現在、GPT-6.1 TerraとSonnet 5.5のどちらを選ぶか迷っている方のために、私がベンチマークを実行する前に使用している簡単な判断基準をご紹介します。
パイプラインで大量のスクリーンショット検査、フォームや請求書の自動化、UIレイアウトのデバッグ、あるいは限定的なコーディングタスクを実行しており、ピーク時の自律的なリファクタリングの深さよりも、0.80ドル/4.00ドルのトークン単価と3倍高速なタスク実行速度が重要であり、かつ単一リクエストの入力が272Kトークン以下である場合は、GPT-6.1 Terraを選択してください。
エージェントが複数ファイルのレポジトリ移行を実行する場合、編集ミスがトークン料金よりも高くつくような深いターミナルのデバッグを行う場合、あるいはOpenAIのロングコンテキスト追加料金によってTerraの入力価格の優位性が相殺されてしまう300Kから900Kトークンのシングルパスプロンプトを使用する場合は、Claude Sonnet 5.5を使い続けてください。
どちらのルートにするか決定する前に、GPT Protoモデル比較ハブで最新のカタログ料金を確認するか、ご自身の月間トークン量で試算してみてください。以下の内容はすべて、2026年11月5日時点で検証されたドキュメントおよびベンチマークに基づいた比較です。ベンダーが報告したベンチマークは、Artificial Analysisによる独立した測定結果や初期の開発者フィードバックとは分けて記載しています。
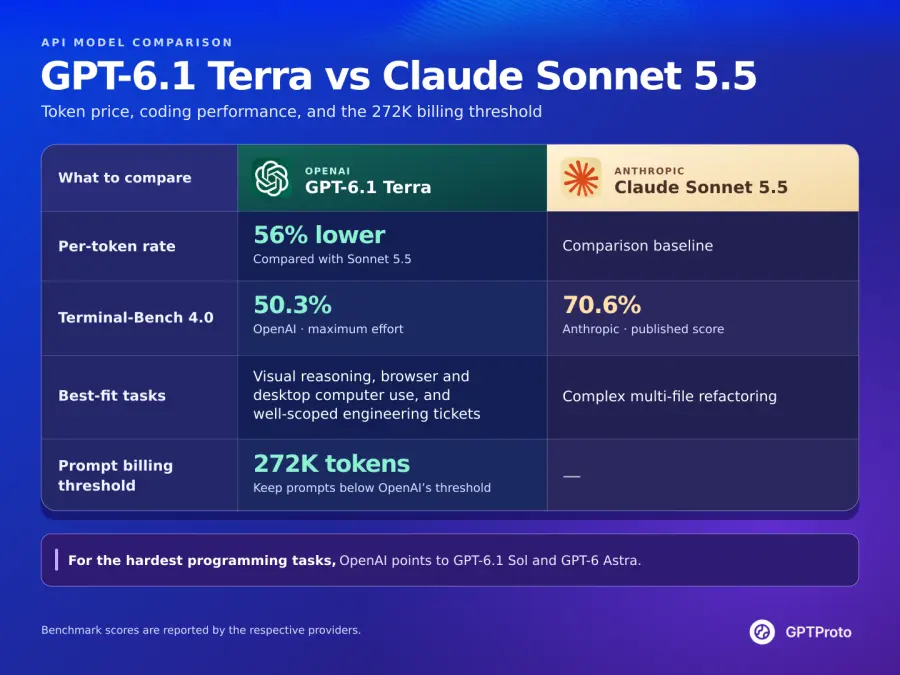
GPT-6.1 Terra 対 Claude Sonnet 5.5 比較まとめ
ChatGPT 6.1 Terra 対 Sonnet 5.5、あるいは Anthropic Claude Sonnet 5.5 対 GPT 6.1 Terra を比較しようとする開発者は、両ベンダーで推論制御、ツールエンドポイント、長文コンテキストの追加料金の構造が異なるため、仕様書の内容が食い違うという問題に直面しがちです。以下の表は、両モデルを OpenAI の公式 gpt-6.1-terra ドキュメント、Anthropic の Claude Sonnet 5.5 概要、および GPT Proto のライブカタログ料金に基づいて整理したものです。
| 仕様 |
GPT-6.1 Terra (gpt-6.1-terra) |
Claude Sonnet 5.5 (claude-sonnet-5-5) |
| プロバイダー |
OpenAI |
Anthropic |
| リリース日 |
2026年10月26日 |
2026年9月28日 |
| 公式標準入出力(100万トークンあたり) |
$1.00 / $5.00 |
$2.00 / $10.00 |
| GPT Proto 入出力(100万トークンあたり) |
$0.80 / $4.00 (公式比 -20%) |
$1.80 / $9.00 (公式比 -10%) |
| 公式キャッシュ入力読み取り(100万トークンあたり) |
$0.05 (基本入力の5%) |
$0.10 (2026年10月7日に$0.20から値下げ) |
| 公式キャッシュ書き込み(100万トークンあたり) |
$1.25 (TTL 30分) / $2.50 (TTL 12時間) |
$2.50 (TTL 5分) |
| GPT Proto キャッシュ読み取り / 書き込み(100万トークンあたり) |
$0.04 / $1.00 |
$0.09 / $2.25 (最新のモデルページを確認してください) |
| コンテキストウィンドウ |
1,050,000 トークン |
1,000,000 トークン |
| 長文コンテキストの料金ルール |
272Kトークンを超える入力は、入力/キャッシュの2倍、出力の1.5倍で課金 |
100万トークンのコンテキストウィンドウ全体で一律料金 |
| 最大出力トークン数 |
128,000 トークン |
128,000 トークン |
| 入出力モダリティ |
テキスト、画像、ドキュメント入力 → テキスト出力 |
テキスト、画像、ドキュメント入力 → テキスト出力 |
| 知識のカットオフ |
2026年6月1日 |
2026年前半〜中期(Sonnet 5のトークナイザーを保持) |
| 推論 / 努力制御 |
none、 low、 medium (デフォルト)、 high、 xhigh、 max |
適応的思考がデフォルトで有効。 medium、 high (APIデフォルト)、 max、 between_tools |
| ツール呼び出しに必要なエンドポイント |
/v1/responses (OpenAIドキュメントで必須) |
/v1/messages (ネイティブ) または OpenAI互換の /v1/chat/completions |
| クライアントおよびIDEの対応状況 |
ChatGPT Work & Codex (通常のチャットは不可)、GitHub Copilot、Claude Code (API経由) |
Claude.ai、Claude Code、GitHub Copilot、Cursor |
| AA Intelligence Index (v4.3.2) |
41 (medium) / 48 (max) |
56 (max、デフォルトのフォールバック) |
| AA 平均評価タスクコスト |
$0.10 (`medium`) / $0.40 (max) |
$5.46 (max、デフォルトのフォールバック) |
| Terminal-Bench 4.0 (ベンダー報告値) |
50.3% (max effort) |
70.6% |
アプリケーションの予算を立てる際、この表の3つの行がほとんどの判断基準となります。第一に、272Kトークン未満の標準的なリクエストにおいて、GPT-6.1 Terra は GPT Proto 上で入力・出力ともにトークンあたりのコストが56%安いため、長い補完を行ってもコスト順位が逆転することはありません。第二に、Sonnet 5.5 は Terminal-Bench 4.0 で20.3ポイントのリードを保っており、これは両モデルがガイドなしのリポジトリ編集でどのように動作するかと密接に関連しています。第三に、GPT-6.1 Sol とは異なり、GPT-6.1 Terra は reasoning.effort: "none" のサポートを復活させており、OpenAI 開発者に再び真の非推論型高速パスを提供しています。
料金とコストの内訳:どちらが高額で、どちらが費用対効果に優れているか?
開発者が「GPT 6.1 TerraとSonnet 5.5のどちらが高額か」あるいは「どちらが費用対効果が高いか」を検索する際、通常は2つの異なる数字、つまり料金ページに記載された100万トークンあたりの単価と、エージェントタスク完了時の実際のドルコストを照らし合わせようとしています。この2つの比率は同じではありません。
トークン単位で見ると、Claude Sonnet 5.5の方が大幅に高額なモデルです。Anthropicの公式料金は入力100万トークンあたり2.00ドル、出力100万トークンあたり10.00ドルであり、Terraの定価である1.00ドル/5.00ドルの2倍です。GPT ProtoではGPT-6.1 Terraに20%(入力0.80ドル/出力4.00ドル)、Claude Sonnet 5.5に10%(入力1.80ドル/出力9.00ドル)の割引を適用しているため、プラットフォーム上ではSonnet 5.5のトークン単価は2.25倍となります。両ベンダーとも現在、キャッシュされた入力読み取り料金を基本入力の5%(Terraは公式0.05ドル、Sonnet 5.5は2026年10月にAnthropicがSonnetのキャッシュ読み取り価格を半額に改定した後の公式0.10ドル)に設定しており、標準的なキャッシュ書き込み料金も基本入力の1.25倍(公式1.25ドル対2.50ドル)を請求しています。なお、キャッシュに書き込まれた一度限りの長いプロンプトは、そのプレフィックスを二度と読み取らない場合、どちらのモデルでも実質的に25%の追加料金が発生することに注意してください。
タスク単位で見ると、その差はさらに広がります。Artificial Analysis社のIntelligence Index v4.3.2(2026年10月26〜27日公開)において、テストされたClaude Sonnet 5.5構成(デフォルトフォールバックでmax effort)は、評価タスクあたり5.46ドルの加重平均コストを記録しました。同じ評価スイートにおいて、[GPT-6.1 Terra at `max` effort](https://artificialanalysis.ai/models/gpt-6-1-terra)はタスクあたり平均0.40ドル、GPT-6.1 Terra at medium effortはタスクあたりわずか0.10ドルでした。これはmax effortで13.6倍、Sonnetの最高設定とTerraのデフォルトであるmedium設定を比較すると54.6倍の差となります。
なぜトークン単価の2倍の差が、13倍から54倍の請求額の差になるのでしょうか?推論モデルは思考トークンを出力トークンとして課金します。Sonnet 5.5がオープンエンドのベンチマークでhighまたはmaximum effortで実行されると、100万トークンあたり10.00ドル(GPT Protoでは9.00ドル)で長い推論チェーンを生成します。Terraの発表でも、Agents' Last Examのmaximum effortにおいて、TerraはClaude Opus 5.5の3分の1未満のトークンしか使用しなかったことが指摘されています。さらに重要なのはArtificial Analysis社のパレートフロンティアの発見です。GPT-6.1 Terraの場合、lowおよびmedium effort設定が、知能とコストのバランスにおいてパレート最適であるということです。Terraをmaxに上げるとスコアは41から48に上昇しますが、これはGPT-6.1 Sol at medium effortと同等です。ただし、Solのmediumはタスクあたり0.21ドルであるのに対し、Terraの`max`は0.40ドルかかります。要するに、Terraで最も費用対効果の高い設定を求めるならlowまたはmediumに留めておくべきであり、max effortを必要とするほど難しいタスクであれば、最初からSolやSonnet 5.5を試すべきなのです。
コスト計算の実例:2つの本番環境シナリオ
安価なトークン単価が実際にどこで利益を生み、どこで裏目に出るのかを確認するため、GPT Protoのライブカタログ料金(Terraは$0.80/$4.00、Sonnet 5.5は$1.80/$9.00)に基づき、272Kトークン未満のキャッシュなしリクエストを想定して正確な計算を行ってみましょう。
シナリオAは、20ステップのビジュアルQAおよびフォーム抽出エージェントループです。各ステップでスクリーンショットとDOMスニペット(合計15,000入力トークン)を送信し、1,500出力トークン(medium 推論トークンを含む)を生成します。20ステップ全体で、1つのワークフローが300,000入力トークン(0.3M)と30,000出力トークン(0.03M)を消費します:
月間10,000ワークフローの場合、Terraのコストは$3,600となり、Sonnetの$8,100と比較して月間$4,500の節約になります。仮にTerraが実行の20%で検証に失敗し、その2,000ワークフローを最初からやり直す必要がある場合($720の追加コスト)、合計請求額は$4,320となりますが、それでも再試行なしのSonnet実行と比較して月間$3,780の節約になります。
シナリオBは、アクティブなプルリクエストにおける複数ファイルのバックエンドリファクタリングです。各試行で80,000入力トークンを読み取り、10,000出力トークンを生成すると仮定します。Sonnet 5.5での1回のクリーンなパスのコストは (0.08 * $1.80) + (0.01 * $9.00) = $0.234 です。Terraでの1回のパスのコストは (0.08 * $0.80) + (0.01 * $4.00) = $0.104 です。APIコールで13セント節約できます。問題は、Terraがモジュール間の型依存関係を見落とした場合(Terminal-Benchにおける50.3%対70.6%という差に起因します)、3回の再試行とシニアエンジニアの12分間の時間(時給$90で$18.00の労働コスト)が発生し、その13セントのトークン節約がチームに$18.18の損失をもたらすことです。一言で言えば、Terraは反復可能で機械的に検証可能なループにおいて圧倒的に優れていますが、編集の失敗が人間のレビュー時間を浪費するようなケースでは、Sonnet 5.5のより高い料金を支払う価値があるということです。
ウィンドウコンテキスト(1.05M対1M):272Kを超えると請求額が変わる理由
理論上、GPT 6.1 TerraとSonnet 5.5のウィンドウコンテキストの比較は、OpenAIがわずかに優勢な互角の勝負に見えます。Terraは1,050,000入力トークンを受け入れ、最大128,000出力トークンを生成するのに対し、Claude Sonnet 5.5は1,000,000入力トークンを受け入れ、最大128,000出力トークンを生成します。ほとんどの比較表はここで終わっています。
しかし、OpenAIのgpt-6.1-terraモデルのドキュメントを読むと、272,000入力トークンに課金の境界線があり、ロングコンテキストの経済性が一変することがわかります。GPT-6.1 Terraでプロンプトが272K入力トークンを超えると、OpenAIはリクエスト全体(272Kを超えた分だけでなく)に対して、入力レートとキャッシュレートを2倍、出力レートを1.5倍にして請求します。
プロンプトが272,000トークンから272,001トークンに達した瞬間に、公式の100万トークンあたりの料金表がどうなるかを以下に示します。
| コンテキスト範囲 |
GPT-6.1 Terra(公式レート) |
Claude Sonnet 5.5(公式レート) |
入力価格の関係 |
| 標準プロンプト(272K入力トークン以下) |
入力$1.00 / 出力$5.00 / キャッシュ読み取り$0.05 |
入力$2.00 / 出力$10.00 / キャッシュ読み取り$0.10 |
Terraは入力と出力が50%安い |
| ロングコンテキストプロンプト(272K超〜1M+入力トークン) |
入力$2.00 / 出力$7.50 / キャッシュ読み取り$0.10 |
入力$2.00 / 出力$10.00 / キャッシュ読み取り$0.10 |
入力およびキャッシュ読み取りレートは同一($2.00 / $0.10) |
Anthropicの小型モデルHaiku 5.5(100Kトークンを超えると5倍の追加料金が適用される)とは異なり、Claude Sonnet 5.5は一律の価格設定を維持しており、1,000,000トークンのコンテキストウィンドウ全体で適用されます。
公式リストレートで10,000出力トークンを生成する、400,000トークンのリポジトリ監査を例に計算してみましょう。
プロンプトが272Kトークンを超えると、Terraの50%の入力割引は完全に消滅し、400Kトークンの呼び出しで合計$0.025の差しかなくなります。私の推奨は単純です。半額の経済性を期待して272Kトークンを超える巨大なプロンプトをGPT-6.1 Terraに送信しないでください。コンテキストを272Kトークン以下に分割/取得してTerraを$1.00(GPT Proto経由で$0.80)の枠内に収めるか、300K〜900Kのリポジトリダンプを直接Claude Sonnet 5.5にルーティングしてください。こちらの方が公式の入力レートは同じで、より強力な長距離コード理解が得られます。(GPT Protoを通じて272Kを超えるプロンプトを本番環境で実行する前に、アップストリームの272K階層調整がアカウント残高にどのように反映されるかをプラットフォームサポートに確認してください。)
ベンチマークとコミュニティのフィードバック:コーディング、フロントエンド、およびエージェントワーク
総合スコアのヘッドラインだけでは、各モデルが実際にどこで優れているのかは見えてきません。Artificial Analysis Intelligence Index v4.3.2において、Claude Sonnet 5.5(max、デフォルトフォールバック)は56、GPT-6.1 Sol(max)は52を記録し、GPT-6.1 Terraはmaxの負荷で48、mediumの負荷で41を記録しています。(GPT Protoの比較カードに表示されている2026年11月3日時点のインデックススナップショットでは、Sonnet 5.5は54.2、Terra maxは51を記録しており、差は3.2ポイントに縮まっていますが、依然としてSonnetが優勢です。)コード、フロントエンドUI、またはエージェントループの実用的なルーティング判断を行うには、これらの集計値をタスクタイプ別に分解し、開発者が現場で報告している内容と比較する必要があります。
1. バックエンドおよびターミナルコーディング (GPT 6.1 Terra 対 Sonnet 5.5 コーディング比較)
コマンドラインからの純粋なソフトウェアエンジニアリングにおいて、Anthropicは依然として明確な優位性を保っています。Terminal-Bench 4.0において、AnthropicはClaude Sonnet 5.5で70.6%を報告しており(Sonnet 5の10.3%から上昇)、一方OpenAIはGPT-6.1 Terraのmax(最大)エフォートで50.3%を報告しています(GPT-5.6 Terraの21.5%から上昇)。Artificial Analysisが新たに公開したCoding Agent Index v2.0では、Terraは48点を記録しました。これは軽量版のGPT-6 Luna(31点)を17ポイント上回りますが、GPT-6.1 Sol(54点)には6ポイント及びません。またArtificial Analysisは、コーディングエージェントに特化した場合、Terraのlow(低)およびxhigh(超高)エフォート設定がコスト効率のフロンティアに位置しており、他のエフォート設定は遅れをとっていると指摘しています。
初期の実際のテストでは、両モデルの境界線が明確に示されています:
GitHub Copilotの2026年10月26日のリリースチェンジログによると、初期の社内テストにおいて、GPT-6.1 TerraはGPT-5.6 TerraよりもターミナルおよびC#のコーディングタスクを顕著に多く解決したと報告されており、重要な行動観察として「タスクの範囲が明確な場合に、集中して統合的なステップで動作する」"It works in focused, consolidated steps on well-scoped tasks." と述べられています。GitHubはそのメモで生の合格率を公開していないため、これは管理されたベンチマークではなく、定性的なプラットフォームの知見として扱うべきです。
Claude側では、r/ClaudeAIでの初期の直接対決開発者テスト(Claude Codeおよびpi-agentで、10個の個人的なコーディングタスクを各構成で3回ずつ、high(高)エフォートで実行)において、Sonnet 5.5は前モデルよりも少ない会話ターン数と少ない出力トークン数で一貫して実装を完了させました。これは主に、Sonnet 5.5が並列ツール呼び出しをより積極的にバッチ処理するためです。同様に、Cursorの外部評価であるCursorBench 4.0において、Sonnet 5.5はhigh(高)エフォートでタスクあたり1.67ドルで47.8%を記録しました。
バックエンド開発者への結論:チケットの範囲が明確な場合(C#のサービスメソッドの記述、ユニットテストの追加、分離されたCLIスクリプトの修正など)、Terraのlow(低)またはmedium(中)エフォートを使用すれば、トークン単価の半分以下で迅速に完了できます。もしチケットが10個のファイルにまたがる状態の追跡を必要とし、再試行ループがワークフローを阻害するような複雑なものであるなら、Sonnet 5.5の70.6%のターミナル能力は、より高い料金を支払う価値があります。科学計算が関与する場合、OpenAIはTerminal-Bench-Science 0.1(タイムラプス動画内の細胞分裂を追跡するコードの記述など)において、Terraのmax(最大)エフォートが実際にGPT-6.1 Solを上回り、推定コストの5分の1以下でClaude Opus 5.5に5ポイント差まで迫ると報告しています。
2. フロントエンドコーディングにおけるGPT-6.1 Terra vs Sonnet 5.5
フロントエンドコーディングにおけるGPT 6.1 Terra vs Sonnet 5.5というテーマは、それ自体で一つの回答を必要とします。なぜなら、フロントエンドエンジニアリングは「ビジュアル/DOMレイアウト作業」と「状態管理/アーキテクチャロジック」という、全く異なる2つの仕事が組み合わさったものだからです。
OpenAIがGPT-6.1 TerraのTerminal-Bench 4.0における50.3%というスコアを発表した際、その発表の中で強調された唯一の具体的なコーディング例は、フロントエンドのバグでした。それは「読み込み時にレイアウトがずれるWebページの修正」(累積レイアウトシフト、またはCLS)です。同時にOpenAIは、図表、スクリーンショット、高密度なレイアウトに対する視覚的推論のベンチマークであるMMMU-Proにおいて、GPT-6.1 TerraがGPT-5.6 Terraをすべての難易度で上回り、最先端のGPT-6 AstraやGPT-6.1 Solに匹敵する性能をわずかなコストで実現していると報告しました。OpenAI開発者コミュニティフォーラムのローンチ当日のスレッドでは、ある開発者がTerraについて最初にこう評価しました:「特に視覚的理解において、コストパフォーマンスが非常に高い。コーディングもまずまずだ。」
この特性により、フロントエンドチームは以下のように役割を明確に分担できます:
ビジュアルおよびUI層のフロントエンド作業にはGPT-6.1 Terraを使用します。Figmaのスクリーンショットやワイヤーフレームから初期のTailwind/HTMLマークアップを作成したり、レンダリングされたPlaywrightのスクリーンショットをデザイン仕様と比較してDOMノードの重なりやモバイルブレークポイントの回帰を特定したり、CSSのレイアウトシフトを診断したりする作業です。Terraは画像をネイティブに処理し、視覚アクションベンチマークではGPT-6.1 SolやAstraの3倍以上の速度で動作し、GPT Proto上では$0.80/$4.00というコストであるため、CIパイプラインですべてのコミットに対して視覚的リグレッションテストを実行することが可能です。
ロジック重視のフロントエンドアーキテクチャにはClaude Sonnet 5.5を使用します。複雑なReact/Next.jsのサーバーアクション状態ツリーのリファクタリング、複雑なTypeScriptのジェネリック制約の解決、あるいはハイドレーションを壊さずにレガシーなReduxストアを移行するような作業です。検査すべきスクリーンショットがなく、純粋に複数ファイルにまたがる状態の一貫性が求められる難易度の高いタスクにおいては、Sonnet 5.5の方がより信頼できる選択肢となります。
3. エージェントワーク、コンピュータ操作、および事実性 (エージェントワーク向け)
「エージェントワークにおけるGPT 6.1 Terra対Sonnet 5.5」の定義が、GUI自動化、ドキュメント解析、バックオフィスでのコンピュータ操作に重点を置いている場合、GPT-6.1 Terraは間違いなく2026年におけるOpenAIの最も強力な価値あるリリースと言えます。
「Agents' Last Exam v1」(建築図面から3Dモデルへの変換や、アニメーション映画のショットごとのタイムコード記録といった、多段階の専門的ワークフローをテストするもの)に関するOpenAIのベンダー報告評価において、GPT-6.1 Terraは中程度の労力でGPT-5.6 Terraより15パーセントポイント高いスコアを記録し、コストは約3分の1、トークン単価はフラッグシップであるGPT-6 Astraの10分の1となりました。最大の労力では、TerraはClaude Opus 5.5と比較してトークン効率が3倍以上、トークンあたりの価格は4分の1であり、GPT-6 AstraやGPT-6.1 Solの両方よりも3倍以上速くワークフローを完了させつつ、タスクあたりのコストを約9分の1に抑えられるとOpenAIは報告しています。
「OSWorld 2.1」(デスクトップアプリケーション制御)において、OpenAIは、中程度の労力でTerraがGPT-5.6 Terraの最高スコアを上回り、タスクあたりのコストも大幅に削減できたと報告しています。公平を期すために付け加えると、Anthropicが公開したClaude Sonnet 5.5のOSWorld 2.1(オフライン)スコアは83.9%と非常に高い数値です(Anthropicの2026年10月のHaiku 5.5ベンチマーク表で開示)。どちらのモデルも最高レベルのコンピュータ操作エンジンですが、違いは、スクリーンショットを読み取るエージェントはクリックのたびに新しいスクリーンショットを送信するため、入力トークンを急速に消費してしまう点にあります。その点、Terraの$0.80/M GPT Proto入力レートは、大規模な運用において維持がはるかに容易です。
自律型エージェントにとって同様に重要なのは、モデルが何かを知らないことを認識することです。Artificial Analysisによる独立したAA-Omniscienceベンチマークでは、GPT-6.1 Terraのハルシネーション率(知識がない場合にモデルが推測を行う頻度)が、GPT-5.6 Terraの88%から38%へと50パーセントポイント低下し、同時に全体的な精度も2ポイント向上しました。この独立した測定結果は、OpenAIの内部的な事実性評価(GPT-6.1 Terraシステムカードで詳細を解説)を裏付けるものであり、そこでは難しいプロンプトに対する低労力での事実誤認率が53.6%から16.7%に低下し(最大の労力では4.3%まで低下)、ハルシネーション率の低下は、後続のプロセスにおける誤ったツール呼び出しの減少を意味します。
開発者体験とAPIの落とし穴 (開発者向け GPT 6.1 Terra vs Sonnet 5.5)
本番環境で gpt-6.1-terra と claude-sonnet-5-5 を切り替えることは、単なる文字列の置換で済むことはほとんどありません。開発者向け GPT 6.1 Terra vs Sonnet 5.5 のエルゴノミクスを評価する場合、統合作業を左右する4つのAPIレベルの制約が存在します。
第一に、GPT-6.1 Terra は reasoning.effort: "none" をサポートしていますが、GPT-6.1 Sol はサポートしていません。 OpenAIが2026年9月29日に GPT-6.1 Sol をリリースした際、none および minimal の推論ティアが削除され、すべてのリクエストが low 以上に強制されたことで、temperature と top_p が全面的に機能しなくなりました。OpenAI公式の gpt-6.1-terra プロンプトおよび移行ガイド によると、Terra は none、low、medium(デフォルト)、high、xhigh、および max という全スペクトルをサポートしています。reasoning_effort: "none" を設定すると、Terra は隠れた推論トークンを生成せずに動作し、標準的なサンプリングパラメータを使用できます。しかし、low、medium、high、xhigh、または max を使用した瞬間、リクエストペイロードから temperature、top_p、top_logprobs、および logprobs を削除しなければなりません。そうしないと、APIはHTTP 400エラーで呼び出しを拒否します。
第二に、OpenAIは、GPT-6.1 Terra でのツール呼び出しに Responses API (/v1/responses) を要求します。 通常のテキストおよび画像プロンプトは /v1/chat/completions で動作しますが、OpenAIのモデルドキュメント には、ツール呼び出しには /v1/responses が必要であると明記されています。Responses API に移行すると、Terra はOpenAIの9つのネイティブ組み込みツール(Web検索、ファイル検索、画像生成、コードインタープリタ、ホスト型シェル、apply_patch、スキル、コンピュータ使用、MCP、ツール検索)すべてをサポートし、さらにカスタム関数ツールで async: true を使用できるため、低速なバックグラウンドツールが実行されている間もモデルが推論を継続できます。さらに、Terra は会話の途中で configuration_update 入力項目を送信し、プロンプトのプレフィックスを書き換えたり30分間のプロンプトキャッシュ (prompt_cache_options.ttl: "30m") を無効にしたりすることなく、難しいターンで reasoning.effort を上げ下げすることが可能です。
第三に、Claude Sonnet 5.5には独自の厳格な400エラーの罠があります。 AnthropicのSonnet 5.5移行ガイド によると、Sonnet 5.5はデフォルトで適応型思考(Adaptive Thinking)を使用します(AnthropicのClaude Code設定ドキュメント に記載されている通り、APIではデフォルトで high、Claude Codeでは medium の努力レベルになります)。レガシーなClaude統合で thinking: {"type": "disabled"} を送信している場合は、最も低い思考設定である between_tools に更新する必要があります。さらに重要な点として、Sonnet 5.5は適応型思考が有効な場合、強制的なツール選択(tool_choice: {"type": "any"} または強制された名前付きツール)を400エラーで拒否します。そのため、auto を使用し、プロンプト内でツール選択をガイドする必要があります。また、最初のブロックが頻繁に thinking ブロックになるため、content[0] がテキストであると想定するのではなく、type によってレスポンスのコンテンツブロックを解析する必要があります。
第4に、IDEおよびCLIの統合は、両モデルですでに利用可能になっています。 コンシューマー向けサブスクリプションにおいて、OpenAIのリリースノートは、GPT-6.1 TerraがChatGPT WorkおよびCodex(Plus、Pro、Business、Enterprise、およびEduプラン向け)に展開されたことを確認しており、標準のChatGPTチャットインターフェースには展開されていません。また、UAEでの推論レジデンシーには対応していません(ただし、FastモードはEUデータレジデンシーをサポートしています)。ローカルターミナルで作業する開発者は、GPT Protoを通じて両モデルをClaude CodeおよびOpenAI Codexに接続できます。GPT-6.1 TerraモデルページでTry this modelをクリックすると、クイックスタートパネルが開きます。そこでLet AI finish the integrationの下にあるClaude CodeまたはChatGPT (Codex)を選択するか、Copy Markdown for AIをクリックして、コーディングアシスタントに環境変数を自動的に設定させることができます。
アプリ構築:1つのAPIキーで両方のモデルをルーティングする方法
チームからアプリ構築におけるGPT 6.1 TerraとSonnet 5.5の比較について質問を受けた際、トラフィックの100%を単一のモデルで処理するようなアーキテクチャは、まず推奨されません。GPT Protoでは両モデルが単一のプリペイド残高で利用できるため、ベンダー単位ではなくステップ単位でルーティングを行うのが最適です。高頻度の視覚的検査、スクリーンショットの分類、限定的なUI修正はgpt-6.1-terra(100万トークンあたり入力$0.80/出力$4.00)に送信し、複数ファイルにまたがるコード合成はclaude-sonnet-5-5(100万トークンあたり入力$1.80/出力$9.00)にエスカレーションします。
1. 初回呼び出しのcURLチェック(OpenAI互換のChat Completions)
どちらのモデルも、標準のBearerトークンを使用し、GPT Protoの統一されたOpenAI互換/v1/chat/completionsエンドポイントを通じて、テキストおよび視覚分析のために呼び出すことができます。モデルを切り替えるには、"model"文字列を変更するだけです:
# 呼び出し 1: GPT-6.1 Terra (GPT Protoで100万トークンあたり入力$0.80 / 出力$4.00)
curl --fail-with-body https://gptproto.com/v1/chat/completions \
  -H "Authorization: Bearer $GPTPROTO_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "gpt-6.1-terra",
    "messages": [
      {
        "role": "user",
        "content": "このCSSルールを検査し、なぜモバイルでレイアウトシフトを引き起こすのかを2文で説明してください: .hero-banner { width: 100%; height: auto; }"
      }
    ]
  }'

# 呼び出し 2: Claude Sonnet 5.5 (GPT Protoで100万トークンあたり入力$1.80 / 出力$9.00)
curl --fail-with-body https://gptproto.com/v1/chat/completions \
  -H "Authorization: Bearer $GPTPROTO_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "claude-sonnet-5-5",
    "messages": [
      {
        "role": "user",
        "content": "Web Crypto APIを使用して、定数時間比較でWebhook署名を検証するTypeScriptヘルパーを作成してください。"
      }
    ]
  }'
2. フロントエンドおよびアプリパイプライン向けのPythonステップルーター例
以下は、https://gptproto.com/v1に向けられた標準のopenai SDKを使用した実用的なPythonパターンです。このワークフローでは、ステップ1でgpt-6.1-terraを使用してUIバグレポートをトリアージし(トークン量が多く、視覚的/DOM診断が安価なため)、ステップ2で実際のコードパッチを動的にルーティングします。ルーティング先は、gpt-6.1-terra(単一コンポーネントのCSS修正の場合)またはclaude-sonnet-5-5(トリアージでファイル横断的な状態変更がフラグされた場合や、プロンプトが272Kの制限に近づいた場合)のいずれかとなります:
import os
import json
from openai import OpenAI

# OpenAIとAnthropicの両モデルで共有される1つのAPIキーと残高
client = OpenAI(
    api_key=os.environ["GPTPROTO_API_KEY"],
    base_url="https://gptproto.com/v1",
)

def triage_and_patch_ui_issue(dom_snapshot: str, screenshot_url: str, approx_tokens: int) -> dict:
    # ステップ 1: 常に GPT-6.1 Terra で視覚的/DOM トリアージを実行する ($0.80 / $4.00 / 100万トークン)
    triage_response = client.chat.completions.create(
        model="gpt-6.1-terra",
        messages=[
            {
                "role": "system",
                "content": (
                    "あなたはフロントエンドQAトリアージエージェントです。スクリーンショットとDOMを検査してください。 "
                    "キー:'root_cause'、'scope' ('isolated_css' または 'multi_file_state')、"
                    "および 'target_files' (文字列の配列) を含むJSONを返してください。"
                ),
            },
            {
                "role": "user",
                "content": [
                    {"type": "text", "text": f"DOMスナップショット: {dom_snapshot}"},
                    {"type": "image_url", "image_url": {"url": screenshot_url}},
                ],
            },
        ],
        response_format={"type": "json_object"},
    )

    triage_data = json.loads(triage_response.choices[0].message.content)

    # ステップ 2: タスクのスコープと272Kのロングコンテキスト課金境界に基づいてルーティングする
    # 修正が複数ファイルのステータスに及ぶ場合、または入力トークンが272Kを超える場合は、Sonnet 5.5にエスカレーションする
    if triage_data.get("scope") == "multi_file_state" or approx_tokens > 272_000:
        selected_model = "claude-sonnet-5-5"
    else:
        selected_model = "gpt-6.1-terra"

    patch_response = client.chat.completions.create(
        model=selected_model,
        messages=[
            {
                "role": "user",
                "content": (
                    f"トリアージ診断: {json.dumps(triage_data)} | "
                    f"DOM/コンポーネント用の最小限のプロダクション対応パッチを生成してください: {dom_snapshot}"
                ),
            }
        ],
    )

    return {
        "triage": triage_data,
        "routed_to": selected_model,
        "patch": patch_response.choices[0].message.content,
    }

if __name__ == "__main__":
    sample_dom = "<div class='card-grid'><img src='/hero.webp' /><h2>Checkout</h2></div>"
    result = triage_and_patch_ui_issue(
        dom_snapshot=sample_dom,
        screenshot_url="https://example.com/cls-regression-frame.png",
        approx_tokens=12_000,
    )
    print(f"パッチのルーティング先: {result['routed_to']}")
    print(result["patch"])
デプロイ前の注意点(スモークテスト必須): 課金対象のループをデプロイする前に、GPT ProtoのモデルページにあるライブAPI使用状況パネルで、正確なモデル文字列(gpt-6.1-terra および claude-sonnet-5-5)を確認してください。エージェントがOpenAIのネイティブResponses APIツール(apply_patch、Hosted shell、または async: true 関数呼び出し)や、Anthropicのネイティブ /v1/messages 適応型思考パラメータ(output_config.effort)に依存している場合は、GPT Protoの各ネイティブエンドポイント(/v1/responses および /v1/messages)に対して簡単なスモークテストを実行し、ルート上でのパラメータのパススルーを確認してください。
結論:どちらを使うべきか?
アーキテクチャレビューのドキュメントに貼り付けるための表が必要な場合は、主要なワークロードを、最も重視する障害モードおよび課金境界と照らし合わせてください:
| ワークロード / シナリオ |
推奨モデル |
推奨設定 |
選ばれる理由 |
| 大量のスクリーンショットQA、請求書/フォームの読み取り、およびブラウザでのコンピュータ操作 |
GPT-6.1 Terra |
low または medium effort |
GPT Protoトークンレートが56%低く($0.80/$4.00)、Sol/Astraよりも3倍以上高速なタスク完了速度を誇り、AstraレベルのMMMU-Proビジョンを備えているため。 |
| フロントエンドUIのデバッグ(CLSレイアウトシフト、FigmaからCSSへの変換、視覚的リグレッション) |
GPT-6.1 Terra |
medium effort |
視覚およびDOM検査用に構築されており、Webページのレイアウトシフト修正において明示的にベンチマークされています。 |
低レイテンシの分類、ルーティング、またはtemperatureが必要なJSON抽出 |
GPT-6.1 Terra |
reasoning.effort: "none" |
GPT-6.1 Solで廃止された非推論のnoneティアを復活させ、レイテンシと出力トークン数を最小限に抑えます。 |
| 複数ファイルのバックエンドリファクタリングおよび複雑なTypeScript/Reactの状態変更 |
Claude Sonnet 5.5 |
medium または high effort |
Terminal-Bench 4.0で70.6%対50.3%のスコアを記録。ツール呼び出しをより少ないターンでバッチ処理するため、コストのかかる開発者のレビュー時間を節約できます。 |
| 単一リクエストでの長文脈リポジトリ分析(300K〜900K入力トークン) |
Claude Sonnet 5.5 |
medium または high effort |
Terraは272Kトークンを超えると2倍の入力/1.5倍の出力追加料金が発生し(公式入力価格が$2.00に跳ね上がる)、価格優位性が失われるため。 |
Terraのmaxでは不十分な場合の、最も高度なOpenAIネイティブのターミナルコーディング |
GPT-6.1 Sol |
medium effort |
AA Coding Agent Index v2.0でTerraの48に対し54を記録。また、Solのmedium(タスクあたり$0.21)は、Terraの`max`(タスクあたり$0.40)よりもタスクあたりのコストが実際に安価です。 |
結論をまとめると、繰り返し発生する視覚的タスク、コンピュータ操作、および境界のあるコーディングステップはすべて、GPT-6.1 Terraのlowまたはmedium effortで開始して$0.80/$4.00のレートを活用し、複数ファイルのコーディングステップや272Kトークンを超えるプロンプトには、初回パスの精度が高く1Mコンテキストの定額料金が割安になるClaude Sonnet 5.5を使用することをお勧めします。独自の月間入力/出力比率を当てはめるには、GPT Proto比較計算機を開き、両モデルを並べてテストしてください。