SillyTavernにおけるモデルのランキング方法
主な根拠は、September 2026 AI Roleplay Benchです。これは14の公式モデルを10のカテゴリでテストし、840件の回答をスコアリングしたものです。カテゴリには、コンパニオンチャット、ゲームマスターの振る舞い、厳格なキャラクターボイス、悪役、堅牢性、成人向けテーマ、安全性の境界線が含まれます。Kimi K3、GLM-5.3、DeepSeek V4.1 Flashの差は2ポイント未満であるため、ベンチマーク自体が、小数点以下の数値を決定的な勝利と見なすのではなく、実質的な同点として解釈することを推奨しています。
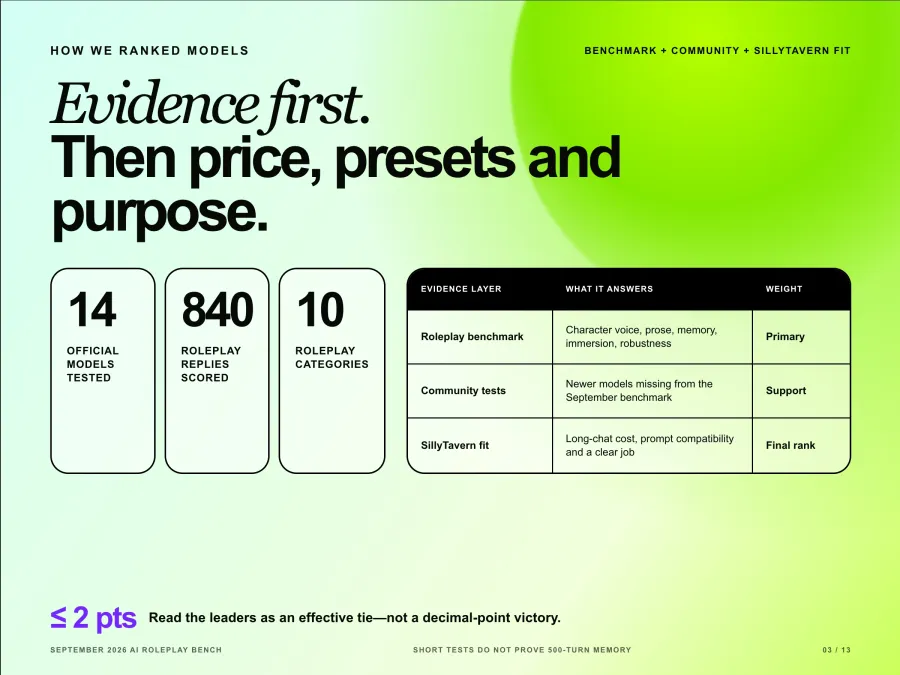
このベンチマークにも限界があります。その公開されている手法では、短いマルチターンのシナリオを使用しており、数百のメッセージにわたるドリフト(文脈の逸脱)を測定しておらず、コミュニティによるファインチューニング版も除外されています。Gemini 4 Argonのような新しいリリースは、そのテストの後に登場しました。これらのモデルについては、コミュニティによる比較を補足的な証拠として使用し、推奨の確実性は低いものとして扱っています。
最終的なランキングには、SillyTavern特有の3つの要素が追加されています:
長文チャットの経済性。 SillyTavernはキャラクターカード、指示、関連する伝承、会話履歴を繰り返し送信するため、通常、後のターンでは入力トークンが支配的になります。
プロンプトとプリセットの互換性。 チャット補完(Chat Completion)、テキスト補完(Text Completion)、インストラクトテンプレート、サンプラー、推論制御は互換性がありません。
各モデルの明確な役割。 安価なモデルは、単に価格が低いからではなく、有用な役割を果たす場合にのみランクインします。
SillyTavernロールプレイに最適なAIモデル8選
1 Kimi K3:SillyTavernで総合的に最高のモデル
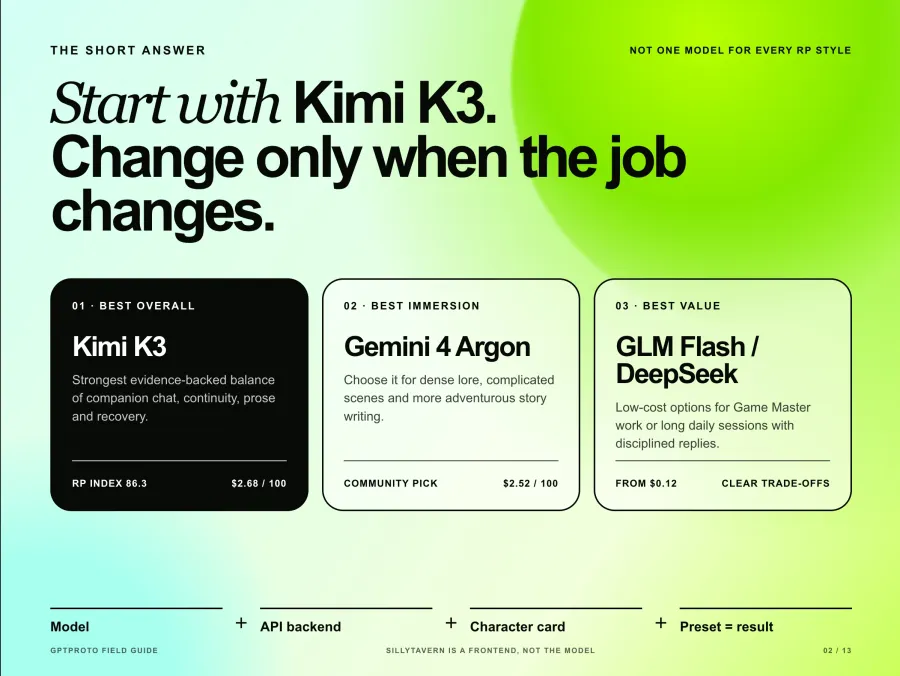
Kimi K3は、どのロールプレイスタイルが好みかまだわからない場合に、最も安全な最初の選択肢です。ロールプレイベンチマークにおいて、総合スコア86.3、コンパニオン部門で90.0、堅牢性部門で88.3を記録しました。また、キャラクター性、文章力、記憶力、没入感の評価でもベンチマークをリードしました。
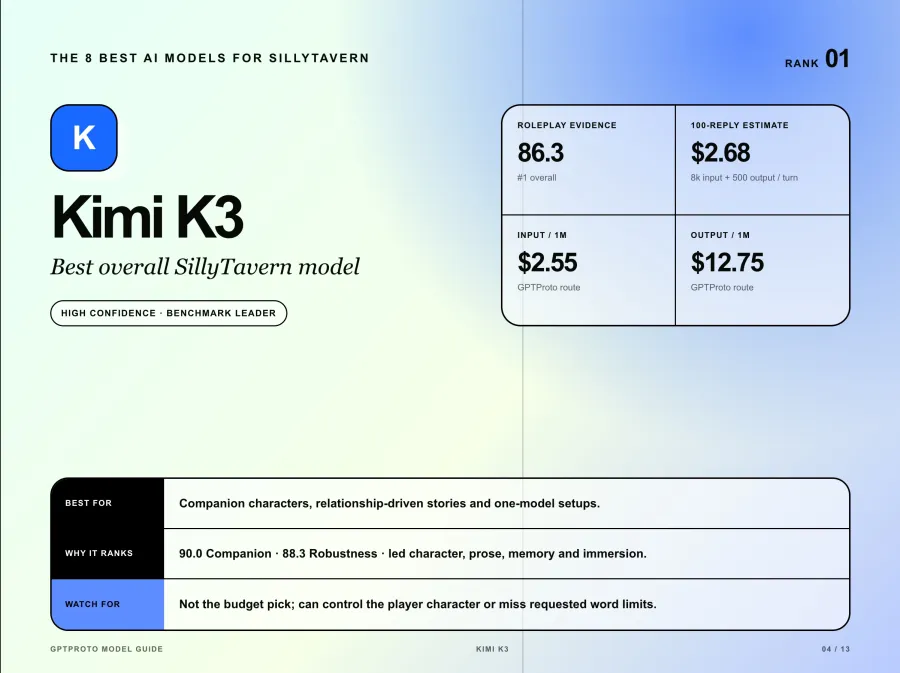
SillyTavernでは、単に派手な回答をするよりも、このようなバランスが重要です。Kimiはユーザーの短いメッセージを処理し、植え付けられた詳細を記憶し、一般的なアシスタントになることなくキャラクターをアクティブに保ちました。弱点は具体的で、時折ゲームマスターとしてプレイヤーのキャラクターを操作してしまったり、要求された単語制限を守れなかったりすることがありました。
最適な用途: コンパニオンキャラクター、関係性重視のストーリー、複数のRPスタイルに1つのモデルを使いたいユーザー。SillyTavernでの開始方法: チャット補完を使用し、正確なkimi-k3モデルIDを指定し、複雑なプリセットルールを追加する前に適度な応答長を設定してください。100万トークンあたり入力2.55ドル、出力12.75ドルという価格は、予算重視の選択肢ではありません。
2 Gemini 4 Argon:没入型ロールプレイに最適
Gemini 4 Argonは、濃密な伝承、複雑なシーン、長編ストーリーの執筆において、最近コミュニティで最も支持されている強力なモデルです。SillyTavernユーザーは、大規模なプロンプトに対する精度の高さや、キャラクターカードの内容を単に言い換えるだけでなく、有用なシーンの詳細を追加できる能力を高く評価しています。ある詳細な長編ストーリー利用に関するコミュニティでの議論では、他のモデルでは停滞してしまったストーリーが、このモデルを使うことで明確に改善したと報告されています。
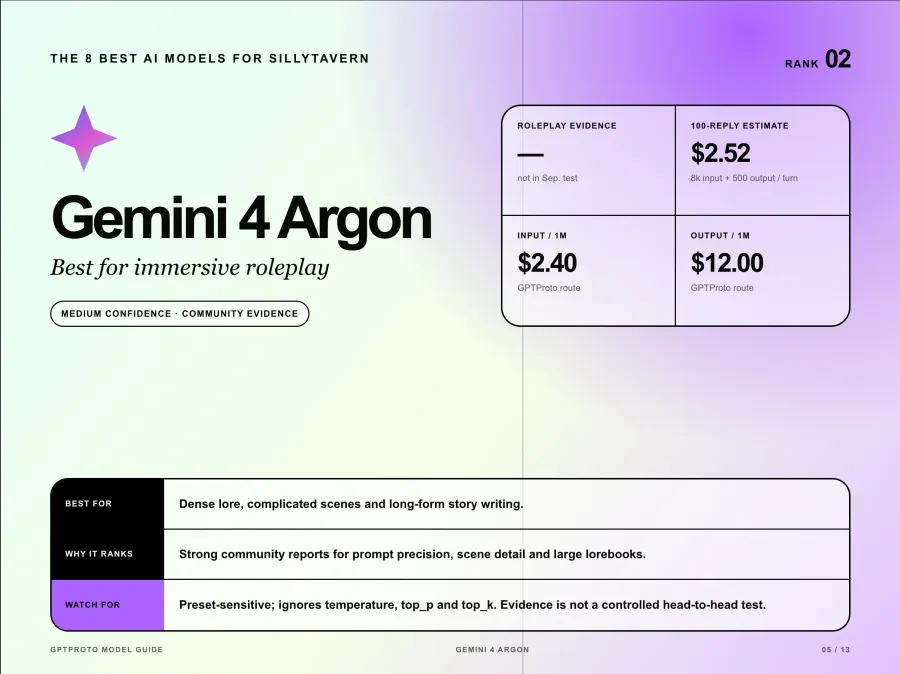
Argonは9月のロールプレイベンチマークに含まれていなかったため、KimiやGLMと比較すると信頼度レベルは低くなります。コミュニティの熱狂ぶりは証拠の一つですが、管理された直接比較テストではありません。
また、Argonには専用のプリセットが必要です。そのAPIはtemperature、top_p、top_kを無視するため、古いサンプラー重視のGeminiプリセットをコピーしても、実際には値が変わっていないのに制御できているような錯覚を生んでしまいます。1対1のキャラクターチャットには「medium thinking(中程度の思考)」から始め、ルールが複雑なRPGや大規模なロアブック(伝承集)の場合のみ「high thinking(高度な思考)」を試してください。欠点はコストです。入力2.40ドル、出力12ドルのレートでは、履歴が拡大する前の固定100リプライのテストで約2.52ドルかかります。
3 GLM 5.3:バランスの取れたストーリーモデルとして最適
GLM-5.3は、モデルにストーリーをより多く牽引させたい場合に、Kimi K3に代わる最も説得力のある選択肢です。ベンチマークでは総合スコア85.1、厳格な口調(Strict Voice)で92.5、堅牢性(Robustness)で85.8を記録しました。このベンチマークでは、ストーリー主導のロールプレイ、ダークフィクション、アドベンチャーボットに特に効果的であると評価されています。
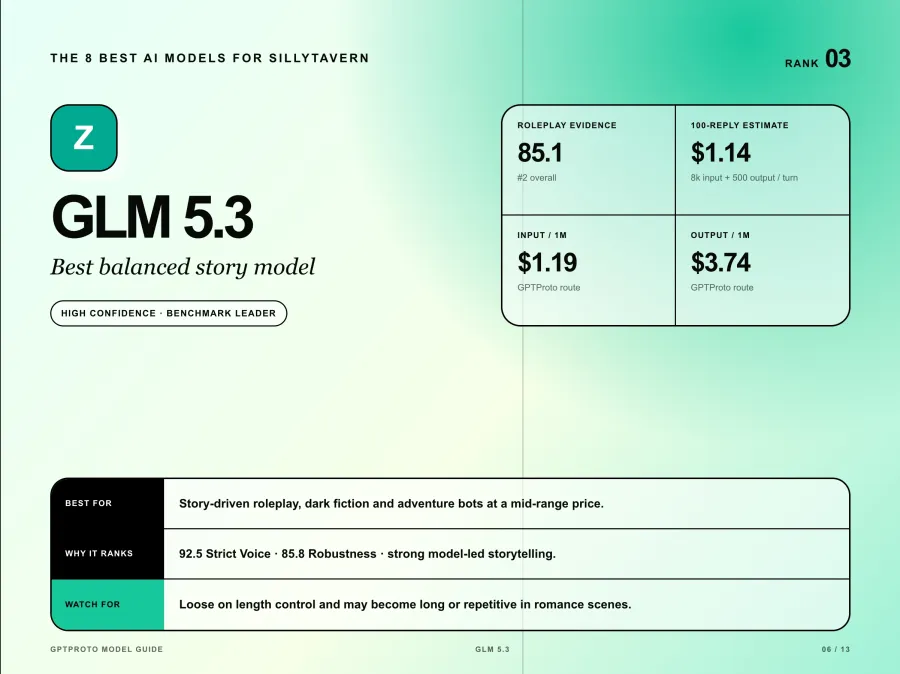
トレードオフとなるのは、長さとペースの制御です。GLM-5.3は主要モデルの中で最も文字数制限が緩く、ベンチマークの恋愛シナリオでは回答が長く反復的になり、パフォーマンスが大幅に低下しました。厳格な最大応答長の設定や、履歴後の明確な指示は役立ちますが、簡潔な出力を保証するものではありません。
100万トークンあたり入力1.19ドル、出力3.74ドルというコストは、固定100リプライの例においてKimi K3の半分以下です。モデルID glm-5.3を使用してください。これは、毎回プレミアムモデルの料金を支払うことなく、強力なロールプレイ品質を求めるユーザーにとって賢明なデフォルト設定です。
4 DeepSeek V4.1 Flash:手頃な価格で長時間のセッションに最適
DeepSeek V4.1 Flashは、このリストの中で品質とコストのバランスが最も優れています。総合スコアは84.4で、28件中28件のコアロールプレイ返信すべてで単語制限内に収まり、「悪役(Villain)」カテゴリーでは同率1位を獲得しました。入力0.24ドル、出力0.96ドルのレートにより、100回の返信を想定した固定例では約0.24ドルとなります。
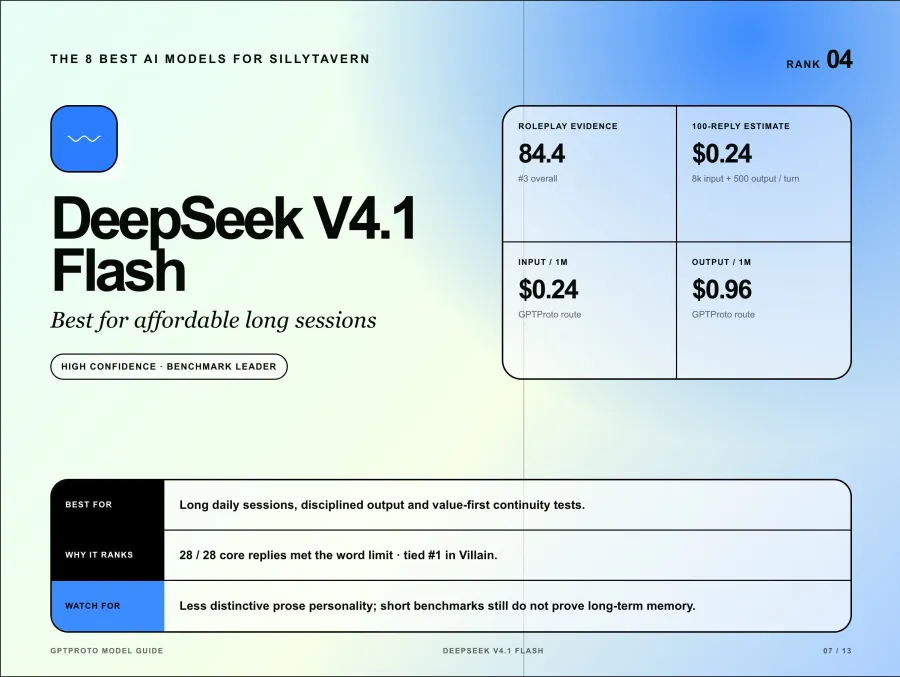
このモデルは、Kimi、Argon、Opusと比較すると、文章のスタイルに際立った個性はあまりありません。しかし、キャラクターカードにすでに強力な個性が設定されている場合、モデル独自のスタイルで上書きされる可能性が低いため、これは利点にもなり得ます。また、毎日長時間チャットを行い、重要なシーンのために高価なモデルを温存しておきたい場合にも便利です。
SillyTavernでdeepseek-flashを使用してください。私の判断では、長期間続くチャットの価値を最初に試すモデルとして最適ですが、ベンチマークでは短いシナリオが使用された点には注意が必要です。低価格であることを長期記憶の証明として信頼する前に、まずは30〜50ターンの継続性テストを自身で行うことをお勧めします。
5 GLM 5.3 Flash:最高の低価格ゲームマスター
GLM-5.3 Flashは、予算重視のスペシャリストです。9月のベンチマークにおいて、ゲームマスターとして89.2、厳格な口調(Strict Voice)で98.3という、単一カテゴリーで最高スコアを記録しました。100万トークンあたり入力0.1275ドル、出力0.425ドルという価格設定により、100回の返信を想定した固定例では約0.12ドルとなります。
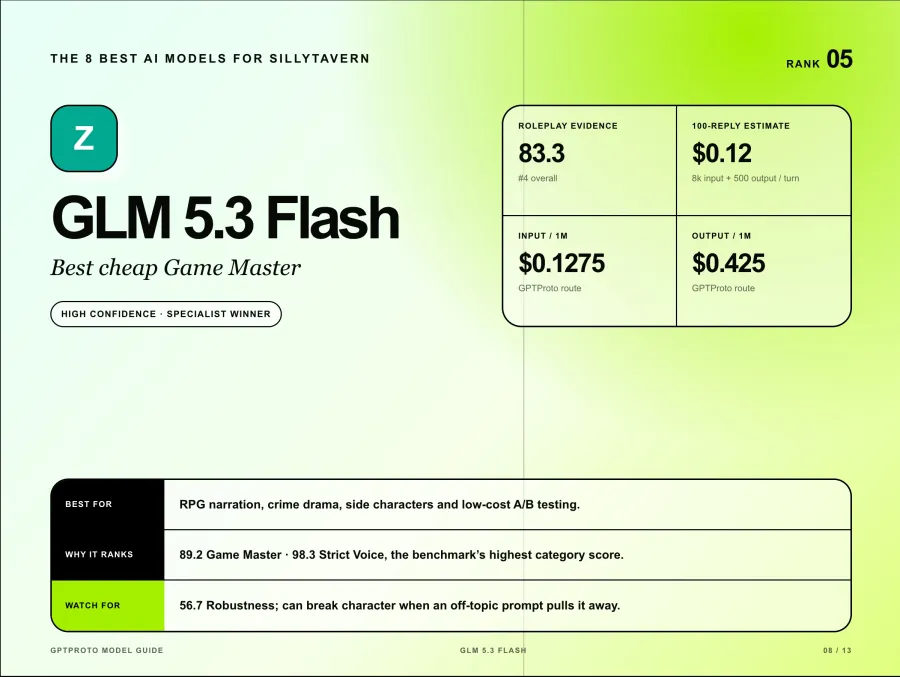
このモデルの弱点も同様に重要です。GLM-5.3 Flashは、一般的なアシスタントのようにトピック外の質問に答えるためにキャラクターを崩してしまい、堅牢性(Robustness)のスコアは56.7にとどまりました。また、他の主要モデルと比較して、コアロールプレイの単語制限を逸脱する回数も多くなっています。
RPGのナレーション、犯罪ドラマ、サイドキャラクター、あるいは安価なA/Bテストに選ぶのが最適です。低価格だからといって、最高のコンパニオンモデルであると決めつけないでください。SillyTavernで使用する際は、キャラクターのルールをプロンプトの末尾近くに配置し、長期的なチャットに投入する前に、意図的に脱線させようとするテストを行うことをお勧めします。モデルIDはglm-5.3-flashです。
6 Gemini 3.8 Flash:日常使いに最適な高速モデル
Gemini 3.8 Flashは、単なる言及にとどまらず、このリストに加える価値が十分にあります。最近のコミュニティによるロールプレイベンチマークでは、8つの章にわたってモデルごとに最大64件の回答をテストした結果、Gemini 3.8 Flashは91.9の品質スコアを獲得しました。このテストでは、文章の好みが75%、堅牢性が25%の割合で加重されています。これは有用な証拠ですが、プロンプトやスコアリング方法が異なるため、AI Roleplay Benchと直接比較することはできません。
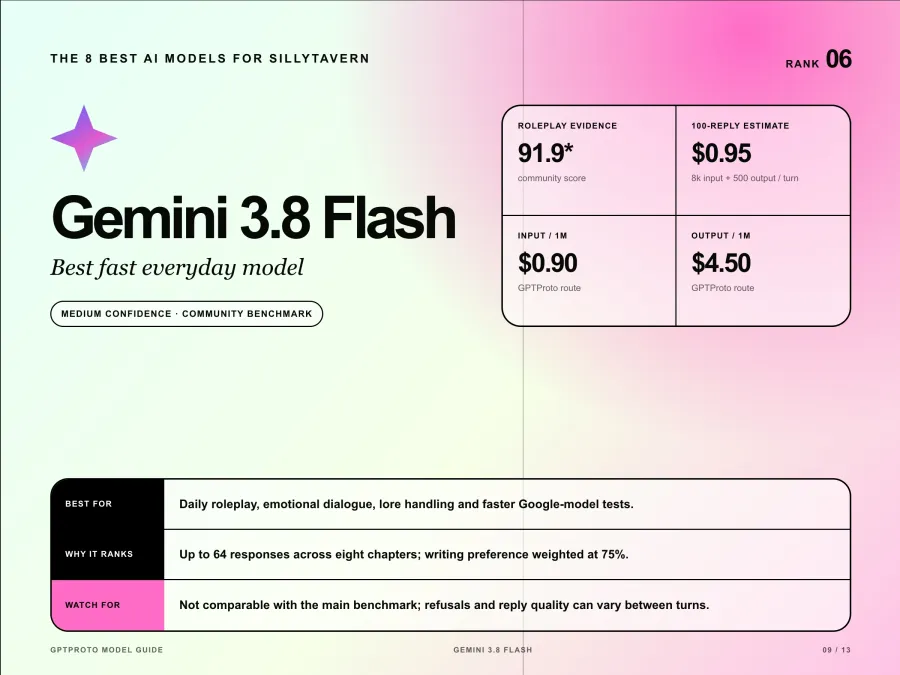
コミュニティの報告では、感情豊かな対話、設定(ロア)の処理、会話のリズムも高く評価されています。難点は一貫性で、前後のやり取りがうまくいっている場合でも、突然の拒否や回答のムラが発生するという報告が一部のユーザーから上がっています。
gemini-3.8-flashを使用し、まずは中程度の思考設定から始めてみてください。入力100万トークンあたり0.90ドル、出力4.50ドルという料金はArgonよりもはるかに安価ですが、固定の100件の回答例では約0.95ドルのコストがかかります。Argonのような高度な推論を毎回必要としないものの、日常的にGoogleのモデルを使いたい場合に最適です。
7 Claude Opus 5.5:最高のプレミアム散文モデル
Claude Opus 5.5は、万能な勝者というわけではありませんが、散文においてはプレミアムな選択肢です。このモデルを好むユーザーは、空間認識能力、世界観の知識、ペース配分、そして舞台設定を生き生きと感じさせる能力を挙げています。詳細なSillyTavernコミュニティレポートでは、一般的なストーリーロールプレイにはこれを推奨しつつ、シーンに応じて異なるコンテンツ処理が必要な場合はモデルを切り替えることを勧めています。
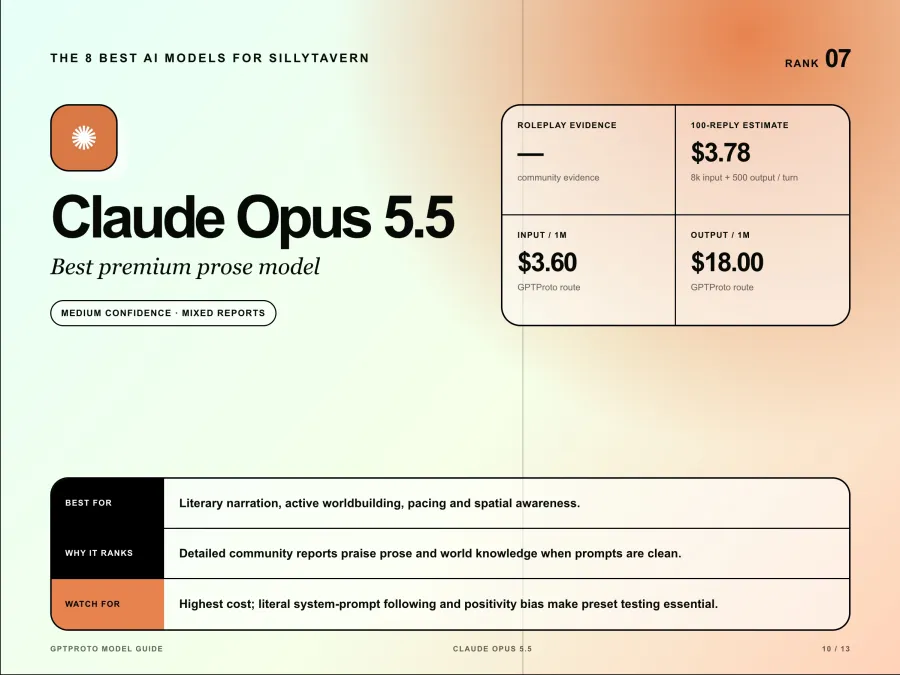
他のユーザーからは、Opusは大規模なシステムプロンプトを文字通りに受け取りすぎるため、キャラクターカードやプリセット内の矛盾した指示によってキャラクターが歪んでしまうことがあるという報告もあります。ポジティブバイアスも繰り返し指摘される不満点の一つです。こうした理由から、実際のカードでテストしない限り、ベンチマークのリーダーよりも上位にランク付けすることはできません。
最大の欠点は価格です。入力100万トークンあたり3.60ドル、出力18ドルであり、固定の100件の回答例では約3.78ドルかかります。claude-opus-5-5を使用する場合は、クリーンなプロンプトから始め、説明できない継承されたプリセットルールは削除してください。Opusは文学的な物語作成には試す価値がありますが、カジュアルで大量のチャットを行うにはコストを正当化するのが難しいでしょう。
8 GPT 6 Luna:超低コストなGPTモデルの最適解
GPT-6 Lunaは、総合的なロールプレイモデルとしてトップクラスではありませんが、SillyTavernのガイドから外せない理由があります。Lunaの総合スコアは71.1で、ベンチマーク上位4モデルを大きく下回っています。内訳は「コンパニオン」で68.3、「厳格なボイス」で60.0、「堅牢性」で54.2でした。その慎重すぎる姿勢が、たびたび物語への没入を妨げてしまいます。
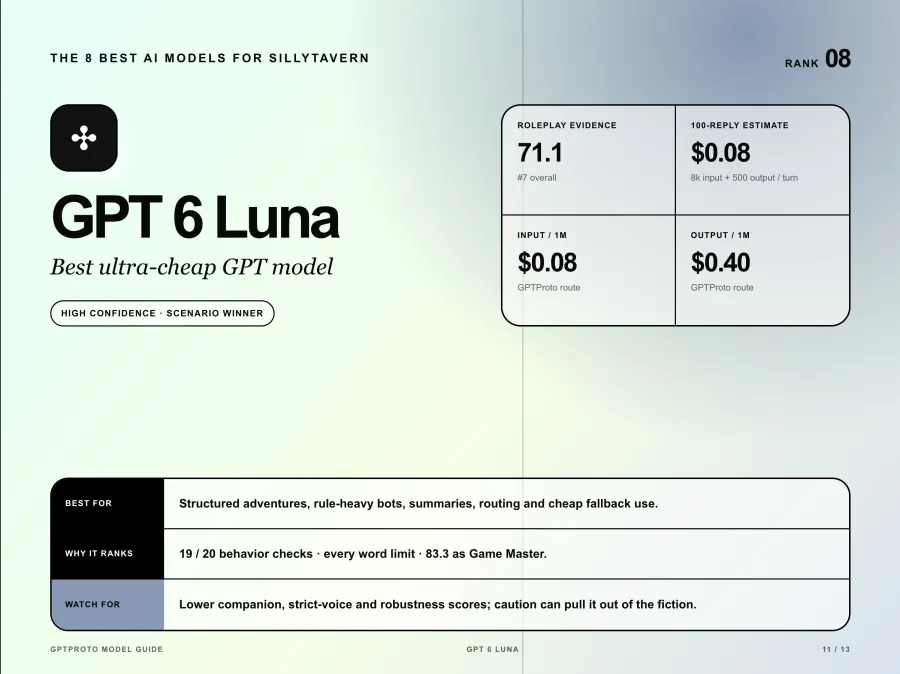
一方で、この結果には有用な側面もあります。GPT-6 Lunaは20個の行動チェックのうち19個をパスし、テストされたすべての単語制限を守り、「ゲームマスター」として83.3というスコアを記録しました。100万トークンあたり入力0.08ドル、出力0.40ドルという価格設定により、100回の返信例を生成してもコストは約8セントで済みます。
構造化された冒険、ルール重視のボット、要約、ルーティング、あるいは安価なフォールバックが必要な場合にはgpt-6-lunaを使用してください。感情的な没入感が主な目的であるなら、Kimi、GLM、Geminiを差し置いて選ぶべきではありません。これはシナリオ攻略における勝者であり、ベンチマーク7位のモデルが総合最強であるという主張ではありません。
なぜGPT、Claude、Geminiのモデルをもっと多く掲載しないのか
有益なランキングとは、すべてのプロバイダーに同等のスペースを割くべきではありません。モデルを追加するたびに、強力なロールプレイの証拠か、明確に異なる用途が必要となります。
| モデルファミリー |
メインリストの選択肢 |
テストする価値のある他のモデル |
代替モデルが個別にランク付けされていない理由 |
| GPT |
GPT-6 Luna |
GPT-6.1 Terra($0.80 / $4.00) |
Terraは価格設定と一般的な文章力は魅力的ですが、まだ比較可能なロールプレイのベンチマークがありません |
| Claude |
Claude Opus 5.5 |
Claude Sonnet 5.5($1.80 / $9.00) |
より安価なClaudeの選択肢ですが、現時点ではRP特化の証拠が乏しく、個別の勝者として挙げるには至りません |
| Claude |
Claude Opus 5.5 |
Claude Haiku 5.5($0.09 / $0.45) |
Haikuは大量の軽量タスク向けに位置付けられており、低価格であることだけでは、優れた文章力や長時間のセッションでの一貫性は証明されません |
| Gemini |
Gemini 4 Argonおよび3.8 Flash |
Gemini Flash Liteバリアント |
より安価なLiteモデルには、RP特化のコミュニティによる裏付けが不足しています |
| Kimi |
Kimi K3 |
Kimi K3.1 Pro($2.00 / $10.00) |
新しく有望ですが、専門的なベンチマークにおいてK3に取って代わるには至っていません |
これが、GPT-6 Lunaが消えることなく8位にランクインしている理由でもあります。特定の用途において実績があるからです。将来的にTerraが順位を上回る可能性はありますが、現時点でそう断言することは、一般的な能力とテスト済みのロールプレイ性能を混同させることになります。
VRAM別:SillyTavernに最適なローカルモデル
SillyTavernをローカルで実行するからといって、言語モデル自体がローカルにあるとは限りません。フロントエンド自体の要件は控えめですが、ローカル推論にはモデルの重みとコンテキストキャッシュを保持するための十分なGPUメモリが必要です。SillyTavern公式概要では、ローカル推論の開始点として最低6GBのVRAMを推奨しています。
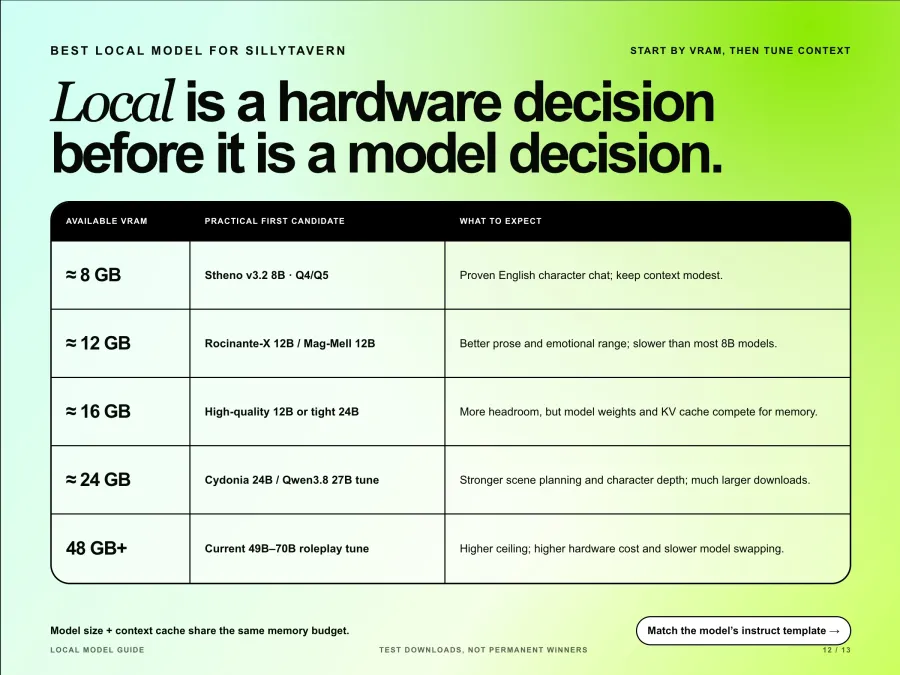
ローカルモデルの推奨事項はすぐに変化するため、これらは永続的な決定版ではなく、まずはテストとしてダウンロードするものと考えてください。現在のHugging Faceのロールプレイモデルディレクトリには、テンプレートや量子化が大きく異なる数千ものコミュニティバリエーションが存在します。
| 利用可能なVRAM |
実用的な最初の候補 |
期待できること |
| 約8 GB |
Stheno v3.2 8B (Q4またはQ5) |
英語のキャラクターチャットにおける実績ある入門モデルですが、コンテキストは控えめにする必要があります |
| 約12 GB |
Rocinante-X 12B または Mag-Mell 12B |
8Bモデルの多くよりも優れた文章表現と感情の幅がありますが、生成速度は低下します |
| 約16 GB |
より高品質な12Bの量子化モデル、または短いコンテキストと部分的なオフロードを使用した24Bモデル |
品質の余裕は増えますが、モデルファイルがVRAMに収まっても、大きなKVキャッシュが収まるとは限りません |
| 約24 GB |
Cydonia 24B または Qwen3.8 27Bのロールプレイ調整版 |
より優れたシーン構成とキャラクターの深みがありますが、ダウンロードサイズは大幅に大きくなります |
| 48 GB以上 |
最新の49B〜70Bのロールプレイ調整版 |
高い上限がありますが、ハードウェアコストが高く、モデルの切り替えも非常に遅くなります |
8GBのカードの場合、中心となるトレードオフは単純です。モデルサイズとコンテキストが同じメモリを奪い合います。まずは小さなコンテキストから始めてキャラクターの口調を確認し、VRAMと生成速度を監視しながら制限を引き上げてください。
ローカルのテキスト補完バックエンドを使用する場合は、モデルの実際の指示テンプレート(Instruct Template)を選択してください。SillyTavernのInstruct Modeのドキュメントでは、選択したテンプレートがモデルの期待する形式と一致している必要があると警告されています。強力なファインチューニングモデルであっても、テンプレートの設定が間違っていれば、適切に設定された小さなモデルよりも性能が低く見えることがあります。
長期ロールプレイに最適なモデル
Kimi K3は、長期的なキャラクターの一貫性を維持する上で、エビデンスに基づいた最も強力な選択肢です。一方、履歴が長くなりコストがかさむ場合には、DeepSeek V4.1 Flashがより経済的な選択肢となります。Gemini 4 Argonは大規模なロアブック(設定資料)には魅力的ですが、100万トークンのウィンドウを信頼性の高い記憶力と混同すべきではありません。
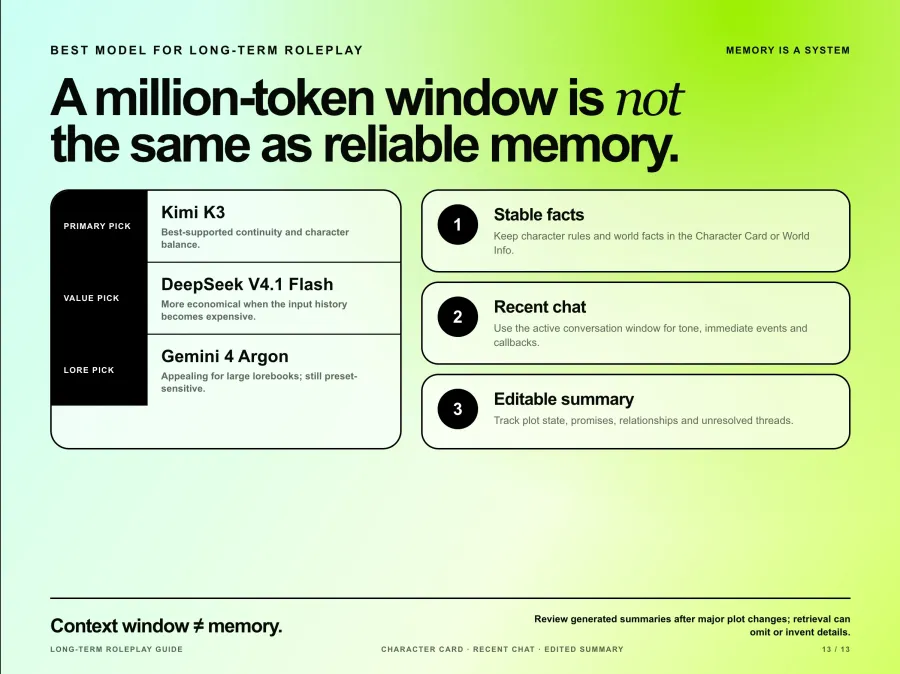
SillyTavernのコンテキストに関するドキュメントでは、アクティブなコンテキスト範囲内のメッセージのみがモデルに送信されると説明されています。キャラクター情報、システムプロンプト、World Info、要約、および応答用のスペースはすべて同じ予算を消費します。古いメッセージがその範囲外になると、関連する事実を再度注入しない限り、モデルはそれらを思い出すことができません。
コンテキストサイズだけに頼るのではなく、3つのレイヤーを使用してください:
安定したキャラクターの事実や世界観のルールは、キャラクターカードやWorld Infoに保持する。
口調や直近の出来事については、最近のチャット履歴を使用する。
プロットの状態、人間関係、約束、未解決の伏線については、編集可能な短い要約を維持する。
「Summarize(要約)」拡張機能を使用すると3つ目のレイヤーを自動化できますが、そのドキュメント自体が、モデルが生成した要約は詳細を省略したり、事実を捏造したりする可能性があると警告しています。主要なプロットが変更された後は、要約を確認してください。チャットのベクトル化は実験的な機能であり、検索の効率を低下させる可能性があるため、盲目的に有効にするのではなく、テストを行うべきです。
SillyTavernでモデルを切り替える方法
切り替えを行ってもチャットは削除されませんが、口調、書式、拒否の挙動、および以前のメッセージの解釈方法が変わる可能性があります。GPT、Claude、Gemini、ローカルのテキスト補完モデル間で1つのプリセットを強制的に使用するのではなく、モデルファミリーごとに個別のプリセットを保存してください。
GPT Protoの簡単なセットアップ手順は以下の通りです:
SillyTavernでAPI Connections(API接続)を開きます。
「Chat Completion」および「Custom OpenAI compatible」を選択します。
Base URLをhttps://gptproto.com/v1に設定します。/chat/completionsは追加しないでください。SillyTavernが自動的に追加します。
APIキーを貼り付け、kimi-k3、glm-5.3-flash、またはgemini-3.8-flashのような正確なモデルIDを入力します。
Prompt Post-ProcessingをNoneに設定した状態で開始し、接続してTest Messageを実行します。
図解付きのSillyTavern API統合ガイドでは、インストール、キャラクターカード、スクリーンショット、および一般的な接続エラーについて解説しています。
SillyTavern以外で同じキーとモデルを検証したい場合は、このリクエストで同一のOpenAI互換ルートを使用してください:
export GPTPROTO_API_KEY="YOUR_KEY"

curl --request POST "https://gptproto.com/v1/chat/completions" \
  --header "Authorization: Bearer $GPTPROTO_API_KEY" \
  --header "Content-Type: application/json" \
  --data '{
    "model": "kimi-k3",
    "messages": [
      {"role": "user", "content": "Reply in character with one short sentence."}
    ],
    "max_tokens": 120
  }'
切り替えた後は、同じキャラクターカードを使用して少なくとも5ターンのテストを行ってください。短い返信、話題から逸れたプロンプト、返信の長さに関する指示、および以前の詳細への言及を1つずつ含めます。これを行うことで、最初のメッセージだけで判断するよりも多くの問題を把握できます。
どのSillyTavernモデルを選ぶべきか
確実な根拠に基づいたデフォルトの選択肢が欲しい場合は、Kimi K3を選んでください。
複雑な設定や没入感のあるシーン展開を求める場合は、コストが高くベンチマークの確実性が低いことを許容した上で、Gemini 4 Argonを選んでください。
中価格帯で強力なストーリーテリングを求める場合は、GLM-5.3を選んでください。
手頃な価格で長時間のセッションや規律ある出力を求める場合は、DeepSeek V4.1 Flashを選んでください。
低予算でのRPGナレーションや、厳格なキャラクターの口調を求める場合は、GLM-5.3 Flashを選んでください。
コミュニティでの評価も高く、より高速で安価なGeminiを求める場合は、Gemini 3.8 Flashを選んでください。
文章の質がコストに見合うほど重要である場合は、Claude Opus 5.5を選んでください。
最も安価な構造化されたロールプレイ、要約、またはフォールバックルーティングを求める場合は、GPT-6 Lunaを選んでください。
セットアップの手間やクラウドモデルの品質よりも、プライバシー、オフライン利用、無制限の生成を優先する場合は、ローカルのロールプレイ用ファインチューンモデルを選んでください。
現在の利用状況やモデルの価格はGPT Proto SillyTavernモデルページで比較できます。その後、ロールプレイAPIプレイグラウンドを通じて、同じキャラクターと履歴を複数のモデルでテストしてみてください。
最終結論
最もサポートが充実した万能な選択肢を求めるなら、まずはKimi K3から始めてください。没入感を最も重視するならGemini 4 Argonを併用してテストし、長時間の会話でコストが気になり始めたらDeepSeek V4.1 FlashやGLM-5.3 Flashを準備しておきましょう。
モデルはあくまで一つの要素に過ぎません。適切なプロンプト形式、整理されたキャラクターカード、モデル固有のプリセット、編集されたメモリの要約の方が、リストの順位を一つ下げるよりも結果を大きく変える可能性があります。同じ5ターンのテストを2〜3の候補で実行し、キャラクターの個性を維持しつつ、持続可能な価格で利用できるモデルを選んでください。