予約ページは、誰かが無効な日付を入力したり、ブラウザをリロードしたり、スマートフォンで試したりするまでは完成しているように見えます。AIコーディングの比較が面白くなるのはそこからです。最初のスクリーンショットで最高の結果を出すモデルが、アプリケーションとして使える状態にするまでに最も多くの作業を必要とする場合があるからです。
私の最初の推奨は、デバッグ、正確な要件定義、レビュー時間が重要となる複雑なアプリケーション開発にはClaude Opus 5.5です。Kimi K3.1 Proは、限定的な実装タスク、インタラクティブなプロトタイプ、自動チェックが可能なワークロードにおいて、早めに試してみる価値があります。トークン単価が低いため実験の予算を立てやすいですが、最終的なコストが安くなるかどうかは、完了する作業内容次第です。
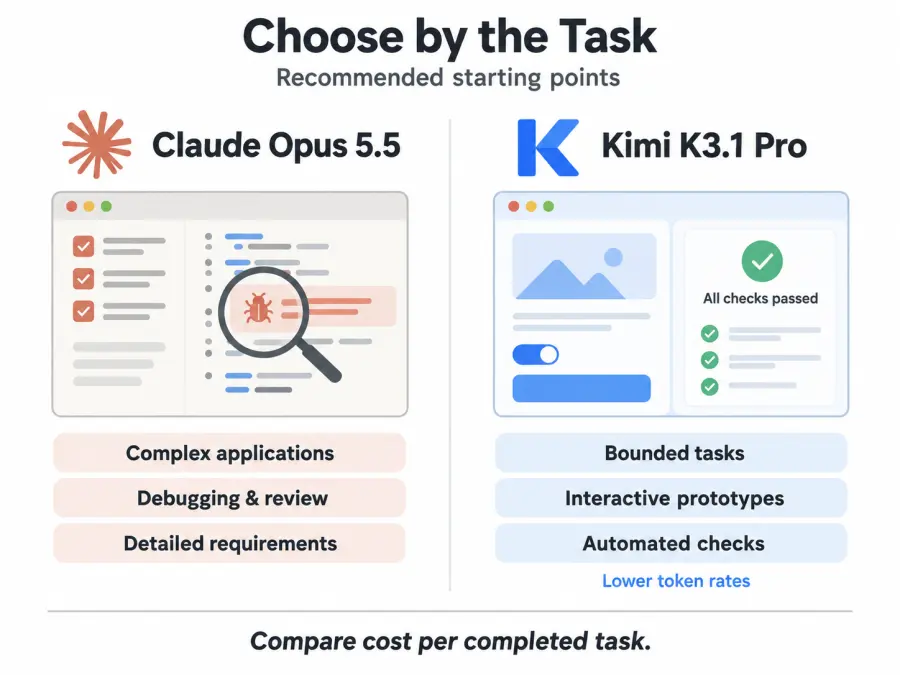
したがって、有益な比較はタスクごとに行う必要があります。フロントエンドの忠実度、インタラクティブな挙動、既存プロジェクトでの開発などです。公開されているベンチマークは基準値を示しますが、実際の開発者の事例こそが、その基準値が実践でどのような結果をもたらすかを示してくれます。
Kimi K3.1 Pro 対 Opus 5.5 比較概要
| 項目 |
Kimi K3.1 Pro |
Claude Opus 5.5 |
| 公式入出力価格(100万トークンあたり) |
$2 / $10 |
$4 / $20 |
| GPT Proto入出力価格(100万トークンあたり) |
$2 / $10 |
$3.60 / $18 |
| コンテキストウィンドウ |
約100万トークン |
100万トークン |
| モデルの入出力 |
テキストおよび画像 / テキスト |
テキストおよび画像 / テキスト |
| ネイティブAPIのデフォルト推論設定 |
最大 |
中 |
| 推奨される最初の試行 |
チェック項目が明確な限定的タスク |
複雑な開発および最終レビュー |
価格は2026年10月29日時点のものです。公式仕様はKimi APIドキュメントおよびClaudeモデルドキュメントに基づいています。GPT Protoの料金はKimi K3.1 Pro APIページおよびClaude Opus 5.5 APIページに記載されています。キャッシュ操作やその他の適用料金については別途計算が必要です。
カタログのクイック比較については、Kimi K3.1 Pro 対 Claude Opus 5.5 比較ページをご利用ください。今回のKimiリリースの背景については、Kimi K3.1 Proの変更点をご覧ください。
ベンチマークが示すコーディング能力と、そこから漏れるもの
Moonshot社の公開されたローンチ比較によると、Terminal-Bench 4.0においてKimi K3.1 Proは65.7%、Opus 5.5は66.4%を記録しています。これらはベンダーが公開した数値であり、その特定の比較に関する独立した検証はまだ行われていません。これらはターミナルベースの作業においてKimiを真剣に検討する根拠にはなりますが、アプリケーション開発全体における同等のパフォーマンスを保証するものではありません。
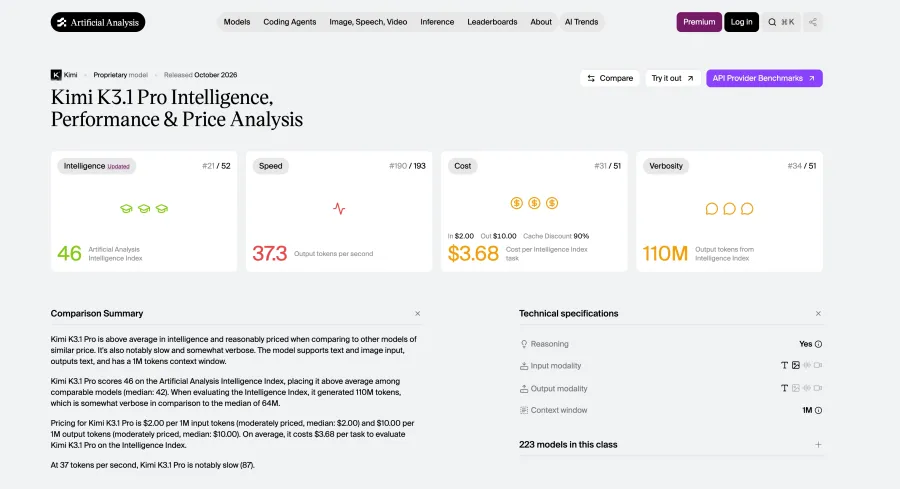
より広範な独立した見解は異なります。10月29日時点のArtificial Analysis Intelligence Index v5.0モデルページでは、Kimiが46、Opusが58となっており、後者は「Max with Default Fallback」とラベル付けされています。これらのインデックスポイントは、パーセンテージやコーディングの成功率ではありません。比較の際は、インデックスのバージョンと構成を併せて確認してください。
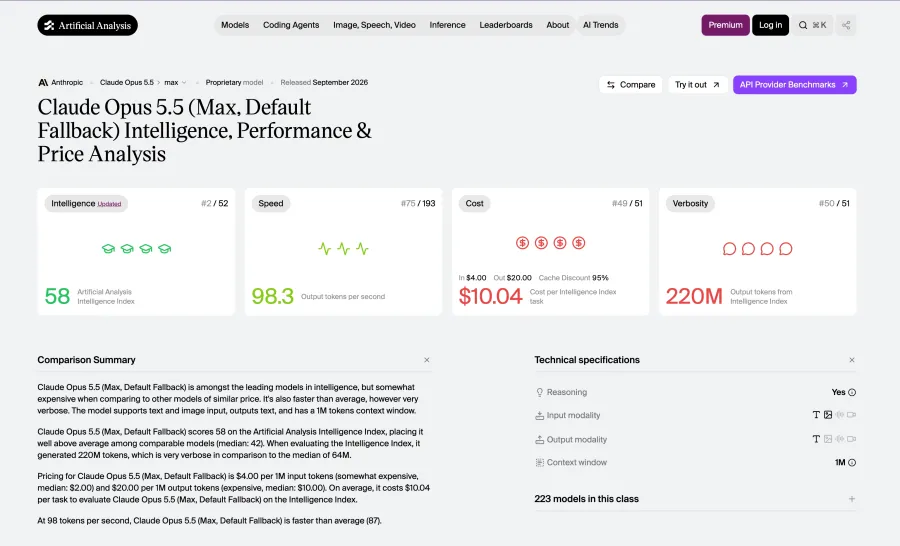
私は、要求の厳しい作業の初期品質ベースラインとしてOpusを扱い、その後、より低コストでKimiが同じ受け入れ基準を満たせるかどうかをテストすることをお勧めします。ターミナルのベンチマークでは、予約フォームが状態を保持しているか、ダッシュボードがモバイルで読みやすい状態を維持しているかまでは判断できません。それはアプリケーションのテストで確認する必要があります。
フロントエンドコーディング:スクリーンショットから動作するインターフェースへ
スクリーンショットからインターフェースを作成するタスクでは、見た目と動作を切り分けて考える必要があります。忠実なレイアウトであっても、機能するナビゲーション、フォームの状態管理、キーボード操作への対応、そして実用的なモバイル版が必要です。その上で変更を依頼しましょう。既存のレイアウトを壊さずにフィルターを追加することは、ゼロからページを生成するのとは異なるテストです。
ここに役立つ開発者の例があります。Melvynx氏が公開した比較では、タイムゾーンチェッカーの視覚的な処理においてOpusが好まれていました。これは測定されたフロントエンドの勝率というよりは、一つのビルドに対する審美的な評価です。
マーケティングサイトやクライアント向けのダッシュボードであれば、デザインに独自性や繰り返しの洗練が必要な場合、私はまずOpusを選びます。Kimiは、明確なデザインシステムを持つ社内インターフェースに適した候補であり、特にリリース前に結果を検証できる場合に有効です。トレードオフとなるのは、最初のプロンプトで曖昧にされた部分を修正するために費やす時間です。
評価の基準として、予約インターフェースを検討してみましょう。両モデルに同じ参照画像、既存のコンポーネントライブラリ、日付選択、予約不可枠、バリデーション、確認画面の要件を与えます。それぞれに、インターフェースを同じモックAPIに接続するよう指示します。次に、リクエスト失敗の状況を発生させ、ユーザーがフォームの内容を失わずに復旧できるかを確認します。
この最後のステップが、これをアプリケーションの比較たらしめています。魅力的なページが、顧客の次のアクションを適切に処理できるかどうかを明らかにします。
インタラクティブアプリと3D:視覚的品質、ロジック、および実行パフォーマンス
Kimiのケースは、インタラクティブな視覚的作業においてより興味深いものになります。Melvynx氏の溶岩ランプの例には、照明と色の制御が含まれていました。彼はOpusのより手間をかけた結果を最高と評価しましたが、Kimiの素材感やガラスの表現も説得力があると認めました。報告された実行コストは、Kimi Highで2.30ドル、Maxで4.16ドルに対し、Opus Mediumで4.35ドル、Extra Highで6.39ドルでした。
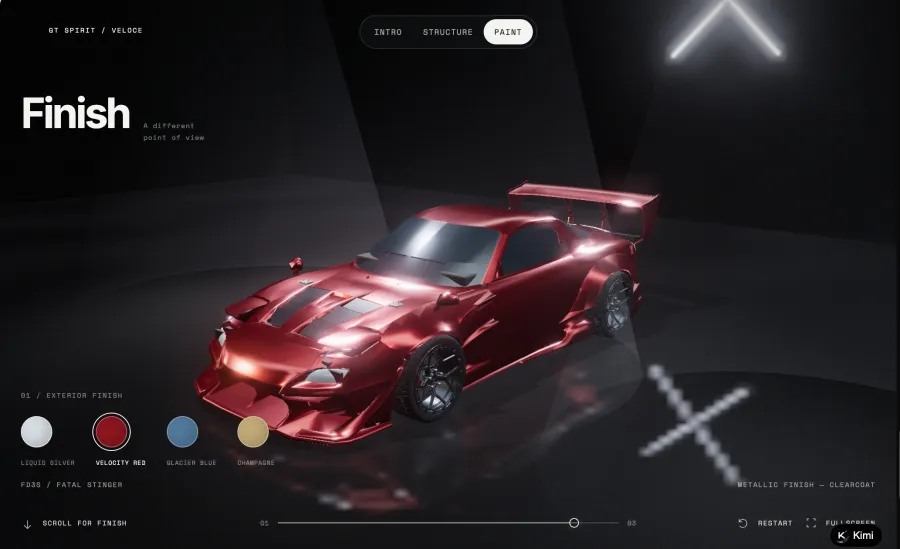
同じレビューでは、Kimi Highの方がMaxよりもクラッシュシミュレーションがうまく機能したと記述されています。著者はKimiのアフィリエイトリンクを公開しており、共有された非分離のワークスペースを使用していることを明示しています。これらの例は、そうした制限を考慮した上での有用な観察結果です。
私の解釈では、Kimiは製品コンフィギュレーター、教育用デモ、視覚的プロトタイプのテストに値します。より高い負荷設定を自動的に選択することは、これらの例から得られる実践的な教訓を見逃すことになります。明確な要件から始め、生成された成果物を検証してください。
家具コンフィギュレーターの場合、素材を選択したとき、カメラビューを切り替えたとき、あるいはデザインをリセットしたときに何が変わるべきかを定義します。表示価格が選択内容と一致するかを確認してください。ページをリロードします。スマホで操作を試します。見た目が魅力的な椅子は、成果物の一部に過ぎません。
技術的な正確さには独自のチェックが必要です。MoonshotのBenchCADの結果では、ジオメトリ再構築メトリクスを用いて、ツール使用時にKimiで92.7%、Opusで96.2%と報告されています。このベンダー公開の結果は、シーンが見栄えするかどうかという問いとは別の問題に対処しています。説得力のあるアニメーションであっても、物理学を教えたりエンジニアリングプロセスを表現したりするために使用する前には、個別の検証が必要です。
プロトタイプであれば、私はまずKimiを試します。精度が求められるアプリケーションであれば、Opusから始め、どちらのモデルがコードを生成するにせよ、ドメイン固有のチェックを必須とします。
エージェントによる開発:モデルはマルチステップのタスクを完遂できるか?
リポジトリ内で作業するエージェントは、既存の動作を理解し、変更するファイルを選択し、ツールを実行し、失敗を解釈し、いつ停止すべきかを判断しなければなりません。それらのステップの間でミスが蓄積される可能性があります。
両ベンダーとも、拡張的な作業の例を公開しています。Moonshotは、Kimiが歩行コントローラーを再トレーニングする前にシミュレーターを診断・修正する様子を説明しています。AnthropicのOpus 5.5ローンチレポートでは、Webアプリケーション全体での改善について説明されており、ロード時間のタスクが40回の試行中39回成功したことなどが挙げられています。これらは共通の直接比較テストではなく、ベンダー各社による個別の事例です。
既存の請求書発行アプリケーションの場合、CSVインポートの追加が有用な比較対象となるでしょう。フィールドマッピング、無効な行の処理、重複検出、プレビュー、および既存の動作を網羅するテストが必要です。各モデルに同じリポジトリスナップショットから作業させ、両方のパッチを検証してください。「すべてのテストに合格」という要約には、その裏付けとなるテストログが必要です。
そのようなファイル横断的な変更については、Opusをデフォルトの開始点とします。Kimiは、合意されたスキーマに対するバリデーションの実装など、ジョブの限定的な部分で評価する方が容易です。テストによって周辺のアプリケーションを扱えることが確認できてから、その範囲を拡大してください。
設定も重要です。Kimiのツール使用ガイダンスでは、ターン全体を通じて完全なアシスタントメッセージを保持する必要があります。ClaudeのOpusドキュメントには、モデル固有の思考とツールの動作が記載されています。選択したルートでそれらの詳細を確認してください。基本的なリクエスト形式を合わせるだけでは、同一のエージェント動作を確立したことにはなりません。
価格とコスト:承認された結果には実際いくらかかるのか?
Kimi K3.1 Proの方が標準の入力および出力料金は低く設定されています。より難しい問題は、タスクに何回の呼び出し、再試行、レビューサイクルが必要かということです。
以下は、GPT Protoの記載料金を使用した計画例です。各試行で100万トークンのキャッシュなし入力と20万トークンの課金対象出力を使用すると仮定します。これらは仮定のボリュームであり、実際のアプリケーション結果を観測したものではありません。
| 計画シナリオ |
Kimi K3.1 Pro |
Claude Opus 5.5 |
| 記載ボリュームでの1回の試行 |
$4.00 |
$7.20 |
| 同じボリュームでの2回の試行 |
$8.00 |
$14.40 |
これらの前提に基づくと、2回の試行を必要とするKimiの結果は、1回で承認されたOpusの結果よりもトークンコストが高くなります。実際の再試行で全く同じトークンボリュームが繰り返されることは稀ですので、実際の計算にはご自身の利用記録を使用してください。
キャッシュによって比較は再び変わります。両ベンダーとも、公式のキャッシュ読み取り料金を100万トークンあたり0.20ドルと、それぞれのKimiおよびClaudeドキュメントに記載しています。広範なキャッシュヒットを伴う長いエージェントセッションでは、新規リクエストとは異なるコスト比率になります。キャッシュ書き込み料金、出力使用量、およびプロバイダーの実際の料金も確認してください。
チームの場合、承認されたタスクあたりのコストを、経過時間やレビュー担当者の作業時間と併せて追跡することをお勧めします。安価なドラフトは、確認が迅速であれば価値があります。しかし、開発者がエージェントの変更内容を信頼する前に再構築しなければならない場合、その魅力は低下します。
GPT Protoを使用して独自のアプリで両モデルを比較する方法
目に見える結果が得られる小さなアプリケーションの変更を使用してください。予約フォーム、CSVインポーター、または製品コンフィギュレーターを使用する方が、「何か印象的なものを作って」という制限のないリクエストよりも、はるかに有用な証拠が得られます。
KimiモデルページとOpusモデルページを開きます。「このモデルを試す」および「クイックスタート」を使用して統合ガイドを取得し、Markdown形式の指示をコーディングアシスタントにコピーしてください。APIキーはローカル環境変数またはサーバー側の構成に保持してください。
開発品質を評価する前に、両方のモデルルートが応答することを確認してください。この接続例は、モデルページで公開されているChat Completions形式に従っています。実行前にローカルでGPTPROTO_API_KEYを設定してください。リクエストには有料トークンが消費されます。
for model in kimi-k3.1-pro claude-opus-5-5; do
  curl --fail-with-body --silent --show-error --max-time 180 \
    https://gptproto.com/v1/chat/completions \
    -H "Authorization: Bearer $GPTPROTO_API_KEY" \
    -H "Content-Type: application/json" \
    --data "{
      \"model\": \"$model\",
      \"messages\": [{\"role\": \"user\",
        \"content\": \"Return only: API connection OK\"}]
    }"
done
これは接続を確認するものであり、コーディングの品質を評価するものではありません。ネイティブAPIにはそれぞれ異なるデフォルトの推論設定があるため、アプリケーションの比較を行う前に、サポートされている推論設定を構成して記録してください。また、APIの応答には、ファイルの編集、ツールの実行、ブラウザの検査を行うためのエージェントやアプリケーションが必要です。
開発トライアルでは、同じプロジェクトのクリーンなコピーから各モデルを開始してください。同じタスク、権限、依存関係、および受け入れテストを提供します。モデルルート、推論設定、課金対象の使用量、完了時間、および必要な手動修正を記録してください。本番環境のデフォルト設定を変更する前に、タスクを繰り返して検証してください。
エンドポイントが認証エラーを返す場合は、キーと認証ヘッダーを確認してください。オプションのパラメータが拒否された場合は、現在のモデルページガイドと比較してください。ジョブを拡大する前に、成功したレスポンスに意図したモデルの出力が含まれていることを確認してください。
どちらのモデルを選ぶべきか?
| ワークロード |
最初の選択肢 |
継続利用の条件 |
| デザイン修正が繰り返されるクライアント向けフロントエンド |
Opus 5.5 |
承認される出力の質がコストに見合う場合 |
| インタラクティブなプロトタイプや視覚的な実験 |
Kimi K3.1 Pro |
制御が機能し、成果物の検証が容易な場合 |
| 既存アプリケーションへの複雑な変更 |
Opus 5.5 |
リポジトリのテストとレビューがその選択を裏付ける場合 |
| 固定された仕様に基づく反復的な実装 |
Kimi K3.1 Pro |
自動チェックにより修正コストが低く抑えられる場合 |
| 精度が求められるコードやシミュレーション |
初期ベースラインとしてOpusを選択 |
いずれのモデルでも外部検証が必要な場合 |
エージェントに本格的なアプリケーション開発を任せるチームにとって、初期のデフォルトとしてはOpus 5.5を選択します。広範な評価結果がその選択を裏付けており、実際のプロジェクトでそのプレミアムな価値に見合う成果が得られるかを判断するのが賢明です。
Kimi K3.1 Proは、明確に定義された作業のコストを削減するための実用的な候補です。まずは検証やテストが可能なタスクから始め、承認された結果を測定し、実績に応じてより大きな責任を任せていくのが良いでしょう。これは、ベンチマーク上の僅差よりも、切り替えるための強力な理由となります。
小さなタスクを1つ選び、Kimi K3.1 Pro API と Claude Opus 5.5 API のページで統合ガイドを利用して試し、アプリケーションが受け入れ可能な結果を比較してみてください。