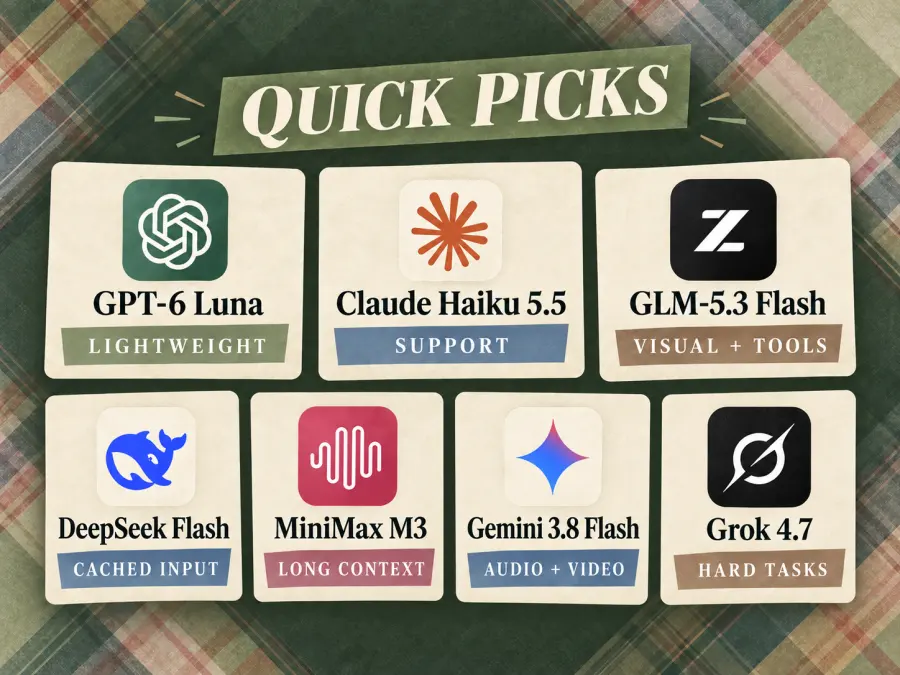
エージェント向けの手頃なLLM API一覧
このショートリストは、モデルをテストする価値のある用途別に分類したものです。これは公開されている機能と価格に基づいた編集上の選定であり、非公開の直接的な性能ランキングではありません。
| モデル |
GPT Protoモデル文字列 |
公開されているGPT Protoの100万トークンあたりの入力/出力料金 |
最初にテストすべきワークロード |
| GPT-6 Luna |
gpt-6-luna |
$0.08 / $0.40 |
分類、抽出、ルーティング |
| Claude Haiku 5.5 |
モデルページのクイックスタートを参照 |
100Kトークン以下のプロンプトで$0.09 / $0.45 |
反復的なサポートタスクおよびコーディングのサブタスク |
| GLM-5.3 Flash |
glm-5.3-flash |
$0.15 / $0.50 |
視覚およびツール駆動型のワークフロー |
| DeepSeek Flash |
deepseek-flash |
$0.30 / $1.20 |
繰り返される指示およびキャッシュを多用する入力 |
| MiniMax M3 |
MiniMax-M3 |
$0.48 / $0.96 |
長文ドキュメントおよびリサーチセッション |
| Gemini 3.8 Flash |
gemini-3.8-flash |
$0.90 / $4.50 |
音声、動画、画像、およびPDFワークフロー |
| Grok 4.7 |
grok-4.7 |
$1.20 / $3.60 |
難易度の高いコーディングおよび多段階のエスカレーション |
料金は2026年10月8日に確認済みです。これらはGPT Protoの料金であり、プロバイダー直販のプロモーション価格ではありません。Haiku 5.5は、100Kトークンを超えるプロンプトの場合、100万トークンあたり入力$0.45、出力$2.25となります。予算を立てる前に、各モデルページで適用されるコンテキストティア、キャッシュ料金、サービスティア、および最新の料金を確認してください。
導入前の比較: GPT Protoで利用可能なAIモデルを閲覧し、ショートリストに載せたモデルIDを構成設定内に保持しておくことで、エージェント全体を再構築することなく切り替えが可能になります。
エージェントAI向けの手頃なLLMをランク付けした方法
サイモン・ウィリソン氏は、有用な定義を提示しています。「LLMエージェントとは、目標を達成するためにツールをループ内で実行するもの」です。そのループが、手頃な価格の測定方法を変えます。通常のチャットボットの比較では1回の応答コストに焦点を当てることができますが、エージェントの比較では、ツール呼び出し、ツールの結果、再試行、推論トークン、および失敗した実行回数もカウントする必要があります。
評価には以下の順序を使用しました。
1. モデルはエージェント機能のゲートを通過しなければならない
単にトークン価格が安いという理由だけでモデルを含めることはしませんでした。ショートリストの各オプションには、関数呼び出しやツール使用のための文書化されたルートに加え、構造化データを返したり、複数ターンのワークフローを継続したりするための実用的な方法が必要でした。
2. 一般的な知識スコアよりも、公開されたエージェントの評価指標が重要
Berkeley Function Calling Leaderboardは、ツール使用の評価において何を検証すべきか(正しい関数の選択、有効な引数、マルチターンでの挙動、ツール呼び出しを避けるべきケースなど)を理解する上で特に有用です。ただし、その公開リーダーボードの最終更新日は2026年4月12日であり、本記事で取り上げるモデルのほとんどよりも古いものです。そのため、私たちは古いスコアを新しいリリースに適用するのではなく、その評価手法を採用しています。
また、Artificial Analysisも参照しています。同社のIntelligence Indexには、エージェントによるナレッジワーク、実務、SaaS自動化、ターミナル操作、長文コンテキストの評価が含まれています。これは純粋な関数呼び出しスコアではなく複合的な指標であるため、特定のエージェントに対する保証ではなく、スクリーニングの証拠として扱うべきです。
3. トークン単価よりも、タスク成功あたりのコストが重要
実用的な本番環境の指標は以下の通りです:
タスク成功あたりのコスト = すべての試行と再試行のAPIコスト合計 / 完了したタスク数
この計算には、キャッシュされていない入力、キャッシュされた入力、出力、該当する場合は隠れた推論トークンや課金対象の推論トークン、失敗した試行、リカバリのための呼び出しを含める必要があります。あるモデルが100タスク中90タスクを完了し、別のモデルが60タスクしか完了できない場合、トークン単価のみを比較していては、残りのタスクを修正するためのコストが見えなくなってしまいます。
4. 速度、冗長性、統合の摩擦がコストに影響する
1秒あたりの出力トークン数は、生成フェーズのみを測定するものです。これでは、最初の回答までの時間、内部推論、ツール実行、レート制限による遅延、繰り返し呼び出しなどは考慮されません。また、冗長なモデルは、出力単価が低くても最終的な請求額が高くなる可能性があります。
最後に、類似したAPIであってもモデル固有のルールが存在します。推論フィールド、サポートされていないサンプリングパラメータ、関数応答ID、モデル名の大文字・小文字の区別などは、移植可能なはずのワークフローを壊す原因となります。そのため、すべての項目に正確なGPT Protoモデル文字列を記載しています。
1. GPT-6 Luna — 軽量かつ大量のAIエージェント処理に最適
GPT-6 Lunaは、チケットの分類、製品属性の抽出、ワークフローの選択、ツール実行結果の要約など、頻繁に発生する限定的なリクエストに対して私たちが最初に推奨するモデルです。GPT Protoでの価格は入力トークン100万あたり0.08ドル、出力トークン100万あたり0.40ドルとなっており、本リストの中で最も低い入力・出力レートを誇ります。
このモデルはテキストと画像に対応し、構造化出力をサポートしており、105万トークンのコンテキストウィンドウを提供します。推論能力を調整できるため、開発者はタスクに必要な労力をテストすることが可能です。単純なルーティングの判断に、曖昧なコーディング問題と同じ設定が必要になることはほとんどありません。
ツール呼び出しコントローラーとして使用する前に、確認すべき互換性の詳細があります。OpenAIはResponsesを通じた推論有効化の関数呼び出しを文書化していますが、Chat Completionsで関数呼び出しをサポートするのはreasoning_effort: "none"の場合のみです。GPT ProtoモデルページのTry this modelクイックスタートを使用して、ルートとサポートされているフィールドを確認してください。
Lunaの役割は、安価な第一層としての活用です。ルーチン的なステップを処理し、明確な失敗や複雑さの兆候が見られた場合に、より高性能なモデルに引き継ぐことができます。トークン単価の安さは、最初のステップが正確であってこそ活きてきます。そのトレードオフについて詳しく知るには、コーディングやエージェントワークロードにおけるGPT-6 LunaとGPT-6 Solの比較をご覧ください。
GPT-6 Lunaを選ぶべき場面:
ワークフローに大量の分類、抽出、または要約が含まれている場合
各ステップに明確なスキーマがあり、アプリケーション側で結果を検証できる場合
既存のOpenAI互換アプリケーションに対して低コストなベースラインを求めている場合
困難なケースを無期限に再試行するのではなく、エスカレーションできる場合
注意点: エンドポイント固有のツールサポートと、繰り返される検証エラーに注意してください。Lunaは限定的な作業に使用し、複雑な計画やリカバリにはより強力なモデルを評価してください。
2. Claude Haiku 5.5 — 低コストのサポート業務とClaudeエージェントのステップに最適
Claude Haiku 5.5は、反復的なサポート業務、会話の要約、分類、および小規模なコーディングタスクにおいて強力な選択肢となります。2026年10月7日にリリースされたこのモデルは、Haikuティアに調整可能な「努力(effort)」レベルをもたらし、より大規模なClaudeモデルと組み合わせたワークフローにおいて、コスト効率の高いワーカーとして機能します。
GPT Protoは、Haiku 5.5を公式料金より10%安い価格で提供しています。最大100K入力トークンのリクエストの場合、入力100万トークンあたり0.09ドル、出力100万トークンあたり0.45ドルとなります。100K入力トークンを超える場合、料金は入力0.45ドル、出力2.25ドルとなります。
このしきい値は、最大コンテキストウィンドウよりも重要です。Haikuは1Mのコンテキストをサポートしていますが、会話が長くなると、その容量に達するよりもずっと前に高い価格ティアに移行する可能性があります。このしきい値は、保持された会話やツールの結果を含む、各リクエストの入力に適用されます。
適応型思考(Adaptive thinking)はデフォルトで有効になっており、「努力」レベルによってモデルがタスクに費やす作業量を制御できます。まずは焦点を絞ったリクエストから開始し、努力レベルを上げる前に、完了の品質、レイテンシ、および課金対象トークンを比較してください。
Claude Haiku 5.5を選ぶべき場面:
エージェントが繰り返し発生するサポートの質問やチケットのトリアージを処理する場合
要約や圧縮された会話状態がワークフローの頻繁なステップである場合
Claudeベースのコーディングワークフローで、特定のサブタスクの支援が必要な場合
ほとんどのリクエストが低いプロンプト長の価格ティアに収まる場合
注意点: 入力トークンが100Kを超えるリクエスト。再利用可能な状態をコンパクトに保ち、特に長い会話ではリクエスト全体のコストを確認してください。
3. GLM-5.3 Flash — 低コストの視覚およびツール駆動型エージェントに最適
GLM-5.3 Flashは、視覚的な証拠と外部ツールを組み合わせるワークフローにおいて、最も有用な候補の1つです。公開されているGPT Protoの料金は、入力100万トークンあたり0.15ドル、出力100万トークンあたり0.50ドルです。
Z.aiは、テキスト、画像、動画、ファイルのネイティブ入力サポートと、1Mトークンのコンテキストウィンドウを文書化しています。関数呼び出し、構造化JSON、キャッシュ、ストリーミング、およびストリーミングされたツール引数は、ドキュメントやインターフェースを検査して次のステップに進むエージェントにとって重要です。
実用的な例として、視覚的なQAワークフローがあります。スクリーンショットを検査し、レイアウトの問題を特定し、コードの変更を提案し、アプリケーションのツールを通じてレンダリングされた結果を確認します。モデルは判断と引数を提供し、周囲のエージェントがブラウザ、コード実行、検証を提供します。
主なトレードオフは、常にオンになっている推論機能です。これは曖昧な判断には役立ちますが、基本的なラベル付けや抽出にはオーバーヘッドが生じます。このリストの中では、GPT-6 LunaとHaiku 5.5の方が短いリクエストのトークン単価が低くなっています。
GLM-5.3 Flashを選ぶべき場面:
スクリーンショット、チャート、ドキュメント、または動画の証拠が次のアクションに影響を与える場合
ワークフローでツール呼び出しと構造化された結果が必要な場合
視覚的なコーディングや反復的なインターフェースチェックがタスクの一部である場合
ホストされたAPIアクセスと併せてオープンウェイトが有用な場合
注意点: 推論と出力のボリューム。生成されるトークンとワークフローのステップに制限を設定してください。「Flash」という名前は、エンドツーエンドのレイテンシを保証するものではありません。
4. DeepSeek Flash — キャッシュを活用する入力負荷の高いAIエージェントに最適
DeepSeek Flashは、DeepSeek V4.1 Flashのルート名です。バージョン名を別のAPIティアとして扱うのではなく、リクエスト内でdeepseek-flashを使用してください。GPT Protoに表示されている入出力レートは、100万トークンあたり$0.30 / $1.20です。
このモデルは、テキストと画像の入力、最大100万トークンのコンテキストウィンドウ、ツール呼び出し、JSON出力、ストリーミング、および思考モード(thinking)と非思考モードの動作を組み合わせたものです。この組み合わせは、比較的小さな結果を生成する前に、リポジトリファイル、指示、ドキュメント、またはツール履歴を繰り返し読み込むエージェントに適しています。
入力負荷の高いモデルの候補としてこのモデルを挙げた理由は、キャッシュ機能にあります。安定した指示やツール定義は多くの呼び出しで再利用できますが、節約効果は実際のキャッシュヒット率に依存します。ターンごとに大幅に変更される長いプロンプトについては、別の予算計画を立てる必要があります。
状態管理にも注意が必要です。ネイティブの思考モードを使用したツールワークフローでは、呼び出し間で推論状態を保持する必要がある場合があります。マルチターンのループを移行する前に、選択したGPT Protoエンドポイントがその状態をどのように表現しているかを確認してください。最初の応答が有効であっても、会話全体にわたって互換性が維持されるとは限りません。
DeepSeek Flashを選ぶべきケース:
繰り返し使用される指示や参照資料があり、キャッシュが有効な場合
リポジトリの調査やドキュメント分析が入力ボリュームの大半を占める場合
思考モードと非思考モードを切り替えるワークフローが有益な場合
同じタスク内でテキストに画像のエビデンスを添える必要がある場合
注意点: キャッシュミス、冗長な出力、ツール呼び出し状態の喪失に注意してください。キャッシュ率のみから節約額を見積もるのではなく、ループ全体を測定してください。
5. MiniMax M3 — 長文ドキュメントやリサーチエージェントに最適
MiniMax M3は、エージェントが大量のドキュメントや長い作業履歴を扱う必要がある場合に検討する価値があります。GPT Protoにおけるモデル文字列はMiniMax-M3で、料金は入力100万トークンあたり0.48ドル、出力100万トークンあたり0.96ドルと表示されています。
このモデルはツール利用、長文コンテキストでのコーディング、およびエージェントワークフローをサポートしており、コンテキストウィンドウは約100万トークンまで対応しています。ドキュメントを多用する作業(ポリシーの比較、サポート履歴の確認、参照ファイル間の関係性の追跡、中間リサーチ結果の保持など)に適しています。
価格のトレードオフについては明確な説明が必要です。MiniMaxの現在の直接料金は、入力512Kトークンまでのプロンプトに対して入力100万トークンあたり0.30ドル、出力100万トークンあたり1.20ドルです。これらの料金を比較すると、GPT Protoの方が出力コストは安く、直接利用の方が入力コストは安くなります。どちらの提示価格がすべてのワークロードにおいて安価になるかは一概には言えません。
また、コンテキストウィンドウが大きいからといって、検索や検証が不要になるわけではありません。エージェントにアーカイブ全体を読み込ませると、適切な証拠を見つける助けにならないままコストだけが増加する可能性があります。
MiniMax M3を選ぶべき場面:
タスクが複数のドキュメントや長期的な作業履歴に依存している場合
エージェントが複数のステップにわたって中間的な調査結果を保持する必要がある場合
生成されるレポートや説明文により、出力コストが重要になる場合
ホスト型アクセスを通じてオープンウェイトモデルを評価したい場合
注意点: 蓄積される高額な入力コストと、長いドキュメント内での証拠の見落とし。ドキュメントを横断した推論をテストし、選択したルートの入力能力を確認してください。
6. Gemini 3.8 Flash — 音声、動画、マルチメディアエージェントに最適
Gemini 3.8 Flashは、タスクに音声、動画、画像、PDF、テキストが含まれる場合に真価を発揮します。GPT Protoでは、入力100万トークンあたり0.90ドル、出力100万トークンあたり4.50ドルでgemini-3.8-flashルートを利用できます。
このモデルは約100万トークンの入力ウィンドウを持ち、思考プロセスの調整、関数呼び出し、構造化出力をサポートしています。顧客の動画を確認し、関連ドキュメントを読み込み、次のアクションを準備するようなワークフローにおいて、実用的な選択肢となります。
このモデルの価値は、これらの入力によって代替できる作業量にあります。複数のメディアタイプを理解できるエージェントであれば、個別の処理段階を減らせる可能性があります。アップストリームモデルのツールエコシステムがすべて利用可能であると想定する前に、GPT Protoのルートでサポートされているファイル形式とリクエストマッピングを確認してください。
ここにある選択肢の中で、トークン単価が最も安いわけではありません。Googleの直接の導入価格は、2026年12月31日まで入力100万トークンあたり0.75ドル、出力100万トークンあたり3.75ドルであり、GPT Protoの表示価格よりも低くなっています。このルートを利用する理由は、単一のアカウントと残高で他のモデルと併用できる利便性にあります。
Gemini 3.8 Flashを選ぶべき場面:
音声や動画がタスクの中心である場合
同一のワークフローで複数のメディアタイプを検査する必要がある場合
マルチモーダルモデルによって個別の前処理段階を簡素化できる場合
日常的なリクエストから困難なリクエストまで、調整可能な推論が役立つ場合
注意点: 出力コストとプロバイダー固有のツールサポートに注意してください。生成速度の数値に頼るのではなく、完成したワークフローでベンチマークを行ってください。
7. Grok 4.7 — 難易度の高いコーディングや多段階のエスカレーションに最適
Grok 4.7は、本リストにおけるエスカレーション(段階的引き上げ)の選択肢です。GPT Protoでは、入力トークン100万あたり1.20ドル、出力トークン100万あたり3.60ドルで既にリストされており、Grok 4.6と同一の料金設定となっています。
このモデルはテキストと画像に対応し、関数呼び出しと構造化出力もサポートしており、500Kトークンのコンテキストウィンドウを提供します。推論レベルは「低」「中」「高」「超高」の4段階あり、開発者は困難なタスクにどれだけの労力が必要かをテストできます。
そのため、エージェントが失敗したコード変更の診断、複数の依存するツール結果の調整、あるいは検証失敗後の計画の再検討を行う必要がある場合に有効です。日常的な準備作業は低コストモデルで処理し、困難なステップのみをGrokに任せることができます。
制限は技術的なものというより経済的なものです。すべての抽出やルーティングのリクエストをエスカレーションモデルに送信すると、より強力な推論が必要になる前にコストが嵩んでしまいます。また、同じトークン単価の新しいリリースであっても、タスク完了時の請求額が低くなるとは限りません。既存のアプリケーションが既にGrok 4.6に依存している場合は、両方のバージョンを比較してください。
Grok 4.7を選ぶべき場面:
コーディングや調査タスクにおいて、複数の依存する判断が必要な場合。
低コストのルートが、定義された受け入れ基準を繰り返し満たせない場合。
画像による証拠と推論を組み合わせて検討する必要がある場合。
成功による回復が、追加のモデル費用に見合う価値がある場合。
注意点: 高コストな再試行や過度な推論の労力に注意してください。定義されたエスカレーションパスに沿って使用し、他のモデルでは提供できない権限や不足している入力がタスクに必要になった時点で停止するようにしてください。
安価なトークンでもエージェントのタスクが高額になる理由
トークン単価が低いことは、繰り返しの分類や書き換えには役立ちます。しかし、ツールを選択し、その結果を解釈し、失敗から回復しなければならないエージェントについては、それだけでは判断できません。
モデルは安価な応答を生成する一方で、間違った関数を繰り返し選択したり、必要な引数を省略したりする可能性があります。修正のたびにモデルの呼び出しが増え、会話履歴が長くなり、場合によっては別のツール操作が発生します。エージェントが許容可能な結果を出す前に、タスクが高額になってしまうことがあります。
モデルにワークフローの制御を任せる前に、以下のことができるか確認してください:
まずは受け入れ基準を設定し、それを満たすモデルの総コストを比較してください。単純な抽出ステップと、複数のツールを制御するコントローラーでは、同じモデルを使う必要はありません。
実用的な低コストモデルルーティング戦略
1つのエージェント内で、ステップごとに異なるモデルを割り当てることができます。ルーチン的な準備作業には低コストなルートを、高度な推論が必要な作業にはエスカレーションルートを割り当てます。アプリケーションは、タスクの種類、検証結果、支出制限に基づいてその選択を行います。
| エージェントタスク |
最初に評価するモデル |
エスカレーションまたはルート変更の条件 |
| 分類、抽出、リクエストルーティング |
GPT-6 Luna |
出力が検証に失敗した、またはリクエストが曖昧な場合 |
| 反復的なサポートおよびClaudeコーディングのサブタスク |
Claude Haiku 5.5 |
より広範な計画が必要、または繰り返しの試行が失敗した場合。入力が100Kを超える場合はコストを確認してください |
| 視覚的チェックおよびドキュメントベースのツールワークフロー |
GLM-5.3 Flash |
モデルが矛盾する証拠を解決できない、または検証を完了できない場合 |
| 繰り返しの多い、キャッシュ負荷の高いコンテキスト |
DeepSeek Flash |
状態が失われた、ツール処理が失敗した、または測定されたキャッシュ節約が実現しない場合 |
| 長いドキュメントおよびリサーチセッション |
MiniMax M3 |
重要なドキュメント間の関連性が見落とされている場合 |
| 音声、動画、および混合メディア入力 |
Gemini 3.8 Flash |
抽出された証拠に、より困難な別の計画ステップが必要な場合 |
| 困難なコーディングおよびマルチステップのリカバリ |
Grok 4.7 |
ワークフローが時間、ステップ、または支出制限に達した場合 |
これらは評価を開始するための出発点です。検証の失敗は、モデルだけでなく、プロンプト、ツール定義、またはアプリケーションに起因する可能性があります。より高コストなルートに切り替える前に、原因を調査してください。
エージェントのコストを管理するための5つのルール:
タスクの受け入れチェックに合格した後にのみ、低コストモデルを使用する。
実行前にツール引数を検証する。
各実行におけるモデル呼び出し、出力トークン、経過時間、および支出に上限を設ける。
同じリクエストを無期限に再試行するのではなく、リカバリまたはエスカレーションルールを定義する。
アクションがエージェントの権限を超える場合は、承認のために停止する。
GPT Protoは、1つのAPIキーと共有残高でサポート対象モデルへのアクセスを提供します。ルーティング、状態管理、ツール実行、および停止条件の管理は、引き続きアプリケーションまたはフレームワーク側で行われます。モデルへのアクセスを比較し、既存のワークフローのコストを見積もるには、AIエージェント向けLLM APIページをご覧ください。境界付きルーティングや分類ステップについては、決定をより高価なエージェントモデルに割り当てる前に、Jevと汎用LLMを比較してください。
GPT Protoによる最小限のツール呼び出しリクエスト
この例では glm-5.3-flash を使用し、アプリケーションが実行可能なツールとして get_order_status を定義しています。モデルのレスポンスがその関数を要求する場合がありますが、リクエスト自体がモデルに注文システムへのアクセス権を与えるわけではありません。
GLM-5.3 Flashモデルページ を開き、現在のクイックスタート用に Try this model を選択してから、サーバー側のAPIキーを例に提供してください。
curl https://gptproto.com/v1/chat/completions \
  -H "Authorization: Bearer $GPTPROTO_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "glm-5.3-flash",
    "messages": [
      {
        "role": "user",
        "content": "Where is order A-1042?"
      }
    ],
    "tools": [
      {
        "type": "function",
        "function": {
          "name": "get_order_status",
          "description": "Return the current status of one order.",
          "parameters": {
            "type": "object",
            "properties": {
              "order_id": {
                "type": "string",
                "description": "The order identifier."
              }
            },
            "required": ["order_id"],
            "additionalProperties": false
          }
        }
      }
    ],
    "tool_choice": "auto"
  }'
OpenAI互換のChat Completionsレスポンスについては、choices[0].message.tool_calls を確認してください。返された各呼び出しに対して、以下の手順を実行します:
そのユーザーとタスクに対して関数が許可されているか確認する;
引数を解析および検証する;
アプリケーション内で関数を実行する;
一致する tool_call_id を含むツールメッセージで結果を返す;
必要な推論状態を保持したまま、次のモデルレスポンスを要求する。
モデルを切り替えるには互換性の確認が必要です。GPT-6 LunaのアップストリームChat Completionsツール呼び出しには reasoning_effort: "none" が必要です。推論が有効な関数呼び出しではレスポンスが使用されます。他のルートでは、状態やパラメータの要件が異なる場合があります。同じペイロードがどこでも機能すると想定せず、各モデルのクイックスタートを確認してください。
これはツールループにおける最初のリクエストです。アプリケーションは、ツールの実行とそれに続くメッセージを提供する必要があります。
エージェント向けの手頃なLLM APIをテストする方法
アプリケーションの代表的なタスクを使用してください。一般的なベンチマークは候補を絞り込むのに役立ちますが、モデルは実際のツール名、データ、および受け入れルールに対応できる必要があります。
以下の4つのカテゴリから始めましょう:
ツールの選択: 類似した機能を提供し、モデルが正しいツールを選択できるかを確認します。
複数のツール: 2つの独立した結果を必要とするリクエストを与えます。ルートがサポートしている場合は並列呼び出しをテストするか、連続したターンで両方を完了させます。
ツール不要のリクエスト: 利用可能などのツールも呼び出すべきではない質問を含めます。
リカバリ: 現実的なツールエラーを返し、モデルが無期限にループすることなく次のステップを修正できるかを確認します。
指示、ツール定義、入力データ、および受け入れ基準を一貫させてください。各ルートでサポートされている設定を使用し、そのエンドポイントと推論設定を記録します。パラメータ名はプロバイダー間で必ずしも互換性があるとは限りません。
各カテゴリをモデルごとに少なくとも5回実行してください。7つのモデル、4つのカテゴリ、5回の繰り返しで、初期比較には140回の実行が含まれます。これはパイロット評価の設計であり、これらの実行がすでに完了していることや、5回の繰り返しで本番環境の信頼性が確立されることを主張するものではありません。
記録項目:
計算:
受け入れられたタスクあたりのコスト = 評価全体のAPI総支出 / 受け入れられた完了数
特にモデルがタスクを一つも受け入れなかった場合は、失敗を個別に報告してください。品質しきい値を確認した後にのみコストを比較し、その後、本番環境で重要な失敗ケースを中心に評価を拡大してください。
エージェント開発者が語るレイテンシについて
コミュニティの報告は、価格ページでは得られないコンテキストを提供します。あるAIエージェントコミュニティの議論では、単純な検索システムは1秒未満で回答したのに対し、よりエージェント的なバージョンでは3秒近くかかったと報告されています。カスタマーサポートにとって、その差は致命的な問題であると説明されました。
他の参加者は、この一般的な結論に異議を唱えました。彼らは、リサーチや社内分析のユーザーは、ツールの使用によって回答が大幅に改善されるのであれば、はるかに長い待ち時間を受け入れる可能性があると指摘しました。ここから得られる有益な教訓は、「3秒は常に遅すぎる」ということではありません。レイテンシ、品質、失敗コストの価値はそれぞれ異なるため、同じモデルでも、あるエージェントにとっては手頃であっても、別のエージェントにとっては不適切になり得るということです。
コミュニティのコメントはベンチマーク結果ではなく、経験報告として扱ってください。それらを使用して、独自の評価における失敗ケースを特定しましょう。
自身のエージェントについては、生成速度だけでなく、最初の有用な回答までの時間とタスク完了までの時間を測定してください。モデルは素早く開始できても、完了までにさらに数ターンかかる場合があります。したがって、インタラクティブなサポートとバックグラウンドのリサーチでは、同じAPIルートを使用する場合でも、異なるレイテンシ目標が必要になる可能性があります。
最終的な推奨事項
頻繁かつ限定的なステップには、まず GPT-6 Luna から始めてください。これは、このリストの中で最も低い基本入力/出力レートを提示しており、アプリケーションで検証可能なリクエストに適しています。
反復的なサポートやClaudeのコーディングサブタスクには Claude Haiku 5.5 を選択し、100K入力の価格しきい値を意識してください。スクリーンショット、ドキュメント、その他の視覚的な証拠が次のツールアクションを導く場合は、GLM-5.3 Flash を使用してください。
繰り返しが多くキャッシュを多用する入力には DeepSeek Flash を、長いドキュメントセッションには MiniMax M3 を評価してください。音声や動画の理解によって個別の処理段階を減らす必要がある場合は、Gemini 3.8 Flash を選択してください。困難なコーディングや多段階のリカバリには Grok 4.7 を確保しておきましょう。
最終的な選択は、測定されたワークフローコストが最も低く、許容目標に達するモデルであるべきです。トークンレートを使用して候補リストを作成し、その後、失敗した実行、推論、ツール、再試行を考慮して決定を下してください。
候補リストを接続する準備はできましたか?GPT Protoの AIエージェント向けLLM API を探索して、サポートされているモデル、ワークロードの見積もり、および1つのキーと共有残高によるアクセスを確認してください。各モデルページの このモデルを試す パネルを使用してクイックスタートを行い、スケーリングの前に GPT Protoの価格 を確認してください。