ClaudeとChatGPTでは、コーディングにどちらが優れていますか? Claudeは通常、インタラクティブな開発、フロントエンドの反復作業、リポジトリ全体にわたる推論に適しています。Codexを備えたChatGPTは、ターミナルを多用するタスクや長時間の自律的なジョブでより強力なことが多いです。定型的な生成、Pythonスクリプト、独立したデバッグでは、選択したモデル、与えられたコンテキスト、コードを実行できるかどうかが、ブランドよりも重要です。 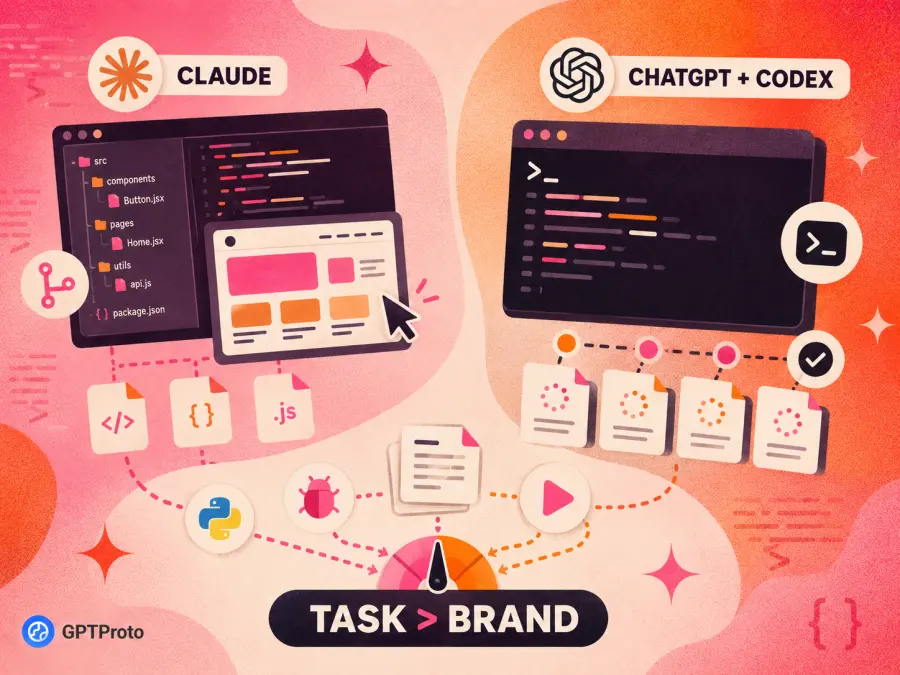
有用なClaude vs ChatGPTのコーディング比較では、Claude CodeとCodex、Claude APIとGPT APIを区別する必要もあります。このガイドでは、現在のドキュメント、公開ベンチマーク、開示された第三者テストを使用しており、GPTProtoが実施したと主張するハンズオンテストではありません。
コーディングにおけるClaude vs ChatGPT:クイック判定
最適な選択は、あなたのコーディング方法と、AIにタスクをどこまで自律的に完了させたいかによって決まります。
| コーディングタスク |
より良い開始点 |
理由 |
| 小さな関数とスクリプト |
引き分け |
通常、プロバイダーよりもプロンプト品質とモデル階層のほうが重要 |
| インタラクティブなペアプログラミング |
Claude Code |
迅速なフィードバックと高度なターミナルカスタマイズ |
| 長時間の自律コーディングジョブ |
Codex |
委任・レビューとバックグラウンドワークフローに強い |
| フロントエンドとUI生成 |
Claude |
視覚的な実装と反復においてわずかな品質上の優位性 |
| ターミナル中心のデバッグ |
ChatGPT/Codex |
GPT-5.6 Solが共通のTerminal-Bench比較でわずかにリード |
| リポジトリ全体のリファクタリング |
Claude Opus 5 |
コード移行と複数ファイルにわたるエンジニアリング性能に強い |
| Python開発 |
引き分け |
勝者はタスク、ライブラリ、テスト、リポジトリへのアクセスによって変わる |
| 大規模コードベース |
Claude、わずかに優位 |
リポジトリ推論に強いが、現在は両ファミリーとも非常に大きなコンテキストをサポート |
| エントリーレベルのコーディングサブスクリプション |
ChatGPT Plus |
公表されているCodexの割り当ては、一般に見積もりやすく、長持ちさせやすい |
| APIデプロイ |
モデル階層による |
受け入れられた結果あたりのコストは、最も安い個別リクエストよりも重要 |
緊密な共同作業と大規模で相互接続された変更にはClaudeを選びましょう。委任してレビューしたい場合はCodexを備えたChatGPTを選びましょう。APIチームは、どちらかのプロバイダーを単一の固定製品として扱うのではなく、個々のモデルを評価すべきです。
何を比較しているのか:Claude、ChatGPT、Claude Code、Codex?
ClaudeとChatGPTの違いは、製品サーフェスから始まります。
Claude.ai と ChatGPT は、コードの説明、生成、レビューを行う汎用アプリケーションです。Claude Code と Codex は、リポジトリを調査し、ファイルを編集し、コマンドやテストを実行し、失敗を修正できるコーディングエージェントです。これにより、タスクは「コードを書く」から「動作する変更を生成して検証する」に変わります。
APIはさらに別の層です。周囲のアプリケーションがファイルとツールを選択し、コマンドを実行し、エラーを返し、作業がいつ完了したかを判断します。したがって、チャットで正しい関数を書くモデルが、エージェント内では異なる動作をする可能性があります。公平なClaude AI対ChatGPTの比較では、モデルとその動作環境の両方を評価する必要があります。
コーディング向けの現在のClaudeおよびGPTモデル
現在のコーディング向けClaude vs ChatGPTガイドでは、同等のモデル階層を比較する必要があります。 Anthropicは推奨しています:最も複雑なワークロードにはClaude Opus 5を、特に要求の厳しい長期的作業にはFable 5.1を。 OpenAIは位置づけています:複雑なコーディング向けのフラッグシップとしてGPT-5.6 Solを、より軽いワークロード向けにTerraとLunaを。
| モデル |
最適なコーディング用途 |
コンテキストウィンドウ |
主なトレードオフ |
| Claude Fable 5.1 |
要求の厳しい長時間実行のエージェント型コーディング |
100万トークン |
Claude APIで最高価格、より遅いレイテンシ |
| Claude Opus 5 |
複雑なコーディング、移行、リポジトリ作業 |
100万トークン |
ミッドティアモデルより高価 |
| Claude Sonnet 5 |
低遅延の日常的なコーディング |
100万トークン |
最も難しいエンジニアリングタスクでの上限が低い |
| GPT-5.6 Sol |
複雑なコーディング、エージェント、ターミナル作業 |
105万トークン |
小規模なGPTモデルより高いコストとレイテンシ |
| GPT-5.6 Terra |
日常的な開発と本番タスク |
105万トークン |
最も難しい作業ではSolより低性能 |
| GPT-5.6 Luna |
特定用途のスクリプトと大量変換 |
105万トークン |
最も曖昧なエンジニアリングタスク向けではない |
現在のClaudeモデルファミリーとOpenAIモデルファミリーをGPT Protoで確認できます。難しいコーディングワークロードでは、最も関連する個別ページはClaude Fable 5.1、Claude Opus 5、およびGPT-5.6 Solです。日常的な本番作業では、GPT-5.6 Terraがより経済的な比較対象です。
ワークロードに応じてモデルを選び、許容できる結果を得るために必要な総コストを測定しましょう。
コーディングベンチマークが実際に示すもの
現在のベンチマーク証拠は、普遍的な勝者を支持していません。Claudeは一部のリポジトリおよびコード生成評価でリードし、GPT-5.6 Solは共通のターミナルベンチマークでわずかにリードしています。
| ベンチマーク |
Claudeの結果 |
GPTの結果 |
示唆されること |
| Terminal-Bench 2.1 |
Fable 5.1:85.02% |
GPT-5.6 Sol:85.77% |
GPTはターミナルベースのエージェントタスクでわずかなリードを保つ |
| SWE-bench Verified |
Opus 5:97.00% |
GPT-5.6 Sol:96.20% |
両者とも実際のリポジトリ問題で非常に競争力がある |
| Vibe Code Bench |
Fable 5.1:90.26% |
GPT-5.6 Sol:80.50% |
Claudeはエンドツーエンドのアプリ生成で優位性を示す |
| LiveCodeBench |
Fable 5.1:90.52% |
— |
コード問題解決に強いが、完全な製品比較ではない |
これらの結果は、Valsによる次の評価から得られています:Claude Fable 5.1、Claude Opus 5、およびGPT-5.6 Sol。しかし、依然として文脈が必要です。
たとえば、Fable 5.1は拒否時のサーバーサイドClaudeフォールバック付きで評価されました。Valsは、フォールバック支援タスクを失敗として数えると、Terminal-Bench 2.1スコアが85.02%から79.03%に下がると報告しています。評価設定も異なります。Fable 5.1とGPT-5.6 Solは最大エフォートを使用し、Opus 5はTerminal-Benchで高エフォートを使用しました。
Claudeは、コード生成、移行、アプリケーション構築の評価で特に優れています。GPT-5.6 Solはリポジトリ解決で近接し、共通のターミナルベンチマークではわずかに先行しています。これらの差は、異なるエージェント、ツール、コードベースでは逆転する可能性があります。
コード生成における Claude vs ChatGPT
小規模で明確に定義されたコード生成タスクでは、Claude と ChatGPT は互角に近く、信頼できる普遍的な勝者はいません。プロンプトに関連する要件が含まれていれば、どちらも関数、データ変換、API ハンドラー、テストケース、小規模アプリケーションを生成できます。
Claude は、複数ファイルにまたがる実装計画と調整のための良い出発点です。ChatGPT は、焦点を絞ったスクリプト、構造化された出力、完了条件が正確に定義されたタスクにも同じくらい実用的です。Codex 内では、GPT モデルはコードを提案するだけでなく、変更を実装して検証できます。
プログラミングのために Claude と ChatGPT を比較するときは、両方に同じ言語と依存関係のバージョン、編集可能なファイル、期待される動作、互換性の制約、必要なテストを与えてください。コードが最初の試行で通るなら、短い回答のほうが優れている場合もあります。印象的な回答かどうかではなく、採用された出力を評価してください。
デバッグにおける Claude vs ChatGPT
デバッグにおける Claude と ChatGPT の比較は、単一の比較ではありません。貼り付けられたスタックトレースのデバッグは、不慣れなリポジトリ全体に広がるリグレッションを見つけることとは異なります。 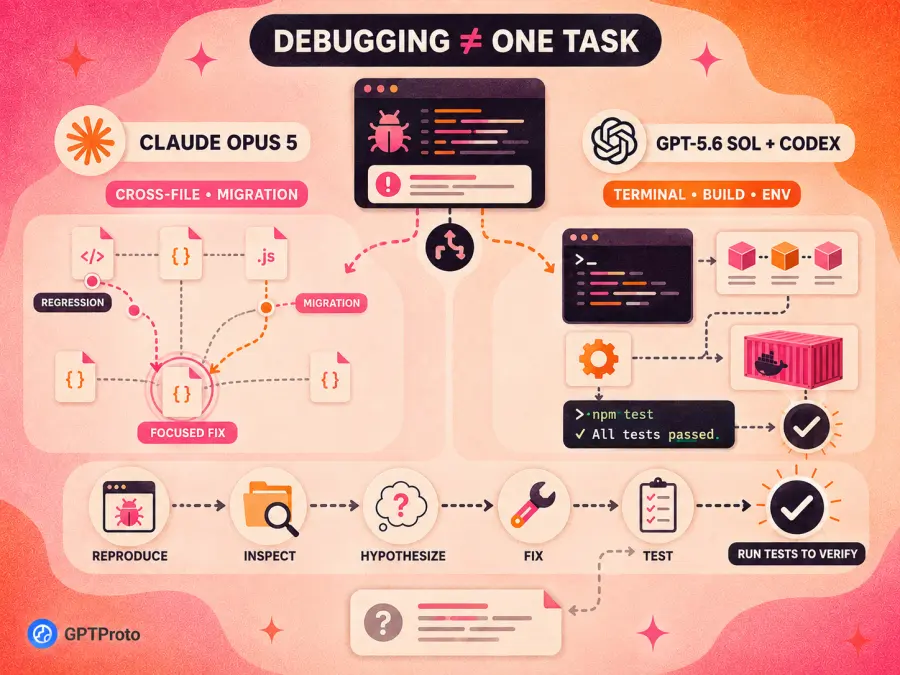
単一のエラーメッセージであれば、通常どちらの製品も考えられる原因を説明し、確認方法を提案できます。結果は、ユーザーが最後の行だけでなく、周囲のコード、ランタイムのバージョン、依存関係のバージョン、入力データ、エラー全体を含めるかどうかに大きく左右されます。
ターミナル、依存関係、ビルド、環境の問題については、GPT-5.6 Sol と Codex の組み合わせが強力な出発点です。そのわずかな Terminal-Bench でのリードは、コマンドライン操作を必要とするタスクに強いことを示唆していますが、報告されている設定では Fable 5.1 との差は 1 パーセントポイント未満です。
複数ファイルにまたがるロジックのバグ、移行、アーキテクチャ上のリグレッションについては、Claude Opus 5 が妥当な第一候補です。その強力なリポジトリおよびコード移行の結果は、修正が複数モジュール間の関係の理解に依存する場合に有効であることを示しています。
実際には、デバッグの品質は、エージェントが障害を再現し、関連ファイルを調査し、検証可能な仮説を立て、焦点を絞った修正を適用し、影響を受けるテストを実行できるかどうかにかかっています。環境にアクセスできない場合、その回答は検証済みの修正ではなく、仮説として扱ってください。
フロントエンドコーディングにおける Claude vs ChatGPT
Claude はフロントエンドコーディングにおいてわずかな質的優位があります。特に、視覚的な方向性をコンポーネント、レイアウト、レスポンシブ動作、アニメーション、インタラクティブな状態に変換するタスクで顕著です。Claude Opus 5 に関する初期の報告では、視覚的およびインタラクティブな作業を含むフルスタックアプリケーション構築の改善も強調されています。
とはいえ、すべての Claude の出力が洗練されて見えるわけではありません。ブリーフが曖昧な場合、どちらの製品もありきたりなカード、グラデーション、デスクトップファーストのレイアウトに陥ることがあります。両方に同じデザインリファレンス、ビューポートサイズ、フレームワーク、ブランドルール、インタラクション状態、アクセシビリティ要件、受け入れ基準を与えてください。
どちらのモデルも、ソースコードだけで自身の視覚的出力を判断すべきではありません。エージェントがページを起動し、スクリーンショットを検査し、参照と比較し、CSS を修正できると、パフォーマンスが向上します。Claude のほうがより良い初回試行を提供するかもしれませんが、より良いワークフローは視覚的検証を含むものです。
Python における Claude vs ChatGPT
Python における Claude vs ChatGPT には一般的な勝者はありません。なぜなら「Python コーディング」は、10 行のファイル名変更スクリプトから大規模な Django サービスや機械学習パイプラインまで、あらゆるものを含むからです。
| Python タスク |
より良い出発点 |
| 小規模な自動化スクリプト |
Claude または ChatGPT のどちらでも |
| データクリーニングと変換 |
Sonnet 5 や GPT-5.6 Terra などのバランスの取れたモデル |
| 大規模な Python アプリケーションのリファクタリング |
Claude Opus 5 |
| CLI、パッケージ、または環境のトラブルシューティング |
GPT-5.6 Sol と Codex |
| 長いノートブックの説明 |
Claude のほうがしばしば理解しやすい |
| 反復的な大量変換 |
検証後の、より小さく安価なモデル |
両方を同じ環境で評価し、依存関係の互換性、エッジケース、ファイル処理、型チェック、リンティング、および pytest の結果を確認してください。きれいな説明は、検証済みの動作よりも重要ではありません。
大規模コードベースにおける Claude vs ChatGPT
Claude は、多くのリポジトリ全体の分析、コード移行、連携した複数ファイルの変更において、より強力な第一候補です。Claude Opus 5 はコード移行とリポジトリのベンチマークで強力な性能を発揮し、Fable 5.1 は要求の厳しい長時間稼働のエージェント作業向けに設計されています。
ただし、コンテキストウィンドウのサイズだけではこの優位性は確立されません。現在の Claude のフラッグシップモデルは最大 100 万トークンのコンテキストウィンドウを提供し、GPT-5.6 ファミリーは約 105 万トークンを提供します。どちらも相当なコードを保持できる大きさですが、リポジトリ全体を盲目的に挿入すると、トークンを浪費し、関連する依存関係を覆い隠す可能性があります。
大規模コードベースでのパフォーマンスは、エージェントがリポジトリをマッピングし、関連ファイルを特定し、プロジェクトの指示に従い、インターフェースを維持し、変更を検証できるかどうかにかかっています。効果的なコンテキスト選択と圧縮は、宣伝されている最大値よりも重要かもしれません。
広範な移行、アーキテクチャ上の推論、相互接続されたモジュール全体にわたる連携した変更を含むタスクでは、Claude Opus 5 を選んでください。タスクが明確に指定され、ターミナルを多用し、より長い自律実行に適している場合は、GPT-5.6 Sol と Codex を選んでください。どちらの場合も、非常に大きな変更を検証可能な段階に分割し、各境界でテストを必須にしてください。
Claude Code vs Codex:エージェントはモデルと同じくらい重要になり得る
Claude Code と Codex は、デフォルトモデルを考慮する前からワークフローが異なります。
| 項目 |
Claude Code |
Codex |
| 典型的なワークフロー |
対話型ターミナル開発 |
委任、実行、レビュー |
| リポジトリの指示 |
CLAUDE.md |
AGENTS.md |
| カスタマイズ |
深いフック、スキル、エージェント設定 |
より管理されたデフォルトとサンドボックス制御 |
| フィードバックスタイル |
高速で対話型 |
より慎重で自律的 |
| 向いている用途 |
開発に深く関与し続ける開発者 |
バックグラウンド作業、レビュー、並列タスク |
| 主なトレードオフ |
複雑なセッションは制限をすぐに消費する可能性がある |
一部のタスクは完了までに時間がかかる |
Composio による有用なサードパーティテストは、ハーネスと基盤モデルを切り分けるのに役立ちます。評価者は同じ DeepSeek V4 Flash モデルを Claude Code と Codex の両方で実行し、30 件の同一のマルチアプリケーションタスク、同じホスト型 MCP 設定、最大推論、タスクごとの 900 秒制限を使用しました。
| 結果 |
Claude Code |
Codex |
| 合格タスク |
16/30 |
16/30 |
| 完了時間の中央値 |
122.7 秒 |
245.0 秒 |
| ツール呼び出し |
358 |
448 |
| 推定総コスト |
$3.116 |
$1.294 |
| 成功あたりのコスト |
$0.195 |
$0.081 |
2 つのハーネスは同じ合格数を達成しました。Claude Code は中央値時間の約半分で完了し、Codex はコストが約 58% 低くなりました。Composio の完全な比較 は限定的な結論を支持します。この設定では Claude Code の方が迅速なフィードバックを提供し、Codex は予算をより長く延ばしました。両ツールで同じサードパーティモデルを使用したテストであるため、Claude モデルの方が賢いことを証明するものではありません。
Claude Pro の使用率と ChatGPT Pro の比較
Claude Pro の使用率を ChatGPT Pro と比較する際、誤解を招く固定メッセージ数で説明されることがよくあります。両プロバイダーは、選択したモデル、コンテキスト長、推論努力、ツール、タスクの複雑さに応じて消費量が変わります。
現在の最も近い価格比較は次のとおりです:
| 月額料金 |
Anthropic プラン |
OpenAI プラン |
| $20 |
Claude Pro |
ChatGPT Plus |
| $100 |
Claude Max 5x |
ChatGPT Pro 5x |
| $200 |
Claude Max 20x |
ChatGPT Pro 20x |
Claude の使用量 は Claude.ai、Claude Desktop、Claude Code で共有されます。そのプランは 5 時間のセッション制限と週間制限を組み合わせています。ユーザーはリセットを待つか、アップグレードするか、別途課金される使用クレジットを有効にできます。
ChatGPT Work と Codex も該当する使用予算を共有します。OpenAI は 5 時間あたりのローカル Codex メッセージに関する大まかな推定値を公開しています。GPT-5.6 Sol の場合、現在の範囲は Plus で約 10~100、Pro 5x で 50~500、Pro 20x で 200~2,000 です。クラウドタスクはローカルメッセージより多くを消費する可能性があり、一見似た 2 つのタスクでも使用量が異なる場合があります。
これらは計画用の範囲であり、保証ではありません。1 つの長いリポジトリタスクは、複数の集中的な編集よりも多くの容量を消費する可能性があります。$20 では、ChatGPT Plus が持続的なエージェント利用のための一般的により安全な出発点です。Claude Code を頻繁に使うユーザーは、Max 容量または使用クレジットが必要になる場合があります。$100 と $200 では、好みのワークフローが表面上の倍率よりも重要です。
開発者向けの Claude vs ChatGPT API
サブスクリプションプランは、Claude または ChatGPT 製品内で作業する人向けです。アプリケーションを構築する開発者は、代わりに API モデルと従量課金を比較すべきです。
| ワークロード |
Claude オプション |
GPT オプション |
| 最も難しい長期的エージェント作業 |
Claude Fable 5.1 |
GPT-5.6 Sol |
| 複雑な日常コーディング |
Claude Opus 5 |
GPT-5.6 Sol |
| バランスの取れた本番ワークロード |
Claude Sonnet 5 |
GPT-5.6 Terra |
| 大量の集中的タスク |
Claude Haiku 4.5 |
GPT-5.6 Luna |
公式のトークン価格は初期モデルの選択に役立ちますが、コーディングワークフローの全コストを明らかにするものではありません。より高性能なモデルは、少ない再試行で完了する場合があります。安価なモデルは反復タスクには経済的ですが、エンジニアがその出力を繰り返し修正しなければならない場合は高くつくことがあります。
独自のタスクセットでは、初回合格率、合格したテスト、再試行、人間による介入、失敗したツール呼び出し、総トークン数、時間、受け入れられた結果あたりのコストを追跡します。勝者は段階によって変わる可能性があります。Claude がリポジトリ分析を担当し、GPT がターミナルを多用する実装を担当し、より小型のモデルが反復的な変換を担当するかもしれません。
Claude と GPT モデルを一緒に使えますか?
すべてのコーディングワークロードで 1 つのプロバイダーを選ぶ必要はありません。アプリケーションは、複雑さ、レイテンシ、コスト、または関与するエンジニアリング作業の種類に応じてタスクをルーティングできます。
GPT Proto は、1 つの API キーと共有残高を通じて Claude および GPT モデルファミリーへのアクセスを提供します。これにより、同じ評価タスクを両方のプロバイダーに送信し、品質とコストを比較し、別々のプロバイダー請求アカウントを維持せずにモデルを切り替えることが容易になります。
これは、GPT Proto キーがあらゆるネイティブコーディングクライアント内で Claude または ChatGPT のサブスクリプションを置き換えるという意味ではありません。開発者は自身のアプリケーションからサポートされている Claude および GPT API を呼び出せますが、クライアントの互換性はカスタムエンドポイントとリクエストスキーマのサポートに依然として依存します。
コーディングにおける Claude か ChatGPT か:最終判断
対話型ターミナルワークフローにほとんどの時間を費やし、フロントエンド実装を重視し、または大規模で相互接続されたリポジトリ全体を推論するモデルが必要な場合は、Claude を選んでください。 Claude Opus 5 は、ほとんどの複雑な開発作業にとって妥当な出発点であり、Fable 5.1 は最も難しい長期的タスク向けです。
委任とレビューのワークフロー、ターミナルを多用する自律タスク、またはより広範な ChatGPT サブスクリプションと統合されたコーディングアクセスを好む場合は、Codex を備えた ChatGPT を選んでください。 GPT-5.6 Sol は難しい作業向けの最も強力な GPT オプションであり、Terra と Luna はより明確で反復的なタスクのコストを削減できます。
API 開発では、コーディングにおける Claude vs ChatGPT の判断を独自の受け入れテストで決めましょう。同じタスク、ツール、テストを同等のティアに対して実行し、成功した結果、修正、レイテンシ、コストを測定します。公開されている証拠は、2 つの非常に競争力の高いファミリーを示しており、永続的なチャンピオンは 1 つではありません。