Qwen 4 Maxの概要:「Qoduck」ブラインドテストから14日間のプレビューまで
Qwen 4 Maxの実用的な概要を知るには、その名称が公開される前の4日間から振り返るのが最適です。2026年11月7日から11月10日にかけて、Qoduckというコードネームの匿名モデルが、エージェント型コーディングIDEであるQoder内に突如現れました。Qoduckをテストしていた開発者は、ある異例のパターンに気づきました。それは、高速なシングルパスのコードスニペットを返して人間のフィードバックを待つのではなく、モデルが10分から15分かけてシェルチェックを実行し、カスタムSVGアセットをゼロから作成し、自身のdiffに対してユニットテストを実行してから最終的な回答を返すという挙動です。
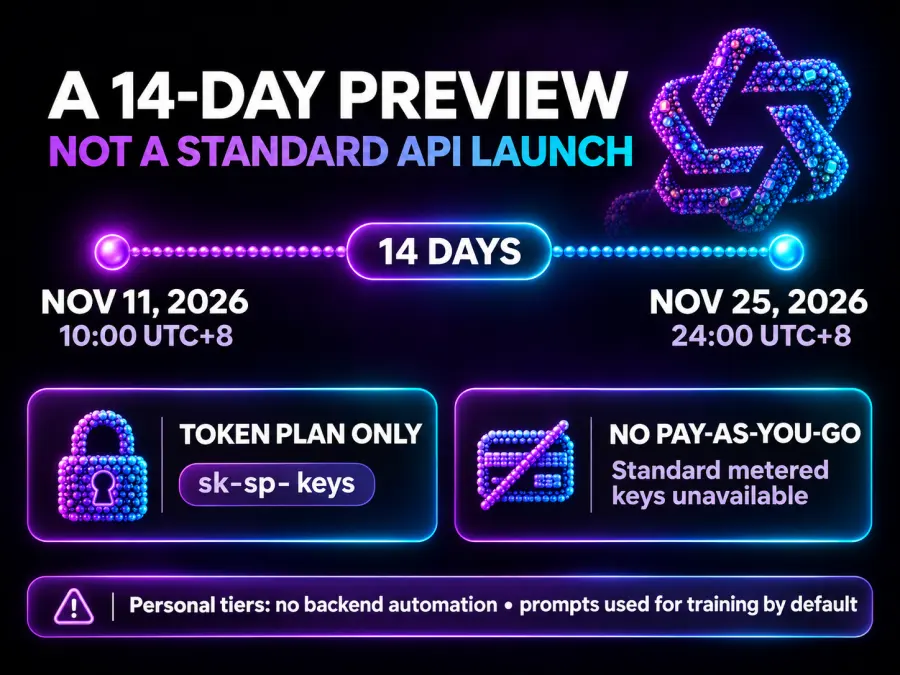
2026年11月11日10:00(UTC+8)、AlibabaはQoduckがQwenの最新モデル「Qwen 4 Max」であることを認め、Alibaba Cloud Model Studioにてモデル文字列qwen4-max-preview(一部のクライアント設定ではqwen4.0-max-previewと参照)として公開しました。Alibabaはトークン単位の定価を設定した本格的な商用ローンチを行うのではなく、開発者向けドキュメントで「14日間のQwen 4 Maxプレビュー」として紹介されるロールアウト形式を採用しました。これは、Claude Code、Cursor、Cline、Qoderといった開発ツール内でのエージェントワークフローをストレステストすることを目的としています。
| 仕様 |
確認済みステータス (qwen4-max-preview) |
ソース / エンジニアリングノート |
| 公式モデルID |
qwen4-max-preview |
Alibaba Cloud Model Studio / Bailian ドキュメント |
| プレビュー期間 |
2026年11月11日 (10:00) – 2026年11月25日 (24:00 UTC+8) |
厳格な14日間の限定プレビュー |
| コンテキストウィンドウ |
1,000,000トークン(最大入力:967,000トークン) |
中国および国際ドキュメントで検証済み |
| 最大出力トークン数 |
合計393,216(最終出力131,072 + 推論262,144) |
max_tokensは思考と出力を合わせた上限 |
| 入力 / 出力モダリティ |
入力:テキスト、画像、動画 · 出力:テキスト |
プレビュー版ではネイティブの音声入力は非対応 |
| 推論制御 |
reasoning_effort: low、medium、xhigh |
思考機能はデフォルトでON。初期設定はxhigh |
| サポートされているAPIプロトコル |
OpenAI Chat Completions、Responses API、Anthropic Messages |
専用のsk-sp- トークンプランエンドポイントが必要 |
| パラメータサイズと重み |
非公開(クローズド商用プレビュー) |
オンライン上の2.4T / 95Bという数値はQwen3.8-Maxのものです |
| 公式ベンチマークテーブル |
プレビュー開始時点では未公開 |
出回っている49.9というGameFeelスコアはQwen-4-Flash-Early |
世代の飛躍としてのqwen 4 maxの解説は、推論時にどのように計算リソースを消費するかに集約されます。以前のリリースではツール呼び出しはオプションの補助機能として扱われていましたが、今回のqwen 4 maxのアップグレードでは、デフォルトの推論トレースに自己検証ループが組み込まれています。Webアプリケーションの構築やコマンドラインユーティリティの修正を求められた際、このモデルは日常的に数十ものツール呼び出しを連鎖させます。ディレクトリツリーの検査、pytestやローカルのヘッドレスブラウザの実行、自身の構文やレイアウトの回帰の検知を行い、ユーザーが結果を目にする前に壊れたコードを書き直すのです。
アーキテクチャ、モデルサイズ、そしてベンチマークの現実
qwen 4 max sizeおよびqwen 4 max benchmarkの検索結果には、現在2つの誤情報が蔓延しています。これらを整理することが、Alibabaが実際に何をリリースし、何が未公開のままなのかを理解する最短の道です。
まず、Alibabaはalibaba qwen 4 maxの総パラメータ数やアクティブパラメータ数を公開していません。一部のサードパーティブログでは、2.4兆パラメータのMixture-of-Experts(MoE)モデルで、トークンあたりのアクティブパラメータ数は950億であると記載されています。それらの数値は、2026年9月にリリースされた前世代のフラッグシップモデルQwen3.8-Maxのものです。Qwen 4 Maxが100万トークンのコンテキストウィンドウを経済的に処理するためにスパースMoEバックボーンを採用していることはほぼ確実ですが、2026年11月時点で目にする「兆」単位の具体的な数値は、3.8世代から引き継がれた未検証の情報に過ぎません。
アーキテクチャ面で判明していることは、Alibabaが2026年8月に技術リリースしたQwen3.8-Flash-Nextに関する情報です。Qwenチームはこれを、Qwen 4シリーズの主要なアーキテクチャアップグレードを検証するためのテストベッドであると明言しています。その先行レポートには、qwen4-max-previewがどのようにして100万トークンのワークロードを処理しているかを説明する4つの構造的変更が記録されています。
ハイブリッドGDN + QSAアテンション: Gated DeltaNet(GDN)線形アテンション層とQwen Sparse Attention(QSA)を組み合わせることで、100万トークンのコンテキストにおける初回トークン生成時間(TTFT)のプリフィル遅延を、標準的なフルアテンションと比較して最大7.6倍短縮しました。
4ストリーム・ゲート残差接続: 学習可能なゲートを使用して残差ストリームの幅を拡張することで、高度な多段階推論における勾配フローと層間特徴ルーティングが改善されました。
N-gram埋め込み層: 埋め込み段階で直接マルチトークンのローカルコンテキストを注入することで、初期のアテンションブロックから語彙パターンマッチングの負荷を軽減しています。
Muonオプティマイザ学習: 大規模な事前学習の最適化をMuonに切り替えたことで、コードや形式論理コーパスにおけるサンプル効率が向上しました。
次に、qwen 4 max benchmarkの結果を検索すると、Qwen 4 MaxがGameFeel Bench v1.4で49.9を記録し、47.2のClaude Opus 5.5を上回ったという主張を目にすることがあるでしょう。リーダーボードと基盤となるコミットログを確認したところ、その49.9というスコアは、Qwen-4-Flash-Early(内部コードネームhawk)という初期の軽量テストチェックポイントによって記録されたものであり、qwen4-max-previewによるものではありません。2026年11月13日現在、AlibabaはQwen 4 Maxに関する公式のMMLU-Pro、SWE-bench Verified、またはAIMEのリーダーボードテーブルを公開していません。
現時点で検証可能なのは、qwen 4 max context windowのメカニズムと出力予算です。ここが移行しようとする開発者が直面する壁となります。コンテキストウィンドウは100万トークン(プロンプトの上限は967,000トークンと記載)を保持しますが、最大出力は国際ポータルでは393,216トークンと記載されており、国内ポータルでは推論トークン262,144+最終回答トークン131,072という内訳で示されています。
ここで注意すべき点があります。qwen4-max-previewにおける max_tokens APIパラメータは、reasoning_content と content の sum(合計)を制御します。このモデルはデフォルトで reasoning_effort: "xhigh"(利用可能な3つの設定である low、medium、xhigh の中で最も高い設定)に設定されているため、複雑なコーディングのプロンプトでは、隠れた思考ブロック内で簡単に15,000から40,000トークンを消費してしまいます。既存のクライアントコードで max_tokens: 4096 や 8192 を渡している場合、モデルは思考の途中で許容量を使い果たし、空の content 文字列を返してしまいます。意図しない切り捨てを避けるには、max_tokens を65,536以上に引き上げるか、日常的なタスクでは reasoning_effort を明示的に medium に下げてください。
Qwen 4 Max 実践レビュー:コミュニティとメディアのテストが実際に示すもの
Alibabaは従来のベンチマークに関するプレスリリースを省略したため、最も信頼できるqwen 4 maxのレビューデータは、プレビュー開始から48時間以内にqwen4-max-previewをライブエージェント環境に組み込んだエンジニアリングチームからもたらされています。彼らのログには明確なパターンが見て取れます。出力品質が向上するたびに、顕著なレイテンシとトークンコストの増加が伴うというものです。
11月11日、日本のAIコンサルティング企業であるWEELは、Claude Code内でのフロントエンド合成、マルチソースリサーチ、リポジトリレベルのデバッグという3つの観点からプレビューモデルを評価した結果を公開しました。
908行のカスタムSVGランディングページ(Qwen 3.8 Maxとの比較): 林業をテーマにした理学療法クリニックのレスポンシブなランディングページを作成するという同一のプロンプトを与えたところ、Qwen3.8-Maxは約9.5分で完了しましたが、外部のストックフォトをランダムに取得したため、グリッドが崩れたり読み込みに失敗したりしました。一方、qwen4-max-previewは約17分かかり、時間はほぼ2倍でした。しかし、不安定な外部URLにリンクする代わりに、バックグラウンドでCode Interpreterを数十回呼び出し、森林の樹冠、クリニックの建築、スタッフのアイコンなどのカスタムSVGイラストをプログラムで描画し、破損したアセットが一切ない908行のHTMLファイルを生成しました。
Claude Codeにおける自律的なCLIデバッグ(36/36のテストに合格): WEELは、Claude Code(Anthropic互換エンドポイント経由でqwen4-max-previewを使用)をローカルの家計簿CLI(kakeibo)に向け、--export-csvフラグと--monthフィルタリングフラグをユニットテスト付きで追加するよう指示しました。実行時間は11分48秒でした。初期実装の記述後、モデルはpytestを実行し、-100日元のような負の通貨文字列がPythonのargparseによってコマンドラインフラグとして誤解されるというエッジケースを含む2つの失敗したテストを検出し、自力でパーサーを修正しました。さらに指示されることなく、Microsoft Excelで日本語が文字化けしないようにutf-8-sig BOMヘッダーを先頭に追加し、CSVインジェクションを防ぐために先頭の=、+、-、および@文字をエスケープ処理しました。全36テストに合格し、月間Liteプランのクォータをわずか0.4%消費しただけでした。
自己検証型の政策リサーチ: 2026年度の中小企業向け補助金比較表を作成するタスクにおいて、モデルは2分かけて省庁ポータルサイトを横断する12以上のウェブクエリを実行し、さらに5分かけてgrepとPython検証スクリプトを実行し、Markdownテーブルの列がずれていないことを確認した上で、8分で結果を提示しました。
その2日後の11月13日、中国のテックメディアSilicon Star(GuiXingRen)は、qwen4-max-previewに対してビジュアルおよび3Dエンジニアリングの試練を課しました。定番の「自転車に乗るペリカン」のSVGアニメーション生成を指示した際、モデルはペダルの動きや木々の影の視差を表現しただけでなく、指示なしで0.5倍〜1.75倍の速度スライダーと、昼/夕暮れ/夜のテーマ切り替え機能を追加しました。より難易度の高いThree.jsのテスト(寝室の窓から庭へ紙飛行機が飛ぶ、プレイ可能な3DゲームPaper Skiesの構築)では、物理演算や障害物処理がAnthropicのクリエイティブ特化型モデルClaude Fable 5.1に匹敵すると評価されましたが、シェーダーの洗練度では最新のClaude Fable 5.2に一歩譲る結果となりました。Silicon Star自身のレスポンシブホームページの再設計を依頼した際には、ローカルブラウザを起動して外部記事のサムネイルが403ホットリンクエラーを返していることを特定し、自動的にスタイリッシュなSVGグラデーションのプレースホルダーに置き換え、5分で2回目の編集レイアウト修正を完了させました。
X(旧Twitter)や日本の開発者フォーラムにおける開発者からのフィードバックは、qwen 4 maxの各機能のハイライトに重要なニュアンスを加えています。開発者の@round_boys氏は、このモデルがJavaとThree.jsを使用して完全な3Dシーンを一度のプロンプトでレンダリングする様子を実演しましたが、その実行には約69,000トークンを消費したと指摘しています。生の処理能力を測定した他の初期ユーザーは、デフォルトのxhigh設定下でのストリーミング速度が毎秒約33トークン前後であると報告しており、強化学習(RL)によるツール使用の軌跡が単純なファイル読み込みに対して過剰に思考することがあると述べています。これは、-previewという接尾辞が文字通りの意味であることを再認識させるものです。
Qwen 4 Maxの料金、トークンプランのルール、および本番環境での制限事項
「qwen 4 max pricing」を検索して、一般的な「入力トークン100万あたり$X」という料金表を期待しているなら、それを見つけることはできません。Alibabaは、qwen4-max-previewに対して従量課金制の請求を提供していません。リクエストを送信する唯一の方法は、アクティブなAlibaba Cloud Model Studio Token Plan(旧称:Coding Plan)のサブスクリプションを利用することです。これは、トークンあたりのドル単価ではなく、抽象的な月間「クレジット」で請求されます。
国際版のQwenCloudポータルでは、トークンプランは個人向けとチーム向けのティアに分かれています:
Liteプラン(新規ユーザーは初月3ドル): 月間20,000クレジットが含まれます。5時間ごとに1,200クレジット、週に9,000クレジットという厳格なローリングスロットル(制限)が適用されます。
Proプラン(初月15ドル): 月間100,000クレジットが含まれます。5時間ごとに6,000クレジット、週に45,000クレジットという上限があります。(Alibabaの中国国内向けポータルでは、LiteとProは月額39人民元および199人民元で提供されており、初月半額プロモーションとして19.5人民元および99.5人民元で利用可能です。)
14日間プレビュー割引(2026年11月11日〜11月25日): 2週間のプレビュー期間中、日中の呼び出し(08:00〜22:00 UTC+8)は標準クレジットウェイトの20%のみを消費し、オフピークの夜間呼び出し(22:00〜08:00 UTC+8)にはさらに80%の割引が適用され、実質的なクレジット消費量は通常レートのわずか4%まで低下します。
夜間にIDEで作業する個人開発者にとって、3ドルで利用できるこのプロモーションの計算は非常に魅力的です。しかし、製品を構築したり、自動化されたCI/CDエージェントを実行したりするエンジニアリングチームにとっては、このトークンプランには3つの重大な本番環境での制限事項があります:
バックエンド自動化およびAPI統合の禁止: Alibabaのトークンプランの利用規約では、個人向けLiteおよびProキー(sk-sp-)の使用を、サポートされているIDEプラグイン内での人間による対話的なコーディングに明示的に制限しています。サブスクリプションキーを使用して自動化されたバックエンドスクリプト、顧客向けのSaaS機能、またはバッチデータパイプラインを動かすことは利用規約違反となり、アカウント停止の対象となります。
個人向けティアにおける強制的なデータ学習: トークンプランのルールに基づき、個人向けLiteおよびProサブスクリプションでは、すべてのプロンプト、リポジトリのコンテキスト、およびモデルの補完結果が、デフォルトでAlibabaのモデル学習改善プログラムに組み込まれます。これをオプトアウトする設定はありません。企業向けのチームプラン(1シートあたり月額40ドル)のみが、データ保持ゼロ/学習なしを保証します。
5時間ごとのローリングレート制限と11月25日の終了: ワークフローが完全に内部的なものであっても、5時間で1,200クレジットという上限では、複数の開発者によるバースト的な利用を吸収することはできません。また、qwen4-max-previewエンドポイントは、2026年11月25日 24:00(UTC+8)に終了する予定です。
比較:Qwen 4 Max vs Qwen 3.8 Max、Kimi K3.1 Pro、GLM-5.3、Claude Opus 5.5
現在、qwen4-max-previewを本番環境のバックエンドに組み込むことはできません。そのため、あらゆる比較検討において実用上の焦点となるのは、サブスクリプションによる縛りやデータ学習のリスクなしに、100万トークンのコンテキストを扱うエージェントワークロードを代替できる従量課金制のフラッグシップモデルはどれか、という点です。
| モデル |
課金と可用性 |
コンテキストウィンドウ |
最大出力 |
対応入力モダリティ |
GPT Proto従量課金レート(入力 / 出力 100万トークンあたり) |
Qwen4-Max-Preview (qwen4-max-preview) |
14日間プレビュー限定(11月25日終了); トークンプランサブスクリプション(月額6ドル〜30ドル) |
1,000,000 |
393,216 (うちCoT 262K) |
テキスト、画像、動画 |
ホストなし(従量課金APIなし) |
Qwen3.8 Max 0902 (qwen3.8-max-0902) |
本番環境向け従量課金 |
1,000,000 |
65,536+ |
テキスト、画像、動画、音声、ドキュメント |
4.20 (公式定価より30%オフ) |
Kimi K3.1 Pro (kimi-k3.1-pro) |
本番環境向け従量課金 |
1,048,576 (1.05M) |
131,072 |
テキスト、画像、ドキュメント |
10.00 (キャッシュ入力は0.20ドル) |
GLM-5.3 (glm-5.3) |
本番環境向け従量課金 |
1,050,000 (1.05M) |
128,000 |
テキスト、画像、ドキュメント |
3.74 (公式定価より15%オフ) |
Claude Opus 5.5 (claude-opus-5-5) |
本番環境向け従量課金 |
1,000,000 |
128,000 |
テキスト、画像、ドキュメント |
18.00 (公式定価より10%オフ) |
Qwen 4 Max vs Qwen 3.8 Max
qwen 4 max vs qwen 3.8 maxを評価する際、トレードオフとなるのは「自律的な検証時間」と「本番環境の安定性および幅広いモダリティ対応」です。WEELによる17分対9.5分のランディングページテストが示したように、Qwen 4 MaxはバックグラウンドでのPythonチェックやカスタムSVGの合成に、2倍の時間をかけることを厭いません。しかし、qwen4-max-previewはプレビュー版のため、ネイティブの音声およびドキュメントファイルの解析機能が削られており、トークン単位での呼び出しもできません。
もし貴社のパイプラインがすでにAlibabaのプロンプト形式、多言語トークナイゼーション、あるいはマルチモーダルビジョンに依存している場合、qwen3.8-max-0902こそが、今すぐ採用すべき本番環境対応のフラッグシップモデルです。これは100万トークンのコンテキストウィンドウを維持しつつ、テキスト、画像、動画、音声、ドキュメントの入力を受け付けます。GPT Protoでは、qwen3.8-max-0902を出力100万トークンあたり4.20ドル(Alibabaの公式従量課金定価より30%オフ)で利用でき、Qwenモデルハブで他の軽量なオープンウェイトモデルと比較することも可能です。
Qwen 4 Max 対 Kimi K3.1 Pro
Silicon Starの11月13日のBlender MCPおよびWebGLベンチマークにおいて、qwen 4 max vs kimi k3.1 proの直接対決が行われました。その結果、両モデルの特性の違いは非常に明確です。Qwen 4 Maxは構造機械エンジニアのように思考し、Kimi K3.1 Proはインダストリアルデザイナーのように思考します。
Blenderのプロンプト(「木星軌道上の巨大宇宙船メンテナンスドック」)およびWebGLの深海ゲートテスト(「万潮の門」)において、qwen4-max-previewは、より密度の高い内部耐荷重リブや複雑なドッキングアームを構築し、水位と圧力の数値を動的に再計算する実用的な潮位UIスライダーを実装しました。しかし、レビュアーは一貫して、視覚的な構成、水シェーダーのライティング、色の調和においてkimi-k3.1-proを高く評価しました。ユーザー向けのフロントエンド、インタラクティブな3Dウェブ体験、あるいは1,048,576トークン(1.05M)のコンテキストウィンドウと131,072の最大出力トークンを必要とする長文コンテキストドキュメントエージェントを構築する場合、Kimi K3.1 ProはGPT Protoにて10.00ドル/1M出力(キャッシュされた入力は1Mあたり0.20ドルまで低下)で利用可能です。
Qwen 4 Max 対 GLM-5.3
qwen 4 max vs glm5.3を検索する開発者は、通常、高効率なコーディングとツール利用を低コストで求めています。Qwen 4 Maxの初月3ドルのLiteプロモーションは一見安価に見えますが、5時間のローリングクレジット制限や自動スクリプトの禁止により、バックグラウンドエージェント群での運用には不向きです。
Z.aiのglm-5.3は、従量課金制のAPIでその問題を解決します。これは、1.05Mのコンテキストウィンドウと128Kの出力上限を備え、テキスト、画像、ドキュメントの入力を受け付けることで、総コンテキスト容量においてQwen 4 Maxをわずかに上回っています。GPT Protoでは1M出力トークンあたり3.74ドル(Z.ai公式料金より15%オフ)で提供されており、GLM-5.3は自動PRレビューボット、高並列ツールルーティング、複数ファイルにわたるコード生成において、最も費用対効果の高い実用的なモデルです。
Qwen 4 Max 対 Claude Opus 5.5
Alibabaは、Claude Code内でqwen 4 max vs claude opus 5.5を検討する開発者を取り込むため、qwen4-max-previewにAnthropic Messages APIとのネイティブな互換性を組み込みました。WEELのPython CLIテストが証明したように、Qwen 4 Maxはすでに12分間のpytest修復ループを実行し、微妙なargparseやCSVインジェクションのバグを検出可能です。
claude-opus-5-5が決定的なリードを保っているのは、軌道効率、ストリーミングの応答性、そして本番環境でのSLA信頼性です。コミュニティのテスターは、Qwen 4 Maxの初期段階のRLチューニングにより、xhigh推論時に冗長なシェルチェックを繰り返す可能性があると指摘しています。無駄なツール実行や個人レベルのデータ学習が許されないミッションクリティカルな本番リポジトリをリファクタリングする場合、Claude Opus 5.5は1Mのコンテキストウィンドウと128Kの最大出力、そして成熟した指示順守能力を提供します。GPT Protoを通じて、claude-opus-5-5を1M出力あたり18.00ドル(Anthropic公式価格より10%オフ)で呼び出すことができます。
統合API経由で本番環境の代替モデルを呼び出す方法
ベンダーごとのSDKやサブスクリプションのクレジット管理、sk-sp- といったリージョン別エンドポイントを個別に管理することなく、上記の4つの主要な本番環境モデルを実行したい場合、GPT Protoならすべてを単一のOpenAI互換ルート(https://gptproto.com/v1/chat/completions)経由で利用可能です。
コードスニペットをコピーする前に留意すべき認証の詳細があります。認証ガイドおよびクイックスタートページに記載されている通り、キーは常にAuthorizationヘッダーにBearer プレフィックスを付けて渡してください(Authorization: Bearer $GPTPROTO_API_KEY)。以下は、qwen3.8-max-0902を呼び出し、文字列を1つ変更するだけでglm-5.3、kimi-k3.1-pro、またはclaude-opus-5-5に直接切り替える方法を示すドキュメントベースの例です。
curl --request POST "https://gptproto.com/v1/chat/completions" \
  --header "Authorization: Bearer $GPTPROTO_API_KEY" \
  --header "Content-Type: application/json" \
  --data '{
    "model": "qwen3.8-max-0902",
    "messages": [
      {
        "role": "user",
        "content": "このPython CLIパーサーの負の数のフラグ衝突とCSV数式インジェクションのリスクを監査してください。"
      }
    ]
  }'
import os
from openai import OpenAI

client = OpenAI(
    base_url="https://gptproto.com/v1",
    api_key=os.environ["GPTPROTO_API_KEY"],
)

# 1Mトークンのコンテキストに対応した本番環境モデル間でモデルIDを自由に切り替え可能:

# "qwen3.8-max-0902" ($1.40/$4.20) | "glm-5.3" ($1.19/$3.74)

# "kimi-k3.1-pro" ($2.00/$10.00)   | "claude-opus-5-5" ($3.60/$18.00)
response = client.chat.completions.create(
    model="qwen3.8-max-0902",
    messages=[
        {
            "role": "user",
            "content": "このPython CLIパーサーの負の数のフラグ衝突とCSV数式インジェクションのリスクを監査してください。",
        }
    ],
)

print(response.choices[0].message.content)