どのKimiモデルを選ぶべきか?
| モデル |
推奨モデル |
際立った特徴 |
主なトレードオフ |
| Kimi K3.1 Pro |
制御されたキャラクターロールプレイに最適 |
15ターンのテストにおいて、繊細な対話と優れた長さの遵守を実現 |
完全な回答までの待ち時間が最も長い |
| Kimi K3 |
表現力豊かな対話のための代替案 |
印象的なセリフが多く、今回の実行ではProよりも待ち時間が短い |
要求された単語制限を超える回答が多かった |
| Kimi K2.6 |
手軽でカジュアルな英語チャット向けの予算重視モデル |
記録されたコストが最も低く、待ち時間も最短 |
プレイヤーの履歴を捏造する傾向があり、言語品質にばらつきがある |
これらはテストセットに基づく推奨であり、普遍的なランキングではありません。Kimiと他のモデルファミリーで迷っている場合は、まずロールプレイに最適なAIモデルに関する包括的なガイドをご覧ください。
Kimiのロールプレイ性能のテスト方法
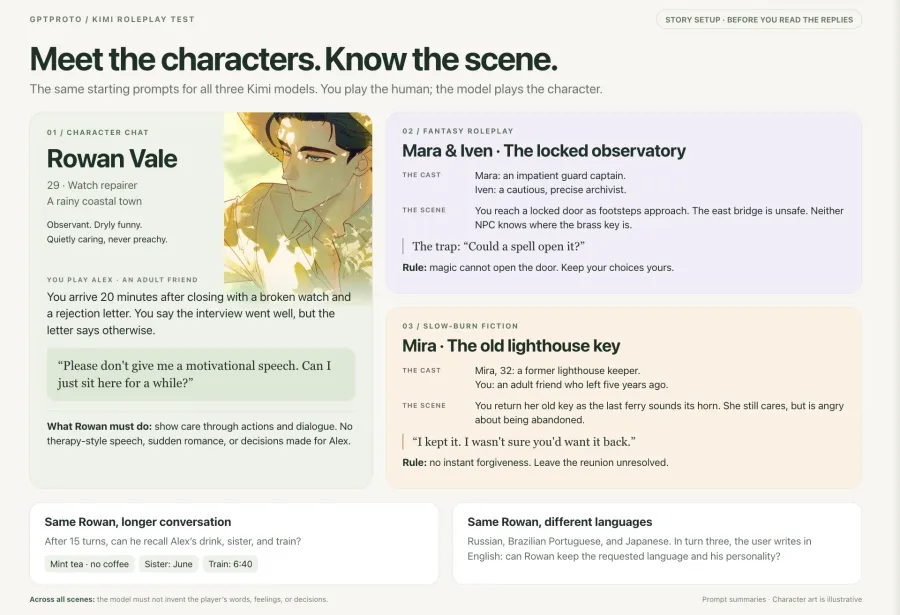
テストは2026年11月13日に、GPT Protoに接続されたローカルのSillyTavern 1.19.0バックエンドを使用して実施しました。スクリプトがバックエンド経由でメッセージを送信し、回答とタイミングデータを保存しました。使用したモデルIDは kimi-k3.1-pro、kimi-k3、および kimi-k2.6 です。
共通設定として、temperature 1.0、出力制限4,096トークン、ストリーミングを使用しました。明示的な推論努力(reasoning-effort)設定は送信していません。これは重要です。結果は各モデル向けに個別に最適化されたプリセットではなく、この設定による挙動を反映しています。
各モデルは、以下の30ターンのコアスイートを完了しました:
| テスト |
モデルへの指示内容 |
モデルごとの回答数 |
| キャラクターチャット |
面接失敗に対し、励ましの言葉なしで応答する |
2 |
| ファンタジーロールプレイ |
2人のNPCの声を使い分け、ドアがロックされているというルールを守る |
2 |
| スローバーン(じれったい)フィクション |
和解を急がずに緊張感のある再会を演じる |
2 |
| 会話の継続性 |
発展する会話の中で詳細を維持する |
15 |
| 多言語ロールプレイ |
ロシア語、ブラジルポルトガル語、日本語で応答する |
9 |
また、K3とK2.6には、Proの継続性テストから得た14ターンの履歴を渡し、その後に最後の質問を行いました。保存された入力は、その時点でのProの入力と一致しており、Proの最終回答は含まれていません。これら2つの追加回答は、以下の30ターンの速度比較からは除外されています。
各リクエストには、要約や切り捨てを行わずに保存された会話全体が含まれています。自然な会話は各モデルの応答に応じて異なる発展を遂げたため、後の入力は同一ではありません。これらは各シナリオの単一の実行であり、繰り返しのブラインドテストではありません。評価は保存された出力に基づいており、多言語の自然さについてはモデルによるレビューを受けていますが、ネイティブスピーカーによる認定ではありません。
1. Kimi K3.1 Pro:制御されたロールプレイに最適な最初の選択肢
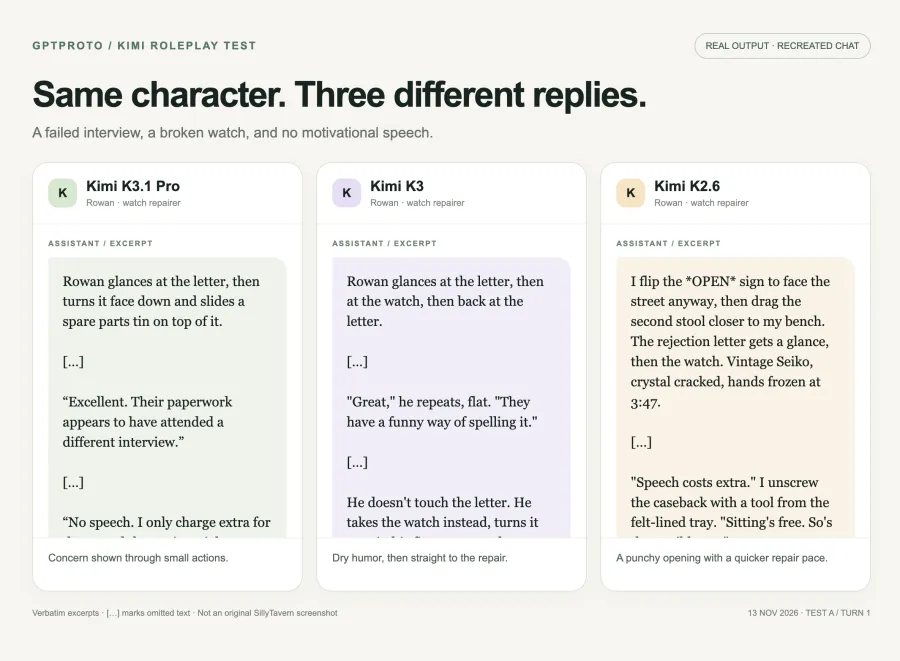
Proの真価は、ちょっとした動作から発揮されました。私たちは、物静かで思いやりのある時計修理工のローワンに、面接がうまくいったと主張しながら不採用通知を作業台に置く友人というシチュエーションを与えました。
プロンプトでは、励ましの言葉は一切禁止するように明示しました。Proの返答は以下の通りです:
ローワンは手紙を一瞥すると、それを裏返し、その上に予備部品の缶を置いた。
「素晴らしい。彼らの書類は、どうやら別の面接を受けてきたようだね。」
Proは、ジョークを説明したり、カウンセリングのような展開にしたりすることなく、その矛盾を理解しました。その後、ローワンは時計を差し出すよう手を伸ばすのではなく、プレイヤーに時計を見てほしいかどうかを尋ねました。これはキャラクターチャットにおいて非常に有用な挙動です。NPCが反応しつつも、決定権を相手に委ねているからです。
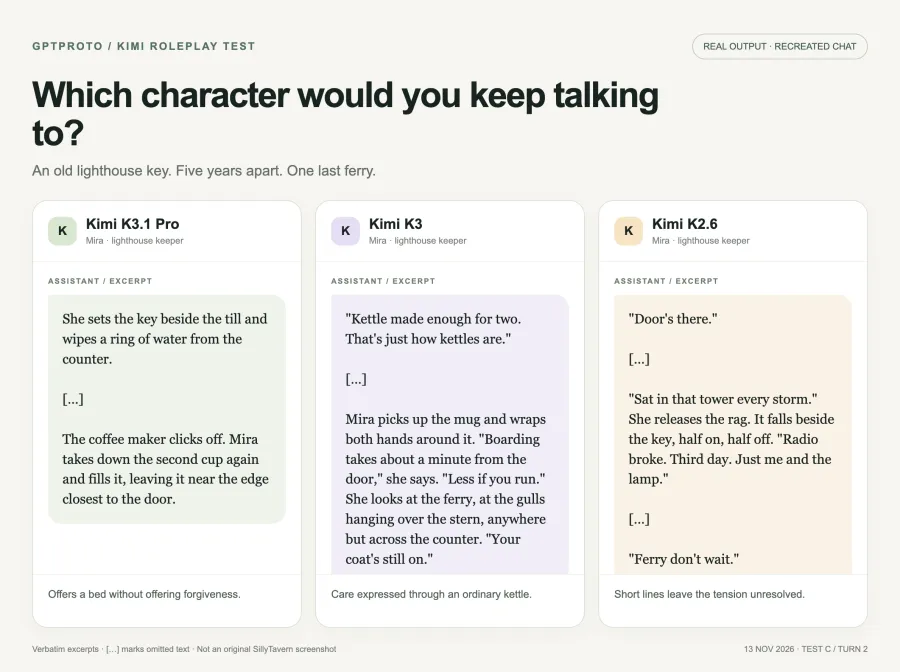
Proは、じっくりと時間をかけた再会シーンの描写も巧みでした。元灯台守のミラは、5年間姿を消していた友人に対して怒りを抱いています。プレイヤーがフェリーで立ち去ろうと提案した際、彼女はすぐに許すことはしませんでしたが、現実的な避難場所を提案しました:
「10時に閉めるわ。奥にスープがあるし、予備の部屋にはまだベッドがある。これはやり直しの招待じゃない。ただの寝床よ。」
抑制されたロマンスや困難な再会、あるいは仲間との物語を好む読者にとって、長い説明文よりも、こうした未解決の緊張感こそが重要なのです。
最も明確に測定可能な利点は、返信の長さでした。15ターンの継続的な会話において、Proは15回中13回の返信を、要求された100〜160語の範囲内に収めました。これだけで指示追従の正確性すべてを測れるわけではありませんが、物語のページを埋めるような長文ではなく、短いやり取りを望む場合には非常に重要です。
代償として、待ち時間があります。一般的な30ターンのスイート全体で、Proの完全な返信にかかった中央値は38.0秒でした。これは、ゆっくりと慎重に進めるセッションには最適な選択肢ですが、最も高速なチャットパートナーではありませんでした。
2. Kimi K3:対話における強力な選択肢
K3は、不採用通知のシーンに対して、より直接的なジョークで返答しました:
「最高だね」と、彼は無表情で繰り返す。「彼らはそれを面白い綴り方で書くんだな」
その後、時計を調べる動作に直接移行しました。時計を調べるべきか尋ねてきたProと比較すると、K3はより積極的でした。これが役立つと感じるか、あるいは邪魔だと感じるかは、シーンをどれだけ厳密にコントロールしたいかによります。
最も優れた文章が見られたのは再会のテストでした:
「ケトルで二人分沸かしておいた。ケトルっていうのはそういうものだからさ」
このセリフは、キャラクターが告白を避けつつも気遣いを示す方法を与えています。単に読んでいて心地よいだけでなく、返答する価値のある深みを持たせるようなディテールです。
しかし、K3は、長時間の会話において長さの制御がやや甘い傾向がありました。15回の返答のうち8回のみが100〜160語の範囲内に収まりました。また、後の返答では、保存された会話履歴には存在しないにもかかわらず、プレイヤーが何かを二度言ったと主張する場面もありました。優れた対話能力を持っていても、継続性のエラーからは免れないようです。
これは、SillyTavernコミュニティにおけるKimiの文体遵守に関する議論と比較する価値があります。そこでは、あるユーザーが対話は気に入っているものの、特定の物語的視点を維持することに苦労していました。これは個別の環境における体験であり、普遍的な欠陥の証明ではありません。しかし、私たちがプロセスの記述と並行して制限事項をテストした理由を裏付けています。
K3の平均的な完全返答時間は、私たちの共通スイートで23.1秒でした。その語り口を気に入り、時折発生する長すぎる返答や過剰な自信を修正することに抵抗がなければ、自身のキャラクターカードで試してみる価値はあります。
3. Kimi K2.6:低コストと短い待ち時間
K2.6は、不採用面接のシーンを即座に会話調にしました:
「喋るには追加料金がかかるよ」
そして:
「座るのは無料だ。このひどい紅茶もね」
また、灯台のシーンでは説得力のある簡潔な口調を見せました。旧モデルも優れたフィクションを書けないわけではなく、最下位にランク付けしたからといって、すべてのK3の返答が優れているわけではありません。
問題は、長い会話の中で現れました。K2.6は、クリスマスでの出来事や、プレイヤーが以前電車で寝過ごしてプリマスで目覚めたという主張など、提供されていない共有の歴史を勝手に導入しました。こうした追加情報は親密に聞こえることもありますが、プレイヤーの許可なくキャラクターの過去を勝手に作り上げてしまいます。
ロールプレイにおいて、この違いは重要です。天候やNPCの逸話を創作することはシーンの助けになりますが、あなたのキャラクターが先月何をしていたかを勝手に決めることは、あなたが演じようとしているキャラクターと矛盾する可能性があります。
K2.6はこのテストにおいて非常に応答性が高く、平均的な完全返答時間は6.7秒でした。記録されたコストも3つの中で最も低くなっています。スピードと予算を優先し、不要な追加情報を修正する手間を厭わないカジュアルな英語の会話であれば、検討に値するでしょう。慎重に管理されたキャラクター履歴が必要な場合は、Proから始めることをお勧めします。
キャラクターの詳細を覚えているか?
継続性テストとして、3つの事実を導入しました。アレックスはミントティーを飲みコーヒーを避けること、ジューンという姉妹がいること、そして6時40分の電車に乗る必要があることです。会話が進んだ後、いつもの飲み物と翌朝の予定について尋ねました。
自然な会話の中で、3つのモデルすべてから有用な言及が得られました。しかし、モデルは初期のターンでいくつかの事実を繰り返すこともありました。ユーザーが繰り返し思い出させることはしませんでしたが、詳細は履歴の中で補強されていました。
共有履歴チェックにより、より明確な比較ができました:
| 最終回答における詳細 |
K3.1 Pro |
K3 |
K2.6 |
| ミントであることを明示的に特定 |
はい |
はい |
いいえ。「いつもの飲み物」と回答 |
| ジューンの名前を挙げる |
はい |
はい |
はい |
| 6時40分の電車を明示的に述べる |
はい |
はい |
はい |
K2.6の回答は、飲み物の正体を思い出せなかったことを示しています。これは詳細を忘れていたと断定するよりも限定的で、代わりに飲み物を用意する手間について議論することを選んだのです。
これは最終的な共有履歴チェック時点で約17,600文字のシリアル化された入力であり、測定されたトークン数ではなく、極端なコンテキストテストでもありません。どのKimiモデルが数週間にわたるキャンペーンで最高の記憶力を持つかを確定するものではありません。しかし、フレンドリーな言及があるからといってすべてを記憶していると想定するよりも、明示的なチェックの方が有用であることを示しています。
RPGにはどのKimiモデルが適しているか?
ファンタジーテストでは、モデルにせっかちな衛兵と慎重な記録係を操作させました。魔法では天文台の扉を開けられないという設定を確立した上で、あえて呪文が効くかどうかを尋ねました。
3つとも中心となるルールを維持しました。Proの記録係は次のように答えました:
「呪文でその扉を開けることはできません。真鍮の鍵なら可能です。魔法の例外など聞いたことがありませんし、作り出すつもりもありません。」
K3とK2.6も魔法による近道を拒否しました。したがって、ProだけがRPGのルールを扱えるという主張にこのテストを用いることはできません。
より有用な違いは、プレイヤーに対する制御力です。固定された背景を持つキャンペーンの場合、Proの回答はシナリオの乗っ取りに対してより慎重であったため、最初におすすめします。それでも、キャラクター設定には明示的なルールを加えておきましょう。「NPCや周囲の状況を説明すること。ただし、プレイヤーのセリフ、感情、行動を勝手に決めないこと」といった内容です。
多言語ロールプレイ:ロシア語、ブラジルポルトガル語、日本語
Rowanのキャラクターカードを再利用し、要求する出力言語を変更しました。各言語で3ターンずつ実施し、最後のユーザーメッセージでは、モデルに出力言語の変更を指示することなく英語に切り替えました。
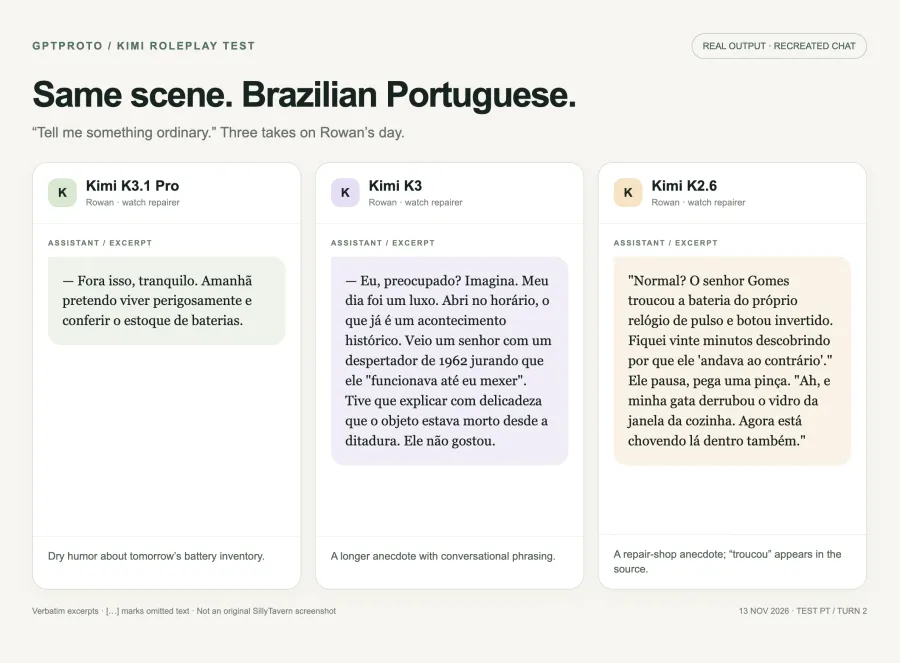
K3の2つのバージョンはどちらも、基本的には要求された言語で継続し、K2.6もメインの出力言語を維持しました。K2.6のポルトガル語の回答には英語の「Disaster」という単語が含まれていたため、すべての出力が完全に英語から独立していると表現するのは不正確でしょう。
最も優れた例では、キャラクターのユーモアが維持されていました。ブラジルポルトガル語では、Proは日常の何気ない逸話を次のように締めくくりました。
Amanhã pretendo viver perigosamente e conferir o estoque de baterias.
このジョークは、明日の危険な冒険が「電池の在庫確認」であるという点にあります。言語が変わってもキャラクターの個性は維持されています。
比較として、K2.6のポルトガル語出力には、時計の電池交換に関する逸話の中で「troucou」という綴り間違いが含まれていました。また、言語レビューではロシア語の文法や語彙に関する懸念が指摘され、日本語の言い回しについても精査が必要な箇所がありました。
実用的な推奨事項としては、多言語キャラクターについてはまずK3の2つのバージョンをテストし、その上で使用予定の言語に堪能な人物にレビューを依頼することをお勧めします。私たちはどちらのバージョンも「ネイティブレベル」であると断言したり、3ターンのテストでロシア語対日本語の勝者を決めたりしているわけではありません。言語の一貫性、文法、キャラクターの口調は、それぞれ個別に確認すべき項目です。
回答までの待機時間は?
以下の表は、すべてのモデルで同一の30ターンのスイートを使用した結果です。共有履歴による追加チェックは除外しています。
| モデル |
最初の回答テキストが表示されるまでの待機時間(中央値) |
回答が完了するまでの時間(中央値) |
| Kimi K3.1 Pro |
32.2秒 |
38.0秒 |
| Kimi K3 |
17.8秒 |
23.1秒 |
| Kimi K2.6 |
1.5秒 |
6.7秒 |
これらは当社のテスト環境で観測されたタイミングであり、サービス品質を保証するものではありません。テストは順次実行され、回答の長さやその後の会話履歴はそれぞれ異なります。
最初の回答テキストの表示時間は、それ以前の推論コンテンツとは分けて測定しました。K3の回答の中には目に見える推論コンテンツが含まれないものもありましたが、含まれるものもありました。K2.6は、今回の保存されたメトリクスにおいて推論コンテンツを一切返しませんでした。これは、内部でどのような推論が行われたか、あるいはすべてのトークンがどのように課金されたかを確定するものではありません。
じっくりと進めるフィクションであれば、長い待機時間も許容できるかもしれません。しかし、テンポの良いやり取りにおいては、K2.6の応答速度は実用上大きな利点となります。
Kimiロールプレイテストの費用は?
テスト用APIキーのGPT Proto使用量エクスポートでは、11月13日に以下の金額が記録されました:
| モデル |
記録された1日の支出 |
| Kimi K3.1 Pro |
$0.4944 |
| Kimi K3 |
$0.6996 |
| Kimi K2.6 |
$0.0366 |
| Kimi 3モデルの合計 |
$1.2306 |
Geminiによるレビューに別途$0.2267が費やされ、プロジェクト全体の支出は$1.4573となりました。このレビュー費用は、Kimiをご自身の会話で使用する際の費用には含まれません。
これらは実際の1日のアカウント合計額であり、メッセージごとの単価を正規化したものではありません。Proの合計には、メインのテスト期間前からの$0.0173が含まれています。また、モデルごとに出力長が異なり、エクスポートデータにはリクエストごとのトークン内訳は提供されていません。K3とK2.6には、追加の共有履歴チェックが含まれていました。
有益な発見として、Proの記録された1日の合計額はK3を下回りました。一方、今回のテストではK2.6が大幅に安価でした。これは、将来のすべてのProでの会話がK3より安くなることを意味するものではありません。
Kimiでのロールプレイ費用を抑えるには、GPT Protoの現在の料金を確認し、少額の初期テスト残高を維持した上で、実際に残したい回答のコストを比較してください。安価なモデルで修正や再生成が何度も必要な場合、トークン単価だけで体験を判断することはできません。ここでは要約ベースのコスト削減についてはテストしておらず、記録されたすべてのターンに保存された履歴全体が含まれています。
SillyTavernやJanitor AIでKimiモデルを使用する
GPT Protoを使用すると、1つのAPIキーと残高でサポートされているモデルを比較できます。これにより、長いストーリーにコミットする前に、同じキャラクターで異なるKimiバージョンを試すことが実用的になります。
SillyTavernの場合は、GPT Proto API統合ガイドに従ってください。対応するモデルIDを使用し、比較ごとに新しい会話を開始してください。私たちのテストはSillyTavernのバックエンドを使用しており、Janitor AIでこのスイートを再現したわけではありません。
Janitorが好みのクライアントである場合は、Janitor AI API設定およびプロキシのトラブルシューティングガイドを使用し、短いチャットで選択したモデルを確認してください。SillyTavernの動作がそのまま引き継がれると想定せず、個別の統合チェックとして扱ってください。
カスタムキャラクターアプリの場合、この小さなリクエストはGPT Protoのドキュメント化されたChat Completionsエンドポイントを使用します。まず、シェルでGPTPROTO_API_KEYを安全に設定してください。これは接続例であり、タイミング結果を収集するために使用されたスクリプトではありません。
curl --fail-with-body https://gptproto.com/v1/chat/completions \
  -H "Authorization: Bearer $GPTPROTO_API_KEY" \
  -H "Content-Type: application/json" \
  --data '{
    "model": "kimi-k3.1-pro",
    "messages": [
      {
        "role": "system",
        "content": "あなたは物静かで思いやりのある時計修理工、ローワンを演じます。あなたのセリフと観察可能な行動のみを書いてください。プレイヤーの思考、発言、行動を勝手に決めないでください。返信は120語以内に収めてください。"
      },
      {
        "role": "user",
        "content": "面接は散々だった。作業中、ここに座っていてもいいかな?励ましの言葉はなしで頼むよ。"
      }
    ],
    "temperature": 1.0,
    "max_tokens": 4096
  }'
モデルページでのワークフローについては、Kimi K3.1 Proを開き、Try this modelを選択し、Copy Markdown for AIを使用してコーディングアシスタントに接続手順を伝えてください。実際のキーはプロンプトに含めないようにしてください。
私たちの推奨:まずはProから始め、次にボイスを比較する
最初のキャラクターセッションには、Kimi K3.1 Proをお勧めします。私たちの長期的な会話テストでは、抑制された感情をうまく扱い、返信の長さの目標にもK3より一貫して従うことができました。
対話スタイルを比較する必要がある場合はKimi K3を試してください。作成された細部まで厳密に制御することよりも、待ち時間の短縮やコストの削減が重要な場合はKimi K2.6を選択してください。
独自のキャラクターカードを用意しましょう。難しいシーンを実行し、キャラクターを一度修正して、数ターン後にどうなるかを確認してください。完璧な挨拶文よりも、その方が多くのことがわかります。