GPT-6.2 Astraは、高度なコーディングや専門的な業務向けに設計されたOpenAIのフロンティア推論モデルです。2026年11月17日にChatGPT Work、Codex、およびAPIでリリースされました。しかし、あらゆるプロンプトにおいて自動的に最適なOpenAIモデルになるわけではありません。OpenAIはGPT-6.2 Solを日常的な選択肢と位置づけており、一方のAstraは、より深い推論やツール利用、あるいは完成度の高い専門的な成果物が求められ、高いコストに見合う業務のために設計されています。
この違いは、ローンチ時のデモ以上に重要です。確かにGPT-6.2 Astraはブラウザゲームを構築できます。しかし、より有用な初期の活用例は、コードレビュー、サービス間の障害追跡、レガシーアプリケーションのアップグレード、データベース分析、財務ワークブックの構築、技術的な調査、あるいはCADやシミュレーションツールの操作といった、派手さは控えめなものです。
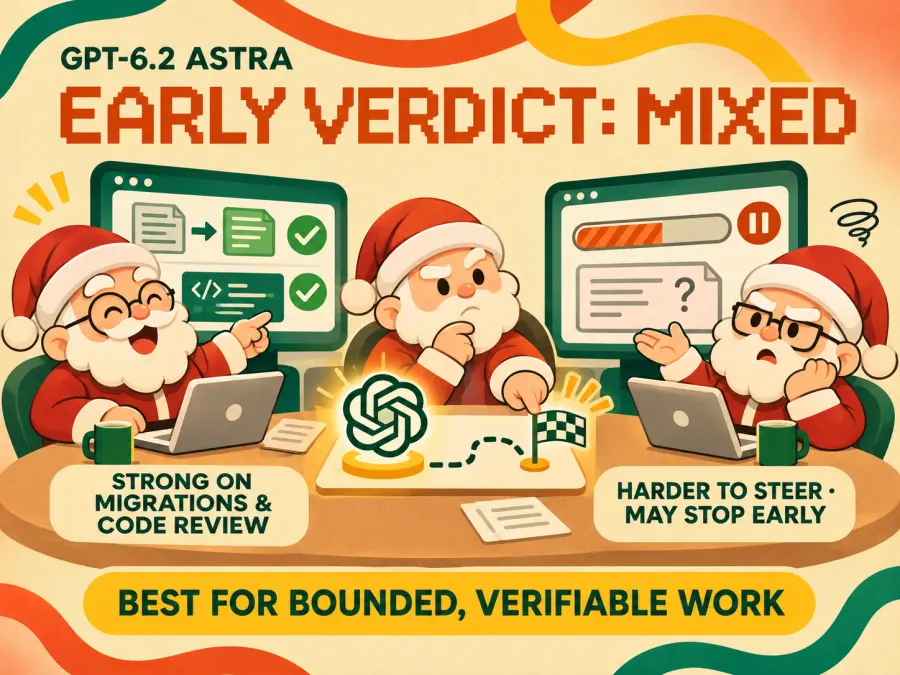
初期の評価は賛否両論です。一部のエンジニアは、移行作業やコードレビューにおいて非常に優れた結果が得られたと報告しています。一方で、モデルの制御が難しい、途中で停止する、あるいは長時間の実行に対する説明が不十分であるという声もあります。最も確実な結論は、「Astraは、明確なゴールがある困難で限定的なタスクにおいて最も強力な力を発揮する」ということです。日常的なライティングや、定義が曖昧な自律型タスクには、必ずしも最適な選択肢とは言えません。
両モデルともGPTProtoで利用可能です。困難で価値の高い業務にはGPT-6.2 Astraを、より高速な日常業務にはGPT-6.2 Solをご利用ください。現在、両モデルともOpenAIの標準APIトークン料金より20%オフで提供しています。
GPT-6.2 Astraの概要
| 質問 |
簡潔な回答 |
| GPT-6.2 Astraとは? |
複雑なコーディングや専門的な業務に対応する、OpenAIの最高性能GPT-6.2モデル |
| リリース日 |
2026年11月17日 |
| APIモデルID |
gpt-6.2-astra |
| コンテキストウィンドウ |
105万トークン |
| 最大入出力 |
922,000 / 128,000トークン |
| モダリティ |
テキストおよび画像入力、テキスト出力 |
| OpenAI標準API価格 |
100万トークンあたり入力8ドル、キャッシュ済み入力0.40ドル、出力40ドル |
| GPT Proto価格 |
100万トークンあたり入力6.40ドル、キャッシュ済み入力0.32ドル、出力32ドル(20%オフ) |
| 最適な用途 |
複雑なデバッグ、コードレビュー、移行、データ分析、専門文書作成、科学研究、CAD、3Dワークフロー |
| 日常的な利用にはこちら |
GPT-6.2 Sol(日常的なコーディング、ライティング、低コストな作業向け) |
OpenAIのモデルドキュメントには、レスポンスおよびチャット補完機能のサポートに加え、ウェブ検索、ファイル検索、コードインタープリタ、ホスト型シェル、コンピュータ操作、MCP、画像生成などのツールが記載されています。モデル自体はテキストを返します。完成したスプレッドシート、スライド、サイト、3Dアセットなどは、周辺のツールや実行環境に依存します。
初期ユーザーは何を議論しているのか?
ローンチ後の議論の中心は、ベンチマークスコアではなく、純粋な能力と日常的な使い勝手のギャップにあります。
1. Astraは既存システムのレビューと修正に極めて優れている
GitHubの初期Copilotテストでは、GPT-6.2 AstraはGPT-6 Astraよりも少ないトークン数で、より多くの実際のコードレビュー上の問題を検出しました。これは、単発のアプリデモよりも本番環境のチームにとって重要です。価値ある作業とは、多くの場合、欠陥を見つけ、既存の動作を維持し、テストでパッチを証明することだからです。
エンジニアのTibor Blaho氏は、日常的なインフラやソフトウェア業務でAstraを使用した経験について述べています。これにはサーバー管理、バックアップ、監視、調査、管理、デバッグ、コードレビューが含まれます。彼の際立った例は、数百万行のレガシーアプリケーションとその古い依存関係を現在の言語バージョンにアップグレードしたことです。彼は約3時間でローカルで動作可能な結果を得て、約6時間後にはクリーンチェックアウトのテストを通過したと報告しました(ただし、まだ作業は残っていると指摘しています)。
これは管理されたベンチマークではなく、あくまで逸話です。しかし、実際のコードベース、経過時間、検証ステップが含まれているため、有用な例といえます。また、実用的なワークフローも示唆しています。Blaho氏は、1つのモデルがすべての欠陥を見つけると想定するのではなく、AstraとClaudeモデルを使用して互いの作業を調査・レビューさせています。
2. 長時間の自律実行はフラストレーションの原因になる
否定的な報告も具体的です。Dan Shipper氏の初期レビューによると、Astraはエンドツーエンドのコーディングビルドにおいて早々に停止してしまうことが多く、簡潔すぎて内容を追うのが困難になる場合があるといいます。Ethan Mollick氏は、Astraを「ムラがあり、制御が難しい」と評しています。彼はBlenderとUnityを使用した野心的なスペースエレベーター体験の構築には成功しましたが、それでも日常的に使うモデルとして真っ先に選ぶことはなかったそうです。
開発者であるTheo氏の詳細な報告も同様に評価が分かれています。彼はコードレビューアーとしてのAstraを称賛し、斬新な解決策を見出したことや、彼の会社で月2万5000ドルのコスト削減につながるリバースプロキシの設計を提案したことを評価しました。一方で、回答できない質問で長時間停止したり、ループに陥って進捗がなくなったり、コードの変更点よりも理解しにくい要約を出力したりといった問題も報告しています。
これらの報告は、すべてのAstraの実行が失敗することを証明するものではありません。しかし、異なる視点から同じリスクを指摘しています。それは、モデル自体には十分な能力があっても、目標が曖昧な場合に監督するのが難しいという点です。
3. 簡潔な出力は「効率的」か、それとも「文脈不足」か
OpenAI自身のGPT-6.2プロンプトガイドによると、Astraはデフォルトでより簡潔かつ直接的になるように設計されています。サポートの返信やコードレビューのメモ、エグゼクティブ向けの要約などには有用かもしれません。しかし、複雑な説明を求める場合、読者が必要とする推論のプロセスが省略されているように感じられることがあります。
これが、初期の反応が分かれている理由です。厳密に範囲が定められた成果物をテストしている人は、無駄な情報が少なくトークン消費も抑えられていると感じるでしょう。一方、長期プロジェクトの共同作業者としてAstraを使用している人は、唐突な回答や説明のない決定、時期尚早な引き継ぎに直面する可能性があります。
4. 真の問題は「タスクの性質」であり、Astraが「賢い」かどうかではない
これまでの証拠は、単純な境界線を示唆しています。
| タスクの性質 |
Astraの適性 |
| 明確な目的、ツール、テスト、ゴールがある |
適性が高い |
| 欠陥の見落としが許されない高価値なレビュー |
適性が高い |
| 検証可能な出力が求められる複数ソースのデータや文書作成 |
適性が高い |
| 日常的なメール、会議の議事録、小さなコード修正 |
通常はSolを優先 |
| 何が重要かの判断を要するオープンエンドなリサーチ |
Fable 5.2と比較し、人間によるレビューを併用 |
| 曖昧な判断を伴う数時間にわたる自律的なビルド |
依存する前に慎重にテストすること |
GPT-6.2 Astraは日常業務に適しているか?
適していますが、ほとんどの日常業務には必要ありません。会議のメモ、ルーチンメール、短い調査、小規模なコード修正、あるいは初稿の作成であれば、GPT-6.2 Solの方が自然な出発点となります。これはOpenAIが日常業務向けに位置づけているモデルであり、トークン料金はAstraより75%低く設定されています。GPT Protoは両モデルに同じ20%の割引を適用しているため、その価格差は変わりません。
Astraが真価を発揮するのは、一般的な業務カテゴリーが困難で価値の高いタスクに変わる時です。「このプルリクエストをレビューして」という依頼にはSolが適しているかもしれませんが、「3つのサービスにまたがる断続的な障害を追跡し、修正し、影響を受けるワークフローを実行して」という依頼はAstra向きの仕事です。「このCSVを要約して」はルーチンワークですが、「データ品質の問題を見つけ、統計的な落とし穴を説明し、編集可能な意思決定用ワークブックを作成して」というタスクであれば、Astraはそのコストに見合うだけの働きをします。
これまでに報告されている実用的な日常利用例には、デバッグ、サーバー運用、監視、バックアップ、コードレビュー、複数ソースにまたがる調査、オフィス管理などがあります。共通しているのは職業ではなく、その仕事がより深い推論から恩恵を受けるのに十分な複雑さを持ち、かつ結果を検証するのに十分な構造を持っているという点です。
GPT-6.2 Astraは何に適しているか?
コードレビュー、根本原因分析、レガシーシステムのモダナイゼーション
これが最も明確な実用例です。失敗しているワークフロー、関連ログ、リポジトリ、テストコマンドをAstraに与えてみてください。サービス全体にわたる障害の追跡、最小限かつ安全な修正の実装、影響を受けるテストの実行を依頼します。これはOpenAIが推奨するAstraのワークフローや、GitHubおよび初期のエンジニアからの肯定的な報告と一致しています。
レガシーシステムのアップグレードは、タスクが困難でありながら検証可能であるため、特に適している可能性があります。モデルは古い依存関係を調査し、段階的にコードを更新し、クリーンビルドを繰り返し実行できます。互換性の要件を定義し、移行をレビューするのは依然として人間の役割です。「すべてのテストに合格」という結果は、テストスイートが重要な動作を網羅している場合にのみ証拠となります。
通常のプルリクエストのレビューや小規模な修正であれば、GPT-6.2 Solで十分かもしれません。OpenAIは日常的なコーディングにSolを明示的に推奨しており、そのコストはAstraの標準的な入力・出力料金の4分の1です。
データ分析、ダッシュボード、編集可能なワークブック
ここでのAstraの価値は、単にSQLクエリを書くことだけではありません。データを調査し、品質の問題に気づき、前提条件を述べ、分析を実行し、その結果を他の人がレビューできるワークブック、グラフ、またはダッシュボードに変換することができます。
独立したPlotlyデータ分析テストが、実際のタスクの有用な例を提供しています。Astraは43問中41問に正解し、仕込まれたすべてのデータ品質の問題を検出し、5つの統計的な落とし穴をすべて回避し、4.11ドルで実行を完了しました。質問あたりの中央値は12.4秒で、GPT-6 Astraの26.9秒と比較して高速でした。重要なトレードオフとして、隠れたパターンを2つ見逃しており、GPT-6.1 Solはそのテストで2.61ドルで満点を達成しました。Astraは高速で有能ですが、必ずしも最も安価または最も正確な選択肢とは限りません。
OpenAIのAlderfenの評価例は、同じ能力のドキュメント作成面を示しています。Astraは2031年までの収益を予測し、3つの財務諸表を照合し、1株あたりの価値を計算し、主要なドライバーを感応度分析表の横に配置した、編集可能なDCFワークブックを作成しました。これは独立した証明ではなく、ベンダーのデモとして扱うべきです。それでも、独自の表計算ソフトで再現できるテストの有用なテンプレートとなります。
財務、経理、法務、および専門文書
GPT-6.2 Astraは、スライド、スプレッドシート、メモ、文書における専門的な慣習に従うようトレーニングされています。OpenAIは、財務、経理、コンサルティング、営業、法務のワークフローにおいて生産性が向上したと報告しています。ローンチページに掲載された顧客の成果には、アプリ、ダッシュボード、スライドのレビュー回数の削減や、長期にわたる経理業務の完了時間の短縮などが含まれています。これらはベンダーが選定した結果であるため、保証された成果というよりは、有望なユースケースとして捉えるべきです。
最適なアプリケーションは、検証可能な成果物です:
前提条件が変更された際に、数式が正しく調整され、適切に応答する財務モデル。
主張の根拠を、提供された権威ある情報源やソース文書に遡ることができる法務メモ。
既存のテンプレートに従い、各タイトルを裏付けのある結論へと変換するスライドデッキ。
すべての要件を証拠、担当者、ステータスにマッピングするコンプライアンス管理ツール。
独立した調査による証拠は、自由度の高い作業においてはそれほど芳しいものではありません。Epoch AIによる現実的な職場環境での評価では、テストされたどのモデルも、あらゆるタスクにおいてEpochが設定した従業員基準を満たすことはできませんでした。GPT-6.2 Astraの平均スコアは65%で、Claude Fable 5.2を17ポイント下回りました。Epochは、Astraが簡潔な文章作成、グラフィックデザイン、データセンター関連の研究においてGPT-6 Astraから改善が見られたものの、慎重になりすぎる傾向があり、利用可能な証拠が裏付けている結論を省略してしまう可能性があることを指摘しています。
この一見矛盾する結果こそが重要なポイントです。Astraは、評価基準と出力が明確な場合には非常に強力な力を発揮します。しかし、何が重要かを判断し、慎重に仮定を立て、不確実な研究計画を反復的に進める必要がある作業においては、モデルの選択と人間の監視がより重要になります。
科学的分析および技術的研究
OpenAIは、科学分野をAstraの主要なユースケースとして位置づけており、ターミナルベースの科学的ワークフローにおいて優れた結果を報告しています。初期ユーザーからの別のシグナルとして、生物医学研究者のDerya Unutmaz氏は、科学研究や長期的な目標を伴うコーディングにおいてAstraを高く評価しつつも、デザインのセンスや感情的知性については依然としてOpus 5.5を好むと述べています。また、同氏は自身の生物医学研究におけるAstraの体験を強力なものと評しています。
これは、Astraが単独で出版可能なレベルの研究を生み出せるという意味ではありません。Epochの評価では、フロンティアモデルは依然として既存のアイデアを再利用し、最初の試案に過度に依存し、最も重要な発見を特定するのに苦労していることが判明しました。Astraは、検索、分析のコーディング、ソースの比較、提示された仮説のテスト、またはドラフトへの挑戦に活用してください。自信に満ちた研究のナラティブを、そのまま検証結果として扱わないようにしてください。
CAD、シミュレーション、3Dデザイン、および視覚的プロトタイプ
ここでは、ローンチ時のデモ例がゲームよりも興味深いものとなっています。OpenAIは、Astraが車両部品をモデリングし、シャシーダイナミクスのためのPythonソルバーを記述し、Blenderで結果をアニメーション化し、ラジコンバギーの組み立てガイドとパーツカタログを作成する様子を披露しました。これらの例は、視覚的推論、コード、コンピュータ操作、ドキュメント作成を一つのワークフローに統合しています。
この組み合わせは、初期のエンジニアリング探索に役立ちます。参照画像やマニュアルを編集可能なモデルに変換し、シミュレーションで修正案をテストし、レビュー担当者向けの視覚的な説明資料を作成するといったことが可能です。ただし、物理的な設計には依然としてエンジニアリング上の検証が必要です。もっともらしいアニメーションは、荷重、公差、材料、または安全要件が正しいことの証明にはなりません。
GPT-6.2 Astraはゲームを構築できるか?
はい。Meridian Sound Racingはブラウザでプレイ可能なデモであり、Ethan Mollick氏の宇宙エレベータープロジェクトは、Blender、Unity、ブラウザ体験、そしてシミュレートされた無重力物理演算を組み合わせたものです。
しかし、「ゲームを構築できる」という言葉はAstraを最もよく表しているとは言えません。これらのプロジェクトは、モデルが大規模なビルド全体にわたってコード、3Dアセット、ツール、インタラクションを調整できることの証拠です。同じ能力は、シミュレーション、トレーニング体験、デジタルツイン、製品コンフィギュレーター、インタラクティブなデータストーリーにも役立ちます。
クリエイティブな一貫性についてもテストが必要です。初期のユーザーからは、デフォルトの視覚的直感は優れているものの、デザインパターンが繰り返され、スタイルに対する制御が弱いという報告がありました。Astraには、視覚的なリファレンス、タイポグラフィ、ターゲットオーディエンス、インタラクションのルール、そして明示的な非目標(やらないこと)を与えてください。その上で、最初のスクリーンショットだけでなく、2回目のリビジョンを評価してください。
GPT-6.2 Astraからより良い結果を得る方法
コミュニティからの不満は、Astraには通常のチャットプロンプトよりも明示的な運用指示書が必要であることを示唆しています。OpenAIのガイドでも、意図が不明確な場合、モデルが次のステップを提案して待機する可能性があると警告されています。
以下のようなプロンプト構造を使用してください:
目標:
[具体的な成果物]を完成させる。

完了条件:

1. [受け入れチェック]

2. [テストまたは証拠]

3. [必要な出力形式]

自律性:
妥当で取り消し可能な前提を立て、待機せずに続行すること。
決定が結果を大きく変える場合や、取り消し不可能なアクションを引き起こす場合にのみ質問すること。

制約事項:

- [既存の動作やスタイル]を維持すること。

- [範囲外の領域]は変更しないこと。

- [ツール、ファイル、ソース、または規約]を使用すること。

検証:
[テストまたはチェック]を実行すること。不足しているファイル、失敗したツール、サポートされていない前提、または不完全なステップがあれば明示的に報告すること。

最終引き渡し:
変更点、検証内容、残存リスク、および合計使用量/コストを要約すること。
マルチターンのAPI作業では、以前のプロンプトのプレフィックスを変更せずに保持し、新しい指示を追加してください。OpenAIによると、これにより推論が維持され、プロンプトキャッシュの再利用が向上します。フロントエンドや視覚的な作業の場合は、実際のリファレンスを提供し、希望するタイポグラフィや画像を指定してください。「モダンにして」という指示はデザインシステムではありません。
GPT-6.2 Astraのタスクあたりのコストは?
これらの料金は、最大272,000入力トークンまでのリクエストに対する100万トークンあたりの米ドル単価です。GPT Protoの行には、OpenAIの標準料金から20%割引が適用されています。
20,000トークンのキャッシュされていない入力と5,000トークンの課金対象出力を含むリクエストの場合、標準的なトークン料金は、GPT-6.2 Astraで$0.36、GPT-6 Astraで$0.45、GPT-6.2 Solで$0.09となります。GPT Protoの現在の料金では、同じトークン数でAstraなら$0.288、Solなら$0.072となります。実際のエージェントタスクでは、モデルの呼び出しが繰り返されたり、キャッシュされたコンテキストが再利用されたり、失敗したツールが再試行されたり、結果がはるかに長くなったりする可能性があります。
1リクエストあたりの入力トークン数が272,000を超えると、Astraの入力およびキャッシュ料金は2倍になり、出力コストはリクエスト全体に対してショートコンテキスト料金の1.5倍になります。1.05Mのコンテキストウィンドウは便利ですが、安易に埋めると高額な請求が発生する可能性があります。100万トークンあたりの価格だけでなく、完了したタスクあたりのコストを測定してください。
Plotlyの実行結果が具体的な例を示しています。43件の分析質問にかかったコストは、GPT-6.2 Astraで$4.11、GPT-6 Astraで$19.97でした。一方、GPT-6.2 Solは$1.22で、完了した質問数は1つ少ないだけでした。Astraのアップグレードは本物ですが、日常的な本番トラフィックにおいては、より安価なモデルの方が経済的に優れている場合があります。
どちらの割引ルートも現在利用可能です。本番トラフィックを送信する前に、GPT-6.2 AstraモデルページまたはGPT-6.2 Solモデルページで、現在のモデルIDとリクエスト形式を確認してください。OpenAIモデルコレクションには、その他の利用可能なOpenAIモデルがリストされています。
GPT-6.2 AstraはClaude Fable 5.2より優れているか?
すべての種類の作業において優れているわけではありません。
OpenAIの報告によると、Astraは法務エージェントのベンチマークにおいて、Fable 5.2の厳格な合格率を約6分の1のコストで2倍以上に高めました。しかし、CognitionのFrontierCode 2.0では、既存のコードベースへの変更においてFable 5.2の方が高いスコアを記録しました。Epochによるオープンエンドな職場評価でも、Fable 5.2が17ポイント差で優位に立っています。
| GPT-6.2 Astraを選ぶべき場面: |
Claude Fable 5.2を選ぶべき場面: |
| コードレビュー、デバッグ、ツール使用、または検証可能な技術的成果物が中心である場合 |
タスクがオープンエンドであり、何が重要かについての強力な判断力が求められる場合 |
| CAD、シミュレーション、3D、またはコンピュータ操作のワークフローが必要な場合 |
コラボレーションのスタイルや、読みやすい長文の解説がより重要である場合 |
| 繰り返しのタスクコストとキャッシュ効率が重要である場合 |
独自の代表的なテストにおいて、介入回数が少ない、または完了率が高いことが示されている場合 |
| 別のエージェントの作業をレビューするために2つ目のモデルが必要な場合 |
Astraの前提条件やパッチに異議を唱えるために2つ目のモデルが必要な場合 |
最も現実的な答えは、両方を使うことかもしれません。Tibor Blahoが説明する初期のクロスレビューワークフローは、どちらか一方を絶対的な勝者と宣言するよりも説得力があります。一方のモデルに実装や調査をさせ、もう一方のモデルに見落とされた欠陥や根拠のない前提がないかを確認させるのです。
創造的な比較を行うには、Claude Fable 5.2テストで使用したインタラクティブな水彩画のブリーフを再利用してみてください。両方のモデルに同じ既存プロジェクトを与え、現在の機能を壊さずに新しいコントロールを追加するよう依頼します。初回パスの正確性、修正回数、説明の質、合計トークン数、およびタスク完了コストを比較してください。Fableへのアクセスは、Claude Fable 5.2 APIページから確認できます。
GPT-6.2 Astraはどこで利用できますか?
ChatGPT Work: GPT-6.2 Astraは、通常のChatGPTチャットではなくWorkで利用可能です。アクセス権はプラン、ワークスペースの設定、およびロールアウト状況によって異なります。
Codex: はい、利用可能です。CodexアプリでAstraを選択するか、CLIで/modelを使用してください。サービスを横断した複雑なバグの追跡や、修正およびテストの完了において、OpenAIが推奨するオプションです。
Claude Code: ネイティブのGPT-6.2 Astraオプションはありません。AnthropicのLLMゲートウェイのドキュメントによると、ゲートウェイを介してClaude CodeをClaude以外のモデルにルーティングすることはサポート対象外となっています。
OpenAI API: 公式モデルIDであるgpt-6.2-astraを使用してください。ツール呼び出しワークフローには、Responses APIの使用が推奨されています。
GPT Proto: GPT-6.2 AstraとGPT-6.2 Solの両方が、OpenAIの標準APIトークン料金より20%安い価格で提供されています。複雑な推論や検証可能な専門的成果物にはAstraを、日常的なコーディング、ライティング、および大量のワークロードにはSolを選択してください。初期のGPT-6.2 Astraロールアウトのタイムラインには、ローンチ前のCodexでの目撃情報が記録されています。
以下のリクエストは、ライブのAstraモデルIDを使用しています。最新の統合スニペットは、モデルページから直接コピーできます。
curl --fail-with-body --silent --show-error \
  https://gptproto.com/v1/chat/completions \
  --header "Authorization: Bearer ${GPTPROTO_API_KEY}" \
  --header 'Content-Type: application/json' \
  --data '{
    "model": "gpt-6.2-astra",
    "messages": [
      {
        "role": "user",
        "content": "We sold 12 units at $25 each. Each unit cost $10. Return revenue and gross profit in USD as JSON using the keys revenue and gross_profit."
      }
    ]
  }'
売上高は300ドル、売上総利益は180ドルになるはずです。より安価なルーチン実行を行うには、GPT-6.2 Solページに示されている正確なモデルIDに切り替えてください。また、OpenAIモデルコレクションで他の利用可能なモデルを閲覧することもできます。
総括
GPT-6.2 Astraの最も説得力のある利点は、ゲームを構築できることではありません。推論、コード、ツール、ファイル、そしてコンピュータ操作を組み合わせて、バグの修正とテスト、クリーンにビルドできる移行、照合が必要なワークブック、あるいは前提条件を明らかにする分析など、測定可能なゴールを持つ作業を実行できる能力にあります。
その制限も同様に現実的なものです。初期のユーザーからは、タスクにおいて非常に優れた能力を発揮する一方で、長期にわたる実行では指示や理解が難しい場合があるという報告が繰り返し寄せられています。日常的な作業にはSolを使用してください。仕事がそれに見合うほど困難な場合にAstraを使用し、「完了」の定義を正確に行い、結果を検証し、リサーチの判断やコラボレーションのスタイルが重要となるタスクではFable 5.2と比較してください。