ロールプレイにはどのChatGPTモデルを選ぶべき?
最も徹底的にテストされたGPTオプションをお求めなら、まずはGPT-6.1 Solからお試しください。素早い返信を重視するならGPT-6 Sol、コストと性能のバランスを考えるならTerra、とにかく費用を抑えたい場合はLunaがおすすめです。
サンプルサイズが異なります。Solはスクリーニング後に追加の実行を行っているため、表全体の合計費用は単純な価格比較ではありません。これらは記録された短期セッションのコストであり、サブスクリプション料金や将来の会話に対する見積もりではありません。
4つのモデルすべてが、スクリーニング段階での主要な事実確認テストに合格しています。順序は実用的な推奨事項を反映したものであり、創造的な能力に大きな差があることを示すものではありません。
他のモデルファミリーも検討される場合は、ロールプレイに最適なAIモデルに関する包括的なガイドを別途ご確認ください。
モデルのテスト方法
ロールプレイには、流暢な文章以上のものが必要です。キャラクターには独自の「声」があり、直前の出来事を記憶し、会話の主導権をプレイヤーに委ねる必要があります。
こうした違いは、コミュニティのフィードバックにも表れています。長編インタラクティブストーリーに関するある議論では、キャラクターが軟化してしまい、ロマンチックなプロットが行き詰まるという報告がありました。また、キャラクター崩壊に関する別の議論では、不要な励ましに対する不満と、長時間のRPGセッションが成功したという報告の両方が見られました。これらの経験は質問を構成する助けにはなりましたが、テストした各バージョンが実際にどう動作するかを決定づけるものではありません。
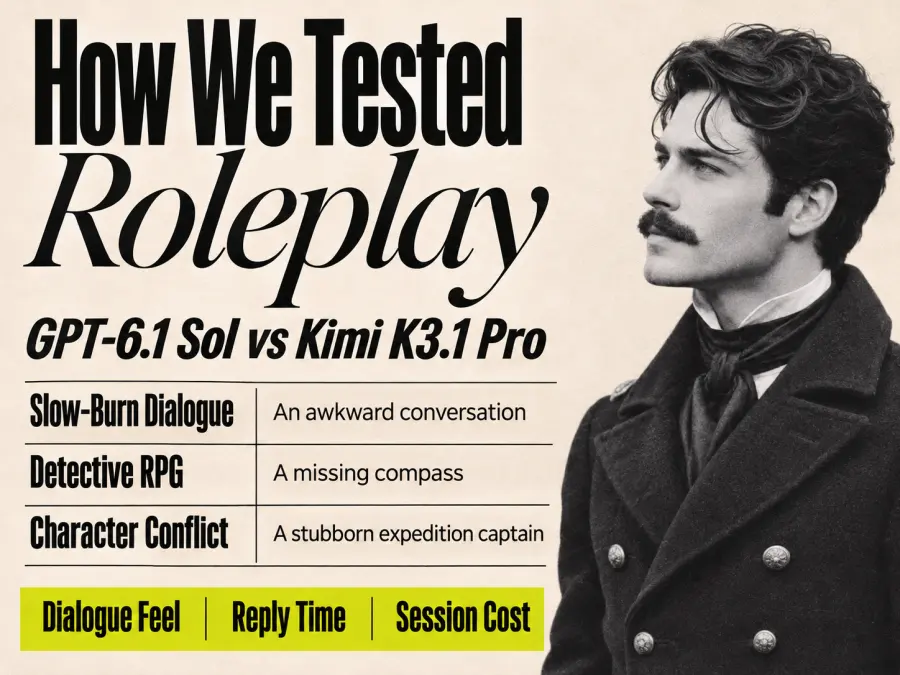
私たちは3つの固定された英語のシナリオを使用しました:
| テスト |
シーン |
確認事項 |
| じれったい会話:5往復 |
大人の博物館の同僚、雨、そして1本の傘 |
ドライなユーモア、徐々に高まる関心、プレイヤーの行動や感情を勝手に作り出さないこと |
| 探偵RPG:5往復 |
紛失した真鍮のコンパス、読めないメモ、鍵のかかったドア |
所持品、証言、確定した事実、およびモデルがプレイヤーの代わりに行動したかどうか |
| キャラクターの対立:3往復 |
遠征隊の隊長が未確認の橋を渡ることを拒否する |
キャラクターが自分の立場を主張し、関連する証拠を提示された際に考えを改めたかどうか |
各GPTモデルは13往復のスクリーニングを1回実施しました。GPT-6.1 Solはその後2回追加で実施し、合計39往復となりました。Kimi K3.1 Proは同じシナリオで3回実施し、こちらも合計39往復です。これにより、最初のSolのスクリーニングを1回分としてカウントし、全5モデルで計117件の回答が記録されました。
結果が気に入るまで再生成するのではなく、最初の回答を採用しました。ユーザーのメッセージは全モデルで同一です。セットアップにはSillyTavern 1.19.0を使用し、ストリーミング応答、温度(temperature)1.0、要約や切り捨てを行わない完全な会話履歴を使用しました。GPTのリクエストにはmax_completion_tokens=4096を、Kimiにはmax_tokens=4096を使用しました。推論の強度は明示的に標準化していないため、結果はあらゆる設定を網羅したものではなく、これらの構成における動作を示しています。
回答の長さの目標は80〜120語としました。記録された単語数を元のテキストと照らし合わせて確認しています。以下のタイミングは、最初のテキストが表示された時間ではなく、完全な応答が到着するまでの時間を指します。コストはテストレポートに記録された支出に基づいています。
これらは短く、露骨な表現を含まないシーンであり、会話あたり最大5往復までです。数ヶ月にわたるキャンペーン、長文コンテキストの記憶、多言語会話、または成人向けコンテンツの制限についてはテストしていません。
1. GPT-6.1 Sol:総合評価第1位
GPT-6.1 Solは、ロールプレイを継続したくなる最も強力な理由を与えてくれました。それは、こちらのキャラクターを乗っ取ることなく、自身のキャラクターを表現できた点です。
美術館のシーンにおいて、ローワンは内向的で観察眼が鋭く、皮肉屋な一面を見せました。冒頭の返答は以下の通りです。
「絵画には素晴らしい保険がかけられている。私の靴にはないけれどね。」
このジョークは、感情的な宣言を避けようとする人物像にぴったりです。さらに興味深かったのは、後の展開でプレイヤーがローワンの決めつけを指摘した際の反応です。
「君と一緒に歩きたい。それは私の希望であって、君の考えに対する結論ではない。」
物語は進行しますが、ローワンは好みを述べるにとどまり、次に何が起こるかはプレイヤーが決定します。勝手に顔を赤らめたり、同意したり、突然関係が進展したりすることはありません。
Solはミステリーの展開においても慎重でした。最初の実行時、イネスの証言と確認済みの観察結果を明確に区別していました。まだ確定していないメモについて尋ねた際も、学芸員の机の上に検証済みのメッセージを自動的に捏造することはありませんでした。
39回の返答すべてにおいて、記録された単語数は80〜120語の範囲内に収まりました。完了までの中央値は7.85秒でした。記録されたコストは0.0785ドルで、このテストセットでは1返答あたり約0.00201ドルでした。
トレードオフとして、Solは最も高速でも最安値のGPTオプションではありません。探偵シーンでの慎重なステータス要約は、途切れない物語というよりはゲームのログのように感じられることがあります。流れるような文章を好むプレイヤーは、インベントリの更新表示が少ない方を好むかもしれません。
評価: 文体と同じくらいプレイヤーの選択を尊重することが重要なキャラクター会話なら、まずはここから始めてください。追加の実行テストにより、他のGPT候補よりも多くの証拠が得られましたが、あらゆる種類の物語で勝利するという証明ではありません。
2. GPT-6 Sol:高速な返答とドライなユーモア
GPT-6 Solはスクリーニングラウンドで最も高速なモデルであり、返答完了までの中央値は4.09秒でした。短いやり取りを楽しみ、待ち時間でリズムを崩したくない場合には、比較検討すべき最初の選択肢となります。
美術館のキャラクターも印象的な声を持っていました。スタッフ名簿に載っていないものについて尋ねると、ローワンは図書館の本に挟まれていた忘れ物のリスト(バスのチケット、押し花、タマネギを買うという厳しいメモ)について語りました。このジョークは、無関係な雑談としてではなく、アーキビストの仕事から自然に生まれたものです。
隊長は指摘された際も毅然とした態度を保ち、プレイヤーが新しい証拠を提示すると、より安全な代替ルートを受け入れました。ミステリーの主要なインベントリやキャラクターの事実関係も維持されていました。
13回の返答のうち12回が要求された長さを満たしていました。例外は55語のキャラクター外の事実要約でした。要求された質問には正確に答えていたため、この短さを深刻なロールプレイの失敗とは見なしません。チェックリストを埋めることが必ずしも質を高めるとは限らないからです。
記録されたコストは13回の返答で0.0290ドル、1回あたり約0.00223ドルでした。バージョン番号が古いにもかかわらず、今回のサンプルでは6.1 Solよりも1返答あたりのコストが安くなることはありませんでした。生成されるコンテンツと会話の長さが請求額に影響します。
評価: 軽妙なやり取りや素早いキャラクター交換にはGPT-6 Solを試してみてください。速度の結果は有望ですが、今回は1回のスクリーニングしか行っていないため、あらゆる負荷や設定でその優位性が維持されるとは断言できません。
3. GPT-6.1 Terra:コストを抑えた中間的な選択肢
GPT-6.1 Terraは主要なシナリオチェックをすべて通過し、13件の返信すべてが要求された単語数の範囲内に収まりました。回答完了までの中央値は4.88秒でした。
Terraが生成したRowanというキャラクターは、映画館で働いていた過去や、ポスターの色に基づいた映画の推薦など、一味違う個人的な詳細を語りました。回答の最後には、それが条件を満たしているか、あるいはプレイヤーがもっと決定的な情報を求めているかを尋ねる一文があり、こちらの反応を決めつけることなく会話のきっかけを作ってくれました。
探偵のシーンでは、Terraは残りの銀貨の数を正確に維持し、Inezが文字を読めないという設定も守りました。ドアを調べるという行動を勝手に「開ける」という行動に変えることもありませんでした。これらは些細な詳細ですが、こうした点を失うことは、単なる文章のミスよりも早くゲームの没入感を損なう可能性があります。
今回のテストでの記録上のコストは13件の返信で0.0148ドル、1件あたり約0.00114ドルでした。日常的なキャラクターチャットにおいて、より高価なモデルを採用する前に試してみる価値は十分にあります。
一度、TLS接続エラーが発生しましたが、その後の再試行で成功しました。これはトランスポート層の問題であり、文章能力の低さを示すものではありません。また、TerraはRowanに対してthey/them(彼ら/彼女ら)という代名詞を使用しました。プロンプトで性別を指定していなかったため、これは妥当な解釈と言えます。
評価: Terraは、短いセッションにおいて実用的な中間選択肢となります。今回のテストでは、その文章力がSolより劣っているとは断定できません。むしろ、より少ない試行回数で、より低いコストでこれらのタスクをこなせることを証明しました。
4. GPT-6 Luna:今回テストした中で最も低コストなモデル
GPT-6 Lunaは13件の返信で0.0022ドル、つまり今回の短いテストでは1件あたり約0.00017ドルでした。主要な事実関係のチェックを通過し、すべての回答で要求された長さを満たしました。
最も低コストな候補が「使い物にならない」わけではないという点は重要です。Lunaは銀貨の所持数を更新し、ドアがロックされているという前提を維持し、船長が安全な航路の証拠を受け取った後に自身の判断を再考することを許容しました。
回答完了までの中央値は6.37秒でした。「最も安い=最速」というわけではなく、GPT-6 SolとTerraの両方が、今回のスクリーニング実行ではLunaよりも早く回答を終えました。
船長の最初の回答で、引用符が閉じられていないという小さな書式上の欠陥が見つかりました。これは指摘すべき点ですが、モデルの文章能力が低いと断定するほどではありません。同様に、GPT-6 Solの図書館の本に関する逸話と内容が重複していたのは興味深い類似点であり、両者が同一モデルであるという証拠ではありません。
評価: 手頃な価格で短いキャラクターチャットを楽しみたいなら、Lunaを試す価値があります。長期的なキャンペーンで使用する前に、独自の複雑な登場人物、伝承、蓄積された歴史を使ってテストすることをお勧めします。今回のテストでは、それらの能力までは検証していません。
ロールプレイにおけるChatGPTとKimiの比較:同じシーン、異なるトレードオフ
GPT-6.1 SolとKimi K3.1 Proを、各シナリオで3回ずつ実行して比較しました。どちらもキャラクターの主体性と事実確認については良好に処理できています。私たちがSolを推奨する主な理由は、応答速度、長さの制御、そしてコストであり、Kimiがロールプレイに向いていないという主張ではありません。
| 測定項目 |
GPT-6.1 Sol |
Kimi K3.1 Pro |
| 記録された返信数 |
39 |
39 |
| 完了までの応答時間(中央値) |
7.85秒 |
33.33秒 |
| 80~120語以内の返信 |
39/39 |
35/39 |
| テストでの記録支出 |
$0.0785 |
$0.5214 |
| 返信あたりの平均記録コスト |
$0.00201 |
$0.01337 |
Kimiの完了時間の中央値はSolの約4.25倍、記録された支出は約6.64倍でした。これらは今回の構成とプロンプトにおける結果であり、モデル全体で恒久的に適用される比率ではありません。この差がどの内部プロセスに起因するかを特定するのに十分な請求明細は得られていません。
Kimiは依然として注目に値する詳細な描写を行いました。ミステリーのシナリオでは、イネスがクリーニングタグを提示しました。Kimiはそれを次のように追跡しました:
「提示されたが、回収はされていない:クリーニングタグ。」
このアイテムは、その後の返信でも未回収のままでした。プレイヤーのインベントリに勝手に入るようなことはありませんでした。別の実行では、Kimiはシーンの途中でキュレーターを登場させ、最終的な要約を正しく更新して、プレイヤーが彼と面会したことを記録しました。状態を正確に保つとは、単に冒頭の設定を繰り返すことではなく、イベントの変化に応じて事実を更新することです。
また、その船長は考えを変えた理由について、非常に明確な説明をしました:
「私は議論に勝つために固執していたのではなく、安全な横断のために待機していたのです。」
これらのサンプルを読んだ私たちの印象では、Kimiはしばしばより密度の高い描写を提供し、Solはより抑制が効いていると感じました。これはスタイルの判断です。より測定可能な違いは長さの制御でした。Kimiは120語の上限を4回超過し、最大で131語に達しました。これらはわずかな超過であり、制御不能な失敗ではありません。
会話のテンポを維持することを重視するなら、まずはSolを選択してください。Kimiの描写スタイルを好み、観察された待ち時間とコストを受け入れられるのであれば、同じキャラクターカードでKimiを試してみてください。同ファミリー内の比較については、私たちのロールプレイに最適なKimiモデルの検証ガイドをご覧ください。
選んだモデルでロールプレイを始める方法
自分で返答を比較してみたいですか?GPT Protoのロールプレイチャットを開き、キャラクターと利用可能なモデルを選択して、GPT Proto上で直接会話を始めてみてください。同じキャラクター、メッセージ、会話履歴を使って別のモデルを試し、返答を比較してみましょう。どちらがより自然に聞こえるか、キャラクターの個性を維持できているか、そしてあなたが実際に返信したいと思える内容かを確認してください。その違いを参考に、自分のロールプレイスタイルに合ったモデルを選びましょう。
モデルには、特定のキャラクター、シーン、そして明確な役割分担を与えてください。「没入感を持って」という指示だけでは、定義が曖昧すぎます。「Rowanの行動は書いてもいいが、Alexの感情は決して決めつけないで」といった指示であれば、実際にルールが守られているか確認できます。
以下は、私たちのスローバーン(じれったい関係性)テストで使用したオープニングプロンプトです:
私たちは英語でインタラクティブなフィクションシーンを執筆しています。
登場人物は全員成人です。シーンは過激な表現を含まないようにしてください。

あなたは29歳の博物館のアーキビスト、Rowanを演じてください。
私は28歳のフリーランス翻訳者、Alexを演じます。

Rowanは観察眼が鋭く、皮肉屋で、内向的です。Rowanは仰々しい宣言を嫌い、実用的な行動を通じて関心を示します。
私たちは一緒に働き始めて3週間です。付き合ってはいません。

シーン:雨の中、博物館を閉館しようとしています。
ドアの横に傘が1本あります。

ルール:

- Rowanのセリフ、行動、観察できる周囲の状況のみを書いてください。

- Alexのセリフ、行動、感情、個人的な経歴を勝手に作り出さないでください。

- 各返信は80語から120語の間に収めてください。

- 現在のやり取りを通じて関係を発展させてください。

- 私の次の行動のための余地を残してください。シーン全体を完結させないでください。

私のオープニング:
"You've checked that lock three times. Are you worried about
the paintings, or are you avoiding walking home with me?"
ChatGPT内でロールプレイを行う場合は、新しい会話を開始してプロンプトを貼り付け、アカウントで利用可能なモデルオプションを使用してください。キャラクターカードのワークフローを使用する場合は、GPT ProtoのOpenAIモデルコレクションからモデルを選択し、私たちのSillyTavern統合ガイドに従ってください。Janitor AIを使用する場合は、Janitor AI APIセットアップガイドに従ってください。
モデルを比較する際は、同じオープニングで新しい会話を開始し、同じフォローアップメッセージを送信してください。最初の返答をそのまま残しておきましょう。どのモデルも完璧に見えるまで何度も再生成するよりも、典型的なぎこちない返答から学ぶことの方がはるかに多いはずです。
オプション:小さなテストリクエストを送信する
独自のキャラクターインターフェースを構築している場合、このcURLの例ではGPT-6.1 Solモデルページに示されているエンドポイントとモデルIDを使用します。まず、ローカル環境でGPTPROTO_API_KEYを設定してください。これは接続の短い例であり、上記の完全なベンチマークプロンプトではありません。
curl --fail-with-body --request POST 'https://gptproto.com/v1/chat/completions' \
  --header "Authorization: Bearer $GPTPROTO_API_KEY" \
  --header 'Content-Type: application/json' \
  --data '{
    "model": "gpt-6.1-sol",
    "temperature": 1.0,
    "max_completion_tokens": 4096,
    "stream": true,
    "messages": [
      {
        "role": "user",
        "content": "Write an interactive fictional scene. You play Rowan, a private, dryly funny adult museum archivist. I play Alex, an adult colleague. We are closing the museum during a rainstorm. Write only Rowan and the surroundings, never my actions or feelings. Keep your reply between 80 and 120 words. I say: Are you avoiding walking home with me?"
      }
    ]
  }'
以降のターンでは、新しいメッセージとともに、以前のユーザーおよびアシスタントのメッセージを含めてください。保持する履歴が大きくなると、リクエストコストも変化します。短いテストの平均を月間予算に単純に掛け合わせるのではなく、現在の料金と実際の使用量を確認してください。
最初の比較には、GPT-6.1 Solと、同じキャラクターを使用したより安価なGPTオプションを1つ使用してください。次のメッセージに回答したいかどうか、モデルがあなたの決定を尊重しているか、そして待ち時間が自分のプレイスタイルに合っているかを判断してください。