Pourquoi la fuite du code source de Claude est importante pour les développeurs aujourd’hui
Les meilleures leçons de génie logiciel proviennent parfois de divulgations involontaires. La récente fuite du code source de Claude, survenue lorsqu’Anthropic a accidentellement inclus des source maps complètes dans un package npm public, en est un parfait exemple. Pour ceux d’entre nous qui construisent dans le domaine de l’IA, c’était comme découvrir un programme de masterclass abandonné sur un banc public.
Il ne s’agissait pas d’une simple petite erreur : la fuite du code source de Claude a révélé la logique TypeScript interne de Claude Code. Elle nous a offert un aperçu rare et sans fard de la manière dont un laboratoire de premier plan structure un agent IA prêt pour la production. Il s’agit du véritable mode d’emploi pour gérer des boucles d’outils complexes et des autorisations à haut risque.
L’incident a rapidement été corrigé, mais les enseignements tirés de la fuite du code source de Claude continuent de circuler parmi les professionnels. Il met en évidence la réalité d’une approche centrée sur l’IA. Il montre que même les géants rencontrent des difficultés lorsqu’ils déploient du code dans l’univers imprévisible de npm.
Voici le point essentiel : nous avons rarement l’occasion de voir l’infrastructure qui se trouve derrière ces modèles. La fuite du code source de Claude a levé le voile sur l’« Agent Loop ». Elle nous a montré exactement comment Anthropic gère, en temps réel, les frictions entre l’intention humaine et l’exécution par la machine.
L’incident de source map à l’origine de la fuite du code source de Claude
La cause de la fuite du code source de Claude était étonnamment banale. Dans la précipitation pour itérer, un développeur a probablement oublié de supprimer les source maps avant de publier sur le registre npm. Cela a permis à toute personne disposant d’un décompilateur de reconstruire les fichiers TypeScript d’origine à partir du JavaScript obfusqué.
C’est une erreur que nous avons probablement tous failli commettre. Mais dans le contexte de la fuite du code source de Claude, elle est devenue une immense occasion d’apprentissage pour la communauté. Nous avons découvert que l’outil repose sur Node.js et utilise React avec Ink pour son interface de terminal.
Mais la véritable valeur de la fuite du code source de Claude résidait dans sa logique. Les source maps ont fourni une feuille de route pour gérer les appels d’outils asynchrones tout en maintenant une interface de terminal réactive. C’était une masterclass d’architecture TypeScript moderne, spécialement adaptée à une application d’IA.
Et soyons honnêtes, la fuite du code source de Claude nous a donné un aperçu du côté « humain » d’Anthropic. Le code était propre, bien commenté et révélait un profond engagement en faveur de la sécurité. Elle a prouvé que même dans une fuite, les bonnes pratiques d’ingénierie se distinguent et suscitent le respect.
La fuite du code source de Claude nous rappelle que la transparence de l’architecture IA, même lorsqu’elle est accidentelle, aide tout l’écosystème des développeurs à améliorer ses stratégies d’implémentation.
Tirer les leçons des failles de sécurité révélées par la fuite du code source de Claude
Chaque développeur sait que la sécurité repose sur plusieurs couches. La fuite du code source de Claude a confirmé qu’Anthropic prend cet aspect très au sérieux. Bien que la fuite elle-même soit due à une faille de sécurité, le code interne a révélé une approche sophistiquée du sandboxing et du consentement utilisateur, ce qui en a surpris plus d’un.
En analysant la fuite du code source de Claude, nous voyons comment le système distingue les commandes « sûres » des commandes « dangereuses ». Il ne fait pas aveuglément confiance au modèle. Un processus de vérification en plusieurs étapes garantit que l’IA ne puisse pas agir de manière incontrôlée sur votre système de fichiers local.
Nous pouvons appliquer ces enseignements de la fuite du code source de Claude à nos propres projets. Si vous créez un outil qui utilise une API pour exécuter du code, vous avez besoin d’un pipeline d’autorisations. La fuite du code source de Claude nous a montré exactement à quoi ressemble ce pipeline en production.
Si vous voulez garder une longueur d’avance, consultez les dernières actualités du secteur de l’IA pour voir comment d’autres entreprises réagissent à ce type de divulgation. La fuite du code source de Claude n’est qu’un chapitre de l’histoire en constante évolution de la sécurité de l’IA.
Enseignements architecturaux de la fuite du code source de Claude
L’architecture centrale révélée par la fuite du code source de Claude repose sur une « boucle d’outils en streaming avec autorisations ». L’expression peut sembler complexe, mais le concept est en réalité élégant. Cela signifie que le modèle commence immédiatement à travailler, avant même d’avoir fini de « réfléchir » à l’ensemble de la tâche.
Dans la fuite du code source de Claude, nous avons vu que le système est conçu pour être très réactif. Lorsque le modèle IA décide qu’il doit appeler un outil, l’exécution s’effectue en flux continu. Cela réduit la latence perçue par l’utilisateur, un problème majeur dans la plupart des applications d’IA.
Une autre découverte fascinante de la fuite du code source de Claude concernait l’utilisation de React et Ink. Concevoir une interface en ligne de commande (CLI) aussi fluide qu’une application web est difficile. La fuite du code source de Claude a montré que l’utilisation d’un modèle basé sur des composants pour l’affichage dans le terminal est la bonne approche.
La fuite du code source de Claude a également mis en évidence un processus de démarrage par phases. L’outil se charge progressivement, en donnant la priorité aux modules de sécurité. Cela garantit que la « frontière de confiance » est établie avant l’initialisation en arrière-plan d’une logique IA lourde ou d’appels API.
Les outils en streaming révélés par la fuite du code source de Claude
Dans la plupart des implémentations basiques, il faut attendre la réponse complète de l’API avant d’agir. La fuite du code source de Claude nous a montré une meilleure méthode. Grâce au streaming des appels d’outils, l’agent peut commencer à exécuter une commande bash pendant que le modèle décrit encore ce qu’il fait.
Cette mentalité « streaming d’abord » est visible partout dans la fuite du code source de Claude. Elle classe les outils en outils « sûrs en parallèle » et « séquentiels ». Le framework peut ainsi optimiser l’ordre d’exécution sans que l’utilisateur ait à gérer manuellement une logique complexe de threads ou à passer par une API distincte.
Si le modèle lance une commande dangereuse, le système peut interrompre le processus en plein flux. La fuite du code source de Claude a prouvé que l’interruptibilité est un élément de premier ordre de leur architecture. Ce n’est pas une réflexion après coup : elle est intégrée au cœur même de la boucle de l’agent.
Pour ceux d’entre nous qui utilisent une API unifiée, ces modèles sont extrêmement précieux. Vous pouvez consulter la documentation complète de l’API pour voir comment implémenter des modèles de streaming similaires lors de la connexion à différents LLM via une interface unique.
La fuite du code source de Claude montre également comment gérer la « recherche d’outils ». Au lieu d’insérer toutes les définitions d’outils dans le prompt, le système recherche à la volée la définition appropriée. Cela permet d’économiser énormément de jetons et de préserver la propreté de la fenêtre de contexte.
Tout est question d’efficacité. La fuite du code source de Claude a révélé que la gestion du prompt est tout aussi importante que celle du code. En choisissant intelligemment le moment d’afficher les schémas d’outils, l’équipe réduit les coûts de l’API et accélère les réponses.
L’utilisation d’un service comme GPT Proto peut vous aider à optimiser davantage ces coûts. GPT Proto propose jusqu’à 70 % de réduction sur les principales API d’IA, ce qui est essentiel lorsque vous exécutez des boucles d’outils à haute fréquence comme celles observées dans la fuite du code source de Claude.
Gérer la boucle de l’agent dans la fuite du code source de Claude
La boucle de l’agent est le cœur du système. Dans la fuite du code source de Claude, cette boucle apparaît comme une machine à états robuste. Elle gère tout, de l’entrée utilisateur à la sortie du modèle, en passant par l’exécution des outils et la récupération après erreur, sans difficulté.
Un détail marquant de la fuite du code source de Claude concerne la gestion des tâches en plusieurs étapes. Le système ne boucle pas aveuglément. Il conserve en mémoire ce qui a déjà été tenté, ce qui empêche l’IA de rester bloquée dans une récursion infinie de commandes défaillantes.
La fuite du code source de Claude a également révélé un mécanisme de « boîte aux lettres ». Celui-ci est utilisé pour la collaboration entre agents au sein d’un même processus. Il permet aux différentes parties du système de synchroniser les autorisations et les mises à jour de statut sans communication interprocessus complexe ni surcharge d’API supplémentaire.
Ce niveau de coordination interne explique pourquoi Claude Code semble si puissant. La fuite du code source de Claude nous a fourni le plan pour créer des agents capables de travailler réellement en équipe. Il s’agit d’un progrès considérable par rapport au prompting « one-shot » auquel la plupart des utilisateurs sont habitués.
Le pipeline d’autorisations en quatre couches de la fuite du code source de Claude
La sécurité constitue le principal obstacle pour tout agent IA ayant un accès en écriture à votre machine. La fuite du code source de Claude a exposé un système de défense en quatre couches. Ce pipeline est conçu pour détecter les mauvaises intentions avant qu’elles ne causent de véritables dommages à l’environnement.
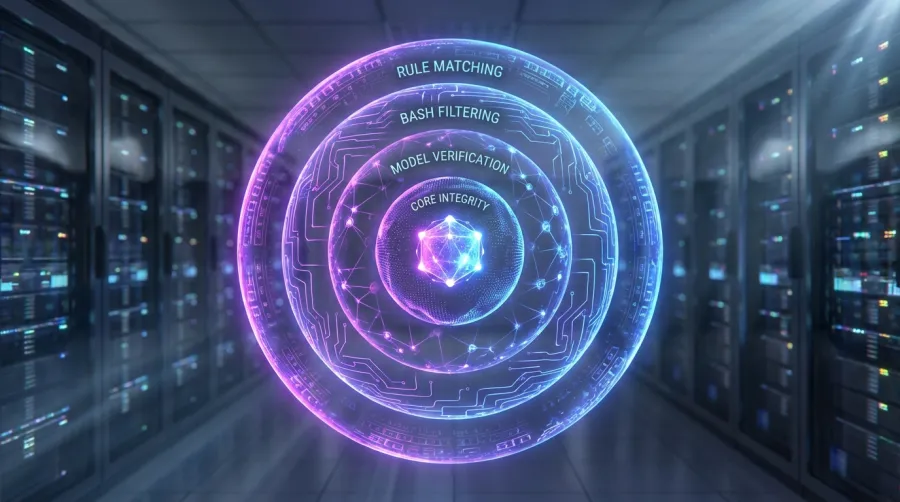
Tout d’abord, la fuite du code source de Claude a montré l’existence d’un « Rule Matcher ». Il s’agit d’une vérification rapide et déterministe basée sur les configurations définies par l’utilisateur. Si vous avez bloqué l’accès à un répertoire précis, cette couche arrête immédiatement l’IA, sans appel API coûteux.
Vient ensuite le « Bash Classifier ». La fuite du code source de Claude révèle un ensemble de motifs regex et d’heuristiques qui recherchent les commandes dangereuses classiques. C’est simple, mais efficace : la première ligne de défense contre le code malveillant évident ou les suppressions accidentelles.
La troisième couche est le « Transcript Classifier ». C’est ici que les choses deviennent intéressantes dans la fuite du code source de Claude. Elle examine le contexte de la conversation et pose la question suivante : « Cette commande a-t-elle réellement du sens compte tenu de la demande de l’utilisateur ? »
Enfin, si le système a encore un doute, il effectue un appel API indépendant vers un modèle Claude distinct et plus petit. La fuite du code source de Claude a montré que ce modèle « arbitre » a une seule mission : évaluer la sécurité de l’action proposée. C’est une excellente manière d’équilibrer rapidité et sécurité.
Analyse approfondie de la logique de sécurité dans la fuite du code source de Claude
L’utilisation d’un modèle indépendant pour la sécurité est l’un des principaux enseignements de la fuite du code source de Claude. Elle empêche l’agent principal de « s’auto-contrôler », ce qui peut facilement être contourné par injection de prompt. Le modèle arbitre reste objectif.
Dans la fuite du code source de Claude, nous voyons également comment sont gérés les modes d’« approbation automatique ». Même lorsque l’utilisateur donne à l’IA un contrôle « total », ces filtres internes restent actifs. Le système dit en substance : « Je vous fais confiance, mais je fais aussi confiance à mes contrôles de sécurité. »
Cette approche en couches réduit les « faux positifs » tout en maximisant la sécurité. La fuite du code source de Claude démontre qu’un modèle gigantesque n’est pas nécessaire pour tout faire. Une chaîne d’outils et d’API spécialisés peut offrir un niveau de fiabilité bien supérieur.
Si le coût de ces appels de sécurité supplémentaires vous inquiète, vous pouvez gérer plus efficacement votre facturation API grâce à un routage privilégiant les coûts. Vos contrôles de sécurité utiliseront ainsi les modèles les plus économiques disponibles pour chaque tâche.
- Filtrage basé sur des règles pour un blocage instantané
- Détection des motifs correspondant aux commandes bash dangereuses connues
- Analyse contextuelle de l’historique de la conversation
- Vérification par un modèle indépendant pour les actions à haut risque
Implémenter des frontières de confiance à partir de la fuite du code source de Claude
Une « frontière de confiance » est le point où l’IA passe de la suggestion d’une modification à sa réalisation effective. La fuite du code source de Claude montre que cette frontière est explicitement gérée dans le code. Il ne s’agit pas simplement d’un indicateur booléen, mais d’un état complexe.
Dans la fuite du code source de Claude, le système isole les tâches qui se produisent avant et après la confirmation de l’utilisateur. Ainsi, même si l’IA fonctionne en arrière-plan, elle ne peut pas accéder aux parties sensibles du système sans l’« autorisation » explicite du développeur.
Cette conception empêche l’IA de « halluciner » son chemin vers un dossier restreint. La fuite du code source de Claude prouve qu’un bon outil d’IA doit être aussi sceptique vis-à-vis des sorties du modèle que l’utilisateur humain. La sécurité est un processus continu de vérification.
En étudiant la fuite du code source de Claude, nous apprenons que les autorisations doivent être granulaires. Ne donnez pas simplement un « accès » à un agent. Accordez-lui l’accès à une tâche précise, pour une durée définie et dans des conditions spécifiques. C’est la référence absolue en matière de sécurité de l’IA révélée ici.
Optimisation des jetons et gestion du contexte dans la fuite du code source de Claude
L’une des principales difficultés liées à l’utilisation d’une API est la taille limitée de la fenêtre de contexte. La fuite du code source de Claude a révélé que les ingénieurs d’Anthropic sont passés maîtres dans la gestion du contexte. Ils ne déversent pas tout le projet dans le prompt en espérant que tout se passe bien.
La fuite du code source de Claude a montré un système qui construit dynamiquement le prompt. Il extrait des informations de sources telles que CLAUDE.md, les fichiers mémoire et le statut Git actuel. Le modèle dispose ainsi exactement des informations nécessaires, et de rien de plus, ce qui maintient le nombre de jetons à un niveau réduit.
Lorsque la fenêtre de contexte est pleine, le système ne plante pas. La fuite du code source de Claude a révélé une logique de résumé automatique. Celle-ci prend les premières parties de la conversation et les compresse en un résumé concis afin de libérer de l’espace pour de nouvelles informations.
Ce type de « contexte glissant » est essentiel pour les sessions longues. La fuite du code source de Claude montre comment préserver la cohérence pendant plusieurs heures de travail. Il s’agit d’une interaction sophistiquée entre le système de fichiers local et l’API d’IA distante.
Compression intelligente du contexte révélée par la fuite du code source de Claude
La stratégie de résumé découverte dans la fuite du code source de Claude est particulièrement ingénieuse. Elle ne supprime pas simplement les anciens messages. Elle utilise l’IA pour résumer les « points clés » et les « changements d’état » de l’historique. Le contexte important est ainsi conservé tandis que le superflu est éliminé.
Dans la fuite du code source de Claude, nous constatons également l’existence d’une limite par défaut sur les jetons de sortie. Cela empêche le modèle de s’étendre inutilement. L’IA est contrainte à la concision, ce qui est meilleur pour l’utilisateur et réduit considérablement le temps de réponse et le coût de l’API.
Si vous développez vos propres outils, vous pouvez surveiller l’utilisation de votre API en temps réel afin de voir comment différentes stratégies de gestion du contexte affectent vos résultats financiers. La fuite du code source de Claude constitue un excellent modèle pour commencer.
Une autre astuce révélée par la fuite du code source de Claude est l’utilisation de fichiers « Memory ». Il s’agit de fichiers locaux dans lesquels l’agent stocke des informations à long terme sur le projet. Ils servent de contexte secondaire et permanent, conservé entre les différentes sessions et les appels au modèle.
La fuite du code source de Claude prouve que le stockage local est le meilleur allié d’un développeur IA. Il n’est pas nécessaire d’envoyer chaque donnée au modèle à chaque fois. Si vous pouvez la stocker localement et ne l’envoyer que lorsqu’elle est pertinente, vous gagnez à la fois en rapidité et en coût.
| Stratégie de contexte |
Méthode révélée par la fuite |
Avantage |
| Construction du prompt |
Assemblage multi-source (Git, MD, fichiers locaux) |
Contexte très pertinent, moins de jetons inutiles. |
| Gestion de la fenêtre |
Résumé automatisé des premiers messages |
Des sessions qui semblent infinies, sans dépasser les limites. |
| Contrôle des sorties |
Limites strictes de jetons et streaming |
Réponses plus rapides et coûts d’API réduits à chaque échange. |
Divulgation progressive des outils dans la fuite du code source de Claude
L’un des éléments les plus innovants découverts dans la fuite du code source de Claude est la « divulgation progressive ». La plupart des agents IA définissent tous leurs outils dans le prompt système. Si vous disposez de 50 outils, cela représente des milliers de jetons consommés avant même que l’utilisateur ne saisisse un mot.
La fuite du code source de Claude montre que Claude Code ne fournit d’abord que les noms des outils. Si le modèle pense avoir besoin d’un outil, il utilise une fonction spéciale « ToolSearch » pour obtenir le schéma JSON complet de cet outil précis. C’est une avancée majeure en matière d’efficacité.
Cette approche, mise en évidence par la fuite du code source de Claude, permet de disposer d’une immense bibliothèque de « Skills » sans alourdir le prompt. Le système devient extrêmement évolutif. Des centaines d’outils spécialisés peuvent être disponibles, mais le modèle ne « paie » que pour ceux qu’il utilise réellement.
La fuite du code source de Claude démontre une compréhension claire de l’économie de l’IA. Chaque jeton a un coût. En retardant le chargement des définitions d’outils, Anthropic rend le système plus économique pour l’utilisateur final et plus réactif dans son ensemble.
Extensibilité et système de Skills dans la fuite du code source de Claude
La fuite du code source de Claude a révélé un système de « Skill » très flexible. Une Skill est essentiellement un fichier Markdown qui décrit un ensemble précis de fonctionnalités. Elle comprend des métadonnées indiquant notamment quand elle doit être déclenchée et quels outils sont nécessaires à son bon fonctionnement.
Dans la fuite du code source de Claude, nous voyons que les Skills sont activées en fonction du contexte. Par exemple, si vous modifiez un fichier Python, les Skills spécifiques à Python deviennent actives. Ce chargement dynamique permet à l’IA de rester concentrée sur la tâche en cours sans être distraite par des outils non pertinents.
La fuite du code source de Claude a également montré un puissant système de « Hook ». Il permet aux développeurs d’injecter une logique personnalisée à différents moments du cycle de vie. Vous pouvez exécuter du code avant le démarrage d’un outil, après sa fin ou au début de la session, ce qui vous donne un contrôle total.
Ce niveau d’extensibilité explique pourquoi Claude Code est bien plus qu’un simple wrapper. La fuite du code source de Claude montre un framework conçu pour être enrichi par la communauté. C’est une plateforme destinée à créer des assistants de programmation IA hautement spécialisés.
Créer des Skills personnalisées à partir de la fuite du code source de Claude
Le système de Skills basé sur Markdown présenté dans la fuite du code source de Claude est brillant parce qu’il est lisible par l’humain. Il n’est pas nécessaire d’être un ingénieur senior pour comprendre comment ajouter une fonctionnalité. Il suffit d’écrire une description et de définir les déclencheurs dans un format simple.
En examinant la fuite du code source de Claude, nous pouvons voir comment ces Skills sont indexées. Le système utilise une base de données locale pour trouver rapidement la Skill adaptée au chemin du fichier ou à la branche Git actuels. C’est une méthode très efficace pour gérer un grand nombre d’extensions.
La fuite du code source de Claude laisse également entrevoir une sorte de « marketplace ». Bien qu’elle ne soit pas entièrement implémentée, la structure nécessaire au partage de ces Skills entre utilisateurs est présente. Cela permettrait de faire émerger un écosystème dynamique autour de l’outil central, à l’image des extensions VS Code.
Si vous souhaitez créer vos propres agents, vous pouvez essayer les agents IA intelligents de GPT Proto, qui intègrent souvent ce type de systèmes de Skills modulaires. C’est bien plus facile que de partir de zéro, notamment grâce aux enseignements de la fuite du code source de Claude.
Model Context Protocol (MCP) dans la fuite du code source de Claude
La fuite du code source de Claude a confirmé une intégration approfondie avec le Model Context Protocol (MCP). Il s’agit d’une méthode standardisée permettant aux modèles d’IA d’interagir avec des sources de données et des outils externes. Elle devient progressivement la norme du secteur pour les workflows agentiques.
Dans la fuite du code source de Claude, nous voyons comment l’agent gère plusieurs serveurs MCP. Il utilise un processus d’authentification en trois couches pour garantir que seuls les outils autorisés puissent communiquer avec le modèle. C’est essentiel pour préserver un environnement sécurisé.
La fuite du code source de Claude montre que MCP n’est pas un simple module complémentaire, mais un élément central de l’architecture. La boucle d’outils est conçue pour gérer la nature asynchrone des appels MCP et garantir que l’interface reste réactive, même lorsqu’elle attend des données externes.
Cette intégration, visible dans la fuite du code source de Claude, permet à Claude Code de communiquer avec une grande variété de services. Des connecteurs de bases de données aux outils de recherche web, MCP fournit une interface unifiée qui simplifie l’ensemble du processus de développement d’agents IA.
Les aspects cachés et l’avenir révélés par la fuite du code source de Claude
Au-delà de l’ingénierie sérieuse, la fuite du code source de Claude a également révélé une certaine personnalité. Au cœur des fichiers se trouvait un système complet pour un « animal électronique » nommé Buddy. Il semble avoir été prévu comme une plaisanterie du 1er avril, avec 18 espèces différentes et des animations ASCII.
La présence de « Buddy » dans la fuite du code source de Claude nous rappelle que les personnes qui construisent ces systèmes complexes savent aussi s’amuser. C’est un petit détail, mais il rend le projet plus accessible et plus humain. Même les meilleurs chercheurs en IA apprécient un bon easter egg.
Mais revenons au volet commercial : la fuite du code source de Claude montre une voie claire vers une intelligence en « essaim ». Le code comprend un système permettant à plusieurs agents de collaborer au sein d’un même processus. C’est la prochaine frontière du développement assisté par l’IA.
La fuite du code source de Claude a également révélé un système de tâches persistantes. Il permet à l’IA d’exécuter des tâches similaires à des cron en arrière-plan. Qu’il s’agisse de lancer des tests toutes les heures ou de surveiller un serveur, l’agent peut travailler même lorsque vous n’êtes pas devant votre clavier.
Systèmes Buddy et essaims dans la fuite du code source de Claude
La fonctionnalité « Swarm » de la fuite du code source de Claude est particulièrement impressionnante. Elle utilise `AsyncLocalStorage` dans Node.js pour isoler le contexte de différents agents au sein du même thread. C’est une méthode très économe en ressources pour gérer l’orchestration multi-agents.
Au lieu de créer un nouveau processus pour chaque agent, ce qui est lent et gourmand en mémoire, l’approche présentée dans la fuite du code source de Claude reste légère. C’est une véritable masterclass d’optimisation des performances de Node.js pour les charges de travail IA.
La fuite du code source de Claude montre également comment ces essaims peuvent communiquer. Ils utilisent une « boîte aux lettres » partagée pour transmettre des messages et synchroniser les autorisations. L’ensemble de l’essaim reste ainsi aligné en permanence sur les objectifs et les préférences de sécurité de l’utilisateur.
Cette architecture, révélée par la fuite du code source de Claude, constitue un modèle pour l’avenir du travail. Nous n’aurons pas seulement un assistant IA, mais un essaim d’assistants, chacun spécialisé dans une partie différente de la stack et tous capables de travailler ensemble de manière fluide.
Ce que la fuite du code source de Claude nous apprend sur l’IA en production
Le principal enseignement de la fuite du code source de Claude est que la création d’une IA de production repose à 90 % sur l’ingénierie et à 10 % sur les appels au modèle. La complexité ne réside pas dans le fait de faire parler le modèle, mais dans la gestion des éléments « non IA », comme les autorisations, le contexte et la réactivité de l’interface.
La fuite du code source de Claude a prouvé qu’un outil IA performant doit être conçu avec une mentalité « sécurité d’abord » et « efficacité d’abord ». Il ne suffit pas d’ajouter une API à un script et de s’arrêter là. Il faut un framework robuste capable de gérer l’imprévisibilité des sorties de l’IA.
Si vous souhaitez construire quelque chose à ce niveau, explorez tous les modèles d’IA disponibles afin de trouver le bon équilibre entre rapidité et intelligence. La fuite du code source de Claude montre que même les meilleurs modèles ont besoin d’un excellent ensemble de composants logiciels pour les accompagner.
Et souvenez-vous que vous n’avez pas à tout faire seul. Avec une plateforme comme GPT Proto, vous pouvez accéder à plusieurs modèles via une API unique, ce qui facilite l’implémentation des essaims multi-agents et des modèles arbitres observés dans la fuite du code source de Claude.
Alors, tirez les leçons de la fuite du code source de Claude et commencez à construire. Le modèle est disponible, les outils sont prêts et le potentiel du développement piloté par l’IA ne fait que commencer à se concrétiser. N’oubliez simplement pas de supprimer vos source maps avant de publier.
Rédigé par : GPT Proto
« Accédez aux meilleurs modèles d’IA au monde grâce à la plateforme API unifiée de GPT Proto. »