Pourquoi cette fuite de Claude Code sur GitHub est importante aujourd’hui
Le monde de la technologie a récemment été bouleversé lorsque le code source du nouvel assistant de programmation IA d’Anthropic a fait surface. Pour tous ceux qui développent dans le domaine des agents, le claude code leak github n’est pas seulement une faille de sécurité ; c’est une véritable leçon d’ingénierie de haut niveau. Il montre exactement comment les professionnels conçoivent des outils qui ne se contentent pas de « discuter », mais qui fonctionnent réellement.
La plupart des tutoriels sur l’IA que vous trouvez en ligne sont des jouets. Ils vous montrent comment envoyer un prompt et obtenir une réponse. Mais le claude code leak github révèle l’écart considérable entre un script « hello world » et un système de niveau production conçu pour gérer des systèmes de fichiers complexes et d’immenses bases de code. C’est le premier véritable aperçu des coulisses d’un assistant de premier plan.
Voici le point essentiel : nous ne faisions que supposer comment des entreprises comme Anthropic géraient l’état et le contexte. Le claude code leak github met fin aux suppositions. Il fournit un modèle pour gérer les difficultés du développement réel. Si vous voulez aller au-delà des simples wrappers, vous devez comprendre les modèles présents dans cette fuite.
Mais pourquoi tout le monde parle-t-il précisément du claude code leak github aujourd’hui ? Parce qu’il établit un nouveau standard pour l’ingénierie de niveau 2026. Nous nous éloignons des agents monolithiques pour nous orienter vers des architectures modulaires et distribuées. Le code trouvé sur GitHub prouve que l’avenir de l’IA repose sur l’orchestration, et pas uniquement sur l’intelligence.
La mine d’or technique de la fuite de Claude Code sur GitHub
En examinant le claude code leak github, on constate immédiatement qu’il ne s’agit pas d’un simple script Python. C’est un système sophistiqué construit avec TypeScript et Bun. L’équipe d’ingénierie a donné la priorité à la vitesse dès la première milliseconde. Elle a compris que les développeurs détestent attendre et a donc optimisé la latence de démarrage avant toute autre chose.
Dans le claude code leak github, j’ai remarqué que la lecture de la configuration et le préchargement des clés s’effectuent en parallèle du chargement du module principal. C’est un petit détail, mais c’est ce qui distingue un outil professionnel d’un projet amateur. Cette attention constante portée aux performances des entrées-sorties est un thème récurrent dans tout le dépôt.
Au-delà de la vitesse, le claude code leak github présente un système à double mode. Il comprend un REPL interactif pour les humains et un mode SDK sans interface pour les pipelines CI/CD. Cette flexibilité témoigne d’une compréhension approfondie du flux de travail des développeurs. Vous pouvez explorer les modèles révélés dans le claude code leak github afin de voir comment ces architectures exploitent différentes capacités des LLM.
Le claude code leak github prouve que l’ère de la simple ingénierie des prompts est révolue. La véritable valeur réside dans la conception du système qui entoure le modèle.
L’une des découvertes les plus surprenantes du claude code leak github est l’utilisation de React et d’Ink pour l’interface du terminal. Cela peut sembler disproportionné, mais c’est brillant. Gérer l’état des sorties en streaming et les appels concurrents aux outils dans un terminal relève du cauchemar. React rend cette gestion déclarative et maîtrisable.
Concepts fondamentaux : l’architecture derrière la fuite de Claude Code sur GitHub
L’architecture révélée dans le claude code leak github est bien plus complexe que toutes les configurations à agent unique que j’ai pu voir. Il s’agit d’un système multicouche qui considère le LLM comme un simple composant d’une machine beaucoup plus vaste. Le code montre comment les tâches de longue durée sont gérées sans faire exploser la fenêtre de contexte ni les coûts.
Au cœur du claude code leak github se trouve une couche d’orchestration sophistiquée. Elle ne se contente pas de faire circuler du texte. Elle gère une machine à états complexe capable de traiter les interruptions, les échecs d’outils et les remplacements décidés par l’utilisateur. C’est là que la plupart des développeurs rencontrent des difficultés, et la fuite fournit une voie claire pour avancer.
Le claude code leak github met également en évidence une évolution vers les « requêtes secondaires ». Au lieu de demander à un grand modèle de tout faire, le système utilise des modèles plus petits et moins coûteux pour les méta-tâches. Le modèle principal peut ainsi se concentrer sur la logique complexe, tandis que le petit modèle s’occupe des vérifications d’autorisation ou de la synthèse des sorties.
Pour les développeurs, le claude code leak github rappelle que l’IA est désormais un problème d’ingénierie des systèmes. Vous n’écrivez pas seulement des prompts ; vous construisez un système distribué dont l’un des nœuds se trouve être un LLM non déterministe. Cette prise de conscience est essentielle pour tous ceux qui utilisent une API dans des applications de production.
Les enseignements d’une stack moderne tirés de la fuite de Claude Code sur GitHub
La stack technique du claude code leak github est très moderne. L’utilisation de Bun comme environnement d’exécution, à la place de Node.js standard, témoigne du besoin de performances. Il est évident que l’équipe derrière le claude code leak github voulait que l’outil soit aussi rapide qu’un binaire natif, bien qu’il soit écrit en TypeScript.
Un autre enseignement majeur du claude code leak github est le mode « headless ». En supprimant l’interface et en produisant uniquement des flux JSON, l’outil peut être facilement intégré à des IDE ou à des flux de travail automatisés. Cette modularité illustre parfaitement comment créer des outils d’IA durables.
- Environnement d’exécution : Bun pour une exécution haute performance.
- Interface utilisateur : React + Ink pour gérer les états complexes du terminal.
- CLI : Commander pour une analyse robuste de la ligne de commande.
- Streaming : Prise en charge native des sorties JSON et texte en temps réel.
La stack du claude code leak github montre qu’ils n’hésitent pas à accepter la complexité si elle permet d’améliorer l’expérience utilisateur. Ils ont choisi le bon outil pour chaque tâche, même lorsque cela impliquait d’intégrer un framework d’interface lourd dans un environnement CLI. C’est un choix d’ingénierie audacieux qui s’est avéré payant.
Si vous souhaitez explorer tous les modèles d’IA disponibles utilisés dans ce type de stack, vous constaterez que les temps de réponse de l’API et la stabilité du streaming sont les facteurs les plus critiques. L’architecture du claude code leak github repose sur un flux d’API très fiable.
Analyse étape par étape : mise en cache et optimisation des prompts dans la fuite de Claude Code sur GitHub
Le secret d’ingénierie le plus précieux du claude code leak github est peut-être la manière dont la mise en cache des prompts est gérée. Le coût des tokens est le tueur silencieux des startups spécialisées dans l’IA. Le claude code leak github révèle une approche précise et hiérarchisée de la mise en cache, qui maximise les taux d’accès au cache tout en réduisant la latence.
Ils n’envoient pas l’intégralité du contexte à l’API à chaque fois. Le claude code leak github présente un système qui divise le prompt en parties statiques et dynamiques. La partie statique — comme les instructions système et les définitions principales des outils — est mise en cache globalement. Cela permet d’économiser énormément d’argent au fil du temps.
Il y a ensuite la mise en cache au niveau de la session. Le claude code leak github utilise un ordre déterministe et une correspondance des chemins fondée sur des hachages afin que, si vous posez deux fois la même question, le modèle n’ait pas à retraiter le même contexte. C’est de l’informatique fondamentale appliquée au monde des LLM, et c’est parfaitement exécuté ici.
Ce que j’ai trouvé fascinant dans le claude code leak github, c’est la manière dont l’état est externalisé. Lorsque c’est possible, l’état de la conversation est stocké en dehors du prompt. Cela maintient la fenêtre active propre et évite la « dérive » qui survient lorsqu’une fenêtre de contexte est encombrée par d’anciennes métadonnées.
Maîtriser les coûts des tokens grâce aux modèles du claude code leak github
Le claude code leak github utilise un mécanisme de hachage sophistiqué pour son cache. Chaque fichier de votre projet est haché, et ces hachages servent à déterminer ce qui doit être envoyé à l’API. Si un fichier n’a pas changé, le modèle utilise la version mise en cache lors du tour précédent.
Dans le claude code leak github, ils utilisent également un mécanisme « ToolSearch ». Au lieu de décrire chacun des plus de 40 outils dans chaque prompt, ils appliquent une stratégie de chargement différé. Le modèle appelle d’abord un outil de recherche pour trouver la capacité appropriée, puis charge la description complète de l’outil.
| Fonctionnalité |
Approche standard |
Approche du claude code leak github |
| Chargement des outils |
Tous les outils dans chaque prompt |
Chargement différé via ToolSearch |
| Mise en cache |
Contexte complet renvoyé |
Mise en cache statique/dynamique segmentée |
| Gestion des fichiers |
Transferts de texte brut |
Détection des changements par hachage |
Ce niveau d’optimisation explique pourquoi les outils professionnels semblent tellement plus rapides que les wrappers GPT. En suivant l’exemple du claude code leak github, vous pouvez réduire votre utilisation de tokens jusqu’à 50 % pour les grands projets. Il s’agit d’utiliser intelligemment vos crédits d’API.
Pour mettre cela en œuvre, vous avez besoin d’une plateforme prenant en charge les fonctionnalités avancées des API. Vous pouvez gérer votre facturation d’API plus efficacement si votre système utilise les stratégies de mise en cache du claude code leak github afin de limiter les frais généraux.
Gérer la complexité : les mécanismes Fork et Swarm dans la fuite de Claude Code sur GitHub
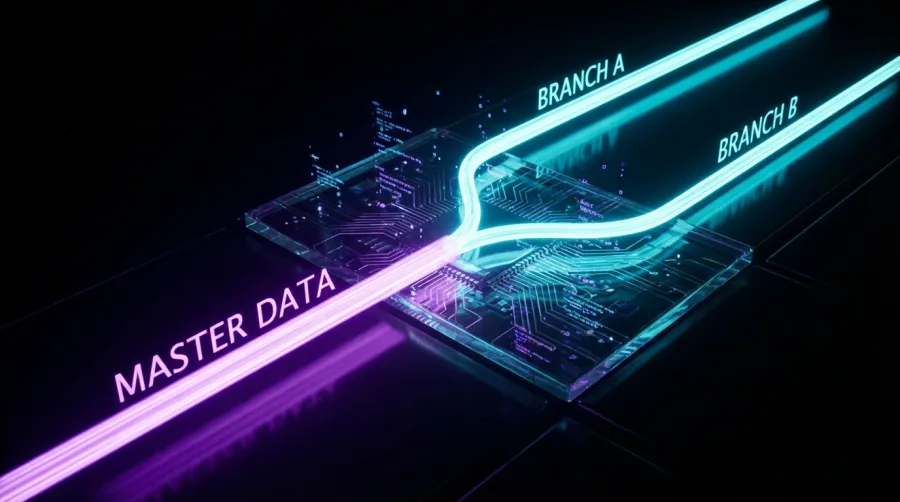
L’un des principaux problèmes des agents IA est la pollution du contexte. Le modèle se laisse distraire par ses propres erreurs précédentes. Le claude code leak github résout ce problème grâce à un mécanisme de « Fork Subagent ». C’est exactement comme créer une branche dans Git, mais pour le « fil de pensée » du modèle.
Lorsque le coordinateur principal doit explorer une idée risquée, il ne le fait pas dans la conversation principale. Le claude code leak github montre qu’il crée un sous-agent. Ce sous-agent hérite du contexte actuel, mais fonctionne dans un bac à sable. Une fois son travail terminé, seule la conclusion finale est fusionnée dans le fil principal.
Cette logique de « Fork » du claude code leak github préserve la propreté du contexte principal. Elle empêche le modèle de rester bloqué dans une boucle du type « Je suis désolé, j’ai fait une erreur ». En isolant la phase d’essais et d’erreurs, le système maintient une qualité de raisonnement élevée pendant toute la session.
Il existe également un mécanisme « Swarm » ou « Teammate » dans le claude code leak github. Il permet au système d’activer plusieurs agents pour travailler simultanément sur différents fichiers. C’est du traitement parallèle appliqué à l’IA, orchestré par un agent « Leader » qui gère les autorisations de l’ensemble du groupe.
Résoudre la pollution du contexte grâce à la logique du claude code leak github
L’architecture du claude code leak github utilise un « Coordinator » qui n’est en réalité pas autorisé à modifier les fichiers. Cela a été un moment de surprise pour moi. Le Coordinator se contente de planifier. Il délègue le travail concret à des sous-agents « Worker ». Cette séparation des responsabilités est un principe classique de l’ingénierie logicielle.
Dans le claude code leak github, si un sous-agent échoue, le Coordinator se contente de supprimer ce « fork » et d’essayer une autre voie. Cela rend le système extrêmement résilient. Il est beaucoup plus difficile pour l’IA de « halluciner » jusqu’à se retrouver dans une impasse lorsque ses échecs sont supprimés de sa mémoire.
Le « forking » d’un sous-agent permet d’explorer sans que le poids d’un échec ne pollue le chemin de raisonnement principal. C’est une idée géniale que l’on retrouve dans le claude code leak github.
La manière dont le claude code leak github gère l’interface des agents parallèles est également ingénieuse. Il utilise des panneaux de terminal pour afficher ce que fait chaque sous-agent. Cela évite le problème du « mur de texte qui défile » et donne à l’utilisateur une vue claire du travail effectué simultanément par l’API.
Si vous souhaitez construire quelque chose d’aussi complexe, vous aurez besoin d’un moyen de suivre vos appels d’API entre plusieurs agents. Le style de développement du claude code leak github peut générer un volume élevé de requêtes ; la surveillance est donc indispensable.
Mémoire et sécurité : les couches secrètes de la fuite de Claude Code sur GitHub
La mémoire est généralement gérée avec des bases de données vectorielles comme Pinecone. Mais le claude code leak github adopte une approche différente. Il utilise un système de mémoire fondé sur des fichiers et centré autour d’un fichier `MEMORY.md`. C’est étonnamment efficace et beaucoup plus facile à déboguer qu’une recherche dans un espace latent.
Le mode « Dream » du claude code leak github est probablement l’« Easter egg » le plus intéressant de la fuite. Lorsque l’outil est inactif, il déclenche une tâche en arrière-plan pour résumer les journaux de la journée. Ce processus de « rêve » transforme les journaux bruts en mémoire structurée à long terme. C’est ainsi que l’assistant reste performant au fil du temps.
La sécurité est également traitée avec une grande rigueur dans le claude code leak github. Le système d’autorisations comporte plusieurs couches. Avant l’exécution de toute commande dangereuse, un petit modèle de « Side-Query » évalue la requête. Si la requête secondaire répond « Deny », le modèle principal est bloqué. C’est une IA qui surveille une autre IA.
Le claude code leak github comprend même un mode « Undercover » destiné aux employés internes. Ce mode oblige le modèle à dissimuler son identité et tous les noms de code internes des modèles. Il montre le degré de contrôle qu’un développeur peut exercer sur la personnalité du modèle lorsque les prompts système sont correctement conçus.
L’architecture de mémoire Dream dans la fuite de Claude Code sur GitHub
L’approche `MEMORY.md` du claude code leak github n’est pas qu’un simple fichier texte ; c’est un index. Il renvoie vers d’autres fichiers consacrés à des sujets précis. Cela crée une structure de mémoire hiérarchique que le modèle peut parcourir efficacement. C’est beaucoup plus « humain » qu’une configuration RAG (Retrieval-Augmented Generation) standard.
Dans le claude code leak github, ce système de mémoire est persistant. Il se trouve dans le dossier `.claude` de votre projet. L’assistant apprend ainsi les particularités de votre base de code et s’en souvient lors des sessions suivantes. L’IA passe du statut d’inconnue à celui de coéquipière qui connaît votre projet sur le bout des doigts.
Mais comment sécuriser ces souvenirs ? Le claude code leak github utilise des interceptions strictes pour les opérations dangereuses. Même si le modèle tente de contourner les règles, le code TypeScript sous-jacent possède une liste d’actions « interdites » qu’aucun prompt ne peut contourner. C’est un modèle fondé sur le principe « faire confiance, mais vérifier ».
Ainsi, la sécurité du claude code leak github est à la fois souple (classification fondée sur un LLM) et stricte (bac à sable au niveau du code). Cette double approche est obligatoire si vous comptez donner à un agent IA un accès au terminal. Vous ne pouvez pas simplement compter sur le fait que le modèle se comportera correctement.
Et maintenant : concevoir l’avenir après la fuite de Claude Code sur GitHub
Le claude code leak github a effectivement mis fin à l’ère des applications « wrapper ». Si votre outil d’IA n’est qu’une jolie interface pour un appel API unique, vous êtes déjà dépassé. Le standard s’est déplacé vers ces systèmes complexes et multi-agents qui comprennent le contexte, les coûts et la sécurité.
La prochaine étape pour les développeurs consiste à mettre en œuvre ces modèles dans leurs propres outils. Utilisez le mécanisme « Fork » pour garder vos prompts propres. Utilisez les modes « Dream » pour créer une mémoire à long terme. Utilisez de petits modèles de requêtes secondaires pour maintenir votre agent principal en sécurité et sur la bonne voie. Le claude code leak github sert de guide.
Nous observons également une intégration plus poussée avec le système d’exploitation hôte. Le claude code leak github ne se contente pas de communiquer avec une API ; il contrôle le terminal, lit le système de fichiers et gère les processus. C’est là que réside la véritable puissance de l’IA — non pas dans l’écriture de poèmes, mais dans l’accomplissement de tâches.
Chez GPT Proto, nous constatons que de nombreux développeurs utilisent notre plateforme unifiée pour créer exactement ce type de systèmes. Comme nous proposons jusqu’à 70 % de réduction sur les API d’IA grand public, vous pouvez vous permettre d’exécuter les modèles « Coordinator » et « Subagent » à haut volume présentés dans le claude code leak github sans vous ruiner.
Créer de meilleurs agents grâce au modèle de la fuite de Claude Code sur GitHub
Pour créer un assistant de niveau « Claude », vous devez avoir accès à plusieurs modèles. Le claude code leak github montre que chaque tâche nécessite des points forts différents. Un modèle rapide et peu coûteux pour les contrôles de sécurité ; un modèle axé sur le raisonnement pour la planification ; et un modèle spécialisé dans le code pour l’implémentation.
Notre API unifiée GPT Proto simplifie cette démarche. Vous n’avez pas à gérer cinq clés d’API différentes. Vous pouvez passer des modèles OpenAI, Google et Claude à l’aide d’une norme d’interface unique. C’est exactement ce dont vous avez besoin pour créer l’architecture « Teammate » présentée dans le claude code leak github.
- Planification intelligente : utilisez nos modes axés sur les performances ou les coûts pour équilibrer le budget de votre agent.
- Accès multimodal : combinez des modèles de texte, de code et de vision dans un même flux de travail.
- Interface unifiée : écrivez votre logique d’orchestration une seule fois et remplacez les modèles selon vos besoins.
Le claude code leak github nous a appris que le « système » est plus important que le « modèle ». Avec GPT Proto, vous pouvez vous concentrer sur la construction de ce système — la mémoire, les forks et la sécurité — tandis que nous prenons en charge la gestion des API et l’optimisation des coûts. Il est temps de construire quelque chose de concret.
Et si la courbe d’apprentissage vous inquiète, il vous suffit de consulter la documentation complète de l’API pour commencer. Vous pouvez mettre en œuvre la mise en cache et la logique de fork du claude code leak github plus rapidement que vous ne le pensez. Le modèle est disponible ; il ne vous reste plus qu’à l’utiliser.
Rédigé par : GPT Proto
« Libérez le potentiel des meilleurs modèles d’IA au monde grâce à la plateforme d’API unifiée de GPT Proto. »