Tarifs API 30 % inférieurs
GPTProto facture l’entrée texte 0,42 $ et la sortie audio 8,40 $ par million de tokens, soit 30 % de moins que les tarifs publiés d’OpenAI de 0,60 $ et 12,00 $.

Chat, agents de codage et travail documentaire. Facturé par million de tokens — l'entrée, l'entrée en cache et la sortie sont facturées séparément. GPTProto est 30 % en dessous des tarifs officiels.
| Scénario | Liste OpenAI | OpenRouter | GPTProto | Économies / mois |
|---|---|---|---|---|
| Personnel10M tokens / mois | $28.80 | $30.38 | $20.16 | −$8.64≈ $103.68 / an |
| Équipe100M tokens / mois | $288.00 | $303.84 | $201.60 | −$86.40≈ $1036.80 / an |
| Entreprise500M tokens / mois | $1440.00 | $1519.20 | $1008.00 | −$432.00≈ $5184.00 / an |
Générez une voix naturelle avec un contrôle en langage courant de l’accent, des émotions, de l’intonation, du rythme, du ton et du chuchotement. L’API GPT-4o-mini-TTS abordable de GPTProto utilise une seule clé API et le même solde de compte que plus de 200 autres modèles d’IA.
Tarifs API 30 % inférieurs
GPTProto facture l’entrée texte 0,42 $ et la sortie audio 8,40 $ par million de tokens, soit 30 % de moins que les tarifs publiés d’OpenAI de 0,60 $ et 12,00 $.
Une interprétation vocale pilotable
Décrivez en langage naturel comment une phrase doit être prononcée. Indiquez l’accent, la palette émotionnelle, l’intonation, le rythme, le ton ou le chuchotement à l’aide du champ d’instructions du modèle.
13 voix intégrées
Choisissez parmi 13 voix documentées, notamment alloy, coral, marin et cedar. OpenAI recommande actuellement marin ou cedar lorsque la qualité de sortie est prioritaire.
Streaming et six formats
Renvoyez un fichier audio aux formats MP3, Opus, AAC, FLAC, WAV ou PCM. Le streaming permet de commencer la lecture avant que le fichier complet soit disponible ; WAV et PCM évitent la surcharge liée au décodage dans les workflows sensibles à la latence.
GPT-4o-mini-TTS est le modèle de synthèse vocale d'OpenAI destiné aux applications qui disposent déjà de texte écrit et qui ont besoin d'un audio parlé contrôlable. Il accepte uniquement du texte et renvoie uniquement de l'audio. Contrairement à un modèle de chat généraliste, il n'est pas conçu pour analyser des images, transcrire des paroles entrantes, conserver un long historique de conversation ou renvoyer une réponse textuelle.
Le principal avantage du modèle par rapport aux anciens flux de travail de synthèse vocale fondés sur des préréglages réside dans son champ instructions. Au lieu de sélectionner uniquement une voix et une vitesse, les développeurs peuvent décrire le rendu souhaité en langage courant : calme ou enthousiaste, conversationnel ou formel, parlé doucement ou énergique, avec des indications sur l'accent, le rythme, l'intonation et l'emphase. L'API OpenAI GPT-4o-mini-TTS est ainsi utile pour la narration, l'intégration des utilisateurs à un produit, les contenus audio accessibles, les dialogues de jeux et les réponses vocales générées à partir du texte produit par une application.
| Spécifications | GPT-4o-mini-TTS |
| Chaîne du modèle | gpt-4o-mini-tts |
| Modalité d'entrée | Texte |
| Modalité de sortie | Audio |
| Entrée maximale | 2,000 tokens d'entrée par requête |
| Voix intégrées | 13 |
| Formats de sortie | MP3, Opus, AAC, FLAC, WAV, PCM |
| Diffusion | Réponse audio complète ou audio en flux continu |
| Vitesse réglable | 0.25 à 4.0 ; valeur par défaut : 1.0 |
| Tarification de GPTProto | $0.42 d'entrée texte / $8.40 de sortie audio par million de tokens |
GPT-4o-mini-TTS documente actuellement les voix intégrées alloy, ash, ballad, coral, echo, fable, nova, onyx, sage, shimmer, verse, marin et cedar. OpenAI recommande d'essayer d'abord marin ou cedar pour obtenir une sortie axée sur la qualité. Les voix peuvent générer de la parole dans plusieurs langues, mais elles sont optimisées pour l'anglais : testez donc les noms, acronymes, nombres et prononciations locales avec de vrais scripts avant la mise en production.
La voix et le format répondent à des besoins différents. La voix détermine le timbre de base ; l'instruction contrôle le rendu ; le format de réponse détermine la façon dont l'audio s'intègre au produit.
| Format | Utilisation idéale |
| MP3 | Lecture générale sur le Web, téléchargements et fichiers compacts |
| Opus | Diffusion sur Internet et applications de communication |
| AAC | Applications mobiles et flux de travail de publication vidéo |
| FLAC | Stockage, édition et archivage sans perte |
| WAV | Lecture à faible latence et édition audio sans décodage audio compressé |
| PCM | Audio brut à 24 kHz, 16 bits, little-endian, pour les pipelines de lecture personnalisés |
Utilisez MP3 comme valeur par défaut pratique. Choisissez Opus lorsque la bande passante est importante, FLAC lorsque le stockage sans perte est prioritaire, et WAV ou PCM lorsque l'absence de surcharge de décodage compte davantage que la taille du fichier.
Un prompt GPT-4o-mini-TTS utile décrit quatre éléments : le rôle du locuteur, l'auditeur, l'intention émotionnelle et le rendu. Conservez le script à prononcer dans le champ input et placez les indications vocales dans le champ instructions. Cette séparation facilite la réutilisation et le test des prompts.
| Application | Exemple de prompt instructions |
| Support client | Parlez calmement et de manière rassurante. Adoptez un ton chaleureux et conversationnel, un rythme modéré et une légère emphase sur l'étape suivante. Ne paraissez pas excessivement enthousiaste. |
| Intégration au produit | Adoptez un ton amical, clair et assuré. Gardez un rythme soutenu, faites une brève pause après chaque action et mettez l'accent sur les noms des boutons sans donner l'impression de faire de la publicité. |
| Narration courte | Utilisez un style documentaire intimiste avec une énergie maîtrisée. Commencez doucement, suscitez la curiosité au milieu, puis ralentissez pour la dernière phrase. |
| Lecture accessible | Lisez clairement à un rythme mesuré. Prononcez distinctement chaque nombre et chaque abréviation, évitez les émotions théâtrales et marquez une pause entre les titres et le corps du texte. |
Modifiez une seule variable à la fois lorsque vous testez une voix de l'API GPT-4o-mini-TTS. Sélectionnez d'abord la voix de base, affinez ensuite le ton et le rythme, puis testez la prononciation. Il est ainsi plus facile de déterminer si un problème vient du choix de la voix, de l'instruction ou du texte source.
Narration et voix off : Transformez des articles, des vidéos de produits, des cours et de courts scripts en audio parlé cohérent.
Guidage dans l'application : Lisez à voix haute les étapes d'intégration, les alertes, les indications de navigation ou les résumés générés.
Sortie d'agent vocal : Transformez la réponse textuelle d'un assistant en parole diffusée en continu. Utilisez plutôt un flux de travail avec l'API Realtime lorsque le produit nécessite une interaction bidirectionnelle complète de parole à parole.
Accessibilité : Ajoutez des versions parlées des messages, documents et contenus de l'interface pour les utilisateurs qui préfèrent ou nécessitent l'audio.
Diffusion multilingue : Générez de la parole à partir de textes dans les langues prises en charge, tout en testant chaque langue cible, car les voix intégrées sont optimisées pour l'anglais.
L'entrée maximale est de 2 000 tokens par requête, et non d'une fenêtre de contexte de 128K. Divisez les contenus longs aux limites des phrases ou des paragraphes. Réutilisez la même voix, la même instruction, la même vitesse et le même format de réponse pour chaque segment, et évitez de couper une phrase, un nombre ou un nom propre entre deux requêtes. Après la génération, écoutez les raccords pour repérer les pauses répétées, les emphases incohérentes ou les changements de prononciation.
Pour une lecture interactive, demandez une diffusion en continu afin que l'application puisse commencer à lire l'audio avant la fin de la génération. Pour une narration préenregistrée, générez des fichiers complets et effectuez un contrôle qualité avant la publication. Dans les deux cas, indiquez clairement aux utilisateurs finaux que la voix est générée par une IA et non par un humain.
Guides, comparaisons et mises à jour liés à ce modèle.
Tous les articles
Comparez les meilleurs outils de synthèse vocale IA pour TikTok et YouTube, notamment les options gratuites, la qualité des voix, les droits commerciaux, les flux de production vidéo et l’automatisation via API.
Comparez les tarifs, la vitesse, les benchmarks et les cas d’utilisation de Gemini 3.6 Flash et Gemini 3.5 Flash-Lite. Découvrez quel nouveau modèle Google convient à votre charge de travail en IA.
Comparez les meilleures API d’IA de synthèse vocale en matière de qualité des voix, d’agents en temps réel, d’audio multilingue, de tarifs, d’offres gratuites, de clonage vocal et d’utilisation en production.
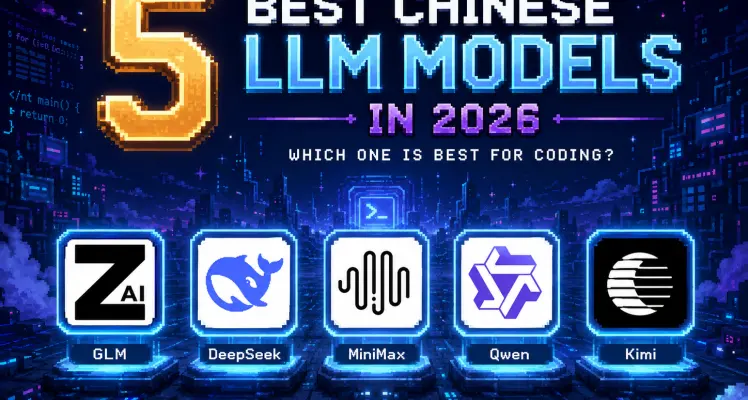
Comparez Kimi K3, GLM 5.2, Qwen3.7 Max, MiniMax M3 et DeepSeek V4 Pro pour le codage, le coût, la vitesse, un contexte de 1 million de tokens et l’accès aux poids ouverts.