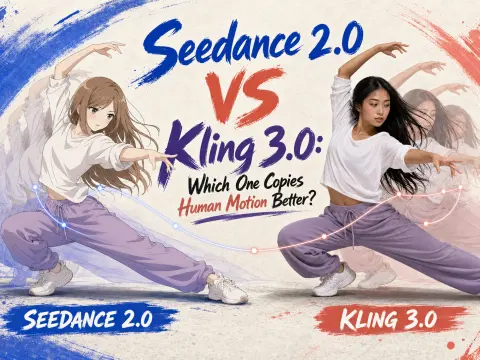
Si vous développez avec des API vidéo, vous avez probablement remarqué que la question « quel modèle gère le mieux les mouvements humains ? » reçoit souvent une réponse évasive — « ça dépend, les deux sont excellents ». Cette réponse ne sert à rien quand vous devez livrer un plan. Voici donc la version plus précise à laquelle je suis arrivé après avoir étudié les notes de version des deux laboratoires et les données indépendantes de l’arène.
En bref. Il n’y a pas de vainqueur unique, car « reproduire les mouvements humains » correspond en réalité à deux tâches différentes, et chaque modèle excelle dans l’une d’elles :
- Si vous voulez générer des mouvements humains crédibles à partir d’un prompt textuel — quelqu’un qui danse, sprinte ou donne un coup de poing, sans que ses membres ne se transforment en spaghetti — choisissez Kling 3.0.
- Si vous voulez reproduire une performance précise à partir d’un clip de référence sur un nouveau personnage ou une nouvelle scène — « faites-les bouger exactement comme ceci » — choisissez Seedance 2.0.
Choisissez le mauvais modèle pour la tâche et vous devrez lutter contre lui du début à la fin. Choisissez le bon et il s’effacera largement de votre chemin. Le reste de cet article présente les éléments qui justifient cette distinction, un tableau comparatif des spécifications, du code d’API exécutable pour les deux modèles et une recommandation selon chaque scénario.
Tout d’abord, démêlons ce que signifie « reproduire un mouvement »
La plupart des comparaisons mélangent deux capacités qui semblent similaires, mais se comportent de manière totalement différente.
La première est la synthèse de mouvements : vous décrivez une action avec des mots et le modèle invente la physique — angles des articulations, transfert du poids, mouvement de suivi. C’est là que la vidéo générée par IA s’est historiquement effondrée. Les actions humaines rapides sont la chose la plus difficile à simuler, car votre œil y est entraîné. Un coude légèrement incorrect paraît immédiatement « faux », même aux non-spécialistes. Quand les gens disent qu’un clip semble « généré par IA », un mouvement humain défaillant en est généralement la cause.
La seconde est le transfert de mouvements : vous fournissez au modèle une référence — une image, un clip, parfois une voix — et lui demandez de transférer ce mouvement ou cette identité exacte dans une nouvelle génération. Ici, le modèle n’invente pas le mouvement ; il le copie et le réadapte. Problème différent, architecture différente, vainqueur différent.
Gardez ces deux notions séparées et toute la comparaison devient plus claire. Kling 3.0 est conçu pour exceller dans la première. Seedance 2.0 est conçu pour exceller dans la seconde. Tout ce qui suit découle de cette distinction.
Comparatif des spécifications
Les deux modèles sont sortis à quelques jours d’intervalle au début de 2026 et sont tous deux réellement performants ; leur fiche technique est donc plus proche que ne le laisse entendre le marketing.
| |
Kling 3.0 |
Seedance 2.0 |
| Laboratoire |
Kuaishou |
ByteDance (Dreamina / Doubao / CapCut) |
| Date de sortie |
5 févr. 2026 (Kuaishou) |
Févr. 2026 ; déploiement CapCut le 26 mars (TechCrunch) |
| Résolution maximale |
4K natif, 3840×2160 (Kuaishou) |
1080p au lancement, 4K ajoutée ultérieurement (BytePlus) |
| Fréquence d’images |
Jusqu’à 60 i/s (Kuaishou) |
Non spécifiée officiellement |
| Durée maximale |
15 s (Kuaishou) |
15 s, six formats d’image (TechCrunch) |
| Plans multiples |
Jusqu’à 6 plans dans un clip, style réalisateur (Kuaishou) |
Création de séquences via plusieurs entrées de référence |
| Audio natif |
Musique, effets sonores et synchronisation labiale dans 5 langues (Kuaishou) |
Dialogue, effets sonores et musique natifs (BytePlus) |
| Entrées de référence |
Texte / image / vidéo / audio (architecture MVL) |
Images + clips vidéo + audio fusionnés en une seule passe (BytePlus) |
| Disponibilité aux États-Unis |
Disponible |
Non disponible aux États-Unis lors du déploiement (examen des droits d’auteur) (TechCrunch) |
Une remarque sur la ligne consacrée à la résolution, avant de lui accorder trop d’importance : la 4K native à 60 i/s de Kling est le chiffre le plus élevé sur le papier, et Kuaishou précise qu’il s’agit d’un rendu natif, pas d’une mise à l’échelle. Mais presque personne ne produisant de courtes vidéos sociales ou publicitaires n’a besoin de 4K/60 — vous payez en temps de rendu et en argent pour des pixels qui seront écrasés par la compression de la plateforme. Considérez la 4K comme un bonus appréciable pour les rares projets de diffusion ou de grand écran, pas comme le critère qui décide de ce duel.
Manche 1 : générer des mouvements humains à partir d’un prompt — Kling 3.0
C’est le terrain de prédilection de Kling, et c’est la raison pour laquelle la question des mouvements humains mérite d’être posée.
Kuaishou a reconstruit Kling 3.0 autour de ce qu’il appelle une architecture « Multi-modal Visual Language » (MVL), qui traite le texte, l’image, l’audio et la vidéo au sein d’un même système plutôt que d’assembler plusieurs outils distincts. L’affirmation qui m’intéresse — et il s’agit d’une affirmation du fournisseur, à évaluer en conséquence — est que le modèle préserve l’anatomie humaine pendant les actions rapides et complexes. Le thème récurrent des évaluations pratiques indépendantes va dans ce sens : les actions complexes comme la danse, la course et les arts martiaux produisent beaucoup moins de membres qui se déforment et de doigts supplémentaires, défauts qui affectent précisément ce scénario.
Mon interprétation, en considérant le consensus des évaluateurs comme une piste plutôt que comme une vérité absolue : si votre prompt est « un danseur effectue une rotation complète et atterrit », Kling est le choix le plus sûr pour obtenir une prise propre dès les premiers essais. Il suit aussi précisément les instructions — mouvements de caméra, éclairage, texte à l’écran — ; votre génération nécessitera donc moins de retouches avant d’être exploitable.
Le prix de ce contrôle ? Kling est plus littéral. Donnez-lui un prompt vague et ambitieux du type « surprends-moi », avec une scène chaotique, et il tend à rester plus proche de l’instruction littérale que de l’ambiance recherchée. Il vous récompense si vous formulez vos prompts comme un réalisateur et pénalise les prompts vagues avec des résultats plats.
Manche 2 : copier un mouvement à partir d’une référence — Seedance 2.0
Changeons maintenant de tâche. Vous ne décrivez pas le mouvement avec des mots ; vous disposez d’un clip contenant exactement le mouvement souhaité et vous devez le transférer.
La fonctionnalité distinctive de Seedance 2.0 est la fusion multimodale de références. ByteDance explique que vous pouvez combiner des images, des vidéos et de l’audio comme références dans une seule génération, avec en plus l’édition in situ et l’extension vidéo. L’article de TechCrunch ajoute le point concret : vous pouvez piloter une génération à partir d’une vidéo de référence, et pas seulement d’une image fixe, tandis que le modèle en restitue les textures, les mouvements et l’éclairage de manière réaliste. En termes simples — si le brief est « reproduis cette performance », c’est l’outil conçu pour cela. Kling peut animer une image, mais n’offre pas le même niveau de « verrouillage de cette référence et respect de celle-ci ». Sur GPT Proto précisément, le mode de génération piloté par référence est documenté comme une capacité exclusive à Seedance — Kling expose des modes pilotés par prompt, mais pas le même chemin de fusion de références.
Cette conception fondée sur les références explique également pourquoi Seedance arrive en tête du classement indépendant. L’arène vidéo d’Artificial Analysis, qui classe les modèles grâce à des votes humains à l’aveugle sur des prompts identiques, place Dreamina Seedance 2.0 en première position pour le texte-vers-vidéo avec audio (Elo d’environ 1 219) et en première position pour l’image-vers-vidéo (environ 1 344) à la mi-2026 — devant Kling 3.0 Pro, autour de 1 105 au classement texte-vers-vidéo avec audio. En matière de qualité de sortie préférée, Seedance est donc mesurablement en avance.
Deux réserves importantes, car ce classement ne raconte pas toute l’histoire. Premièrement, désactivez l’audio et le classement est complètement bouleversé — Seedance tombe autour de la 4e place et Kling de la 5e, derrière d’autres modèles, ce qui indique qu’une partie de l’avance de Seedance vient de la préférence des utilisateurs pour son son intégré, et pas uniquement de ses images. Deuxièmement, et c’est le point essentiel pour les développeurs d’API : Seedance n’était pas disponible aux États-Unis lors de son lancement. ByteDance a suspendu sa distribution plus large en raison de différends liés aux droits d’auteur avec les studios hollywoodiens et a intégré des garde-fous — il ne génère pas de contenu à partir de vrais visages et intègre un filigrane invisible. Si votre produit sert directement des utilisateurs américains sur le web grand public, cette indisponibilité constitue une véritable contrainte de planification, pas une simple note de bas de page.
Manche 3 : émotion et micro-expressions
La version de cette question que l’on me pose le plus souvent concerne en réalité les visages — peut-il produire un sourire crédible qui atteint les yeux, un éclair de doute, un rire sincère ? Je dois ici être transparent sur les éléments disponibles : aucun laboratoire ne publie de benchmark consacré aux « émotions faciales », et Artificial Analysis mesure la préférence globale, pas spécifiquement les micro-expressions. Cette section relève donc du jugement, et je le précise comme tel.
Ce que je peux dire repose sur des éléments concrets. L’avantage de Seedance dans les tests de préférence à l’aveugle apparaît surtout dans les petits comportements humains crédibles — le type de réalisme subtil en gros plan qui porte les plans émotionnels. La force de Kling se situe à l’autre extrémité : les actions physiques amples et en pied restent cohérentes. Pour un gros plan serré où tout le plan repose sur une expression, je commencerais par prototyper avec Seedance. Pour une émotion exprimée par le langage corporel à travers une pièce, la cohérence des mouvements de Kling tend à mieux la transmettre. Si la performance faciale est déterminante pour votre cas d’usage, ne faites confiance ni à l’un ni à l’autre — générez le même plan avec les deux et jugez de vos propres yeux. Les API rendent cette comparaison peu coûteuse, ce qui est précisément l’objet de la section suivante.
Testez les deux vous-même : le code
Les deux modèles sont accessibles depuis un seul endpoint sur GPT Proto, ce qui signifie que vous pouvez tester exactement le même brief en A/B sans jongler entre deux fournisseurs, deux clés ou deux comptes de facturation. La génération vidéo est asynchrone : vous envoyez une requête POST, récupérez un id, puis interrogez le résultat.
Voici Kling 3.0 générant des mouvements humains à partir d’un prompt textuel — son point fort :
import requests, time

BASE = "https://gptproto.com/api/v3"
HEADERS = {"Authorization": "GPTPROTO_API_KEY", "Content-Type": "application/json"}

def generate(path, payload):
    r = requests.post(f"{BASE}/{path}", headers=HEADERS, json=payload)
    r.raise_for_status()
    job = r.json()["data"]
    get_url = job["urls"]["get"]  # e.g. https://gptproto.com/api/v3/predictions/{id}/result

    # poll until the job leaves the queued/running state
    while True:
        res = requests.get(get_url, headers=HEADERS).json()["data"]
        status = res["status"]
        if status in ("succeeded", "failed", "expired"):
            return res
        time.sleep(5)

kling = generate(
    "kling/kling-v3.0-std/text-to-video",
    {
        "prompt": "A martial artist performs a fast spinning kick, "
                  "full body in frame, weight shifting naturally on landing.",
        "aspect_ratio": "16:9",
        "duration": 5,
        "resolution": "1080p",
        "generate_audio": True,
        "seed": -1,
    },
)
print(kling["status"], kling.get("outputs"))
Voici maintenant Seedance 2.0 dans son mode référence-vers-vidéo, qui copie le mouvement d’un clip de référence sur un nouveau personnage — exactement la tâche dans laquelle il excelle. Même fonction auxiliaire, chemin et payload différents :
# reference-to-video: `videos` carries the motion to copy, `images` the character
seedance = generate(
    "bytedance/dreamina-seedance-2-0-260128/reference-to-video",
    {
        "prompt": "The character performs the exact routine from the reference video, "
                  "matching timing and body movement, new studio background.",
        "videos": ["https://your-cdn.com/motion-reference.mp4"],  # motion to replicate
        "images": ["https://your-cdn.com/character.png"],          # up to 10 references
        "aspect_ratio": "9:16",
        "duration": 5,
        "resolution": "1080p",
        "generate_audio": True,
        "seed": -1,
    },
)
print(seedance["status"], seedance.get("outputs"))
Si vous préférez cURL pour un test rapide :
curl --location 'https://gptproto.com/api/v3/kling/kling-v3.0-std/text-to-video' \
  --header 'Authorization: GPTPROTO_API_KEY' \
  --header 'Content-Type: application/json' \
  --data '{
    "prompt": "A dancer completes a full spin and lands cleanly.",
    "aspect_ratio": "16:9",
    "duration": 5,
    "resolution": "1080p"
  }'
Remplacez GPTPROTO_API_KEY par votre véritable clé. Le mode référence-vers-vidéo de Seedance accepte des tableaux — videos, images (jusqu’à 10) et audios — afin que vous puissiez verrouiller un clip de mouvement, un personnage et une voix en un seul appel ; selon la documentation de GPT Proto, ce mode de référence est ici une capacité exclusive à Seedance, ce qui explique concrètement pourquoi il excelle dans la copie de mouvements. Kling couvre la génération à partir d’un prompt grâce à ses modes standard et de contrôle des mouvements. La prise en charge des paramètres varie selon le modèle ; vérifiez donc les champs exacts sur la page de chaque modèle avant un lancement en production. L’essentiel est que la structure de l’endpoint, l’authentification et la boucle d’interrogation sont identiques : tester le même brief sur les deux ne demande qu’une petite modification.
Alors, lequel choisir ?
- Vous générez une action humaine à partir de texte — danse, sport, chorégraphie de combat, toute action rapide et en pied : Kling 3.0. Formulez vos prompts comme un réalisateur et il vous le rendra bien.
- Vous devez copier une performance précise depuis un clip de référence sur un nouveau personnage ou une nouvelle scène : Seedance 2.0. La fusion de références est précisément ce pour quoi il a été conçu, et l’arène de votes à l’aveugle confirme sa qualité de sortie.
- Votre plan repose entièrement sur une expression faciale en gros plan : commencez par Seedance 2.0, mais générez avec les deux et jugez par vous-même — c’est le seul axe que je ne trancherais pas à partir d’une simple fiche technique.
- Vous avez besoin de la 4K/60 pour la diffusion ou le grand écran : Kling 3.0 est aujourd’hui le seul à proposer de la 4K native à 60 i/s.
- Vous diffusez auprès d’utilisateurs américains sur le web ouvert et avez besoin d’une disponibilité garantie : tenez compte du fait que Seedance était limité lors de son lancement pour des raisons de droits d’auteur — y accéder via une plateforme d’API est la voie pratique, à confirmer selon votre cas précis.
Les deux sont actuellement disponibles depuis un seul compte : Kling 3.0 et Seedance 2.0. Consultez la liste complète des modèles vidéo si vous souhaitez également les comparer à Veo ou Hailuo, et la page des tarifs présente les coûts actuels par génération.