Pour obtenir une clé API DeepSeek pour votre application, créez un compte GPTProto, ajoutez du crédit, et générez une clé dans le panneau Démarrage rapide sur la page du modèle DeepSeek Flash. Utilisez deepseek-flash pour votre première requête. La même clé GPTProto vous donne accès aux autres modèles pris en charge, y compris DeepSeek V4 Pro.
Tiffany Layne2026-02-03
Comment obtenir une clé API DeepSeek en 2026
Obtenez une clé API DeepSeek sur GPTProto, exécutez votre première requête avec V4.1 Flash, comparez les prix des jetons et connectez DeepSeek à Codex.
Table des matières
Qu'est-ce que l'API DeepSeek ?
L'API DeepSeek permet à votre application d'envoyer des requêtes aux modèles DeepSeek hébergés et de recevoir des réponses sous forme de code. Vous pouvez l'utiliser pour transformer un rapport de bug en ticket d'incident ou pour ajouter un assistant de codage à votre propre produit. L'API utilise une clé et facture l'utilisation du modèle au jeton. Les développeurs qui utilisent déjà le SDK OpenAI peuvent adapter leur client en utilisant le guide de démarrage rapide de l'API DeepSeek.
DeepSeek a été fondé à Hangzhou en 2023. Son fondateur, Liang Wenfeng, a également fondé le fonds spéculatif quantitatif High-Flyer, qui a soutenu la startup spécialisée dans l'IA. DeepSeek a publié V3, un modèle de langage polyvalent, en décembre 2024. R1 a suivi en janvier 2025. La publication des poids du modèle R1 et l'accent mis sur le raisonnement ont permis à DeepSeek de toucher un public plus large. Lisez la présentation de DeepSeek par le Congressional Research Service et les notes de version de R1 de DeepSeek.
Si vous avez vu R1 dans un tutoriel plus ancien, vérifiez l'ID du modèle avant de copier son code. L'exemple ci-dessous commence avec DeepSeek V4.1 Flash, en utilisant l'ID de modèle deepseek-flash sur GPT Proto. Consultez le guide des ID de modèle DeepSeek Flash si vous migrez une intégration plus ancienne.
Comment obtenir une clé API DeepSeek sur GPT Proto
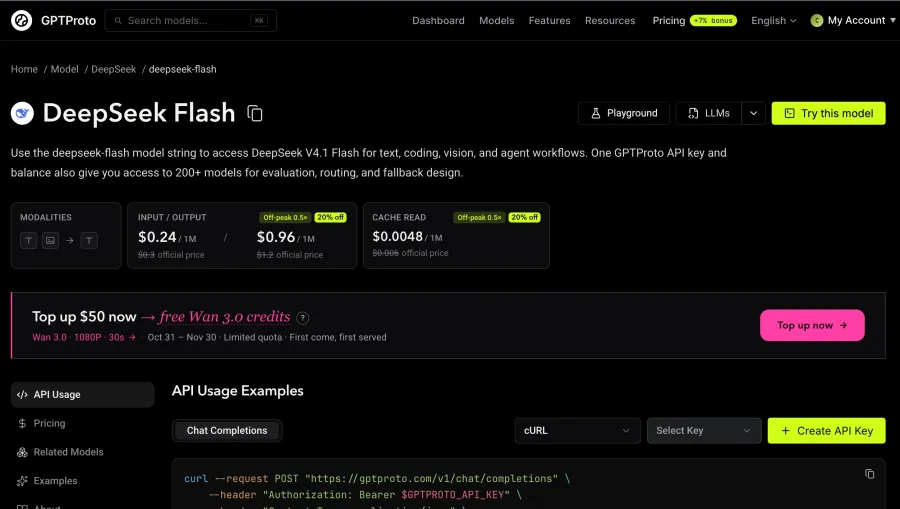
Créez un compte GPT Proto et ajoutez du crédit. Consultez la page du modèle Flash pour connaître les tarifs actuels d'entrée, d'entrée mise en cache et de sortie avant de recharger votre solde.
Ouvrez le démarrage rapide. Sur la page du modèle DeepSeek Flash, cliquez sur Essayer ce modèle pour ouvrir le panneau de configuration. Choisissez Créer une clé API, ou utilisez Sélectionner une clé si vous possédez déjà une clé GPT Proto.
Choisissez comment vous connecter. Pour un projet existant, cliquez sur Copier le Markdown pour l'IA et collez le guide dans votre assistant de codage. Demandez-lui d'ajouter un appel côté serveur en utilisant l'ID du modèle et le point de terminaison indiqués dans le guide. Définissez
GPTPROTO_API_KEYdans votre environnement local ou votre coffre-fort de secrets serveur et gardez la valeur hors de votre code et du chat de l'assistant.
Effectuez votre premier appel à l'API DeepSeek
Une fois que GPTPROTO_API_KEY est défini dans votre terminal, envoyez une courte requête. Cet exemple utilise le point de terminaison Chat Completions présenté dans le Démarrage rapide de DeepSeek Flash.
curl --fail-with-body --silent --show-error \
  https://gptproto.com/v1/chat/completions \
  -H "Authorization: Bearer ${GPTPROTO_API_KEY}" \
  -H 'Content-Type: application/json' \
  --data '{
    "model": "deepseek-flash",
    "messages": [{"role": "user", "content": "Reply with API connected."}]
  }'
Recherchez la réponse dans choices[0].message.content. Si la réponse inclut un objet usage, vérifiez-le avant d'estimer le coût d'une requête plus importante.
Transformez un rapport de bug en ticket
Si vous gérez une petite application SaaS, essayez Flash sur un message de support avant de le connecter à votre outil de suivi des tickets. Remplacez le message de test par ce prompt et cet exemple de rapport.
Transformez ce rapport en un objet JSON avec
summary,reproduction_steps,acceptance_criteriaetmissing_details. Basez les étapes sur le rapport. Placez tous les détails manquants sur l'environnement ou les prérequis dansmissing_details.Exemple de rapport : Sur Safari, j'ai téléchargé un fichier CSV et cliqué sur Importer. L'indicateur de chargement a disparu et la page a affiché zéro ligne importée. Le même fichier a fonctionné dans Chrome.
Vérifiez que le ticket sépare bien les résultats de Safari et de Chrome. Les critères d'acceptation doivent décrire à quoi ressemblerait une importation réussie. La version du navigateur et le contenu du CSV doivent figurer dans missing_details. Si vous automatisez cela, validez le JSON et envoyez le brouillon à un réviseur humain avant de créer le ticket.
Pourquoi utiliser GPT Proto pour l'API DeepSeek ?
Payez 20 % de moins que les tarifs de pointe publiés par DeepSeek pour Flash. Les tarifs affichés par GPT Proto sont de 0,24 $ par million de jetons d'entrée non mis en cache, 0,96 $ par million de jetons de sortie et 0,0048 $ par million de jetons d'entrée mis en cache. Pour une tâche que vous pouvez planifier, vérifiez les tarifs hors pointe applicables avant de décider quand et où l'exécuter. Les tarifs actuels sont disponibles sur la page du modèle DeepSeek Flash.
Conservez une seule clé et un seul solde à mesure que vous testez davantage de modèles. Commencez par Flash pour le tri des tickets. Si les rapports plus complexes nécessitent plus de raisonnement, testez V4 Pro avec les mêmes entrées et les mêmes identifiants GPT Proto. Le catalogue de modèles DeepSeek de GPT Proto répertorie les routes disponibles et leurs prix.
Donnez à votre application une solution de secours que vous pouvez tester. Vous pouvez configurer un second modèle pris en charge dans votre application en cas de délai d'attente ou d'erreurs en amont. Exécutez la même entrée via les deux modèles et vérifiez que les deux réponses répondent aux exigences de votre application avant de vous fier à la solution de secours. Si vous rencontrez un problème de configuration ou de facturation, utilisez le chat de support de la console répertorié dans le guide d'installation de GPT Proto.
Comment connecter DeepSeek à Codex avec une clé API GPT Proto
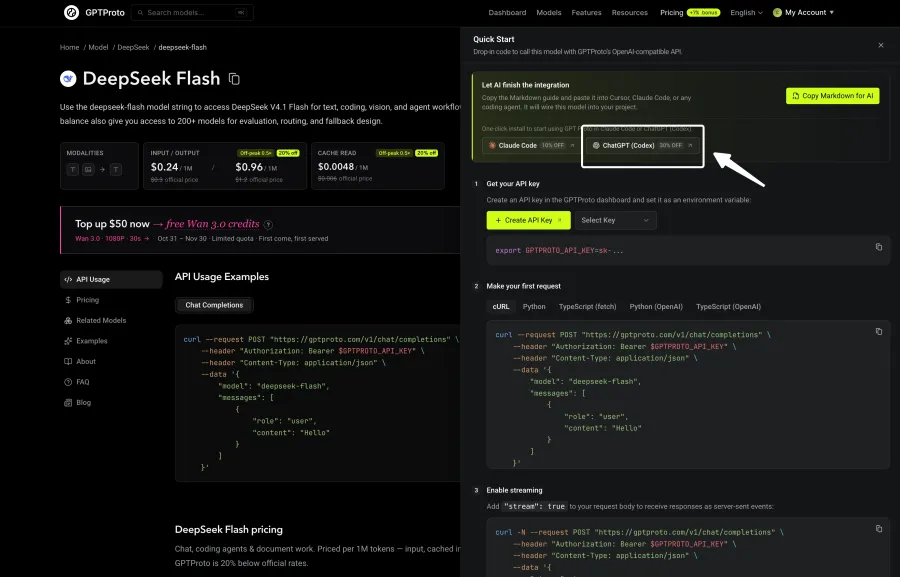
Utilisez l'installateur ChatGPT (Codex) lorsque vous souhaitez configurer Codex avec votre clé GPT Proto. Utilisez Copy Markdown for AI lorsque vous souhaitez que Codex ajoute un appel d'API DeepSeek au code de votre application.
Ouvrez Quick Start sur la page du modèle DeepSeek Flash.
Dans Let AI finish the integration, choisissez ChatGPT (Codex).
Sélectionnez ou créez une clé API GPT Proto, choisissez votre système d'exploitation et suivez les étapes à l'écran dans le guide d'installation GPT Proto.
Ouvrez Codex et confirmez le fournisseur et le modèle actifs. Commencez par une tâche en lecture seule telle que « Explique ce que couvre ce test et suggère un cas manquant ». Si votre flux de travail dépend d'appels d'outils, essayez une seconde tâche qui lit un fichier et utilise son contenu dans une suite.
Une seule réponse confirme la connectivité de base. Si vous prévoyez d'utiliser Codex pour des sessions plus longues, testez également une tâche en plusieurs étapes. Un développeur a signalé une erreur HTTP 400 lors de la continuation d'appels d'outils dans une configuration spécifique de DeepSeek Responses. Ce rapport couvre une configuration directe de DeepSeek et est documenté dans le suivi des problèmes de Codex.
Principaux modèles d'API DeepSeek disponibles sur GPT Proto
Commencez avec DeepSeek V4.1 Flash pour une nouvelle intégration. Évaluez V4 Pro si des tâches textuelles complexes nécessitent régulièrement une seconde analyse, ou V3.2 si vous exécutez un grand volume de tâches textuelles courtes avec des résultats prévisibles. Les autres options sont utiles si vous disposez d'une intégration existante ou si vous souhaitez une base de référence pour vos tests. Les sept modèles sont répertoriés dans le catalogue de modèles DeepSeek de GPT Proto.
| Modèle DeepSeek | ID du modèle GPT Proto | Quand l'essayer |
|---|---|---|
| V4.1 Flash | deepseek-flash |
Le modèle par défaut pour le codage quotidien, le tri de tickets et les tâches combinant texte et captures d'écran. |
| V4 Pro | deepseek-v4-pro |
Tâches textuelles complexes, comme le suivi d'un bug à travers plusieurs fichiers ou la vérification d'un plan technique en plusieurs étapes. |
| V4 Flash | deepseek-v4-flash |
Un point de comparaison pour les flux de travail V4 Flash textuels existants avant de passer à V4.1 Flash. |
| V4 Flash Vision Exp | deepseek-v4-flash-vision-exp |
Une option expérimentale à tester à nouveau si un flux de travail existant basé sur des captures d'écran ou des graphiques en dépend déjà. |
| V3.2 | deepseek-v3.2 |
Une option textuelle à prix réduit à tester pour le marquage en masse, les résumés courts et l'extraction répétitive. |
| V3 | deepseek-v3 |
Une base de référence pour les anciens prompts ou les applications qui dépendent déjà du format de sortie de V3. |
| R1 | deepseek-r1 |
Une base de référence de raisonnement pour un flux de travail mathématique ou logique déjà évalué sur R1. Comparez-le avec Flash et Pro sur les mêmes entrées. |
Il s'agit de routes du catalogue GPT Proto. Sur l'API directe de DeepSeek, les anciens identifiants V4 Flash et Vision Exp redirigent désormais vers V4.1 Flash. Vérifiez l'identifiant dans le démarrage rapide de la page du modèle chaque fois que vous changez de fournisseur ou migrez une intégration existante. Consultez la liste officielle des modèles et le guide des identifiants des modèles DeepSeek Flash.
Comment choisir le bon modèle DeepSeek
Si vos entrées incluent des captures d'écran ou des graphiques, commencez par V4.1 Flash. Dans l'exemple de ticket, envoyez la capture d'écran de l'erreur avec le message de support et vérifiez que la réponse capture bien l'erreur visible. Si vous utilisez déjà Vision Exp, exécutez les deux sur les mêmes images avant de changer.
Si votre entrée est principalement constituée de textes courts et répétitifs, comparez V3.2 avec Flash sur un lot de tickets réels. Vérifiez combien de résultats respectent votre schéma JSON, utilisent les bonnes étiquettes et évitent d'inventer des détails. Comparez le coût par ticket utilisable, en incluant les tentatives répétées.
Si une mauvaise réponse est coûteuse à corriger, essayez Flash sur les cas courants et testez V4 Pro sur les cas que Flash ne traite pas. Pour une correction de code, utilisez les tests réussis et le nombre de tentatives comme critères. Acheminez les cas difficiles vers Pro si cela améliore suffisamment les résultats pour justifier le coût supplémentaire.
Pour changer de modèle dans l'exemple cURL, remplacez la valeur de model par l'ID du modèle GPT Proto ci-dessus. La clé GPT Proto reste la même. Si vous passez de modèles textuels à des modèles capables de traiter des images, assurez-vous que l'entrée de la requête correspond à ce que le nouveau modèle accepte.
Si la vitesse est importante, mesurez le temps d'attente de l'utilisateur pour le premier segment et la durée totale de la tâche. Une génération rapide de jetons peut tout de même laisser un utilisateur en attente lors d'une longue étape de raisonnement. Les deux métriques apparaissent dans les benchmarks indépendants pour l'API directe de DeepSeek.
Pour un petit flux de travail de codage, consultez la comparaison entre DeepSeek Flash et Claude Haiku 5.5. Pour une évaluation plus large, comparez DeepSeek Flash avec Kimi K3 pour les agents de codage ou DeepSeek Flash avec GLM 5.3 Flash pour le code et le coût.
Tarification de l'API DeepSeek par million de jetons
Les tarifs ci-dessous sont exprimés en USD par million de jetons et ont été vérifiés le 4 novembre 2026. Les lignes GPT Proto indiquent les tarifs listés. Pour l'API directe de DeepSeek, les heures de pointe sont de 01h00 à 04h00 et de 06h00 à 10h00 UTC en semaine, hors jours fériés chinois.
| Route | Entrée non mise en cache | Entrée mise en cache | Sortie |
|---|---|---|---|
| GPT Proto DeepSeek Flash | $0.24 | $0.0048 | $0.96 |
| GPT Proto DeepSeek V4 Pro | $1.056 | $0.0352 | $3.168 |
| Flash officiel en heure de pointe | $0.30 | $0.006 | $1.20 |
| Flash officiel hors pointe | $0.15 | $0.003 | $0.60 |
| V4 Pro officiel en heure de pointe | $1.32 | $0.044 | $3.96 |
| V4 Pro officiel hors pointe | $0.66 | $0.022 | $1.98 |
Pour les tarifs actuels, consultez le catalogue GPT Proto DeepSeek et la grille tarifaire officielle de l'API DeepSeek.
Supposons que votre file d'attente de tickets utilise 1 million de jetons d'entrée non mis en cache et 250 000 jetons de sortie. Au tarif GPT Proto Flash indiqué, cela revient à $0.48 en utilisation de modèle. Le même mélange de jetons coûte $0.60 aux tarifs officiels de pointe de DeepSeek ou $0.30 à ses tarifs hors pointe. Il s'agit d'estimations pour ce mélange de jetons. Lors de l'établissement du budget pour un agent, incluez les jetons des tours supplémentaires et des tentatives, ainsi que tous les outils facturés séparément que votre configuration utilise.
Une seule clé pour les agents, le codage et les applications
Propulsez vos agents IA, outils de codage et applications avec un accès abordable aux meilleurs modèles via une seule clé API.
Parcourir les modèles API
Fonctionnalités associées
Toutes les fonctionnalitésGénérateur de vidéos de danse de chat avec IA
Importez une image de chat et une vidéo de danse humaine pour faire danser votre chat avec l'IA. Transférez le mouvement de référence dans une vidéo de chat amusante en ligne avec GPTProto.
IA d'anime à la vie réelle
Téléchargez une œuvre d'art anime, manga, dessin animé ou OC et transformez-la en portrait humain réaliste avec le convertisseur en ligne Anime to Real Life AI de GPTProto.
Modèles associés
Tous les modèles
FAQ sur l'API DeepSeek
L'API DeepSeek est-elle gratuite ?
Vous pouvez créer une clé gratuitement. L'API directe de DeepSeek facture l'utilisation en fonction du solde de votre compte, y compris tout crédit accordé dont vous disposez. L'accès gratuit au chat web de DeepSeek utilise une interface distincte. Consultez les règles de facturation sur la page tarifaire officielle de DeepSeek.
Où puis-je obtenir une clé API DeepSeek officielle ?
Créez-en une dans le tableau de bord des clés API de la plateforme DeepSeek pour un accès direct. Si vous suivez les étapes GPTProto ci-dessus, utilisez la clé GPTProto créée dans le Démarrage rapide et approvisionnez votre solde GPTProto.
Comment acheter un accès à l'API DeepSeek depuis l'étranger ?
Connectez-vous au fournisseur que vous prévoyez d'utiliser et vérifiez quels modes de paiement et devises sont affichés sur la page de recharge de votre compte. Sur GPTProto, ajoutez des fonds à votre solde et utilisez votre clé GPTProto pour les requêtes DeepSeek.
Pourquoi ma clé API DeepSeek ne fonctionne-t-elle pas ?
Une erreur 401 indique un problème d'authentification. Vérifiez que la clé est chargée et qu'elle appartient au fournisseur dans l'URL de votre requête. Une erreur 402 sur l'API directe DeepSeek signifie que vous devez vérifier votre solde. Pour une erreur 429, vérifiez les limites du fournisseur et réduisez les requêtes parallèles avant de réessayer. Consultez les codes d'erreur officiels de l'API DeepSeek pour les erreurs d'API directes.
Articles associés
Plus de blogs
Claude Haiku 5.5 vs DeepSeek V4.1 Flash: Which Is Better for Coding and Agents?
Claude Haiku 5.5 vs DeepSeek V4.1 Flash looks like a simple budget-model comparison until context length changes the answer. On GPTProto, Haiku is cheaper for a typical short request. Once a prompt exceeds 100,000 tokens, Haiku moves to its long-context rate, while DeepSeek Flash keeps the same standard rate. The lower-cost choice can therefore flip with the workload. Capability is just as conditional. Haiku leads several independent reasoning and terminal measures and fits neatly into Claude-based subagent systems. DeepSeek V4.1 Flash offers much longer output, open weights, and notably stronger results on one independent automation benchmark. There is no honest universal winner. Get Haiku 5.5 API
Tiffany Layne | 2026-10-12
DeepSeek Flash vs Kimi K3 : lequel est le meilleur pour le codage et les agents ?
DeepSeek Flash et Kimi K3 prennent des paris presque opposés. DeepSeek Flash privilégie la vitesse, le faible coût en tokens et le raisonnement contrôlable. Kimi K3 dépense davantage de calcul—et bien plus d'argent—pour atteindre un score d'intelligence global plus élevé et de meilleurs résultats dans les tests de préférence frontend. Cela rend la réponse principale simple. Pour le codage à grand volume, la maintenance du dépôt et les agents à forte intensité d'exécution, commencez par DeepSeek Flash. Pour la planification complexe, le travail frontend où le jugement visuel compte, ou les flux de travail nécessitant une entrée vidéo native, Kimi K3 est le meilleur premier test. Si vous pouvez acheminer différentes étapes d'une tâche vers différents modèles, Kimi pour la planification et DeepSeek pour l'exécution est souvent la combinaison la plus judicieuse. Obtenir la clé deepseek-flash Obtenir la clé kimi-k3 Les prix et les positions en direct du classement dans cette comparaison ont été vérifiés le 16 septembre 2026.
Schuyler Stacy | 2026-09-16
DeepSeek V4 Flash, V4.1 Flash et DeepSeek Flash : explication des chaînes de modèles
Statut vérifié : 14 septembre 2026. Vous pouvez envoyer deepseek-v4-flash dans une requête API sans recevoir d’erreur — et pourtant ne pas utiliser le modèle original DeepSeek V4 Flash. C’est la source de la majeure partie de la confusion autour du nommage. DeepSeek V4 Flash, DeepSeek V4.1 Flash et DeepSeek Flash ne décrivent pas trois niveaux de performance actuels. DeepSeek V4 Flash est le prédécesseur retiré. DeepSeek V4.1 Flash est le modèle qui effectue désormais le travail. deepseek-flash est la chaîne de modèle API recommandée par DeepSeek pour l’atteindre. Pour la compatibilité, DeepSeek achemine temporairement les anciens identifiants deepseek-v4-flash et deepseek-v4-flash-vision-exp vers V4.1 Flash également. Sur GPTProto, deepseek-flash , deepseek-v4-flash et deepseek-v4.1-flash pointent actuellement vers le même modèle V4.1 Flash sous-jacent. Cela permet aux anciennes intégrations de continuer à fonctionner, mais cela crée une conséquence moins évidente : la même chaîne de modèle peut produire des résultats à partir d’un modèle plus récent que celui que vous avez testé à l’origine. Essayez DeepSeek Flash sur GPTProto
Michael Johnson | 2026-09-09
DeepSeek Flash vs GLM 5.3 Flash : Lequel est le meilleur pour le codage et les agents ?
DeepSeek Flash est le choix le plus rapide pour le codage interactif, tandis que GLM 5.3 Flash propose des prix standard des tokens plus bas et une légère avance dans les évaluations indépendantes globales. C'est la réponse courte. La réponse la plus utile dépend de la charge de travail. Les mesures indépendantes actuelles placent DeepSeek V4.1 Flash à environ 214 tokens de sortie par seconde, contre 114 tokens par seconde pour GLM 5.3 Flash. GLM, cependant, obtient 42 contre 40 pour DeepSeek sur le même Intelligence Index et coûte légèrement moins par tâche évaluée. La tarification ajoute une autre complication. GLM a les tarifs ordinaires d'entrée et de sortie plus bas, mais l'entrée mise en cache exceptionnellement bon marché de DeepSeek peut le rendre moins coûteux pour les agents à forte utilisation de cache fonctionnant pendant les heures creuses. Il n'y a pas de gagnant universel. Il y a un gagnant clair pour chaque type de travail. Obtenez la clé GLM-5.3 Flash Obtenez la clé Deepseek-Flash
Schuyler Stacy | 2026-09-01