Was ist Hunyuan 4 – oder Hy4 Preview?
Hy4 Preview ist ein großes Sprachmodell mit offenen Gewichten, das vom Tencent Hy Team entwickelt wurde. Es ist vor allem für anspruchsvolle, länger andauernde Produktivitätsaufgaben ausgelegt: Softwareentwicklung, Dokumentenanalyse, Finanzmodellierung, Spieleentwicklung, wissenschaftliche Forschung und Agenten, die planen, Tools aufrufen und Ergebnisse über mehrere Schritte hinweg überprüfen müssen.
Es handelt sich um ein Textmodell. Die umfassendere Hunyuan-Familie von Tencent umfasst zwar auch Bild-, Video- und 3D-Systeme, doch diese Fähigkeiten der gesamten Modellfamilie sollten nicht Hy4 Preview selbst zugeschrieben werden. Der aktuelle Eintrag bei TokenHub unterstützt Texteingabe und Textausgabe sowie Reasoning, strukturierte Ausgaben, Function Calling und Prompt-Caching.
| Spezifikation |
Hy4 Preview |
| Entwickler |
Tencent Hy Team |
| Veröffentlichungsdatum |
28. August 2026 |
| Veröffentlichungsstatus |
Preview |
| Architektur |
Mixture-of-Experts |
| Gesamtzahl der Parameter |
770B |
| Aktive Parameter |
49B pro Token |
| Backbone-Schichten |
78 |
| Kontextfenster |
1M Token |
| Maximale API-Eingabe |
960K Token |
| Maximale API-Ausgabe |
64K Token |
| Eingabemodalität |
Text |
| Ausgabemodalität |
Text |
| API-Modell-ID |
hy4-preview |
| Lizenz |
Apache 2.0 |
| Verfügbarkeit bei GPT Proto |
Demnächst |
Ist Hy4 Preview dasselbe wie Hunyuan-4B?
Nein. Die Namen klingen ähnlich, bezeichnen aber sehr unterschiedliche Modelle.
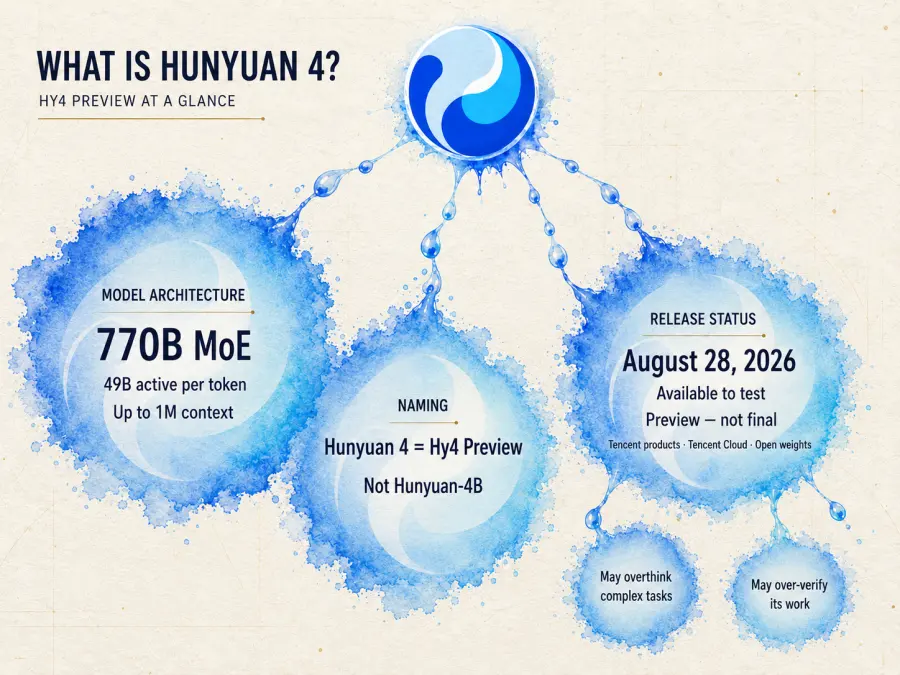
Hunyuan-4B ist ein Modell mit vier Milliarden Parametern aus der früheren Familie dichter Modelle von Tencent. „4B“ bezieht sich auf die Anzahl der Parameter. Hy4 Preview ist das Flaggschiff der nächsten Generation von Tencent mit insgesamt 770 Milliarden Parametern und einer Mixture-of-Experts-Architektur.
Für Suchzwecke ist es nachvollziehbar, „Hunyuan 4“ ohne das Wort „Preview“ zu verwenden. In der technischen Dokumentation sollte jedoch Hy4 Preview stehen, um Verwechslungen zu vermeiden.
Warum heißt es Hy4 „Preview“?
Tencent veröffentlicht Preview-Modelle, bevor die finale Generation fertiggestellt ist, damit das Team Feedback aus echten Programmier-, Recherche- und Produktivitätsabläufen sammeln kann. Hy4 Preview ist also mehr als eine geschlossene Demonstration – die Gewichte, die Dokumentation und die gehostete API sind bereits verfügbar. Das Verhalten des Modells und die Bereitstellungskonfiguration können sich jedoch noch ändern.
Tencent hat noch kein endgültiges Veröffentlichungsdatum für Hy4 angekündigt. In der Ankündigung heißt es lediglich, dass weitere Modelle der Hy4-Serie in Kürze erscheinen sollen. Jeder derzeit im Umlauf befindliche konkrete Monat für die finale Version ist Spekulation.
Die Kennzeichnung als Preview bringt außerdem zwei offengelegte Einschränkungen mit sich:
Bei schwierigen technischen Problemen können diese Verhaltensweisen die Zuverlässigkeit erhöhen. Der Nachteil sind längere Antwortzeiten und möglicherweise mehr Ausgabetoken bei Aufgaben, die ein kleineres oder schnelleres Modell direkt beantworten könnte.
Mein Fazit ist einfach: Hy4 Preview eignet sich für die Evaluierung, nicht für eine unkritische Migration. Ein Team kann es heute parallel zu einem bestehenden Workload testen. Ein vorhandenes Produktionsmodell sollte jedoch erst ersetzt werden, wenn Hy4 die Regressionstests des Teams bestanden hat.
Wie funktioniert Hy4 Preview?
Hy4 Preview ist selbst nach heutigen Standards für offene Modelle sehr groß. Seine 770 Milliarden Parameter kommen jedoch nicht bei jedem Token zum Einsatz.
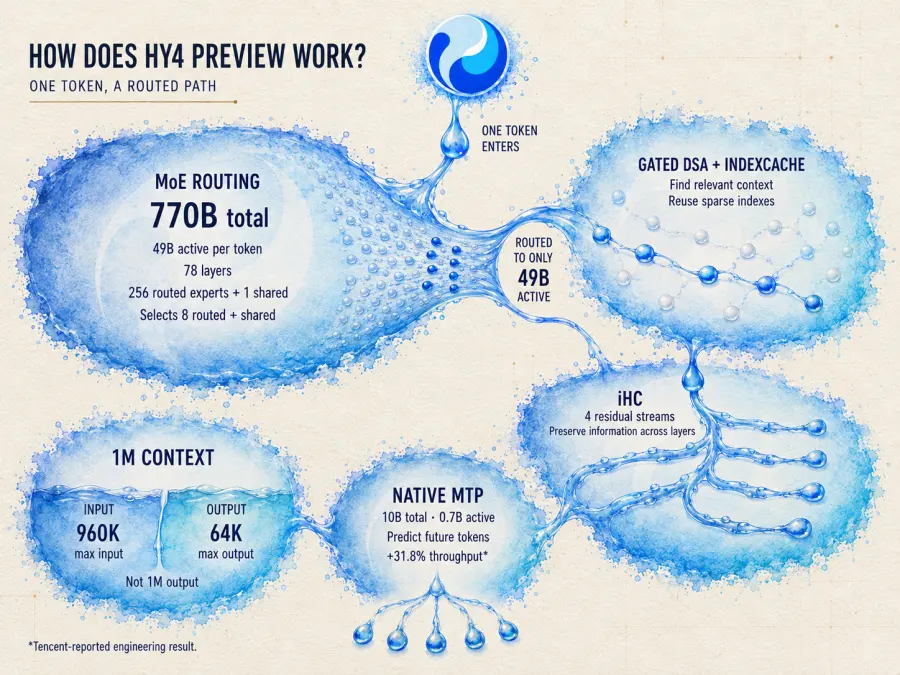
770B Gesamtparameter, 49B aktiv
Das Modell nutzt eine Mixture-of-Experts-Architektur. Man kann sie sich wie eine große technische Organisation vorstellen: Es gibt viele spezialisierte Teams, doch zu jeder Besprechung werden nur die Fachleute hinzugezogen, die für das aktuelle Problem relevant sind.
Hy4 Preview hat ein 78-schichtiges Backbone. Die erste Schicht verwendet ein herkömmliches dichtes Feedforward-Netzwerk, während die übrigen 77 Schichten MoE-Blöcke nutzen. Jeder dieser Blöcke umfasst 256 geroutete Experten und einen gemeinsamen Experten. Für jedes Token wählt das Modell neben dem gemeinsamen Experten acht geroutete Experten aus.
Diese Auswahl verringert den Rechenaufwand pro Token im Vergleich zur Aktivierung aller 770 Milliarden Parameter. Das Modell wird dadurch allerdings nicht klein. Beim Self-Hosting müssen weiterhin alle Gewichte gespeichert, übertragen und verteilt werden.
Gated DSA und IndexCache
Hy4 Preview verwendet Gated DeepSeek Sparse Attention (Gated DSA) mit IndexCache. Anstatt jedes vorherige Token als gleich relevant zu behandeln, versucht Sparse Attention, die Teile eines langen Kontexts zu identifizieren, die für den aktuellen Schritt am wichtigsten sind.
IndexCache verwendet Sparse-Attention-Indizes schichtübergreifend wieder. Damit soll wiederholter Aufwand verringert werden, wenn das Modell sehr lange Dokumente oder Codebasen verarbeitet.
iHC und mehrere Residual-Streams
Das Modell verwendet außerdem Identity Hyper-Connections, kurz iHC. Sein Backbone verwaltet vier Residual-Streams, um die Möglichkeiten zu erweitern, Informationen zwischen den Schichten weiterzugeben.
Für die meisten API-Nutzer ist der Name weniger wichtig als das angestrebte Ergebnis: Das Modell soll Informationen in langen, mehrstufigen Aufgaben bewahren und umwandeln, statt nur kurze, voneinander unabhängige Prompts zu beantworten.
Natives MTP für spekulatives Decoding
Zusätzlich zum Haupt-Backbone enthält Tencent eine native Multi-Token-Prediction-Schicht mit insgesamt 10 Milliarden Parametern, von denen 0,7 Milliarden aktiv sind. Sie kann mehrere zukünftige Token für spekulatives Decoding vorhersagen. Wenn der Bereitstellungs-Stack dies unterstützt, kann sich dadurch der Generierungsdurchsatz verbessern.
Tencent berichtet außerdem, dass Hy4 Preview bei der Analyse und Optimierung von Teilen des eigenen Inferenzsystems geholfen hat. Änderungen an der Operatorfusion und Kommunikation erhöhten den End-to-End-Durchsatz gegenüber der Tencent-Baseline um 31,8 %. Dies ist ein vom Anbieter berichtetes technisches Ergebnis und noch kein unabhängig reproduzierter Bereitstellungs-Benchmark.
Ein Kontextfenster von 1M bedeutet nicht 1M Ausgabetoken
Das angekündigte Kontextfenster umfasst eine Million Token. Für den gehosteten Dienst gelten jedoch genauere Limits:
Maximale Eingabe: 960K Token
Maximale Ausgabe: 64K Token
Gesamtes Kontextfenster: etwa 1M Token
Das reicht für große Repositories, Dokumentensammlungen oder lange Agentenverläufe. Es bedeutet nicht, dass das Modell eine Antwort mit einer Million Token generieren kann. Laut der eigenen TokenHub-Dokumentation von Tencent ist die Ausgabe auf 64K Token begrenzt.
Wichtige Hunyuan-4-Funktionen
Programmierung und Agentenarbeit über lange Zeiträume
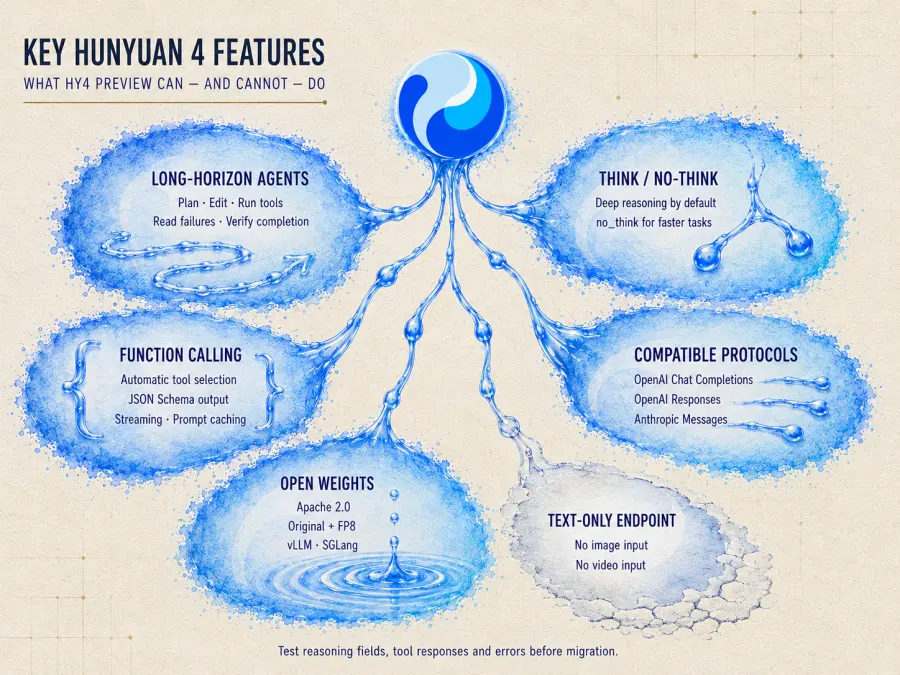
Tencent positioniert Hy4 Preview für Programmieraufgaben, bei denen es um mehr geht als das Generieren einer einzelnen Funktion. Zum vorgesehenen Einsatz gehören das Verstehen eines Repositorys, das Planen von Änderungen, das Bearbeiten von Dateien, das Ausführen von Tools, das Auswerten von Fehlern und das Überprüfen, ob eine Aufgabe tatsächlich abgeschlossen ist.
Das ist ein wichtiger Unterschied. Ein Modell kann bei einzelnen Programmierfragen gut abschneiden und dennoch nach zehn Tool-Aufrufen den Überblick verlieren. Hy4 Preview wird mit Blick auf den gesamten Arbeitsablauf trainiert und evaluiert.
Tencent hat das Modell außerdem gemeinsam mit Produkten wie CodeBuddy und WorkBuddy entwickelt. Dadurch sind die internen Tests praxisnäher als eine Sammlung von Multiple-Choice-Fragen, auch wenn es sich weiterhin um von Tencent durchgeführte Evaluierungen handelt.
Reasoning-Modi „High“ und „No-Think“
Hy4 Preview unterstützt sowohl tiefgehendes Reasoning als auch direkte Antwortmodi. Im offiziellen Bereitstellungsbeispiel ist tiefgehendes Reasoning standardmäßig aktiviert. Es ist für schwierige Programmier-, Mathematik- und Forschungsaufgaben vorgesehen.
Für einfachere Aufgaben können Entwickler das erweiterte Reasoning mit no_think oder dem entsprechenden API-Parameter deaktivieren. Das ist nützlich für:
Tiefgehendes Reasoning bei jeder Anfrage aktiviert zu lassen, kann Zeit und Ausgabetoken verschwenden. Angesichts der bekannten Einschränkungen des Modells ist die Entscheidung, welche Aufgaben so bearbeitet werden, besonders wichtig.
Function Calling und strukturierte Ausgaben
Das gehostete Modell unterstützt Function Calling, automatische Tool-Auswahl und Ausgaben, die durch ein JSON-Schema eingeschränkt werden. Damit eignet sich Hy4 Preview für Agenten, die mit Suchdiensten, Datenbanken, Entwicklungsumgebungen oder internen Diensten interagieren müssen.
Außerdem unterstützt es Streaming und Prompt-Caching. Streaming verkürzt die wahrgenommene Antwortzeit bei langen Generierungen. Die günstigere Bepreisung gecachter Eingaben kann die Kosten senken, wenn dieselben System-Prompts, Repository-Kontexte oder Referenzdokumente wiederholt gesendet werden.
Mit OpenAI- und Anthropic-Protokollen kompatibel
Laut der Dokumentation von Tencent Cloud werden folgende Protokolle unterstützt:
OpenAI Chat Completions
OpenAI Responses
Anthropic Messages
Eine bestehende Anwendung kann Hy4 Preview möglicherweise testen, indem sie die Basis-URL, die Authentifizierung und die Modell-ID ändert, statt die gesamte Anfragestruktur neu zu schreiben.
Das garantiert kein identisches Verhalten. Felder für Reasoning, Antworten auf Tool-Aufrufe, maximale Ausgabelänge und Fehlerbehandlung sollten weiterhin getestet werden, bevor Datenverkehr umgeleitet wird.
Offene Gewichte unter Apache 2.0
Tencent hat sowohl das ursprüngliche Modell als auch eine FP8-Version unter der Apache-2.0-Lizenz veröffentlicht. Entwickler können das Modell untersuchen, mit vLLM oder SGLang bereitstellen, feinabstimmen und quantisierte Versionen erstellen.
Die offiziellen FP8-Rezepte verwenden Tensor-Parallelismus mit achtfacher Aufteilung. Offene Gewichte machen unabhängig von einem einzelnen gehosteten Endpunkt, beseitigen aber nicht den Bedarf an Infrastruktur. Ein 770B-Modell bleibt ein anspruchsvolles Bereitstellungsprojekt.
Unterstützt Hunyuan 4 Bilder oder Videos?
Der aktuelle Hy4-Preview-Endpunkt unterstützt ausschließlich Text.
Das ist eine der deutlichsten Einschränkungen gegenüber neueren multimodalen Programmiermodellen. Über den dokumentierten Endpunkt kann das Modell weder direkt einen Screenshot untersuchen noch ein UI-Mock-up lesen oder ein Video analysieren.
Bei textbasierten Repository- oder Dokumenten-Workflows ist das möglicherweise unerheblich. Bei einem Frontend-Agenten, der visuelle Ausgaben untersuchen muss, kann diese Einschränkung die Modellauswahl bereits vor einem Vergleich der Benchmark-Ergebnisse entscheiden.
Preise und Verfügbarkeit von Hunyuan 4
Die offiziellen internationalen Preise von Tencent sind:
| Tokentyp |
Preis für Hy4 Preview |
| Eingabe |
$0.834 pro 1M Token |
| Ausgabe |
$2.501 pro 1M Token |
| Gecachte Eingabe |
$0.042 pro 1M Token |
Gecachte Eingaben kosten etwa 5 % des Standardpreises für Eingaben. Das kann die Kosten eines Agenten deutlich verändern, wenn dieser wiederholt dieselben Projektanweisungen oder Dokumente liest.
Hy4 Preview ist derzeit über Tencent Cloud TokenHub sowie über Tencent-Produkte wie WorkBuddy, CodeBuddy, Yuanbao und ima verfügbar. Tencent bot außerdem während eines zweiwöchigen Einführungszeitraums einen Testzugang über WorkBuddy und CodeBuddy an. Da es sich um eine zeitlich begrenzte Aktion handelt, sollte sie nicht als dauerhaft kostenloses Modellangebot verstanden werden.
Ist Self-Hosting günstiger?
Bei dauerhaft hohem Volumen möglicherweise. Aber nicht automatisch.
Die ursprünglichen Gewichte sind so groß, dass sie spezialisierte Infrastruktur erfordern. In den offiziellen FP8-Bereitstellungsbeispielen wird das Modell auf acht GPUs verteilt. Self-Hosting verursacht außerdem Aufwand für Entwicklung, Überwachung, Upgrades, Speicher, Netzwerke und ungenutzte Kapazitäten.
AngelSlim hat ein quantisiertes 229-GB-STQ1-GGUF sowie eine 467-GB-Q4-Version veröffentlicht. Der kleinere Download macht lokale Experimente realistischer. Community-Mitglieder haben jedoch zu Recht hinterfragt, ob sich die durchschnittliche Benchmark-Leistung auch auf Programmieraufgaben mit langem Kontext und wiederholte Tool-Aufrufe übertragen lässt. Kleine Fehler können sich über einen langen Agentenlauf hinweg summieren, selbst wenn kurze Tests stabil bleiben.
Für viele Teams ist es einfacher, den gehosteten Tokenpreis zu bewerten als die Wirtschaftlichkeit einer Bereitstellung mit acht GPUs.
Hunyuan-4-Benchmarks: Wie leistungsfähig ist Hy4 Preview?
Hy4 Preview verfügt über einen umfangreichen Benchmark-Anhang. Fast alle Zahlen vom Veröffentlichungstag stammen jedoch von Tencent. Das macht sie nicht nutzlos, aber sie sollten korrekt gekennzeichnet werden.
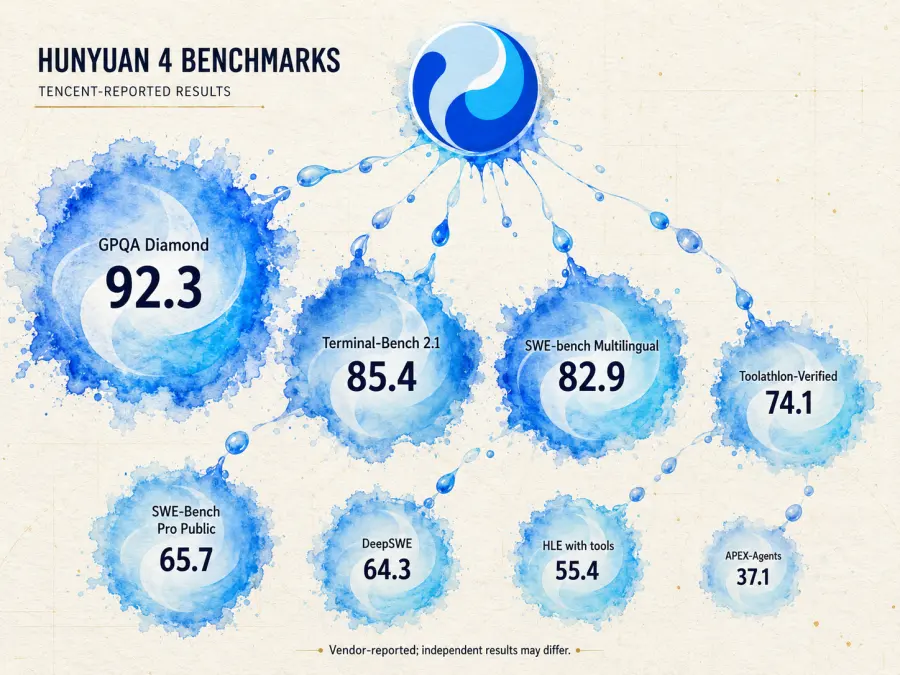
Zu den von Tencent gemeldeten Ergebnissen gehören:
| Benchmark |
Hy4 Preview |
Status der Belege |
| GPQA Diamond |
92.3 |
Vom Anbieter gemeldet |
| Terminal-Bench 2.1 |
85.4 |
Vom Anbieter gemeldet |
| SWE-bench Multilingual |
82.9 |
Vom Anbieter gemeldet |
| Toolathlon-Verified |
74.1 |
Vom Anbieter gemeldet |
| SWE-Bench Pro Public |
65.7 |
Vom Anbieter gemeldet |
| DeepSWE |
64.3 |
Vom Anbieter gemeldet |
| HLE mit Tools |
55.4 |
Vom Anbieter gemeldet |
| APEX-Agents |
37.1 |
Vom Anbieter gemeldet |
Diese Ergebnisse legen nahe, dass Programmierung, Tool-Nutzung und wissenschaftliches Reasoning zentrale Bestandteile des Trainings sind. Sie beweisen nicht, dass dieselbe Rangfolge auch mit einem anderen Agenten-Framework, Tool-Budget oder Bereitstellungskonfiguration gilt.
[Bildplatzhalter: Ausgewählte Hy4-Preview-Benchmarks, aufgeteilt nach vom Anbieter gemeldeten und externen Belegen]
Tencents interner Blindtest mit 203 Aufgaben
Tencent bat außerdem 163 interne Experten, die Modellausgaben für 203 technische Aufgaben zu bewerten.
| Modell |
Durchschnittliche Bewertung |
| Hy4 Preview |
2.99 / 4 |
| Kimi K3 |
2.94 / 4 |
| GLM‑5.3 |
2.92 / 4 |
Im Vergleich mit GLM‑5.3 erzielte Hy4 Preview 46,8 % Siege, 12,8 % Unentschieden und 40,4 % Niederlagen. Gegen Kimi K3 waren es 51,2 % Siege, 7,9 % Unentschieden und 40,9 % Niederlagen.
Das ist ein knapper Vorsprung in Tencents eigener Produktivitätsumgebung – kein Beleg dafür, dass Hy4 Preview generell besser ist.
Außerdem gilt es, eine leicht mögliche Namensverwechslung zu vermeiden: Tencent verglich Hy4 Preview mit GLM‑5.3 und Kimi K3. In diesem Blindtest wurde es nicht mit GLM‑5.3 Flash oder MiniMax M3 verglichen.
Frühe Ergebnisse von Arena WebDev
In Arenas frühem WebDev AutoEval erzielte GLM‑5.3 Flash 1.634 Punkte und Hy4 Preview 1.633. Ein Punkt Unterschied ist zu diesem Zeitpunkt praktisch ein Gleichstand.
Beide Werte wurden mit AutoEval ermittelt. Dabei gibt ein anhand menschlicher Präferenzen trainiertes Belohnungsmodell die Stimmen ab. Es lagen noch nicht genügend echte menschliche Stimmen für eine stabile öffentliche Rangliste vor. Die sinnvolle Schlussfolgerung ist, dass Hy4 Preview bei der Frontend-Generierung konkurrenzfähig wirkt – nicht, dass es eindeutig gewonnen oder verloren hat.
Was sagen erste Nutzer über Hy4 Preview?
Die ersten Reaktionen der Community fallen zurückhaltender aus als manche Schlagzeilen zum Start.
In einem viel diskutierten LocalLLaMA-Thread wurde Hy4 Preview im Allgemeinen auf dem Niveau von GLM‑5.3 eingeordnet. Nutzer bemerkten die deutliche Verbesserung gegenüber Hy3, stellten aber infrage, ob Tencents eigene Grafik eine umfassende Behauptung wie „schlägt GLM und Kimi“ stützt. Außerdem thematisierten sie, wie schwierig es ist, Gewichte für ein 770B-Modell außerhalb eines Rechenzentrums zu betreiben.
Diese Reaktion ist nachvollziehbar. Hy4 Preview wirkt wie ein ernst zu nehmendes offenes Modell, doch die weitreichendsten Behauptungen hängen weiterhin von Tencents eigener Testumgebung ab.
Ein kleiner FlappyBench-Vergleich
In einem Community-Test wurden Hy4 Preview, Kimi K3 und GLM‑5.3 bei einer Designaufgabe im Stil von Flappy Bird verglichen:
| Modell |
Angegebene Kosten des Durchlaufs |
Beobachtung des Testers |
| Hy4 Preview |
$0.0480 |
Am eigenständigsten gestaltete Benutzeroberfläche und Spielmechanik |
| Kimi K3 |
$0.0740 |
Anspruchsvollste Spielmechanik |
| GLM‑5.3 |
$0.0184 |
Flüssige Spielmechanik und niedrigste Kosten |
Kommentatoren widersprachen der ursprünglichen Interpretation. Einige bevorzugten Kimi K3, weil die anspruchsvollere Spielmechanik näher am Originalspiel lag. Ein anderer merkte an, dass der Prompt nicht detailliert genug angegeben wurde, um den Vergleich beurteilen zu können.
Diese Meinungsverschiedenheit ist aufschlussreich. Sie zeigt, warum das „beste Frontend-Ergebnis“ von den Bewertungskriterien abhängt. Visuelle Eigenständigkeit, Vorlagentreue, Schwierigkeitsgrad und Kosten sind unterschiedliche Maßstäbe. Ein gemeinsamer Prompt kann nicht alle vier abschließend beurteilen.
Hunyuan 4 im Vergleich zu GLM‑5.3 Flash, MiniMax M3 und DeepSeek V4 Pro
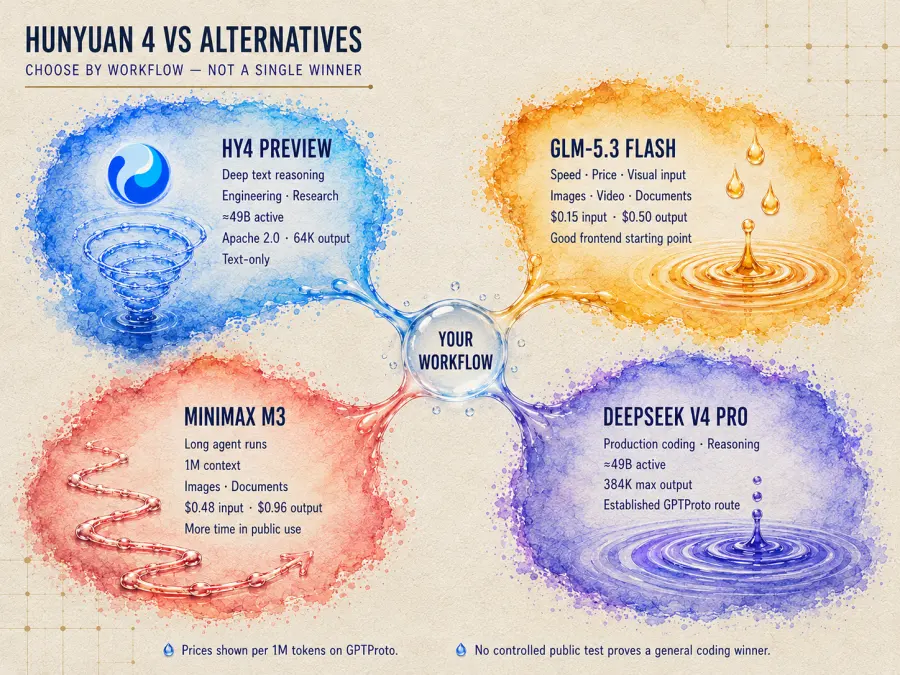
Hy4 Preview tritt in einem dicht besetzten Feld chinesischer Modelle an, die für Programmierung, Agenten und Workloads mit Millionen Token ausgelegt sind.
| Entscheidungsfaktor |
Hy4 Preview |
GLM‑5.3 Flash |
MiniMax M3 |
DeepSeek V4 Pro |
| Veröffentlichungsphase |
Preview |
Veröffentlicht |
Veröffentlicht |
Veröffentlicht |
| Kontextfenster |
1M |
1M |
1M |
1M |
| Dokumentierte maximale Ausgabe |
64K |
Abhängig von der Route |
Bis zu etwa 512K |
384K |
| GPT Proto-Eingabe |
Noch nicht verfügbar |
Text, Bild, Video, Dokument |
Text, Bild, Dokument |
Text |
| Hauptstärke |
Anspruchsvolle textbasierte Agenten und Recherche |
Schnelle multimodale Programmierung |
Lange multimodale Agentenläufe |
Programmierung und MINT-Reasoning |
| Offene Lizenz |
Apache 2.0 |
MIT |
MiniMax Community |
MIT |
| GPT Proto-Eingabepreis |
Demnächst |
$0.15/1M |
$0.48/1M |
Live-Modellseite ansehen |
| GPT Proto-Ausgabepreis |
Demnächst |
$0.50/1M |
$0.96/1M |
Live-Modellseite ansehen |
Die GPT Proto-Preise in dieser Tabelle beziehen sich auf die verfügbaren GPT Proto-Routen. Der zuvor genannte Preis für Hy4 ist dagegen der offizielle Tarif von Tencent. Live-Preise können sich ändern und sollten vor der Bereitstellung auf der jeweiligen Modellseite überprüft werden.
Hunyuan 4 im Vergleich zu GLM‑5.3 Flash
Hy4 Preview ist die interessantere Option für schwierige technische oder Forschungsaufgaben, die ausschließlich Text erfordern und bei denen ein Team bereit ist, für tiefergehendes Reasoning längere Antwortzeiten in Kauf zu nehmen.
GLM‑5.3 Flash ist die praktischere Wahl, wenn Preis, Antwortgeschwindigkeit oder visuelle Eingaben wichtig sind. Die GPT Proto-Route akzeptiert Bilder, Videos und Dokumente, während Hy4 Preview derzeit nur Text verarbeitet. Außerdem kostet GLM‑5.3 Flash bei GPT Proto 0,15 $ pro Million Eingabetoken und 0,50 $ pro Million Ausgabetoken – deutlich weniger als der aktuelle offizielle Preis von Hy4.
Die ersten Arena-WebDev-Werte liegen fast gleichauf. Für Frontend-Programmierung würde ich mit GLM‑5.3 Flash beginnen, da es visuelle Referenzen untersuchen kann und günstiger ist. Anschließend würde ich Hy4 bei den schwierigsten textbasierten Planungs- und Debugging-Aufgaben testen.
Hunyuan 4 im Vergleich zu MiniMax M3
MiniMax M3 ist ein weiteres MoE-Modell mit einem Kontextfenster von einer Million Token, das für lange Agentenläufe entwickelt wurde. Bei GPT Proto kostet es 0,48 $ pro Million Eingabetoken und 0,96 $ pro Million Ausgabetoken. Über seine multimodale Route sind Bild- und Dokumenteingaben verfügbar.
Hy4 Preview bietet eine Apache-2.0-Lizenz und starke erste Ergebnisse bei Benchmarks zur Tool-Nutzung und Softwareentwicklung. MiniMax M3 ist bei GPT Proto günstiger, bietet eine längere dokumentierte Ausgabelänge und wird bereits länger öffentlich genutzt.
Für einen neuen textbasierten Rechercheagenten lohnt es sich, Hy4 in die Evaluierung aufzunehmen. Für einen kostenempfindlichen Produktions-Workflow oder einen Agenten, der Bilder und Dateien untersuchen muss, lässt sich MiniMax M3 derzeit leichter rechtfertigen.
Hunyuan 4 im Vergleich zu DeepSeek V4 Pro
DeepSeek V4 Pro und Hy4 Preview aktivieren pro Token jeweils ungefähr 49 Milliarden Parameter und sind auf schwierige Programmier- und Reasoning-Aufgaben ausgerichtet. DeepSeek V4 Pro hat mehr Gesamtparameter und eine dokumentierte maximale Ausgabelänge von 384K Token, verglichen mit 64K bei Hy4 Preview.
Hy4 bietet Gewichte unter Apache 2.0 sowie eine Integration mit WorkBuddy und CodeBuddy von Tencent. DeepSeek V4 Pro verfügt bereits über eine etablierte GPT Proto-Route und ist besser für Teams geeignet, die jetzt einen Produktionsendpunkt benötigen.
Es gibt keinen ausreichend kontrollierten öffentlichen direkten Vergleich, der einen allgemeinen Sieger für Programmieraufgaben belegt. Testen Sie die Bearbeitung von Repositories, den Umgang mit Fehlern und die Gesamtkosten anhand desselben Workloads.
Wofür lässt sich Hunyuan 4 einsetzen?
Hy4 Preview eignet sich besonders für Aufgaben, die anspruchsvoll genug sind, um den längeren Reasoning-Prozess zu rechtfertigen.
Programmierung auf Repository-Ebene
Ein Entwicklungsagent kann das große Kontextfenster nutzen, um Projektdokumentation, Quelldateien, fehlgeschlagene Tests und frühere Änderungen in einer Arbeitssitzung zu lesen. Aussagekräftiger als die Frage, ob das Modell eine Funktion korrekt schreibt, ist der Test, ob es den Projektzustand nach wiederholten Änderungen im Blick behält.
Analyse langer Dokumente und Finanzanalysen
Tencent hat das Modell auf Büro- und Analyse-Workflows mit Dokumenten, Tabellenkalkulationen, Gleichungen und Finanzmodellen ausgerichtet trainiert. Durch sein Kontextfenster von einer Million Token eignet es sich für große Sammlungen textlastiger Materialien.
Bei vertraulichen oder regulierten Daten müssen die Richtlinien des gewählten Hosting-Anbieters zu Aufbewahrung, Standort und Zugriff gesondert geprüft werden.
Rechercheagenten mit Tool-Nutzung
Hy4 Preview unterstützt Function Calling und erweitertes Reasoning. Dadurch kann es suchen, Experimente ausführen, Ergebnisse untersuchen und Vorgehensweisen überarbeiten. Tencent berichtet, das Modell für KI-Forschung, Molekulardynamik, Festkörperphysik und Mathematik einzusetzen.
Bei diesen Aufgaben ist die Varianz hoch. Eine Überprüfung durch Menschen bleibt notwendig, insbesondere wenn das Modell wissenschaftliche Aussagen generiert oder Versuchsergebnisse interpretiert.
Spiele-Prototyping
Tencent zeigt, wie Hy4 Preview gemeinsam mit Game-Engines spielbare Prototypen erstellt und überarbeitet. Das ist ein guter Test für Agenten, da er Code, Interaktionslogik, Zustandsverwaltung und Debugging verbindet.
Eine spielbare Demo ist kein produktionsreifes Spiel. Lizenzierung von Assets, Leistung, Plattformkompatibilität und eine saubere Projektübergabe müssen weiterhin gesondert geprüft werden.
Workloads, für die ein anderes Modell besser geeignet ist
Hy4 Preview sollte nicht die Standardwahl sein, wenn:
der Agent Screenshots, Bilder oder Videos untersuchen muss.
es um eine kurze Klassifizierungs- oder Extraktionsanfrage geht.
eine niedrige Latenz wichtiger ist als tiefgehendes Reasoning.
das Team Verhaltensänderungen während der Preview-Phase nicht tolerieren kann.
die lokale Hardware ein sehr großes Modell nicht unterstützt.
dem Produktionssystem eine modellspezifische Regressionstestsuite fehlt.
Lohnt sich Hunyuan 4 bereits?
Hy4 Preview ist einen Test wert, aber es ist noch zu früh, um es automatisch als Ersatz für GLM‑5.3 Flash, MiniMax M3 oder DeepSeek V4 Pro zu betrachten.
Am überzeugendsten ist das Modell für Teams, die offene Modelle mit Gewichten für textbasierte Agenten evaluieren, die mit großen Codebasen, Forschungsmaterialien oder komplexen Tool-Workflows arbeiten. Die Apache-2.0-Lizenz, das Kontextfenster von einer Million Token und die ersten Ergebnisse bei technischen Aufgaben sind klare Vorteile.
Auch die Nachteile sind erheblich. Es handelt sich um ein großes Modell, der aktuelle gehostete Preis liegt über dem mehrerer schneller chinesischer Alternativen, die Ausgabe ist auf 64K Token begrenzt, und Tencent hat bereits übermäßiges Reasoning und zu häufige Überprüfungen eingeräumt.
Nutzen Sie es jetzt, wenn Sie über eigene Evaluierungstests verfügen und es parallel zu einem bestehenden Produktionsmodell betreiben können. Warten Sie, wenn Sie stabile Antwortzeiten, multimodale Eingaben oder ein Modell benötigen, das bereits monatelang unabhängig getestet wurde.
Hy4 Preview kommt zu GPT Proto. In der Zwischenzeit können Entwickler GLM‑5.3 Flash, MiniMax M3 und DeepSeek V4 Pro über ein Konto und ein gemeinsames Guthaben vergleichen.