MiniMax M3 vs. DeepSeek V4 Flash: Kurzfazit
DeepSeek V4 Flash ist für die meisten Entwickler, die ausschließlich mit Text arbeiten, die bessere Standardwahl. Die Version mit maximalem Reasoning liegt im unabhängigen Intelligence Index vorn, generiert etwas schneller, steht unter einer MIT-Lizenz und bietet günstige Cache-Lesezugriffe – praktisch, wenn Agents Repository-Kontext und Tool-Schemas wiederholt senden.
MiniMax M3 ist vielseitiger. Das Modell kann Bilder und Videos verarbeiten, unterstützt eine höhere maximale Ausgabelänge und kostet derzeit bei GPT Proto weniger pro Ausgabetoken. Es eignet sich für Screenshot-zu-Code, visuelles Debugging und umfangreiche Ausgaben.
| Dein Anwendungsfall |
Empfohlenes Modell |
| Textbasiertes Coding |
DeepSeek V4 Flash |
| Repository-Agents mit wiederholtem Kontext |
DeepSeek V4 Flash |
| Screenshot-zu-Code |
MiniMax M3 |
| Visuelles Frontend-Debugging |
MiniMax M3 |
| Ausgabelastige Aufrufe während der DeepSeek-Spitzenzeiten |
MiniMax M3 |
| Geplante Batch-Jobs außerhalb der Spitzenzeiten |
DeepSeek V4 Flash |
| Kommerzielles Self-Hosting |
DeepSeek V4 Flash |
| Native Bild- und Videoeingabe |
MiniMax M3 |
Bei risikoreichem Code sollte keines der beiden Modelle allein aufgrund seiner Position auf einer Rangliste ausgewählt werden. Änderungen an der Authentifizierung, Datenbankmigrationen, Infrastrukturarbeiten und Refactorings über mehrere Services hinweg erfordern Tests, statische Prüfungen oder eine separate Überprüfung. Die Kosten für die Behebung einer fehlerhaften Änderung können höher sein als die Token-Ersparnis durch Dutzende erfolgreicher Aufrufe.
MiniMax M3 auf GPT Proto testen oder DeepSeek V4 Flash auf GPT Proto testen.
MiniMax M3 vs. DeepSeek V4 Flash auf einen Blick
Die folgende Tabelle bezieht sich auf die aktuellen gehosteten Versionen und GPT Proto-Preise mit Stand vom 28. August 2026. Preise und gehostete Limits können sich ändern. Daher sollten vor dem Deployment die aktuellen Modellseiten als maßgebliche Referenz dienen.
| Spezifikation |
MiniMax M3 |
DeepSeek V4 Flash 0731 |
| Veröffentlichung |
1. Juni 2026 |
API-Update vom 31. Juli 2026 |
| Architektur |
428B gesamt / 23B aktiv |
284B gesamt / 13B aktiv |
| Kontextfenster |
1.048.576 Tokens; mindestens 512K garantiert |
1.048.576 kombinierte Tokens |
| Maximale Ausgabe |
Etwa 512K Tokens |
Bis zu 384K Tokens |
| Native Eingabe |
Text, Bild und Video |
Text |
| Ausgabe |
Text |
Text |
| Reasoning-Steuerung |
Aktiviert, adaptiv oder deaktiviert |
Ohne Reasoning, niedrig, hoch oder maximal |
| Tool-Aufrufe |
Ja |
Ja |
| GPT Proto-Preis für neue Eingabetokens |
0,48 USD/1 Mio. Tokens |
0,44 USD/1 Mio. Tokens zu Spitzenzeiten |
| GPT Proto-Preis für Ausgabetokens |
0,96 USD/1 Mio. Tokens |
1,32 USD/1 Mio. Tokens zu Spitzenzeiten |
| GPT Proto-Cache-Preis |
0,10 USD für Schreib- / 0,10 USD für Lesezugriffe pro 1 Mio. |
0,014 USD pro 1 Mio. Lesezugriffe zu Spitzenzeiten |
| Lizenz |
MiniMax Community License |
MIT |
| Am besten geeignet für |
Multimodale und visuelle Workflows |
Textbasiertes Coding und wiederholte Agent-Schleifen |
MiniMax ist von Haus aus multimodal, aber GPT Proto trennt Textaufrufe von der Bild-zu-Text-Route. Standardmäßig verarbeitet DeepSeek V4 Flash Text zu Text; deepseek-v4-flash-vision-exp ist ein separates experimentelles Modell.
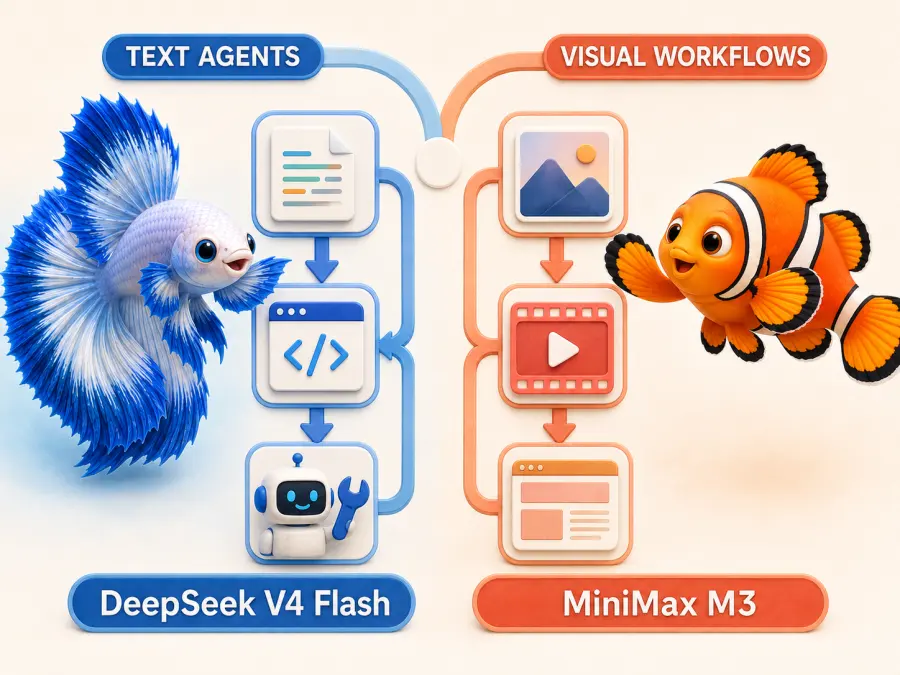
Die Modelle verfolgen unterschiedliche Designziele. MiniMax hat M3 rund um MiniMax Sparse Attention und das native Training mit Text, Bildern und Videos entwickelt. DeepSeek hat die kleinere V4-Flash-Variante für effiziente Textinferenz entwickelt und anschließend mit dem Post-Training-Update 0731 Agents verbessert und native Unterstützung für die Responses API hinzugefügt. MiniMax bietet vielfältigere Eingaben; DeepSeek eine stärker auf Text ausgerichtete, engere Einsatzmöglichkeit mit günstigeren Cache-Lesezugriffen und einer MIT-Lizenz.
Benchmark-Vergleich: Der Reasoning-Modus verändert das Ergebnis
Der klarste unabhängige Vergleich stammt von Artificial Analysis. Bei maximalem Reasoning liegt DeepSeek im Intelligence Index vor MiniMax M3 und ist etwas schneller.
| Unabhängige Kennzahl |
MiniMax M3 |
DeepSeek V4 Flash 0731, maximales Reasoning |
| Artificial Analysis Intelligence Index |
45 |
52 |
| Ausgabegeschwindigkeit |
114 Tokens/s |
119 Tokens/s |
| Zeit bis zum ersten Token |
1,17 Sekunden |
1,12 Sekunden |
| Kontextfenster |
1 Mio. Tokens |
1 Mio. Tokens |
Der Unterschied bei der Intelligenz ist relevant; der Geschwindigkeitsunterschied ist gering, und der Durchsatz gehosteter Modelle kann sich ändern. Aussagekräftiger wird das Ergebnis, wenn DeepSeek ohne Reasoning ausgeführt wird: Artificial Analysis bewertet MiniMax M3 mit 45 und DeepSeek V4 Flash ohne Reasoning mit 29. Aussagen zur „Leistung von DeepSeek V4 Flash“ sind daher unvollständig, solange die Reasoning-Einstellung nicht genannt wird. Max Reasoning ist der relevante Vergleich für komplexen Code und die Planung durch Agents; der Modus ohne Reasoning eignet sich für klar abgegrenzte Aufgaben wie Klassifizierung, Extraktion und Autovervollständigung.
Auch die Diagramme der Anbieter liefern Kontext, aber keinen fairen direkten Vergleich. MiniMax gibt 59,0 % bei SWE-Bench Pro, 66,0 bei Terminal-Bench 2.1 und 74,2 bei MCP Atlas an. DeepSeek gibt 82,7 bei Terminal-Bench 2.1, 54,2 bei NL2Repo und 70,3 bei Toolathlon Verified an. Die Unternehmen verwendeten unterschiedliche Infrastruktur, Gerüste, Evaluations-Frameworks und Einstellungen. Ein direkter Vergleich von 82,7 mit 66,0 wäre daher irreführend.
Die belastbare Schlussfolgerung ist enger gefasst: Im unabhängigen Vergleich liegt DeepSeek bei maximalem Reasoning vorn. Die bei der Markteinführung veröffentlichten Diagramme sagen nicht aus, welches Modell eine bestimmte Repository-Aufgabe mit weniger Korrekturen erledigt.
MiniMax M3 vs. DeepSeek V4 Flash beim Coding
Für kleine, überprüfbare Coding-Aufgaben ist DeepSeek der bessere Ausgangspunkt. Unit-Tests, Schema-Konvertierung, Code-Erklärungen, isolierte Fehlerbehebungen und wiederholte Änderungen profitieren von der Reasoning-Bewertung und der Cache-Rate – insbesondere, wenn Tests, Linter oder Validatoren das Ergebnis überprüfen können.
Arbeiten am gesamten Repository sind weniger eindeutig. Kapazität ist nicht dasselbe wie zuverlässiges Verständnis: Ein Agent muss die Repository-Regeln befolgen, irrelevante Änderungen vermeiden, sich von fehlgeschlagenen Befehlen erholen und einen Plan einhalten. Für textbasierte Repository-Aufgaben würde ich weiterhin mit DeepSeek beginnen, da das Modell bei maximalem Reasoning besser abschneidet und Cache-Lesezugriffe günstig sind. MiniMax wird interessanter, wenn die Aufgabe Screenshots, Diagramme, Design-Assets oder andere visuelle Eingaben umfasst.
Ein günstigerer erster Patch ist nicht günstiger, wenn dafür manuelle Wiederherstellungsarbeit nötig ist. Vergleiche bei risikoreichen Änderungen die Gesamtzahl der Aufrufe, fehlgeschlagenen Tools und Korrekturen, die Tests sowie die Zeit bis zu einem akzeptierten Ergebnis.
Welches Modell eignet sich besser für Frontend-Coding?
„Frontend-Coding“ kann zwei unterschiedliche Aufgaben bezeichnen, die in vielen Vergleichen vermischt werden.
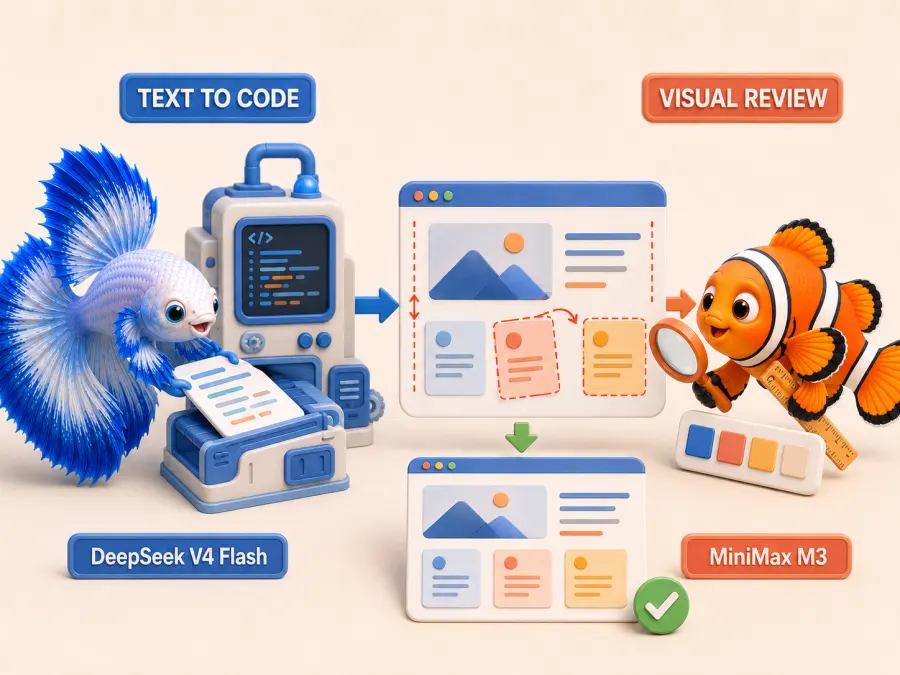
Bei der ersten geht es um Text-zu-Code. Ein Entwickler gibt eine schriftliche Spezifikation vor und bittet um eine React-Komponente, responsives CSS, Zustandslogik, Barrierefreiheitskorrekturen oder ein Seitenlayout. Das Modell muss kein Bild untersuchen. Für diesen Anwendungsfall ist DeepSeek V4 Flash auf Grundlage des aktuellen unabhängigen Reasoning-Vergleichs und seiner Eignung für textbasierte Coding-Agents die stärkere Standardwahl.
Bei der zweiten geht es um visuelle Frontend-Iteration. Das Modell erhält einen Screenshot, eine gerenderte Seite oder eine Bildschirmaufnahme und soll Abweichungen bei Abständen, Farben oder Ausrichtung erkennen. MiniMax M3 hat hier den entscheidenden Vorteil, da DeepSeek V4 Flash in der Standardversion keine visuellen Eingaben verarbeiten kann.
Diese Unterscheidung führt zu einer treffenderen Schlussfolgerung als „MiniMax ist besser für Frontend“. MiniMax M3 ist nicht automatisch der bessere Frontend-Coder. Es ist das bessere Modell für visuelle Frontend-Aufgaben. DeepSeek bleibt die bessere Standardwahl für reine Textaufgaben, während MiniMax die Feedbackschleife übernimmt, die nach dem Rendern der Seite beginnt.
Welches Modell eignet sich besser für KI-Agents?
Beide Modelle können Tools aufrufen, strukturierte Argumente zurückgeben, Ergebnisse lesen und mehrstufige Aufgaben fortsetzen. Für textbasierte Agents, die Repositories durchsuchen, Logs prüfen, Tests generieren oder wiederholbare Daten-Workflows ausführen, ist DeepSeek die praktische Standardwahl. Seine Cache-Rate ist wichtig, weil diese Systeme dieselben Anweisungen und Tool-Definitionen wiederholt senden. MiniMax eignet sich für Agents, die Diagramme, Anwendungsoberflächen, Designvorlagen oder Aufzeichnungen interpretieren müssen, bevor sie den nächsten Schritt wählen.
Das Befolgen von Anweisungen ist bei beiden Modellen der weniger überzeugende Aspekt. In einer Community-Diskussion zu MiniMax M3 berichteten Nutzer, dass sie mit dem Modell um die Einhaltung von Regeln und Anweisungen ringen mussten. Andere beschrieben jedoch gute Ergebnisse in Coding-Agent-Workflows. Auch DeepSeek 0731 wurde ähnlich kritisiert: Entwickler berichteten in einem Coding-orientierten Thread und einer separaten Diskussion zur Zuverlässigkeit über Probleme beim Befolgen von Regeln, Skills und subtilen Anweisungen außerhalb des Codings.
Das sind Erfahrungsberichte, keine kontrollierten Auswertungen. Sie zeigen, warum der abschließende Migrationstest mit deinem tatsächlichen System-Prompt, den Repository-Regeln, dem Tool-Schema und den Anweisungen zur Fehlerbehebung durchgeführt werden sollte. Ein sinnvoller gemischter Workflow überträgt textbasierte Implementierung und wiederholte Teilaufgaben an DeepSeek und leitet Screenshot-Analysen sowie visuelles Debugging an MiniMax weiter.
Preise: Welches Modell ist tatsächlich kosteneffizienter?
Der Tokenpreis allein führt zur falschen Antwort, da sich die Modelle bei Preisen für Eingabe, Ausgabe, Cache und zeitabhängige Nutzung unterscheiden. Die folgenden Berechnungen basieren auf den GPT Proto-Preisen vom 28. August 2026.
MiniMax M3 hat feste Preise von 0,48 USD pro Million neuer Eingabetokens und 0,96 USD pro Million Ausgabetokens. Cache-Schreib- und Lesezugriffe kosten derzeit jeweils 0,10 USD pro Million.
DeepSeek V4 Flash kostet zu Spitzenzeiten 0,44 USD pro Million neuer Eingabetokens, 0,014 USD pro Million Cache-Lesezugriffe und 1,32 USD pro Million Ausgabetokens. Aufrufe außerhalb der Spitzenzeiten werden zum halben Preis abgerechnet. GPT Proto legt die Nebenzeiten derzeit nach Pekinger Zeit auf 18:00–09:00 Uhr und 12:00–14:00 Uhr fest. Für die tatsächliche Abrechnung ist der Zeitpunkt der Anfrage maßgeblich.
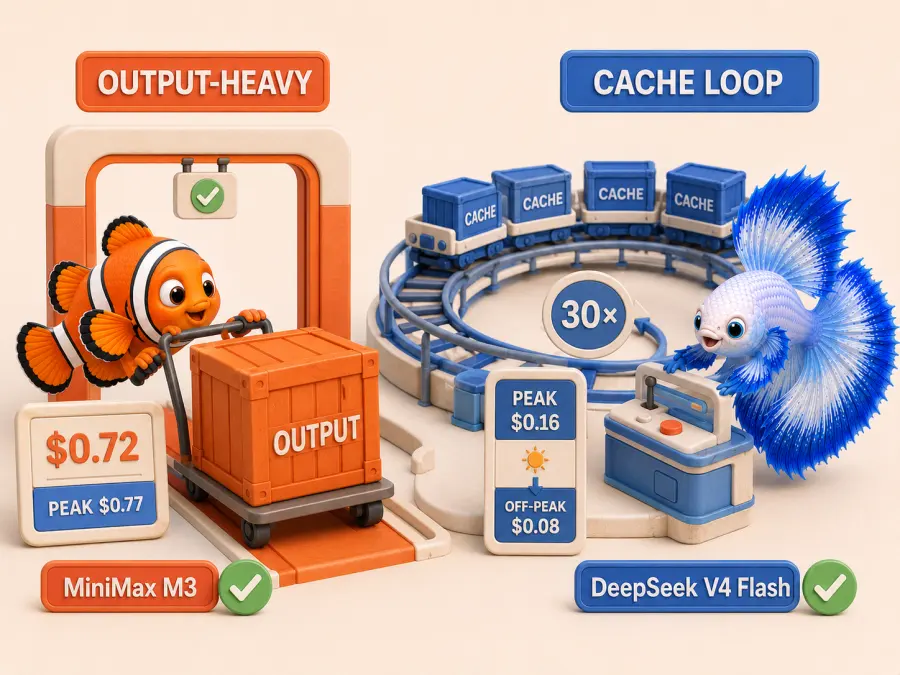
Beispiel 1: Ausgabelastige Anfrage ohne Cache
Angenommen, eine Anfrage verwendet eine Million neue Eingabetokens und erzeugt 250.000 Ausgabetokens.
| Modell und Zeitpunkt |
Geschätzte Kosten |
| MiniMax M3 |
0,7200 USD |
| DeepSeek V4 Flash zu Spitzenzeiten |
0,7700 USD |
| DeepSeek V4 Flash außerhalb der Spitzenzeiten |
0,3850 USD |
MiniMax ist während der Spitzenzeiten von DeepSeek etwa 0,05 USD günstiger, da der Preis für Ausgabetokens niedriger ist. Wird derselbe DeepSeek-Aufruf außerhalb der Spitzenzeiten ausgeführt, kostet er fast nur halb so viel wie bei MiniMax.
Beispiel 2: Coding-Agent mit umfangreicher Cache-Nutzung
Nehmen wir nun eine Coding-Agent-Sitzung mit 30 Durchläufen an. Bei jedem Durchlauf werden 100.000 gecachte Tokens gelesen, 3.000 neue Eingabetokens hinzugefügt und 2.000 Ausgabetokens erzeugt. Die Schätzung für MiniMax umfasst außerdem einen anfänglichen Cache-Schreibvorgang mit 100.000 Tokens.
| Modell und Zeitpunkt |
Geschätzte Kosten für 30 Durchläufe |
| MiniMax M3 |
0,4108 USD |
| DeepSeek V4 Flash zu Spitzenzeiten |
0,1608 USD |
| DeepSeek V4 Flash außerhalb der Spitzenzeiten |
0,0804 USD |
Das ist der Preisunterschied, den viele einfache Vergleichstabellen übersehen. MiniMax M3 kann bei Anfragen ohne Cache mit umfangreicher Ausgabe günstiger sein. Bei Agent-Schleifen mit intensiver Cache-Nutzung ist DeepSeek V4 Flash in der Regel günstiger – selbst zu Spitzenzeiten. Werden aufschiebbare Jobs außerhalb der Spitzenzeiten geplant, vergrößert sich der Unterschied weiter.
Dabei handelt es sich um Schätzungen, nicht um Abrechnungen aus einem Live-Test unter identischen Bedingungen. Teams sollten die Kosten anhand ihres eigenen Token-Verhältnisses, ihrer Cache-Trefferrate, Wiederholungsversuche und Erfolgsquote bei Aufgaben neu berechnen.
Kontextfenster, Multimodalität und Deployment
Beide Modelle geben ein Kontextfenster von ungefähr einer Million Tokens an, doch dabei handelt es sich um ein gemeinsames Nutzungslimit. Bei DeepSeek teilen sich Eingabe, Verlauf, Tool-Ergebnisse, Reasoning und Ausgabe das Fenster von 1.048.576 Tokens; die maximale Ausgabe beträgt bis zu 384K. MiniMax nennt dasselbe Kontextfenster, ein garantiertes Minimum von 512K und eine maximale Ausgabe von rund 512K. Agents mit langem Kontext sollten dennoch ausreichend Spielraum für die Ausgabe reservieren und relevante Dateien auswählen, statt ein ungefiltertes Repository zu senden.
Bei der Multimodalität herrscht kein Gleichstand. MiniMax akzeptiert Text, Bilder und Videos; DeepSeek V4 Flash akzeptiert Text. Ein DeepSeek-Workflow, der Screenshots benötigt, muss den visuellen Schritt an ein anderes Modell weiterleiten, beispielsweise an das separat gehostete Vision Exp-Modell.
Die Lizenz bildet den letzten Unterschied. DeepSeek veröffentlicht die Gewichte von V4 Flash unter der MIT-Lizenz, die kommerzielles Self-Hosting, Weiterverbreitung und Änderungen erleichtert. MiniMax veröffentlicht M3 unter der MiniMax Community License, die zusätzliche Bedingungen zu Namensnennung, Hinweisen und umsatzabhängiger Genehmigung enthält. Nutzern der gehosteten API sind möglicherweise vor allem die Verfügbarkeit der Route und die Datenbedingungen wichtig; Teams, die selbst hosten, sollten vor dem Deployment die Lizenz der Gewichte prüfen.
Welches Modell solltest du wählen?
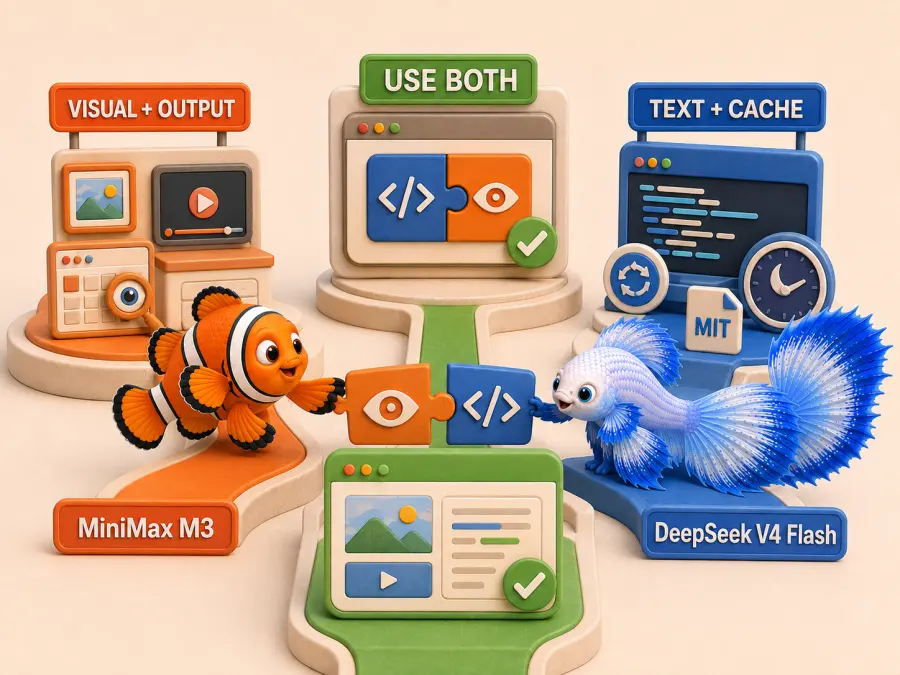
Wähle MiniMax M3, wenn der Agent Bilder oder Videos untersuchen muss, Frontend-Arbeit Feedback zu gerenderten Seiten umfasst oder Aufrufe zu Spitzenzeiten umfangreiche Ausgaben erzeugen. Wähle DeepSeek V4 Flash, wenn der Workflow textbasiert ist, Caching eine Rolle spielt, Batch-Jobs außerhalb der Spitzenzeiten laufen können oder eine MIT-Lizenz erforderlich ist. Nutze beide Modelle, wenn sich die Anwendung sinnvoll in textbasierte Implementierung und visuelle Überprüfung aufteilen lässt.
MiniMax M3 und DeepSeek V4 Flash mit einem API-Key ausführen
Um beide Modelle zu testen, brauchst du weder zwei getrennte Kontoguthaben noch zwei Integrationsebenen. GPT Proto bietet Zugriff auf MiniMax M3 und DeepSeek V4 Flash über dasselbe Konto und ein gemeinsames Guthaben.
Für Textaufrufe passen beide in die Struktur einer OpenAI-kompatiblen Anwendung. Ändere die Modell-ID, behalte Aufgabe und Abnahmekriterien bei und erfasse den Abschluss, fehlgeschlagene Tool-Aufrufe, Korrekturen, Latenz, Tokenverbrauch und Gesamtkosten. Führe vor der Umstellung des Datenverkehrs Canary-Tests für Streaming, Tool-Argumente, JSON-Parsing, Reasoning-Einstellungen, Wiederholungsversuche und das Verhalten bei der maximalen Tokenzahl durch.
Beide Modelle auf GPT Proto testen
Vergleiche beide Modelle mit einem Key und einem gemeinsamen Guthaben anhand der Aufgaben, die deine Anwendung tatsächlich ausführt.
Abschließendes Fazit
DeepSeek V4 Flash 0731 ist die bessere Standardwahl für textbasiertes Coding und Agents mit umfangreicher Cache-Nutzung. Das Modell liegt im aktuellen unabhängigen Vergleich mit maximalem Reasoning vorn, steht unter einer MIT-Lizenz und wird besonders günstig, wenn eine Anwendung Kontext wiederverwendet oder Aufrufe außerhalb der Spitzenzeiten plant.
MiniMax M3 ist die bessere Wahl, wenn der Workflow Bild- oder Videoeingaben, visuelles Feedback zum Frontend, längere Ausgaben oder einen niedrigeren Ausgabepreis zu Spitzenzeiten erfordert. Der Vorteil liegt in der Vielseitigkeit und nicht in der pauschalen Behauptung, das Modell schreibe besseren Code.
Wähle für den Produktiveinsatz anhand der Kosten pro akzeptierter Aufgabe statt allein nach dem Tokenpreis: Abschluss, Befolgung von Anweisungen, bestandene Prüfungen und Aufwand für die Fehlerbehebung.