Qwen 3.7 Plus vs. Qwen 3.8 Max: Die schnelle Antwort
| Anwendungsfall |
Bessere Wahl |
Warum |
| Beste Antwortqualität insgesamt |
Qwen 3.8 Max |
In unabhängigen Bewertungen von Intelligenz und Coding-Agenten liegt das Modell deutlich vorn. |
| Routine-API-Workloads |
Qwen 3.7 Plus |
Niedrigerer Listenpreis und deutlich höhere gemessene Ausgabegeschwindigkeit. |
| Anspruchsvolle Programmierung auf Repository-Ebene |
Qwen 3.8 Max |
Bessere Ergebnisse bei unabhängigen Software-Engineering-Aufgaben. |
| Frontend-Programmierung |
Qwen 3.8 Max |
Starke Platzierung in der WebDev Arena und bessere visuelle Schlussfolgerungen. |
| Klassifizierung oder Extraktion großer Datenmengen |
Qwen 3.7 Plus |
Die Qualität von Max ist bei klar eingegrenzten, wiederholbaren Aufgaben oft nicht nötig. |
| Visuelle Agenten |
Qwen 3.8 Max |
Roboflow stellte bei sechs Vision-Bewertungen einen deutlichen Genauigkeitsvorsprung fest. |
| Niedrigste Tokenkosten |
Qwen 3.7 Plus |
Der Einstiegspreis für Eingaben beträgt ein Fünftel des internationalen Listenpreises von Max. |
| Lange Antworten und umfangreiche Agentenverläufe |
Qwen 3.8 Max |
Die maximale Ausgabe umfasst 131.072 Tokens und ist damit doppelt so groß wie das Limit von Plus. |
Unser Fazit: Qwen 3.8 Max gewinnt beim Funktionsumfang. Qwen 3.7 Plus ist die wirtschaftlichere Standardwahl. Für viele Produktionssysteme ist es am sinnvollsten, normale Anfragen an Plus weiterzuleiten und schwierige Fälle an Max zu eskalieren.
Was hat sich von Qwen 3.7 Plus zu Qwen 3.8 Max geändert?
Qwen 3.7 Plus ist als kostengünstigeres und schnelleres Produktionsmodell positioniert. Qwen 3.8 Max ist die Flaggschiff-Option für komplexes Schlussfolgern, Programmieren, Agenten und multimodale Aufgaben.
In der offiziellen Dokumentation zu Qwen 3.7 Plus werden ein Kontextfenster mit 1 Million Tokens, hybrides Denken, Funktionsaufrufe, strukturierte Ausgaben, Websuche und Prompt-Caching aufgeführt. Die Dokumentation zu Qwen 3.8 Max behält denselben Eingabeumfang bei, erhöht aber die maximale Ausgabelänge und bietet mehr direkte Kontrolle über den Denkaufwand.
| Spezifikation |
Qwen 3.7 Plus |
Qwen 3.8 Max |
| Modell-ID |
qwen3.7-plus |
qwen3.8-max |
| Veröffentlichungszeitraum |
Mai/Juni 2026 |
August 2026 |
| Architektur |
397B Parameter insgesamt, 17B aktiv |
2,4T Parameter insgesamt, 95B aktiv |
| Eingaben |
Text, Bild, Video |
Text, Bild, Video |
| Ausgabe |
Text |
Text |
| Kontextfenster |
1.000.000 Tokens |
1.000.000 Tokens |
| Maximale Eingabe |
991.808 Tokens |
991.808 Tokens |
| Maximale Ausgabe |
65.536 Tokens |
131.072 Tokens |
| Maximale Denklänge |
262.144 Tokens |
262.144 Tokens |
| Funktionsaufrufe |
Ja |
Ja |
| Strukturierte Ausgabe |
Ja |
Ja |
| Feinabstimmung |
Nein |
Nein |
| Offene Gewichte |
Keine entsprechende offene Veröffentlichung |
Qwen3.8-2.4T-A95B-Gewichte separat veröffentlicht |
Die verwaltete API qwen3.8-max und die separat veröffentlichten Gewichte Qwen3.8-2.4T-A95B gehören zur selben Familie, können sich aber bei Bereitstellung, Limits und Funktionen unterscheiden. Bei einem selbst gehosteten Deployment werden nicht zwangsläufig alle Ergebnisse aus der Cloud reproduziert.
Preise von Qwen 3.7 Plus und Qwen 3.8 Max
Die Preise von Alibaba Cloud variieren je nach Region, Kontextlänge, Caching und zeitlich begrenzten Rabatten. Die folgende Tabelle verwendet die dauerhaft geltenden internationalen Listenpreise für das Deployment in Singapur und keine kurzfristige Sonderaktion.
| Modell und Anfragegröße |
Eingabe pro 1 Mio. Tokens |
Ausgabe pro 1 Mio. Tokens |
| Qwen 3.7 Plus, bis zu 256K Eingabe |
$0.40 |
$1.60 |
| Qwen 3.7 Plus, über 256K bis 1M Eingabe |
$1.20 |
$4.80 |
| Qwen 3.8 Max |
$2.00 |
$6.00 |
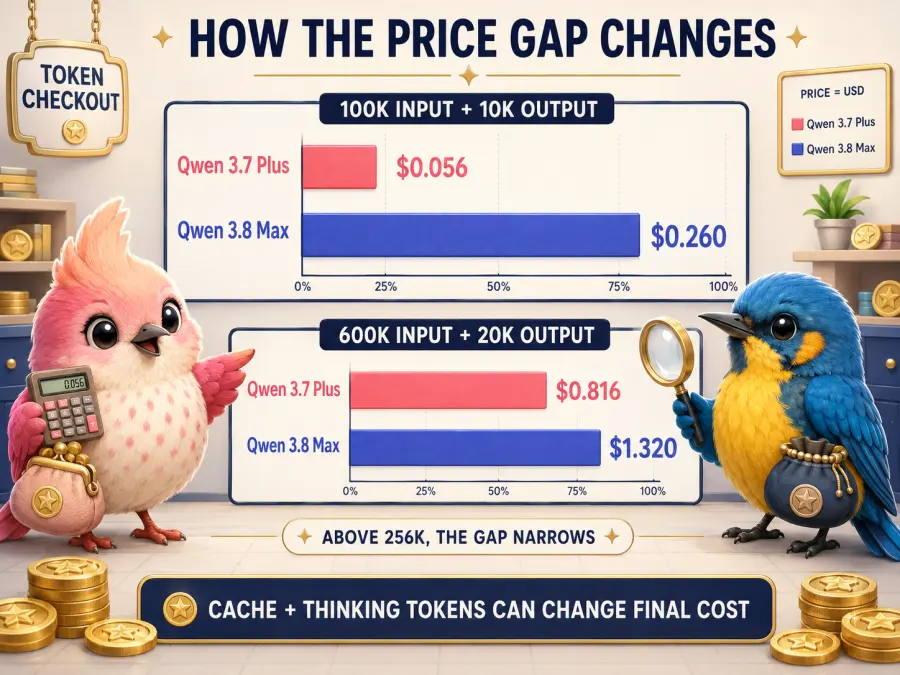
Im niedrigeren Kontextbereich ist Plus bei Eingaben fünfmal günstiger. Bei mehr als 256K Eingabetokens steigt der internationale Preis und der Abstand wird kleiner.
Hier sind zwei vereinfachte Beispiele, ohne Caching, Denktokens oder plattformspezifische Gebühren:
Eine Anfrage mit 100K Eingabetokens und 10K Ausgabetokens kostet etwa $0.056 bei Qwen 3.7 Plus und $0.260 bei Qwen 3.8 Max.
Eine Anfrage mit 600K Eingabetokens und 20K Ausgabetokens kostet etwa $0.816 bei Qwen 3.7 Plus und $1.320 bei Qwen 3.8 Max.
Anfragelänge, Ausgabe, Cache-Treffer und Wiederholungsversuche beeinflussen die tatsächlichen Kosten. Prüfen Sie die offizielle Preisseite von Model Studio für Ihre Region.
 GPT Proto listet Qwen 3.8 Max derzeit mit $1.80 pro einer Million Eingabetokens und $5.40 pro einer Million Ausgabetokens, zuzüglich separater Tarife für Cache-Schreib- und Cache-Lesevorgänge. Prüfen Sie die aktuellen Preise auf der
Leistung: Qwen 3.8 Max ist leistungsfähiger, aber langsamer
Der deutlichste unabhängige Vergleich stammt von Artificial Analysis. Der direkte Modellvergleich liefert folgende Ergebnisse:
| Unabhängige Messung |
Qwen 3.7 Plus |
Qwen 3.8 Max |
| Intelligence Index |
39 |
58 |
| Ausgabegeschwindigkeit |
56.1 Tokens/s |
20.7 Tokens/s |
| Zeit bis zum ersten Token |
2.17 s |
2.51 s |
Max erzielt über ein breites Spektrum an Bewertungen bessere Ergebnisse, Plus generiert Antworten jedoch deutlich schneller. Die Zeit bis zum ersten Token ist ähnlich; der größere Unterschied zeigt sich nach Beginn der Generierung.
In einem Chat oder IDE-Assistenten können sich 56 Tokens pro Sekunde deutlich reaktionsschneller anfühlen als 21. Bei einer Offline-Prüfung, die einen schwerwiegenden Fehler verhindert, kann sich die Wartezeit auf Max lohnen. Die Latenz hängt außerdem von der Auslastung des Anbieters, der Promptlänge und dem Standort ab. Testen Sie daher den Produktionsendpunkt.
Welches Modell eignet sich besser zum Programmieren?
Fürs Programmieren ist Qwen 3.8 Max insgesamt das bessere Modell. Qwen 3.7 Plus bleibt die praktische Wahl für kürzere, klar umrissene Aufgaben.
Verwenden Sie Plus für Erklärungen zu Funktionen, Grundgerüste für Unit-Tests, Datenkonvertierung, repetitive API-Clients und eng umrissene Änderungen mit klaren Anforderungen. Nutzen Sie Max, um Fehler über mehrere Dateien hinweg aufzuspüren, Migrationen zu planen, sicherheitskritische Logik zu prüfen, Mehrdeutigkeiten zu klären oder einen Agenten auf einem Repository arbeiten zu lassen.
Der Coding Agent Index v1.4 von Artificial Analysis verwendete für beide Modelle dieselbe Claude-Code-Testkonfiguration. Die veröffentlichten Ergebnisse zeigen einen deutlichen Vorsprung von Max:
| Ergebnis des Coding-Agenten |
Qwen 3.7 Plus |
Qwen 3.8 Max |
| Coding Agent Index |
38 |
61 |
| DeepSWE |
19% |
52% |
| Terminal-Bench v2.1 |
72% |
84% |
| SWE-Atlas-QnA |
24% |
48% |
| Erfasste Kosten pro Aufgabe |
$6.30 |
$3.23 |
| Erfasste Zeit pro Aufgabe |
10.7 Min. |
29.9 Min. |
Plus hat den niedrigeren Tokenpreis und war schneller fertig, dennoch verzeichnete Max in dieser Bewertung geringere Kosten pro abgeschlossener Aufgabe. Erfolgsquote, Caching, Ausgabemix und Wiederholungsversuche können den Listenpreis überwiegen. Das beweist nicht, dass Max immer günstiger ist; es zeigt, dass der Tokenpreis ein schlechter Richtwert für die Kosten anspruchsvoller Softwarearbeit ist.
In einem unabhängigen Test mit versteckten Fehlern, den Paweł Huryn veröffentlichte, traten 11 Modelle gegen 105 versteckte Fehler in zwei Repositories an und wurden blind bewertet. Qwen 3.8 Max behob 19 Fehler in etwa 148 Minuten bei gemeldeten Kosten von ungefähr 31 $. Es war nicht der Gesamtsieger, behob aber als einziges Modell einen bestimmten Fehler. Plus wurde nicht getestet; daher sind dies Erkenntnisse zu Max und kein direkter Vergleich.
Max rechtfertigt seine Kosten eher, wenn ein fehlerhafter Patch eine weitere Prüfrunde nach sich zieht. Plus ist effizienter, wenn die Aufgabe bereits in Teilschritte zerlegt und leicht zu überprüfen ist.
Welches Modell eignet sich besser für die Frontend-Entwicklung?
Qwen 3.8 Max ist die leistungsstärkere Wahl für die Frontend-Entwicklung, insbesondere wenn der Prompt Screenshots, Layoutvorgaben oder visuelle Abnahmekriterien enthält.
Am 21. August 2026 lag Qwen 3.8 Max auf der vorläufigen Frontend-Bestenliste der WebDev Arena mit 1675 ± 14 Punkten auf Platz vier. Die Arena-Ranglisten ändern sich mit zunehmender Zahl der Stimmen; betrachten Sie dies daher als Momentaufnahme mit Datum und nicht als dauerhaften Rang.
Auch Roboflows Vision-Vergleich mit sechs Aufgaben ergab einen bedeutsamen Unterschied:
| Vision-Ergebnis |
Qwen 3.7 Plus |
Qwen 3.8 Max |
| Durchschnitt über sechs Bewertungen |
67.4% |
84.0% |
| OCR |
86.5% |
92.8% |
| Visuelles Schlussfolgern, geringer Aufwand |
39.7% |
73.5% |
| Durchschnittliche Antwortzeit |
7.0 s |
18.0 s |
| Angegebene Kosten pro Beispiel |
$0.0008 |
$0.0074 |
Der visuelle Vorsprung von Max ist relevant, wenn ein Agent eine gerenderte Seite mit einer Referenz vergleicht, Text in einem Screenshot liest oder Layoutprobleme diagnostiziert. Plus ist weiterhin vorzuziehen, wenn einfache Komponenten auf Grundlage eines textbasierten Designsystems erstellt werden sollen.
Visuelle Ranglisten hängen von der Bewertungsansicht ab. Am 21. August lag Max in einer stilkontrollierten Ansicht der Arena auf Platz zwei und am 27. August ohne Stilkontrolle auf Platz sechs. Die genaue Platzierung hängt daher von den Bewertungsbedingungen ab.
Welches Modell eignet sich besser für Entwickler, die Agenten erstellen?
Beide Modelle unterstützen Funktionsaufrufe und strukturierte Ausgaben. Beide können Bilder und Videos verarbeiten. Qwen 3.7 Plus verwendet hybrides Denken: Das Schlussfolgern ist standardmäßig aktiviert, Entwickler können es aber deaktivieren oder, sofern unterstützt, ein Denkbudget festlegen. Qwen 3.8 Max bietet in der Alibaba-Cloud-API Stufen für reasoning_effort wie low, medium und xhigh; xhigh ist laut Dokumentation die Standardeinstellung.
Längeres Schlussfolgern kann mehr Tokens verbrauchen und die Latenz erhöhen. Beginnen Sie mit der niedrigsten Einstellung, die Ihre Bewertung besteht, und erhöhen Sie sie dann für anspruchsvolle Anfragen. Prüfen Sie die Unterstützung des Anbieters, denn ein Alibaba-Cloud-Parameter ist nicht automatisch über jeden kompatiblen Endpunkt verfügbar.
Max erzielt im Vergleich der Coding-Agenten bessere Ergebnisse, und seine maximale Ausgabe von 131.072 Tokens ist doppelt so groß wie das Limit von Plus. Plus eignet sich weiterhin gut als Koordinator für häufige, risikoarme Tool-Aufrufe, etwa für Klassifizierung, Schema-Prüfungen oder einfache Tool-Auswahl.
Die Batch-Unterstützung muss je nach Region geprüft werden. Bei Batch-Schnittstellen von Plus kann das Kontextlimit niedriger sein. Batch für Max ist für Peking dokumentiert, nicht jedoch für Singapur oder globale Deployments.
Welches Modell ist kosteneffizienter?
Qwen 3.7 Plus ist bei vorhersehbaren, einfachen Anfragen kosteneffizienter. Qwen 3.8 Max kann bei schwierigen Aufgaben kosteneffizienter sein, wenn dadurch Fehler, Wiederholungsversuche und menschlicher Prüfaufwand reduziert werden.
Verwenden Sie drei Kennzahlen: Kosten pro Token, wobei Plus die Nase vorn hat; Kosten pro erfolgreich abgeschlossener Aufgabe, abhängig von Schwierigkeitsgrad und Wiederholungsversuchen; und Kosten einer falschen Antwort, wobei Max bei Codeänderungen und folgenreichen Tool-Aktionen im Vorteil sein kann.
Wenn Plus mehrere Versuche und eine Prüfung durch einen Entwickler erfordert, kann Max trotz des höheren Preises günstiger sein. Werden jedoch alle Extraktions- oder Formatierungsanfragen an Max gesendet, zahlen Sie für Qualität, die Ihre Anwendung möglicherweise gar nicht benötigt.
Erstellen Sie einen repräsentativen Testsatz mit klaren Bestehenskriterien und erfassen Sie dann Latenz, Tokens, Wiederholungsversuche und den endgültigen Erfolg. Vergleichen Sie den gesamten Workflow, nicht nur den ersten Rechnungsposten.
Lange Kontexte, Video und multimodale Aufgaben
Beide Modelle bieten ein Kontextfenster mit 1 Million Tokens. Plus eignet sich für die Extraktion aus großen Dokumentensammlungen, wenn die Antworten kurz und klar spezifiziert sind; der internationale Preis ändert sich jedoch ab 256K Eingabetokens. Max ist besser für die Synthese über mehrere Dokumente hinweg, widersprüchliche Belege und lange Berichte geeignet.
Beide offiziellen Dokumentationsseiten führen Bild- und Videoeingaben auf. Max ist die sicherere Wahl für visuelle Interpretationen, die Aktionen steuern; Plus ist günstiger für einfachere OCR- oder Metadatenextraktion. Testen Sie Medienlimits und -formate beim tatsächlichen Anbieter.
Eine praktische Routing-Strategie für den Produktivbetrieb
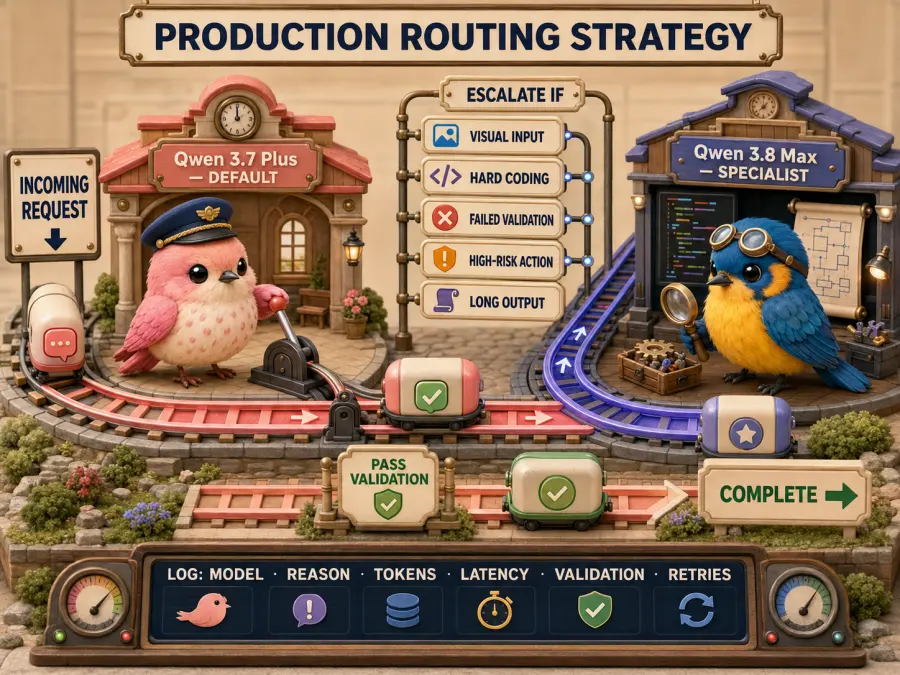
Die beste Entscheidung zwischen Qwen 3.7 Plus und Qwen 3.8 Max könnte sein, beide zu nutzen.
Leiten Sie Anfragen standardmäßig an Qwen 3.7 Plus weiter, wenn sie kurz, klar begrenzt, risikoarm oder leicht zu überprüfen sind. Eskalieren Sie zu Qwen 3.8 Max, wenn eine oder mehrere der folgenden Bedingungen zutreffen:
Die Anfrage enthält einen Screenshot, ein Diagramm oder ein Video, das präzise interpretiert werden muss.
Eine Programmieraufgabe umfasst mehrere Dateien oder erfordert die Fehlersuche nach einer unbekannten Ursache.
Ein erster Versuch mit Plus besteht die Validierung nicht oder liefert eine geringe Konfidenz.
Der Agent kann eine unumkehrbare oder kostspielige Aktion ausführen.
Die Aufgabe erfordert eine sehr lange generierte Antwort.
Die Kosten einer menschlichen Prüfung übersteigen den Preisunterschied zwischen den Modellen.
Protokollieren Sie das ausgewählte Modell, den Grund für das Routing, Tokens, Latenz, Validierungsergebnis und Wiederholungsversuche. Der reale Traffic zeigt, welche Regeln Kosten sparen.
Qwen 3.8 Max mit GPT Proto aufrufen
Redaktioneller Hinweis vor der Veröffentlichung: GPT Proto hat die Modellseite für Qwen 3.8 Max vorbereitet, aber der Endpunkt muss einen Live-Smoke-Test bestehen, bevor dieser Abschnitt als verfügbare API veröffentlicht wird. Ändern Sie bis dahin die Überschrift in „Qwen 3.8 Max kommt zu GPT Proto“, behalten Sie den Link zur Modellseite bei und entfernen Sie den folgenden Befehl.
Sobald das Modell aktiviert ist, kann die folgende OpenAI-kompatible Anfrage als einfacher Verbindungstest dienen:
curl --request POST "https://gptproto.com/v1/chat/completions" \
  --header "Authorization: Bearer $GPTPROTO_API_KEY" \
  --header "Content-Type: application/json" \
  --data '{
    "model": "qwen3.8-max",
    "messages": [
      {
        "role": "user",
        "content": "Review this implementation plan and identify the highest-risk failure points."
      }
    ]
  }'
Beginnen Sie mit Text und überprüfen Sie Modell-ID, Nutzungsfelder, Latenz und Fehler. Testen Sie Denksteuerungen, Medien, Batch-Inferenz und anbieterspezifische Felder separat.
Besuchen Sie die Qwen 3.8 Max API-Seite für aktuelle Verfügbarkeit und Preise.
Abschließendes Fazit: Qwen 3.7 Plus oder Qwen 3.8 Max?
Wählen Sie Qwen 3.8 Max, wenn Sie das beste Modell in diesem Vergleich möchten. Der Vorsprung ist bei unabhängigen Intelligenztests, Coding-Agent-Aufgaben, Frontend-Bewertungen, visuellem Schlussfolgern und maximaler Ausgabelänge am deutlichsten.
Wählen Sie Qwen 3.7 Plus, wenn Ihr Workload routinemäßig, umfangreich, latenzempfindlich oder leicht zu validieren ist. In der Messung von Artificial Analysis generiert es Tokens deutlich schneller und hat einen viel niedrigeren Einstiegspreis.
Verwenden Sie Plus standardmäßig und Max für Eskalationen. Wenn nur ein Modell eingesetzt werden kann, ist Max die sicherere Wahl, wenn Qualität Vorrang hat; Plus eignet sich besser, wenn das Budget entscheidend ist.