Что такое провайдер LLM API?
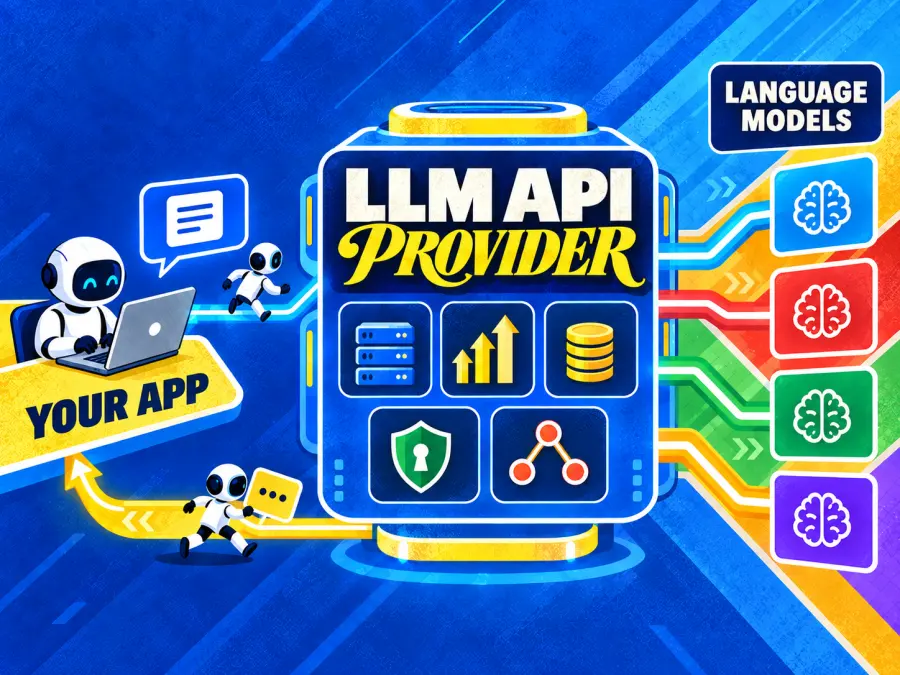
Провайдер LLM API предоставляет разработчикам хостинговый доступ к языковым моделям, избавляя их от необходимости настраивать и обслуживать базовую инфраструктуру для инференса. Провайдер берет на себя развертывание, масштабирование, учет использования, аутентификацию и — в зависимости от платформы — маршрутизацию, наблюдаемость, контроль безопасности или дообучение (fine-tuning).
Этот термин охватывает несколько различных типов бизнеса:
API моделей от первоисточника (First-party model APIs) предоставляют доступ к моделям, созданным той же компанией, например, когда лаборатория ИИ открывает доступ к своим собственным передовым моделям.
Провайдеры мультимодельных API объединяют модели от нескольких создателей под одной учетной записью и часто используют единый стандарт API.
Маршрутизаторы и шлюзы направляют запрос к одному из нескольких базовых хостов на основе цены, доступности, задержки или пользовательских правил.
Управляемые облачные AI-платформы сочетают доступ к моделям с корпоративной идентификацией, частными сетями, управлением и другими облачными сервисами.
Специалисты по инференсу оптимизируют выбранные модели с открытыми весами для повышения скорости, снижения затрат, дообучения или выделенного развертывания.
Эти категории пересекаются. Важен не просто вопрос «Есть ли у этого провайдера нужная модель?», а «Может ли он предоставить модель с тем протоколом, экономикой, надежностью и средствами контроля, которые требуются нашему приложению?»
Как мы оценивали лучших провайдеров LLM API
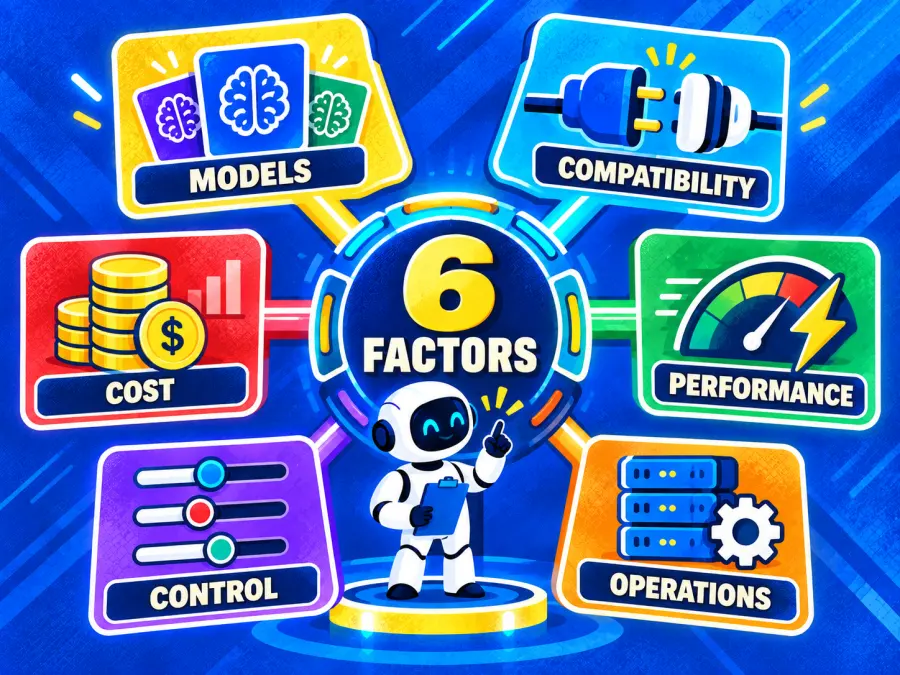
Мы проанализировали каждого провайдера по шести группам факторов:
Выбор моделей: количество и разнообразие полезных моделей, а не просто размер каталога.
Совместимость: согласованность API, инструменты, структурированные выходные данные и потоковая передача.
Реальная стоимость: тарифы на токены, комиссии платформы, кэширование, скидки на пакетную обработку и повторные попытки.
Производительность: время до получения первого токена, пропускная способность, задержки (tail latency) и поведение при нагрузке.
Контроль: привязка к провайдеру, правила отработки отказов, семантика ошибок и жизненный цикл модели.
Операционная деятельность: идентификация, регионы, работа с сетями, управление, документация и усилия по миграции.
Ни один провайдер не лидирует по всем факторам. Наш рейтинг отдает предпочтение лучшей платформе общего назначения для команд, которые ценят широкий доступ к моделям, а затем определяет случаи, когда более специализированный провайдер будет лучшим решением.
Сравнение провайдеров LLM API
| Ранг |
Провайдер |
Лучшее применение |
Профиль каталога |
Подход к API |
Главный компромисс |
| 1 |
GPT Proto |
Один API-ключ для LLM и мультимодальных моделей |
Всего 232 модели, включая 124 текстовые модели на момент обзора |
Чат-эндпоинт, совместимый с OpenAI, для поддерживаемых LLM; специализированные API для других модальностей |
Более новая платформа с меньшей корпоративной экосистемой, чем у гиперскейлеров |
| 2 |
OpenRouter |
Максимальный выбор LLM и маршрутизация между провайдерами |
Более 500 моделей от 80+ провайдеров |
Маршрутизируемый API, совместимый с OpenAI, с настройками предпочтений провайдеров и резервными путями |
Маршрутизация может усложнить кэширование, стабильность производительности и учет затрат |
| 3 |
Amazon Bedrock |
Управление AWS и корпоративное развертывание |
Более 100 моделей через Bedrock Marketplace |
Единые управляемые интерфейсы, включая Converse API |
Концепции AWS, региональная доступность и специфическое поведение моделей усложняют работу |
| 4 |
Together AI |
Модели с открытыми весами, дообучение и эксперименты |
Широкий каталог открытых моделей |
Serverless API, совместимый с OpenAI, плюс возможности дообучения и выделенные опции |
Поддержка функций различается в зависимости от модели |
| 5 |
Fireworks AI |
Промышленный инференс открытых моделей |
Более 100 доступных моделей |
API, совместимые с OpenAI, с serverless и выделенным развертыванием |
Лучше всего подходит для рабочих нагрузок с открытыми моделями |
| 6 |
GroqCloud |
Очень быстрая генерация на сфокусированном каталоге |
Небольшой, тщательно отобранный выбор моделей |
Преимущественно API, совместимый с OpenAI |
Более узкий выбор и задокументированные пробелы в совместимости |
Итоговые показатели каталогов являются ориентировочными, а не прямо сопоставимыми. Каждая компания может считать версии моделей, модальности, провайдеров или дообучения иначе, чем другие. Доступность также меняется быстрее, чем это может отразить ежегодный список.
1. GPT Proto — лучший универсальный провайдер API для мультимодельных LLM
GPT Proto занимает первое место среди разработчиков, которым нужен один аккаунт и API-ключ, способные выходить за рамки простой генерации текста. На момент обзора в каталоге было представлено 232 модели, включая 124 текстовые модели, а также варианты для работы с изображениями, видео и аудио.
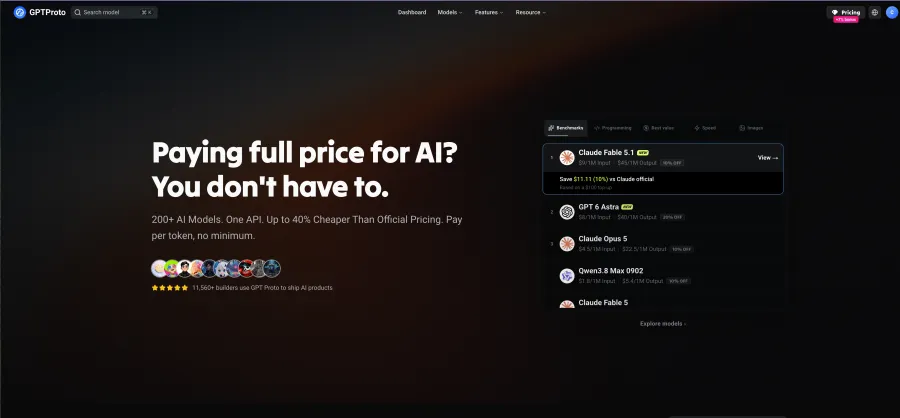
Для поддерживаемых LLM GPT Proto предоставляет шаблон чат-комплитов, совместимый с OpenAI. Разработчики могут просматривать каталог текстовых моделей, изучать тарифы для конкретных моделей и тестировать модель перед интеграцией.
На странице каждой модели указаны тарифы на входные и выходные данные. Например, API GLM-5.3 на момент обзора стоил $1,26 за миллион входных токенов и $3,96 за миллион выходных токенов — это на 10% ниже прямых тарифов Z.ai. Цены могут меняться, поэтому проверяйте страницу модели.
GPT Proto — не всегда лучший выбор для любого предприятия: у Bedrock более глубокое управление AWS, у OpenRouter шире каталог маршрутизируемых LLM, а специализированные провайдеры могут лучше справляться с конкретными открытыми моделями. Его преимущество заключается в практическом охвате различных семейств моделей и модальностей.
Лучше всего подходит для: SaaS-продуктов, AI-агентств, прототипов, переходящих в стадию продакшена, и мультимодальных приложений.
На что обратить внимание: Рассматривайте совместимость с OpenAI как специфичную для конкретной модели и эндпоинта. Модели для работы с изображениями и видео используют тела запросов, специфичные для задачи, а не формат чата LLM.
2. OpenRouter — лучший выбор для широты каталога LLM и маршрутизации
OpenRouter — самый сильный выбор, когда главным требованием является широта каталога. Его предложение включает более 500 моделей от более чем 80 провайдеров. Один эндпоинт может маршрутизировать запросы между базовыми хостами, а разработчики могут настраивать предпочтения провайдеров, разрешать использование резервных вариантов или применять автоматический выбор.
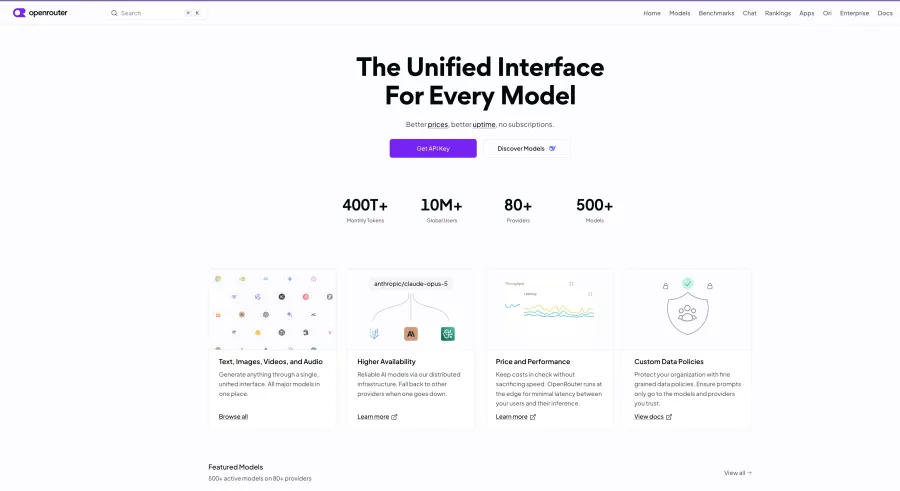
Компромисс заключается в том, что маршрутизация становится частью поведения приложения. Одно и то же имя модели может работать на другом хосте, аппаратном стеке или варианте модели. Это может изменить задержку, поддерживаемый контекст, обработку ошибок и экономику кэширования промптов. OpenRouter также взимает комиссию в размере 5,5% при покупке кредитов для стандартного тарифного плана с оплатой по факту использования, что следует учитывать при расчете общих затрат.
В недавних обсуждениях разработчиков пользователи сообщали о снижении стабильности попаданий в кэш при переключении трафика между провайдерами. В отдельном анализе сообщества были изучены тысячи диалогов. Эти отчеты носят анекдотический характер, но командам с повторяющимися длинными промптами следует протестировать конфигурации с закрепленным провайдером и отключенной маршрутизацией по сравнению с маршрутизацией по умолчанию.
Лучше всего подходит для: поиска моделей, широкого доступа к LLM, резервной маршрутизации и приложений, которые могут извлечь выгоду из выбора провайдера во время выполнения запроса.
На что обратить внимание: платформенные комиссии, различия на уровне провайдеров, промахи кэша и противоречие между автоматическим резервированием и детерминированной производительностью.
3. Amazon Bedrock — лучший выбор для предприятий, использующих AWS
Amazon Bedrock — наиболее привлекательный вариант для организаций, которые уже работают в экосистеме AWS. Маркетплейс Bedrock предоставляет доступ к более чем 100 моделям, а такие сервисы, как Agents, Knowledge Bases и Guardrails, позволяют интегрировать вывод моделей в более широкий управляемый стек.
Главная ценность здесь заключается в управлении, а не в количестве моделей. Клиенты AWS могут согласовать доступ к моделям с привычными принципами идентификации, логирования, региональными настройками, сетевой инфраструктурой, закупками и политиками безопасности. API Converse обеспечивает более единообразный интерфейс обмена сообщениями для поддерживаемых моделей, что сглаживает различия в интеграции между разными поставщиками. AWS также заявляет, что контент, отправляемый через этот API, не сохраняется, что является важным фактором для корпоративных проверок.
Единообразие не означает, что все модели ведут себя одинаково. Доступность зависит от региона, поддержка функций различается, а ограничения аккаунтов или сервисов AWS добавляют дополнительную работу. Эти расходы менее оправданы для небольшой команды, которой нужен только ключ и эндпоинт для чата.
Лучше всего подходит для: регулируемых рабочих нагрузок, устоявшихся команд AWS и компаний, которым нужен доступ к моделям в рамках существующих границ облачного управления.
На что обратить внимание: доступность в конкретных регионах, функции конкретных моделей, квоты на использование сервисов и накладные расходы на облачную архитектуру.
4. Together AI — лучший выбор для экспериментов с открытыми весами и дообучения (fine-tuning)
Together AI — мощный провайдер API для LLM, ориентированный на команды, работающие преимущественно с моделями с открытыми весами. Их бессерверный сервис использует тарификацию за токен без необходимости выделения реплик или обязательств по минимальной стоимости развертывания. Платформа также поддерживает дообучение и выделенные эндпоинты, предоставляя командам путь от быстрой оценки до более контролируемого развертывания.
Интерфейс, совместимый с OpenAI, снижает усилия по миграции для стандартных задач чата. Together также публикует индикаторы возможностей для таких функций, как вызов функций (function calling) и структурированный вывод. Эти индикаторы важны, поскольку поддержка функций в каталоге не является единообразной: модель, отлично подходящая для простой генерации текста, может не подойти для агентского рабочего процесса, требующего строгого JSON или надежных вызовов инструментов.
Together предлагает больше возможностей, чем просто маршрутизатор, для команд, которые хотят дообучить открытую модель, протестировать её через хостинговый эндпоинт, а затем перейти к выделенному обслуживанию. Командам всё равно нужно выбрать подходящую модель, режим обслуживания и набор функций. Чтобы найти другой способ оценки этих вариантов развертывания, сравните альтернативы Together AI перед тем, как выбрать модель обслуживания.
Лучше всего подходит для: исследований открытых моделей, дообучения, оценки и команд, которые могут перейти от бессерверного использования к выделенному выводу.
На что обратить внимание: поддержка инструментов, структурированного вывода, контекста и режимов обслуживания для каждой модели.
5. Fireworks AI — Лучший выбор для развертывания открытых моделей в продакшене
Fireworks AI специализируется на предоставлении открытых моделей для использования в продакшене. Платформа предлагает более 100 доступных моделей, а также варианты как бессерверного доступа, так и выделенного развертывания. Интерфейс API включает поддержку Chat Completions, совместимых с OpenAI, и интерфейсов в стиле Responses, что позволяет сократить объем изменений в коде, необходимых для типичных приложений на базе LLM.
Платформа особенно актуальна, когда команда хочет начать с бессерверного инференса с оплатой за токен, а затем перенести стабильную рабочую нагрузку на более изолированные мощности. Пакетный инференс (batch inference) стоит 50% от тарифов бессерверного режима для задач, не требующих мгновенного ответа, что создает четкий путь оптимизации для офлайн-обогащения данных, классификации, суммаризации и задач по обработке данных.
Независимые бенчмарки инференса также показывают, почему ни одному провайдеру нельзя присваивать постоянный ярлык «скорости». Производительность варьируется в зависимости от модели, региона, нагрузки и метода измерения. Тестируйте конкретную пару «провайдер-модель» с реалистичными промптами, вместо того чтобы переносить результаты одной модели на всю платформу.
Лучше всего подходит для: инференса открытых моделей в продакшене, рабочих нагрузок, требующих выделенных мощностей, и пакетных задач, допускающих задержки.
На что обратить внимание: различия в производительности конкретных моделей и выбор между бессерверным, пакетным или выделенным развертыванием в зависимости от нагрузки.
6. GroqCloud — Лучший выбор для генерации текста с низкой задержкой
GroqCloud — это узкоспециализированный сервис в нашем списке. Его каталог работает на архитектуре инференса Groq, и публичные измерения неоднократно подтверждали, что поддерживаемые модели являются одними из самых быстрых по скорости генерации токенов. Это делает сервис привлекательным для интерактивных агентов, голосовых конвейеров, инструментов для написания кода и других сценариев, где пользователи чувствительны к любой задержке.
Groq описывает свой API как преимущественно совместимый с OpenAI, и это уточнение важно. В документации указаны неподдерживаемые поля, включая logprobs, logit_bias, top_logprobs и messages[].name; параметр n должен быть равен 1. Режим Flex позволяет использовать гораздо более высокие лимиты запросов, но может возвращать ответ 498 capacity_exceeded, если мощности недоступны. Предварительные версии моделей (preview models) также могут быть отозваны без предварительного уведомления.
Выбирайте GroqCloud, когда поддерживаемая модель подходит для вашей задачи, а задержка имеет измеримую ценность для продукта. Не выбирайте его только потому, что в вашем фреймворке уже есть адаптер для OpenAI.
Лучше всего подходит для: ассистентов реального времени, агентских циклов, голосовых приложений и генерации с критически важной задержкой на поддерживаемых моделях.
На что обратить внимание: ограниченный выбор моделей, неподдерживаемые поля запросов, поведение при нехватке мощностей и риски жизненного цикла preview-моделей.
Почему одна и та же LLM может вести себя по-разному у разных провайдеров
В исследовании 2026 года «Когда одна и та же модель не является тем же самым сервисом?» утверждается, что хостинговую модель следует рассматривать как специфический для провайдера объект сервиса. Его наблюдаемое поведение включает вариант модели, протокол, объем контекста, цену, задержку, пропускную способность, надежность и применимость к задаче — а не только название модели.
Это различие дает разработчикам более качественную структуру для сравнения провайдеров LLM API:
Идентичность и версия модели
Две конечные точки могут отображать одно и то же семейство моделей, при этом используя разные чекпоинты, квантование, уровни точности или графики обновлений. Уточняйте, закреплен ли идентификатор модели за конкретной версией и что происходит при изменении исходной модели.
Совместимость за пределами базового URL
«Совместимость с OpenAI» часто означает, что провайдер принимает привычный запрос chat-completions. Это не гарантирует поддержку каждого параметра, схемы инструментов, события потоковой передачи, поля ответа или кода ошибки. Создайте контрактное тестирование для функций, которые ваше приложение действительно использует.
Маршрутизация и стабильность кэширования
Автоматическая маршрутизация может повысить доступность, но переключение между провайдерами может снизить эффективность повторного использования кэша промптов. Если повторяющийся контекст составляет значительную часть ваших расходов, протестируйте фиксированный хост в сравнении с маршрутизируемым трафиком. Сравнивайте эффективную стоимость выполнения задачи, а не заявленную цену за миллион токенов.
Задержка, пропускная способность и ошибки
Измеряйте всё распределение. Задержка P50 описывает типичный вызов; P95 или P99 выявляют «длинный хвост» медленных ответов. Отслеживайте время до первого токена отдельно от скорости генерации. Фиксируйте лимиты запросов, тайм-ауты, ошибки нехватки ресурсов и успешность повторных попыток, поскольку дешевый эндпоинт, требующий частых повторов, может оказаться дорогим как с точки зрения вычислительных ресурсов, так и с точки зрения терпения пользователей.
То же исследование дает полезное представление о преимуществах: в измеренных случаях маршрутизация снизила стоимость одной рабочей нагрузки Qwen3-32B на 37,8%, в то время как выбор провайдера увеличил пропускную способность для рабочей нагрузки DeepSeek-V3.2 примерно на 90%. Эти результаты зависят от конкретной задачи, но они показывают, почему уровень провайдера заслуживает отдельной оценки.
Какого провайдера LLM API выбрать?
Используйте рейтинг как шорт-лист, а затем выбирайте в зависимости от рабочей нагрузки:
Выбирайте GPT Proto для широкого доступа к текстовым и медиамоделям по одному ключу.
Выбирайте OpenRouter для максимального выбора LLM и маршрутизации между провайдерами.
Выбирайте Amazon Bedrock для управления AWS и использования управляемых сервисов.
Выбирайте Together AI для экспериментов с открытыми моделями и их дообучения.
Выбирайте Fireworks AI для развертывания открытых моделей в продакшене.
Выбирайте GroqCloud для генерации с низкой задержкой на поддерживаемых моделях.
Держите API от первоисточника в списке сравнения, если проприетарная модель является стабильной зависимостью. В противном случае тестируйте как минимум двух провайдеров с кэшированными диалогами, вызовами инструментов, структурированными ответами, пиковой нагрузкой и ошибками — а не только короткими демонстрационными промптами.
Как получить доступ к нескольким LLM с помощью одного API-ключа GPT Proto
Начните с каталога текстовых моделей GPT Proto, откройте страницу модели и используйте опцию Попробовать эту модель, чтобы подтвердить вывод перед интеграцией. После создания API-ключа отправьте стандартный запрос chat-completions:
export GPTPROTO_API_KEY="replace_with_your_key"

curl https://gptproto.com/v1/chat/completions \
  -H "Authorization: Bearer $GPTPROTO_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "glm-5.3",
    "messages": [
      {
        "role": "user",
        "content": "Return a JSON comparison of two caching strategies."
      }
    ]
  }'
Для другой совместимой LLM измените значение model на идентификатор, указанный на странице этой модели. Храните выбор модели в конфигурации, а не жестко прописывайте его в коде приложения, и проверяйте поддержку функций перед переключением. Модели для работы с изображениями, видео и аудио используют свои специфические эндпоинты и тела запросов.
Итоговый вердикт
Лучший поставщик API LLM — это тот, который превращает подходящую модель в надежный сервис для вашей рабочей нагрузки. Качество модели определяет верхний предел возможностей, но совместимость, поведение кэша, задержка, обработка ошибок, политика жизненного цикла и общая стоимость определяют то, с чем на самом деле сталкиваются пользователи.
Для широкого повседневного использования GPT Proto предлагает наиболее сбалансированную отправную точку в этом сравнении шести поставщиков: один ключ, обширный каталог текстов, прозрачные страницы моделей и доступ к другим API генеративных медиа. OpenRouter выигрывает по широте маршрутизируемых LLM; Amazon Bedrock — по корпоративным элементам управления AWS; Together AI и Fireworks AI — на разных этапах жизненного цикла открытых моделей; а GroqCloud — по скорости вывода.
Составьте шорт-лист категории поставщиков, которая соответствует вашим операционным потребностям, а затем протестируйте конкретную комбинацию «поставщик-модель-задача». В 2026 году именно эта комбинация сервисов — а не просто логотип или название модели — является тем, что стоит выбирать.