Если вы сегодня выбираете между GPT 6.1 Terra и Sonnet 5.5, вот краткое правило, которым я пользуюсь перед запуском бенчмарка:
Выбирайте GPT-6.1 Terra, если ваш пайплайн включает проверку скриншотов в больших объемах, автоматизацию форм и счетов, отладку макетов UI или ограниченные задачи по программированию, где стоимость токенов $0.80/$4.00 и скорость выполнения задач в 3 раза выше важнее, чем глубина автономного рефакторинга — и при условии, что ваши входные данные для одного запроса не превышают 272 тыс. токенов.
Оставайтесь с Claude Sonnet 5.5, если ваш агент выполняет миграцию репозиториев с множеством файлов, глубокую отладку в терминале, где пропущенное изменение стоит дороже, чем счет за токены, или если вы используете промпты в один проход объемом от 300 тыс. до 900 тыс. токенов, где наценка OpenAI за длинный контекст нивелирует ценовое преимущество Terra на входе.
Вы можете проверить актуальные тарифы или рассчитать свой ежемесячный объем токенов через хаб сравнения моделей GPT Proto, прежде чем выбрать один из вариантов. Все, что приведено ниже, является сравнением, основанным на документации и бенчмарках, проверенным 5 ноября 2026 года; бенчмарки, предоставленные вендорами, указаны отдельно от независимых измерений Artificial Analysis и ранних отзывов разработчиков.
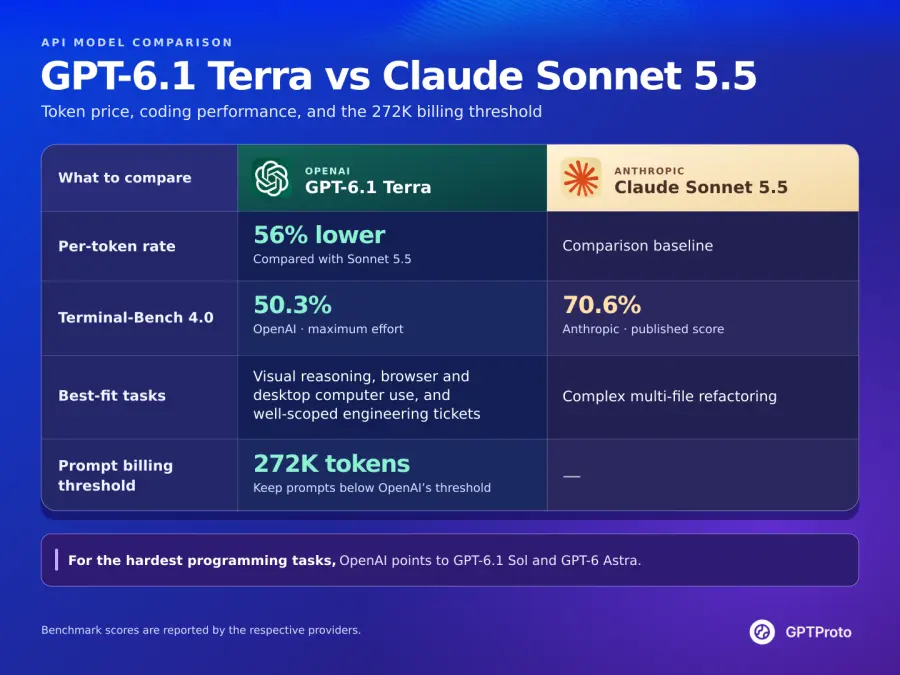
Сравнение GPT-6.1 Terra и Claude Sonnet 5.5: краткий обзор
Разработчики, которые ищут сравнение ChatGPT 6.1 Terra и Sonnet 5.5 или Anthropic Claude Sonnet 5.5 и GPT 6.1 Terra, часто сталкиваются с противоречивыми спецификациями, поскольку эти два вендора по-разному структурируют управление рассуждениями, конечные точки инструментов и доплаты за длинный контекст. В таблице ниже обе модели сопоставлены с официальной документацией OpenAI gpt-6.1-terra, обзором Claude Sonnet 5.5 от Anthropic и актуальными тарифами каталога GPT Proto.
| Спецификация |
GPT-6.1 Terra (gpt-6.1-terra) |
Claude Sonnet 5.5 (claude-sonnet-5-5) |
| Провайдер |
OpenAI |
Anthropic |
| Дата выпуска |
26 октября 2026 г. |
28 сентября 2026 г. |
| Официальный стандартный ввод / вывод (за 1 млн токенов) |
$1.00 / $5.00 |
$2.00 / $10.00 |
| Ввод / вывод GPT Proto (за 1 млн токенов) |
$0.80 / $4.00 (−20% от официального) |
$1.80 / $9.00 (−10% от официального) |
| Официальное чтение кэшированного ввода (за 1 млн токенов) |
$0.05 (5% от базового ввода) |
$0.10 (снижено с $0.20 от 7 октября 2026 г.) |
| Официальная запись в кэш (за 1 млн токенов) |
$1.25 (TTL 30 мин) / $2.50 (TTL 12 ч) |
$2.50 (TTL 5 мин) |
| Чтение / запись кэша GPT Proto (за 1 млн токенов) |
$0.04 / $1.00 |
$0.09 / $2.25 (проверьте на странице модели) |
| Контекстное окно |
1 050 000 токенов |
1 000 000 токенов |
| Правило ценообразования для длинного контекста |
>272 тыс. токенов ввода тарифицируются по двойному тарифу ввода/кэша и 1.5x для вывода |
Единый тариф для всего контекстного окна в 1 млн токенов |
| Максимальное количество выходных токенов |
128 000 токенов |
128 000 токенов |
| Модальности ввода / вывода |
Текст, изображение, документ на входе → текст на выходе |
Текст, изображение, документ на входе → текст на выходе |
| Дата отсечения знаний |
1 июня 2026 г. |
Начало-середина 2026 г. (сохраняет токенизатор Sonnet 5) |
| Управление рассуждениями / усилиями |
none, low, medium (по умолчанию), high, xhigh, max |
Адаптивное мышление включено по умолчанию; medium, high (по умолчанию для API), max, between_tools |
| Необходимая конечная точка для вызова инструментов |
/v1/responses требуется согласно документации OpenAI |
/v1/messages (нативная) или совместимая с OpenAI /v1/chat/completions |
| Доступность в клиентах и IDE |
ChatGPT Work & Codex (не обычный чат), GitHub Copilot, Claude Code (через API) |
Claude.ai, Claude Code, GitHub Copilot, Cursor |
| Индекс интеллекта AA (v4.3.2) |
41 (medium) / 48 (max) |
56 (max, резервный вариант по умолчанию) |
| Средняя стоимость задачи оценки AA |
$0.10 (`medium`) / $0.40 (max) |
$5.46 (max, резервный вариант по умолчанию) |
| Terminal-Bench 4.0 (отчет вендора) |
50.3% (max усилий) |
70.6% |
Три строки в этой таблице выполняют почти всю работу, когда вы планируете бюджет приложения. Во-первых, при стандартных запросах до 272 тыс. токенов GPT-6.1 Terra на 56% дешевле за токен на GPT Proto как для ввода, так и для вывода, поэтому длинные завершения не меняют рейтинг стоимости. Во-вторых, Sonnet 5.5 удерживает преимущество в 20.3 процентных пункта в Terminal-Bench 4.0, что тесно коррелирует с тем, как обе модели ведут себя при неконтролируемом редактировании репозиториев. В-третьих, в отличие от GPT-6.1 Sol, GPT-6.1 Terra восстанавливает поддержку reasoning.effort: "none", снова предоставляя разработчикам OpenAI быстрый путь без рассуждений.
Анализ цен и затрат: что стоит дороже, а что выгоднее?
Когда разработчики ищут «GPT 6.1 Terra vs Sonnet 5.5 что дороже» или «что выгоднее», они обычно пытаются сопоставить два разных показателя: тариф за миллион токенов на странице цен и реальную стоимость выполнения задачи агентом в долларах. Эти два соотношения не идентичны.
На уровне стоимости токенов Claude Sonnet 5.5 является значительно более дорогой моделью. Официальные цены Anthropic составляют $2.00 за миллион входных токенов и $10.00 за миллион выходных — это вдвое выше прайсовой цены OpenAI в $1.00/$5.00 для Terra. Поскольку GPT Proto применяет скидку 20% на GPT-6.1 Terra ($0.80 вход / $4.00 выход) и скидку 10% на Claude Sonnet 5.5 ($1.80 вход / $9.00 выход), Sonnet 5.5 обходится в 2.25 раза дороже за токен на платформе. Оба вендора теперь оценивают кэшированное чтение входных данных в 5% от базовой стоимости ($0.05 официально для Terra против $0.10 официально для Sonnet 5.5 после того, как Anthropic снизила цену на чтение кэша Sonnet вдвое в октябре 2026 года), и оба взимают 1.25x от базовой стоимости входных данных за стандартную запись в кэш ($1.25 против $2.50 официально). Обратите внимание, что однократный длинный промпт, записанный в кэш, фактически добавляет 25% наценки для любой из моделей, если вы никогда не считываете этот префикс повторно.
На уровне выполнения задач разрыв становится гораздо существеннее. В индексе интеллекта Artificial Analysis v4.3.2 (опубликованном 26–27 октября 2026 года), протестированная конфигурация Claude Sonnet 5.5 (max effort с Default Fallback) показала средневзвешенную стоимость $5.46 за задачу оценки. В том же наборе тестов [GPT-6.1 Terra при усилии `max`](https://artificialanalysis.ai/models/gpt-6-1-terra) средняя стоимость составила $0.40 за задачу, а GPT-6.1 Terra при усилии medium — всего $0.10 за задачу. Это 13.6-кратная разница при усилии max и 54.6-кратная разница при сравнении топовой настройки Sonnet с настройкой по умолчанию medium для Terra.
Почему двукратная разница в цене за токен превращается в 13–54-кратный разрыв в счете? Модели рассуждения тарифицируют токены «мышления» как выходные токены. Когда Sonnet 5.5 работает с высоким или максимальным усилием на открытом бенчмарке, она генерирует длинные цепочки рассуждений по цене $10.00 за миллион токенов ($9.00 на GPT Proto). В анонсе Terra также отмечается, что при максимальном усилии в тесте Agents' Last Exam модель Terra использовала менее трети токенов по сравнению с Claude Opus 5.5. Еще важнее вывод Artificial Analysis о границе Парето: для GPT-6.1 Terra настройки усилия low и medium являются оптимальными по Парето с точки зрения соотношения интеллекта и стоимости. Увеличение усилия Terra до max повышает её балл с 41 до 48, что соответствует GPT-6.1 Sol при усилии medium — за исключением того, что Sol medium стоит $0.21 за задачу, в то время как Terra `max` стоит $0.40. Короче говоря, если вам нужна наиболее экономичная настройка на Terra, используйте low или medium; если задача достаточно сложна и требует усилия max, вам уже следует тестировать Sol или Sonnet 5.5.
Расчет стоимости: два реальных производственных сценария
Чтобы понять, где более дешевый тариф за токены действительно окупается, а где приводит к убыткам, давайте проведем точные расчеты по актуальным тарифам в каталоге GPT Proto ($0.80/$4.00 для Terra; $1.80/$9.00 для Sonnet 5.5), предполагая использование некэшированных запросов объемом менее 272 тыс. токенов.
Сценарий А — это цикл агента из 20 шагов для визуального QA и извлечения данных из форм. Каждый шаг отправляет скриншот и фрагмент DOM, что в сумме составляет 15 000 входных токенов, и генерирует 1 500 выходных токенов (включая средние токены рассуждения). За 20 шагов один рабочий процесс потребляет 300 000 входных токенов (0.3 млн) и 30 000 выходных токенов (0.03 млн):
GPT-6.1 Terra на GPT Proto: (0.3 * $0.80) + (0.03 * $4.00) = $0.24 + $0.12 = $0.36 за рабочий процесс.
Claude Sonnet 5.5 на GPT Proto: (0.3 * $1.80) + (0.03 * $9.00) = $0.54 + $0.27 = $0.81 за рабочий процесс.
При 10 000 рабочих процессов в месяц стоимость Terra составляет $3 600 против $8 100 у Sonnet — ежемесячная экономия $4 500. Даже если Terra не проходит валидацию в 20% случаев и требует перезапуска этих 2 000 процессов с нуля (добавляя $720), ваш общий счет составит $4 320, что все равно экономит $3 780 в месяц по сравнению с запуском Sonnet без повторных попыток.
Сценарий Б — это рефакторинг бэкенда с несколькими файлами в активном pull-запросе. Предположим, каждая попытка считывает 80 000 входных токенов и выдает 10 000 выходных токенов. Один чистый проход на Sonnet 5.5 стоит (0.08 * $1.80) + (0.01 * $9.00) = $0.234. Один проход на Terra стоит (0.08 * $0.80) + (0.01 * $4.00) = $0.104. Вы экономите 13 центов на API-запросе. Подвох в том, что если Terra пропустит зависимость типов между модулями — что соответствует ее разрыву в 50.3% против 70.6% в Terminal-Bench — и потребует трех повторных попыток плюс 12 минут времени старшего инженера по ставке $90/час ($18.00 трудозатрат), то эта экономия в 13 центов обойдется вашей команде в $18.18. Если коротко: Terra безоговорочно выигрывает в повторяющихся, проверяемых машиной циклах, в то время как Sonnet 5.5 окупает свой более высокий тариф каждый раз, когда неудачное редактирование требует времени на проверку человеком.
Контекстное окно (1,05 млн против 1 млн): почему превышение 272 тыс. токенов меняет всё
На бумаге сравнение контекстного окна GPT 6.1 Terra и Sonnet 5.5 выглядит как ничья с небольшим преимуществом OpenAI: Terra принимает 1 050 000 входных токенов и выдает до 128 000 выходных, в то время как Claude Sonnet 5.5 принимает 1 000 000 входных токенов и выдает до 128 000 выходных. Большинство сравнительных таблиц на этом заканчиваются.
Однако, если вы прочитаете документацию к модели OpenAI gpt-6.1-terra, то увидите порог тарификации на отметке 272 000 входных токенов, который полностью меняет экономику работы с длинным контекстом. Как только промпт превышает 272 тыс. входных токенов в GPT-6.1 Terra, OpenAI тарифицирует весь запрос — а не только токены сверх 272 тыс. — по двойной ставке за входные токены и кэш, и по ставке 1,5x за выходные токены.
Вот что происходит с официальным тарифом за миллион токенов в тот момент, когда ваш промпт переходит от 272 000 токенов к 272 001 токену:
| Диапазон контекста |
GPT-6.1 Terra (официальный тариф) |
Claude Sonnet 5.5 (официальный тариф) |
Соотношение цен на входные токены |
| Стандартный промпт (≤272 тыс. входных токенов) |
$1.00 вход / $5.00 выход / $0.05 чтение кэша |
$2.00 вход / $10.00 выход / $0.10 чтение кэша |
Terra дешевле на 50% по входу и выходу |
| Промпт с длинным контекстом (>272 тыс. до 1 млн+ входных токенов) |
$2.00 вход / $7.50 выход / $0.10 чтение кэша |
$2.00 вход / $10.00 выход / $0.10 чтение кэша |
Тарифы на вход и чтение кэша идентичны ($2.00 / $0.10) |
В отличие от более компактной модели Haiku 5.5 от Anthropic (которая применяет 5-кратную наценку после 100 тыс. токенов), Claude Sonnet 5.5 сохраняет фиксированную цену на всем своем контекстном окне в 1 000 000 токенов.
Давайте посчитаем стоимость аудита репозитория на 400 000 токенов, который генерирует 10 000 выходных токенов по официальным прайс-листам:
GPT-6.1 Terra (срабатывает правило >272 тыс. 2x/1.5x): (0,4 * $2.00) + (0,01 * $7.50) = $0.80 + $0.075 = $0.875.
Claude Sonnet 5.5 (фиксированная ставка): (0,4 * $2.00) + (0,01 * $10.00) = $0.80 + $0.10 = $0.900.
Как только ваш промпт превышает 272 тыс. токенов, 50% скидка Terra на входные данные полностью исчезает, оставляя общую разницу в $0.025 на вызове в 400 тыс. токенов. Моя рекомендация проста: никогда не отправляйте монолитные промпты объемом >272 тыс. токенов в GPT-6.1 Terra, ожидая экономии вдвое. Либо разбивайте/извлекайте контекст так, чтобы он был менее 272 тыс. токенов, чтобы Terra оставалась в своей категории $1.00 ($0.80 в GPT Proto), либо направляйте дампы репозиториев объемом 300–900 тыс. токенов напрямую в Claude Sonnet 5.5, где вы платите ту же официальную ставку за вход и получаете более глубокое понимание кода при работе с длинным контекстом. (Перед запуском промптов >272 тыс. токенов в продакшн через GPT Proto уточните в поддержке платформы, как корректировка уровня 272 тыс. токенов отражается на балансе вашего аккаунта.)
Бенчмарки и отзывы сообщества: программирование, фронтенд и агентские задачи
Сводные показатели часто скрывают реальные сильные стороны каждой модели. Согласно Artificial Analysis Intelligence Index v4.3.2, Claude Sonnet 5.5 (max, Default Fallback) набирает 56 баллов, GPT-6.1 Sol (max) — 52 балла, а GPT-6.1 Terra — 48 баллов при max усилиях и 41 балл при medium усилиях. (В снимке индекса от 3 ноября 2026 года, отображенном на карточке сравнения GPT Proto, Sonnet 5.5 показывает 54,2, а Terra max — 51, что дает меньший разрыв в 3,2 балла, который все еще в пользу Sonnet.) Чтобы принять практическое решение о маршрутизации для кода, фронтенд-интерфейсов или агентских циклов, нам необходимо разбить эти агрегированные данные по типам задач и сравнить их с тем, что разработчики сообщают на практике.
1. Бэкенд и программирование в терминале (GPT 6.1 Terra против Sonnet 5.5 в кодинге)
В области чистого программного инжиниринга через командную строку Anthropic по-прежнему сохраняет явное преимущество. Согласно Terminal-Bench 4.0, Anthropic сообщает о 70,6% для Claude Sonnet 5.5 (рост с 10,3% у Sonnet 5), в то время как OpenAI сообщает о 50,3% для GPT-6.1 Terra при максимальных усилиях (рост с 21,5% у GPT-5.6 Terra). В недавно выпущенном Artificial Analysis индексе агентов для кодинга v2.0 Terra набирает 48 баллов — это на 17 пунктов выше, чем у облегченной GPT-6 Luna (31), но на 6 пунктов ниже, чем у GPT-6.1 Sol (54). Artificial Analysis также отмечает, что для специализированных агентов по написанию кода настройки низких и сверхвысоких усилий Terra находятся на границе экономической эффективности, в то время как другие настройки усилий отстают.
Первые реальные тесты указывают на четкую границу между двумя моделями:
Список изменений в релизе GitHub Copilot от 26 октября 2026 года сообщил, что в ходе раннего внутреннего тестирования GPT-6.1 Terra решила заметно больше задач в терминале и на C#, чем GPT-5.6 Terra, добавив важное поведенческое наблюдение: «Она работает сфокусированными, консолидированными шагами над четко определенными задачами». GitHub не опубликовал точные проценты успешного выполнения в этой заметке, поэтому воспринимайте это как качественный вывод платформы, а не как контролируемый бенчмарк.
Что касается Claude, то ранний сравнительный тест разработчиков на r/ClaudeAI (выполнение десяти личных задач по программированию по три раза для каждой конфигурации при высоких усилиях в Claude Code и pi-agent) показал, что Sonnet 5.5 стабильно завершает реализацию за меньшее количество диалоговых шагов и с меньшим количеством выходных токенов, чем ее предшественник, во многом благодаря тому, что Sonnet 5.5 более агрессивно пакетно обрабатывает параллельные вызовы инструментов. Аналогично, в сторонней оценке CursorBench 4.0 от Cursor модель Sonnet 5.5 при высоких усилиях набрала 47,8% при стоимости $1,67 за задачу.
Вывод для бэкенд-разработчиков: если задача четко определена — написание метода сервиса на C#, добавление юнит-теста или исправление изолированного CLI-скрипта — Terra при низких или средних усилиях выполнит ее быстро и менее чем за половину стоимости в токенах. Если же задача требует отслеживания состояния в десяти файлах, где лишний цикл повторных попыток портит рабочий процесс, то 70,6% компетентности Sonnet 5.5 в терминале оправдывают более высокую цену. Там, где задействованы научные вычисления, OpenAI также сообщает, что в Terminal-Bench-Science 0.1 (например, написание кода для отслеживания деления клеток на видео с таймлапсом) Terra при максимальных усилиях фактически превосходит GPT-6.1 Sol и приближается к Claude Opus 5.5, отставая всего на пять пунктов при менее чем одной пятой от расчетной стоимости.
2. GPT-6.1 Terra против Sonnet 5.5 для фронтенд-разработки
Поиск GPT 6.1 Terra против Sonnet 5.5 для фронтенд-разработки заслуживает отдельного ответа, поскольку фронтенд-инжиниринг — это две разные задачи, объединенные вместе: визуальная верстка DOM и логика состояния/архитектуры.
Когда OpenAI представила результат GPT-6.1 Terra в 50,3% в Terminal-Bench 4.0, единственным конкретным примером программирования, который был выделен в анонсе, стала ошибка фронтенда: «исправление веб-страницы, макет которой смещается при загрузке» (Cumulative Layout Shift, или CLS). В то же время OpenAI сообщила, что в MMMU-Pro — бенчмарке для визуального мышления по диаграммам, скриншотам и плотным макетам — GPT-6.1 Terra превосходит GPT-5.6 Terra на всех уровнях сложности и почти сравнивается с передовыми GPT-6 Astra и GPT-6.1 Sol при значительно меньшей цене. В ветке обсуждения в день запуска на форуме OpenAI Developer Community одна из первых реакций разработчиков охарактеризовала Terra как «отличное соотношение цены и качества, особенно в том, что касается визуального понимания. В программировании тоже неплоха».
Такое разделение дает фронтенд-командам четкое распределение обязанностей:
Используйте GPT-6.1 Terra для визуальной работы и работы с UI-слоем фронтенда: превращение скриншотов Figma или вайрфреймов в начальную разметку Tailwind/HTML, сравнение отрендеренных скриншотов Playwright с дизайн-макетами для обнаружения перекрывающихся DOM-узлов или регрессий мобильных брейкпоинтов, а также диагностика смещений CSS-макета. Поскольку Terra обрабатывает изображения нативно, работает более чем в 3 раза быстрее, чем GPT-6.1 Sol и Astra в бенчмарках визуальных действий, и стоит $0.80/$4.00 на GPT Proto, ваш CI-пайплайн может позволить себе запускать проверки визуальной регрессии при каждом коммите.
Используйте Claude Sonnet 5.5 для фронтенд-архитектуры с высокой логической нагрузкой: рефакторинг сложных деревьев состояний React/Next.js server-action, разрешение запутанных ограничений дженериков TypeScript или миграция устаревшего хранилища Redux без нарушения гидратации. Когда нет скриншота для проверки, а сложность заключается исключительно в согласованности состояний между множеством файлов, Sonnet 5.5 остается более надежным инструментом.
3. Агентная работа, использование компьютера и фактическая точность (для агентной работы)
Если ваше определение GPT 6.1 Terra против Sonnet 5.5 для агентной работы сосредоточено на автоматизации графического интерфейса, анализе документов и использовании компьютера для бэк-офисных задач, то GPT-6.1 Terra, возможно, является самым сильным релизом OpenAI 2026 года с точки зрения соотношения цены и качества.
Согласно отчетам OpenAI по результатам тестирования Agents' Last Exam v1 (где проверяются многошаговые профессиональные рабочие процессы, такие как преобразование архитектурных чертежей в 3D-модель или регистрация таймкодов каждого кадра в анимационном фильме), GPT-6.1 Terra при средних усилиях набрала на 15 процентных пунктов больше, чем GPT-5.6 Terra, при стоимости примерно в одну треть, что соответствует показателям флагманской GPT-6 Astra при цене за токен в десять раз ниже. При максимальных усилиях, по данным OpenAI, Terra более чем в 3 раза эффективнее по токенам, чем Claude Opus 5.5, и стоит 1/4 от её цены за токен, что дает примерно 9-кратное снижение стоимости выполнения задачи при скорости работы в 3 раза выше, чем у GPT-6 Astra и GPT-6.1 Sol.
В тесте OSWorld 2.1 (управление настольными приложениями) OpenAI сообщает, что Terra при средних усилиях превосходит лучший результат GPT-5.6 Terra при значительно меньшей стоимости выполнения задачи. Для объективности стоит отметить, что опубликованный Anthropic результат OSWorld 2.1 (оффлайн) для Claude Sonnet 5.5 составляет очень высокие 83,9% (раскрыто в таблице бенчмарков Haiku 5.5 от Anthropic за октябрь 2026 года). Обе модели являются первоклассными движками для использования компьютера; разница в том, что агенты, использующие захват экрана, отправляют новый скриншот при каждом клике, что быстро расходует входные токены, поэтому тариф GPT Proto в $0.80/M для Terra гораздо проще поддерживать при масштабировании.
Не менее важно для автономных агентов — знать, когда модель не обладает информацией. В независимом бенчмарке Artificial Analysis AA-Omniscience уровень галлюцинаций GPT-6.1 Terra (как часто модель дает ответ наугад, не владея знаниями) снизился на 50 процентных пунктов — с 88% у GPT-5.6 Terra до 38% — при одновременном повышении общей точности на 2 пункта. Это независимое измерение подтверждает внутреннюю оценку фактической точности OpenAI (подробно описанную в системной карте GPT-6.1 Terra), где частота фактических ошибок при низких усилиях на сложных промптах упала с 53,6% до 16,7% (и до 4,3% при максимальных усилиях). Более низкий уровень галлюцинаций означает меньше ошибочных вызовов инструментов в дальнейшем.
Опыт разработчика и нюансы API (GPT 6.1 Terra против Sonnet 5.5 для разработчиков)
Переключение между gpt-6.1-terra и claude-sonnet-5-5 в продакшене редко сводится к простой замене строки. Если вы оцениваете эргономику GPT 6.1 Terra против Sonnet 5.5 для разработчиков, то ваша работа по интеграции будет зависеть от четырех ограничений на уровне API.
Во-первых, GPT-6.1 Terra поддерживает reasoning.effort: "none", в то время как GPT-6.1 Sol — нет. Когда OpenAI выпустила GPT-6.1 Sol 29 сентября 2026 года, она убрала уровни рассуждения none и minimal, принудительно переведя все запросы на уровень low или выше, что нарушило работу параметров temperature и top_p по всем направлениям. Согласно официальному руководству OpenAI по промптингу и миграции на gpt-6.1-terra, Terra поддерживает полный спектр: none, low, medium (по умолчанию), high, xhigh и max. Если вы установите reasoning_effort: "none", Terra будет работать без генерации скрытых токенов рассуждения и позволит использовать стандартные параметры выборки. Однако, как только вы используете low, medium, high, xhigh или max, вы должны удалить temperature, top_p, top_logprobs и logprobs из полезной нагрузки вашего запроса, иначе API отклонит вызов с ошибкой HTTP 400.
Во-вторых, OpenAI требует использования API Responses (/v1/responses) для вызова инструментов в GPT-6.1 Terra. Хотя обычные текстовые и графические промпты работают через /v1/chat/completions, в документации к моделям OpenAI прямо указано, что вызов инструментов требует /v1/responses. После перехода на API Responses, Terra поддерживает все девять встроенных инструментов OpenAI — поиск в интернете, поиск по файлам, генерация изображений, интерпретатор кода, размещенная оболочка (shell), apply_patch, навыки, компьютерное использование, MCP и поиск инструментов, — а также async: true для пользовательских инструментов, чтобы модель могла продолжать рассуждать, пока выполняется медленный фоновый инструмент. Кроме того, Terra поддерживает отправку элемента ввода configuration_update в середине диалога, чтобы повысить или понизить reasoning.effort на сложном этапе без перезаписи префикса промпта или аннулирования вашего 30-минутного кэша промптов (prompt_cache_options.ttl: "30m").
В-третьих, Claude Sonnet 5.5 имеет свои собственные строгие ловушки с ошибкой 400. Согласно руководству по миграции на Sonnet 5.5 от Anthropic, Sonnet 5.5 по умолчанию использует адаптивное мышление (с установкой high в API и medium в Claude Code, как отмечено в документации по конфигурации Claude Code от Anthropic). Если ваша старая интеграция Claude отправляет thinking: {"type": "disabled"}, вам необходимо обновить её до between_tools для минимальной настройки мышления. Что еще важнее, Sonnet 5.5 отклоняет принудительный выбор инструментов (tool_choice: {"type": "any"} или принудительно заданный инструмент) с ошибкой 400, когда активно адаптивное мышление; вам нужно использовать auto и направлять выбор инструмента в самом промпте. Вам также необходимо анализировать блоки контента ответа по type, а не предполагать, что content[0] — это текст, поскольку первый блок часто является блоком thinking.
В-четвертых, интеграция с IDE и CLI уже настроена для обоих вариантов. Обратите внимание, что в потребительских подписках примечания к выпуску OpenAI подтверждают, что GPT-6.1 Terra была развернута для ChatGPT Work и Codex (для планов Plus, Pro, Business, Enterprise и Edu), а не для стандартного интерфейса чат gpt, и она не поддерживает размещение данных в ОАЭ (хотя быстрый режим поддерживает размещение данных в ЕС). Для разработчиков, работающих в локальных терминалах, обе модели могут быть подключены к Claude Code и OpenAI Codex через GPT Proto. На странице модели GPT-6.1 Terra нажатие на Попробовать эту модель открывает панель быстрого запуска, где вы можете выбрать Claude Code или ChatGPT (Codex) в разделе Пусть ии завершит интеграцию или нажать Скопировать Markdown для ии, чтобы ваш помощник по программированию автоматически настроил переменные окружения.
Создание приложений: как использовать обе модели с одним API-ключом
Когда команды спрашивают о сравнении GPT 6.1 Terra и Sonnet 5.5 для создания приложений, лучшая архитектура — это почти никогда не выбор одной модели для 100% трафика. Поскольку обе модели работают через единый предоплаченный баланс в GPT Proto, вы можете маршрутизировать запросы по этапам, а не по вендору: отправляйте задачи по высокочастотной визуальной проверке, классификации скриншотов и исправлению UI в gpt-6.1-terra по цене $0.80/$4.00, а для сложного синтеза кода в нескольких файлах используйте claude-sonnet-5-5 по цене $1.80/$9.00.
1. Проверка через cURL (Chat Completions, совместимые с OpenAI)
Обе модели можно использовать для анализа текста и изображений через унифицированный эндпоинт GPT Proto /v1/chat/completions, совместимый с OpenAI, используя стандартный токен Bearer. Переключение между ними требует изменения только строки "model" :
# Вызов 1: GPT-6.1 Terra ($0.80 вход / $4.00 выход за 1 млн токенов в GPT Proto)
curl --fail-with-body https://gptproto.com/v1/chat/completions \
  -H "Authorization: Bearer $GPTPROTO_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "gpt-6.1-terra",
    "messages": [
      {
        "role": "user",
        "content": "Проанализируй это CSS-правило и объясни в двух предложениях, почему оно вызывает сдвиг макета на мобильных устройствах: .hero-banner { width: 100%; height: auto; }"
      }
    ]
  }'

# Вызов 2: Claude Sonnet 5.5 ($1.80 вход / $9.00 выход за 1 млн токенов в GPT Proto)
curl --fail-with-body https://gptproto.com/v1/chat/completions \
  -H "Authorization: Bearer $GPTPROTO_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "claude-sonnet-5-5",
    "messages": [
      {
        "role": "user",
        "content": "Напиши TypeScript-хелпер, который проверяет подписи вебхуков с помощью Web Crypto API с использованием сравнения за константное время."
      }
    ]
  }'
2. Пример Python-маршрутизатора для фронтенда и пайплайнов приложений
Вот практический шаблон на Python с использованием стандартного SDK openai, направленного на https://gptproto.com/v1. В этом рабочем процессе этап 1 использует gpt-6.1-terra для сортировки отчетов об ошибках UI (где объем токенов велик, а визуальная диагностика или диагностика DOM обходится дешево), а этап 2 динамически направляет задачу по исправлению кода либо в gpt-6.1-terra (для изолированных CSS-исправлений отдельных компонентов), либо в claude-sonnet-5-5 (когда сортировка выявляет изменения состояния в нескольких файлах или когда промпт приближается к лимиту в 272 тыс. токенов):
import os
import json
from openai import OpenAI

# Один API-ключ и общий баланс для моделей OpenAI и Anthropic
client = OpenAI(
    api_key=os.environ["GPTPROTO_API_KEY"],
    base_url="https://gptproto.com/v1",
)

def triage_and_patch_ui_issue(dom_snapshot: str, screenshot_url: str, approx_tokens: int) -> dict:
    # Шаг 1: Всегда выполняйте визуальную/DOM-триажировку на GPT-6.1 Terra ($0.80 / $4.00 за 1 млн токенов)
    triage_response = client.chat.completions.create(
        model="gpt-6.1-terra",
        messages=[
            {
                "role": "system",
                "content": (
                    "Вы — агент по триажировке фронтенда. Проанализируйте скриншот и DOM. "
                    "Верните JSON с ключами: 'root_cause', 'scope' ('isolated_css' или 'multi_file_state'), "
                    "и 'target_files' (массив строк)."
                ),
            },
            {
                "role": "user",
                "content": [
                    {"type": "text", "text": f"Снимок DOM: {dom_snapshot}"},
                    {"type": "image_url", "image_url": {"url": screenshot_url}},
                ],
            },
        ],
        response_format={"type": "json_object"},
    )

    triage_data = json.loads(triage_response.choices[0].message.content)

    # Шаг 2: Маршрутизация по области задачи И границе биллинга длинного контекста в 272 тыс. токенов
    # Если исправление затрагивает состояние нескольких файлов ИЛИ превышает 272 тыс. входных токенов, перенаправьте на Sonnet 5.5
    if triage_data.get("scope") == "multi_file_state" or approx_tokens > 272_000:
        selected_model = "claude-sonnet-5-5"
    else:
        selected_model = "gpt-6.1-terra"

    patch_response = client.chat.completions.create(
        model=selected_model,
        messages=[
            {
                "role": "user",
                "content": (
                    f"Диагноз триажировки: {json.dumps(triage_data)} | "
                    f"Создайте минимальный, готовый к продакшену патч для DOM/компонента: {dom_snapshot}"
                ),
            }
        ],
    )

    return {
        "triage": triage_data,
        "routed_to": selected_model,
        "patch": patch_response.choices[0].message.content,
    }

if __name__ == "__main__":
    sample_dom = "<div class='card-grid'><img src='/hero.webp' /><h2>Checkout</h2></div>"
    result = triage_and_patch_ui_issue(
        dom_snapshot=sample_dom,
        screenshot_url="https://example.com/cls-regression-frame.png",
        approx_tokens=12_000,
    )
    print(f"Патч направлен в: {result['routed_to']}")
    print(result["patch"])
Примечание перед развертыванием (требуется дымовое тестирование): Проверьте точные строки моделей (gpt-6.1-terra и claude-sonnet-5-5) в актуальных панелях использования API на страницах моделей GPT Proto перед запуском оплачиваемых циклов. Если ваш агент полагается на нативные инструменты Responses API от OpenAI (apply_patch, Hosted shell или вызовы функций async: true) или нативные параметры адаптивного мышления Anthropic /v1/messages (output_config.effort), выполните быструю дымовую проверку на соответствующих нативных эндпоинтах GPT Proto (/v1/responses и /v1/messages), чтобы подтвердить прохождение параметров по вашему маршруту.
Вердикт: что выбрать?
Если вам нужна сводная таблица для документа по архитектурному обзору, сопоставьте свою основную рабочую нагрузку с типом ошибок и моделью тарификации, которые для вас наиболее важны:
| Рабочая нагрузка / Сценарий |
Рекомендуемая модель |
Рекомендуемая настройка |
Почему это лучший выбор |
| Массовая QA-проверка скриншотов, чтение счетов/форм и работа с браузером |
GPT-6.1 Terra |
low или medium effort |
Тариф GPT Proto на 56% ниже ($0.80/$4.00), выполнение задач в 3 раза быстрее, чем у Sol/Astra, и уровень зрения MMMU-Pro, как у Astra. |
| Отладка фронтенд-интерфейса (сдвиги макета CLS, Figma-to-CSS, визуальные регрессии) |
GPT-6.1 Terra |
medium effort |
Создана для визуальной инспекции и анализа DOM; специально протестирована на исправлениях сдвига макета веб-страниц. |
Классификация с низкой задержкой, маршрутизация или извлечение JSON, где требуется temperature |
GPT-6.1 Terra |
reasoning.effort: "none" |
Возвращает уровень none без рассуждений, который был убран в GPT-6.1 Sol, минимизируя задержку и количество выходных токенов. |
| Рефакторинг бэкенда с множеством файлов и сложные изменения состояния TypeScript/React |
Claude Sonnet 5.5 |
medium или high effort |
70.6% против 50.3% в Terminal-Bench 4.0; объединяет вызовы инструментов в меньшее количество шагов, экономя дорогое время разработчика на проверку. |
| Анализ репозитория с длинным контекстом в одном запросе (от 300 тыс. до 900 тыс. входных токенов) |
Claude Sonnet 5.5 |
medium или high effort |
Terra применяет наценку 2x на вход / 1.5x на выход при превышении 272 тыс. токенов (цена возрастает до $2.00 за вход), что нивелирует её ценовое преимущество. |
Глубокое терминальное кодирование на базе OpenAI, когда Terra max не справляется |
GPT-6.1 Sol |
medium effort |
Набирает 54 балла против 48 у Terra в индексе AA Coding Agent Index v2.0, а Sol medium ($0.21/задача) фактически дешевле за задачу, чем Terra `max` ($0.40/задача). |
Подводя итог без лишних слов: начинайте каждый повторяющийся визуальный процесс, работу с компьютером и ограниченные задачи по кодингу на GPT-6.1 Terra с настройкой low или medium effort, чтобы воспользоваться тарифом $0.80/$4.00. Используйте Claude Sonnet 5.5 для задач по кодингу с множеством файлов и промптов объемом более 272 тыс. токенов, где её более высокая точность с первого прохода и фиксированная цена за 1 млн токенов контекста окупают себя. Чтобы подставить свои ежемесячные объемы входных и выходных данных, откройте калькулятор сравнения GPT Proto и протестируйте обе модели бок о бок на одном балансе.