Краткий обзор Kimi K3.1 Pro и Opus 5.5
| Параметр |
Kimi K3.1 Pro |
Claude Opus 5.5 |
| Официальная цена за 1 млн токенов (вход/выход) |
$2 / $10 |
$4 / $20 |
| Цена GPT Proto за 1 млн токенов (вход/выход) |
$2 / $10 |
$3.60 / $18 |
| Контекстное окно |
Около 1 млн токенов |
1 млн токенов |
| Вход / выход модели |
Текст и изображения / текст |
Текст и изображения / текст |
| Уровень рассуждения API по умолчанию |
Максимальный |
Средний |
| Рекомендуемый сценарий для первого теста |
Ограниченные задачи с четкими критериями проверки |
Сложная разработка и финальная проверка |
Цены актуальны на 29 октября 2026 года. Официальные спецификации взяты из документации API Kimi и документации моделей Claude. Тарифы GPT Proto указаны на странице API Kimi K3.1 Pro и странице API Claude Opus 5.5. Операции кэширования и другие применимые сборы требуют отдельного учета.
Для быстрого сравнения каталогов используйте страницу сравнения Kimi K3.1 Pro и Claude Opus 5.5. Подробности о данном релизе Kimi см. в разделе что изменилось в Kimi K3.1 Pro.
Что бенчмарки говорят о программировании и что они упускают
В опубликованном сравнении запуска от Moonshot сообщается о результатах 65,7% для Kimi K3.1 Pro и 66,4% для Opus 5.5 в Terminal-Bench 4.0. Это данные, опубликованные поставщиком, ожидающие независимой проверки конкретного сравнения. Они подтверждают, что Kimi стоит рассматривать для работы в терминале, однако не гарантируют равную производительность при разработке приложений.
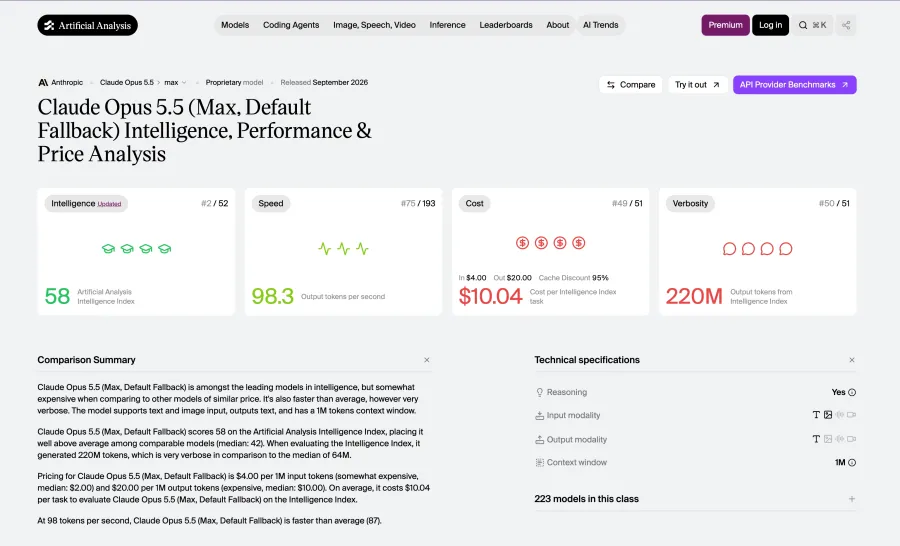
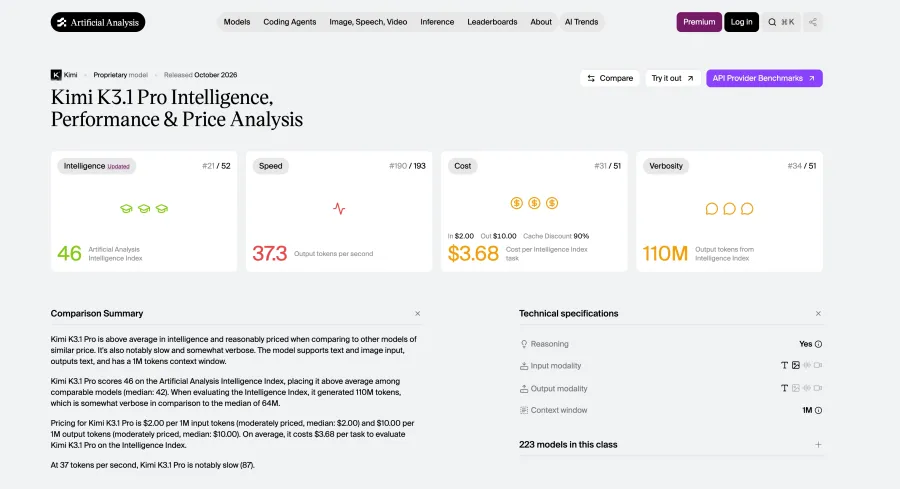
Более широкая независимая картина выглядит иначе. На 29 октября страницы моделей в Artificial Analysis Intelligence Index v5.0 показывали Kimi на отметке 46 и Opus на отметке 58, причем последняя модель была помечена как Max с резервным вариантом по умолчанию. Эти индексные баллы не являются процентами или показателем успешности написания кода. Учитывайте версию индекса и конфигурацию при сравнении.
Я бы рассматривал Opus как базовый стандарт качества для требовательных задач, а затем проверял, соответствует ли Kimi тем же критериям приемки при меньших затратах. Терминальный бенчмарк не покажет, сохраняет ли форма бронирования свое состояние или остается ли дашборд читаемым на мобильных устройствах. Ответы на эти вопросы дадут только ваши прикладные тесты.
Фронтенд-разработка: от скриншота до работающего интерфейса
Для задачи «скриншот в интерфейс» разделяйте внешний вид и функциональность. Качественная верстка все равно требует работающей навигации, состояний форм, доступа с клавиатуры и удобной мобильной версии. Затем попросите внести изменения. Добавление фильтра без нарушения существующей верстки — это тест, отличный от генерации страницы с нуля.
Здесь есть полезный пример для разработчиков. В опубликованном сравнении Melvynx он отдал предпочтение визуальной реализации тайм-зоны от Opus. Это эстетическая оценка конкретной сборки, а не измеренный показатель успешности фронтенд-задач.
Для маркетингового сайта или клиентского дашборда моим первым выбором будет Opus, когда дизайн требует индивидуальности и многократной доработки. Kimi — разумный кандидат для внутреннего интерфейса с четкой дизайн-системой, особенно если вы можете проверить результат перед релизом. Компромисс заключается во времени, затраченном на исправление того, что осталось недоработанным после первоначального промпта.
Рассмотрите интерфейс бронирования в качестве оценочного задания. Дайте обеим моделям одно и то же эталонное изображение, существующую библиотеку компонентов и требования к выбору даты, недоступным слотам, валидации и подтверждению. Попросите каждую подключить интерфейс к одному и тому же мок-API. Затем имитируйте сбой запроса и проверьте, сможет ли пользователь восстановить данные, не потеряв заполненную форму.
Этот последний шаг превращает задачу в сравнение приложений. Он показывает, справляется ли привлекательная страница с последующими действиями пользователя.
Интерактивные приложения и 3D: визуальное качество, логика и производительность
Кейс Kimi становится более интересным в задачах с интерактивной визуализацией. Пример с лавовой лампой от Melvynx включал управление освещением и цветом. Он оценил результат Opus как более качественный, при этом отметив, что материалы и эффекты стекла у Kimi выглядят убедительно. Сообщаемые им затраты на выполнение составили $2.30 для Kimi High и $4.16 для Max, против $4.35 для Opus Medium и $6.39 для Extra High.
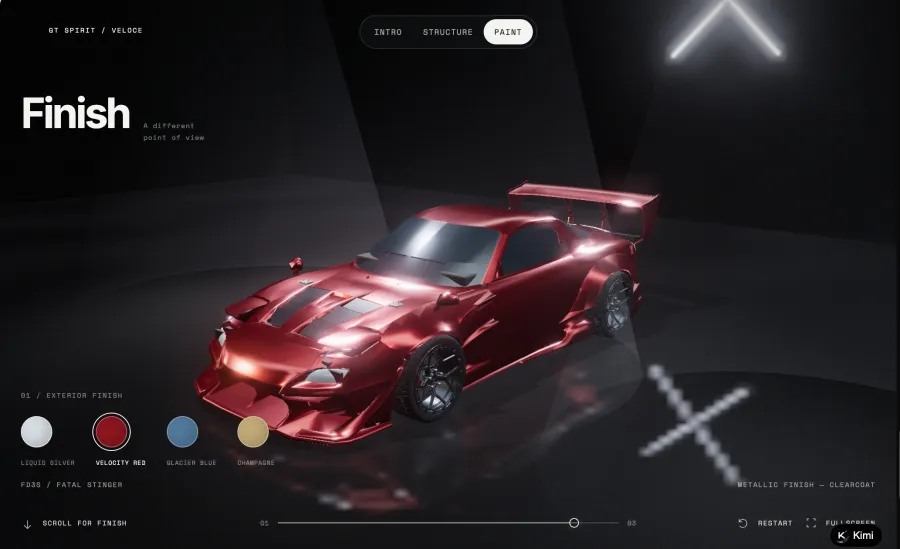
В том же обзоре описывается симуляция сбоя, которая сработала лучше на Kimi High, чем на Max. Автор раскрывает наличие партнерской ссылки на Kimi и использование общего, неизолированного рабочего пространства. Эти примеры являются полезными наблюдениями с учетом указанных ограничений.
На мой взгляд, Kimi стоит протестировать для конфигураторов продуктов, образовательных демо и визуальных прототипов. Автоматический выбор настройки с более высокими усилиями заставил бы упустить один из практических уроков этих примеров. Начните с четкого требования и проверьте полученный артефакт.
Для конфигуратора мебели определите, что должно меняться, когда пользователь выбирает материал, переключает вид камеры или сбрасывает дизайн. Проверьте, соответствует ли отображаемая цена выбранным параметрам. Перезагрузите страницу. Попробуйте элементы управления на телефоне. Визуально привлекательный стул — это лишь часть результата.
Техническая точность требует отдельных проверок. Результаты BenchCAD от Moonshot показывают 92.7% для Kimi и 96.2% для Opus с использованием инструментов, основанных на метрике геометрической реконструкции. Этот опубликованный вендором результат отвечает на вопрос, отличный от того, насколько привлекательно выглядит сцена. Убедительная анимация все равно требует отдельной валидации, прежде чем вы начнете использовать ее для обучения физике или демонстрации инженерного процесса.
Для прототипа я бы сначала попробовал Kimi. Для приложений, чувствительных к точности, я бы начал с Opus и потребовал проведения проверок, специфичных для предметной области, независимо от того, какая модель генерирует код.
Развитие агентов: может ли нейросеть выполнить многошаговую задачу?
Агент, работающий в репозитории, должен понимать текущее поведение кода, выбирать файлы для изменений, запускать инструменты, интерпретировать ошибки и принимать решение, когда остановиться. Ошибки могут накапливаться на каждом из этих этапов.
Оба вендора публикуют примеры расширенной работы. Moonshot описывает, как Kimi диагностирует и исправляет симулятор перед переобучением контроллера ходьбы. В отчете о запуске Opus 5.5 от Anthropic описываются улучшения веб-приложения, включая задачу по времени загрузки, которая была успешно выполнена в 39 из 40 попыток. Это отдельные примеры от вендоров, а не результаты независимого прямого тестирования.
Для существующего приложения для выставления счетов полезным сравнением было бы добавление импорта CSV. Это требует сопоставления полей, обработки неверных строк, обнаружения дубликатов, предварительного просмотра и тестов, покрывающих текущий функционал. Пусть каждая нейросеть работает с одним и тем же снимком репозитория, после чего проверьте оба патча. Резюме «все тесты пройдены» должно подкрепляться логом тестирования.
Для такого рода изменений в нескольких файлах Opus был бы моим выбором по умолчанию. Kimi проще оценивать на ограниченной части работы, например, при реализации валидации по согласованной схеме. Расширяйте область его задач после того, как тесты подтвердят, что он справляется с окружающим кодом приложения.
Конфигурация также имеет значение. Руководство Kimi по использованию инструментов требует сохранения полного сообщения ассистента на всех этапах. Документация Opus от Claude описывает специфическое для модели «мышление» и поведение инструментов. Проверьте эти детали для выбранного вами пути; соответствие базовому формату запроса не гарантирует идентичное поведение агента.
Ценообразование и стоимость: во сколько на самом деле обходится принятый результат?
У Kimi K3.1 Pro более низкие стандартные тарифы на входные и выходные токены. Более сложный вопрос заключается в том, сколько вызовов, повторных попыток и циклов проверки потребуется для вашей задачи.
Ниже приведен пример планирования с использованием тарифов GPT Proto. Предположим, что каждая попытка использует 1 млн некэшированных входных токенов и 200 000 оплачиваемых выходных токенов. Это гипотетические объемы, а не реальные результаты работы приложения.
| Сценарий планирования |
Kimi K3.1 Pro |
Claude Opus 5.5 |
| Одна попытка при указанных объемах |
$4.00 |
$7.20 |
| Две попытки при тех же объемах |
$8.00 |
$14.40 |
Исходя из этих предположений, результат Kimi, требующий двух попыток, стоит дороже в токенах, чем результат Opus, принятый с первого раза. Реальные повторные попытки редко повторяют точно такие же объемы токенов, поэтому используйте свои записи об использовании для фактического расчета.
Кэширование снова меняет сравнение. Оба вендора указывают официальную стоимость чтения из кэша в размере $0.20 за 1 млн токенов в своей документации по Kimi и Claude. Длительная сессия агента с частыми попаданиями в кэш будет иметь иное соотношение затрат, чем новый запрос. Также проверьте расходы на запись в кэш, использование выходных данных и фактические тарифы вашего провайдера.
Для команды я бы отслеживал стоимость одной принятой задачи наряду с затраченным временем и минутами работы рецензента. Более дешевый черновик может быть выгодным, если его проверка проходит быстро. Он становится менее привлекательным, когда разработчику приходится восстанавливать то, что изменил агент, прежде чем довериться результату.
Как самостоятельно сравнить обе модели в вашем приложении через GPT Proto
Используйте небольшое изменение в приложении с наблюдаемыми результатами. Форма бронирования, импортер CSV или конфигуратор продуктов дадут вам больше полезных доказательств, чем общий запрос «создать что-то впечатляющее».
Откройте страницу модели Kimi и страницу модели Opus. Используйте «Попробовать эту модель» (Try this model) и «Быстрый старт» (Quick Start), чтобы получить руководство по интеграции, затем скопируйте инструкции в формате Markdown в ваш помощник по программированию. Храните свой API-ключ в локальной переменной окружения или конфигурации на стороне сервера.
Перед оценкой качества разработки проверьте, отвечают ли оба маршрута модели. Этот пример подключения соответствует формату Chat Completions, опубликованному на страницах моделей. Установите GPTPROTO_API_KEY локально перед запуском; запросы расходуют платные токены.
for model in kimi-k3.1-pro claude-opus-5-5; do
  curl --fail-with-body --silent --show-error --max-time 180 \
    https://gptproto.com/v1/chat/completions \
    -H "Authorization: Bearer $GPTPROTO_API_KEY" \
    -H "Content-Type: application/json" \
    --data "{
      \"model\": \"$model\",
      \"messages\": [{\"role\": \"user\",
        \"content\": \"Return only: API connection OK\"}]
    }"
done
Это проверяет подключение, а не качество кода. У нативных API разные настройки рассуждений по умолчанию; настройте и запишите поддерживаемые параметры усилий перед сравнением приложений. Ответ API также требует наличия агента или приложения для редактирования файлов, выполнения инструментов и проверки браузера.
Для пробной разработки запускайте каждую модель с чистой копии одного и того же проекта. Предоставьте ту же задачу, разрешения, зависимости и приемочные тесты. Записывайте маршрут модели, затраченные усилия, оплаченное использование, время завершения и необходимые ручные изменения. Повторите задачу, прежде чем делать небольшое различие стандартом для вашего продакшена.
Если эндпоинт возвращает ошибку аутентификации, проверьте ключ и заголовок авторизации. Если необязательный параметр отклоняется, сравните его с текущим руководством на странице модели. Убедитесь, что успешный ответ содержит ожидаемый вывод модели, прежде чем расширять задачу.
Какую модель выбрать?
| Ваша задача |
Мой выбор для начала |
Условие для сохранения выбора |
| Frontend для клиентов с частыми правками дизайна |
Opus 5.5 |
Более качественный результат оправдывает стоимость |
| Интерактивный прототип или визуальный эксперимент |
Kimi K3.1 Pro |
Элементы управления работают, а артефакт легко проверить |
| Сложные изменения в существующем приложении |
Opus 5.5 |
Тесты репозитория и ревью подтверждают выбор |
| Повторяющаяся реализация по фиксированной спецификации |
Kimi K3.1 Pro |
Автоматизированные проверки снижают затраты на исправления |
| Код или симуляция, требующие высокой точности |
Opus в качестве базовой модели |
Для любой модели требуется внешняя проверка |
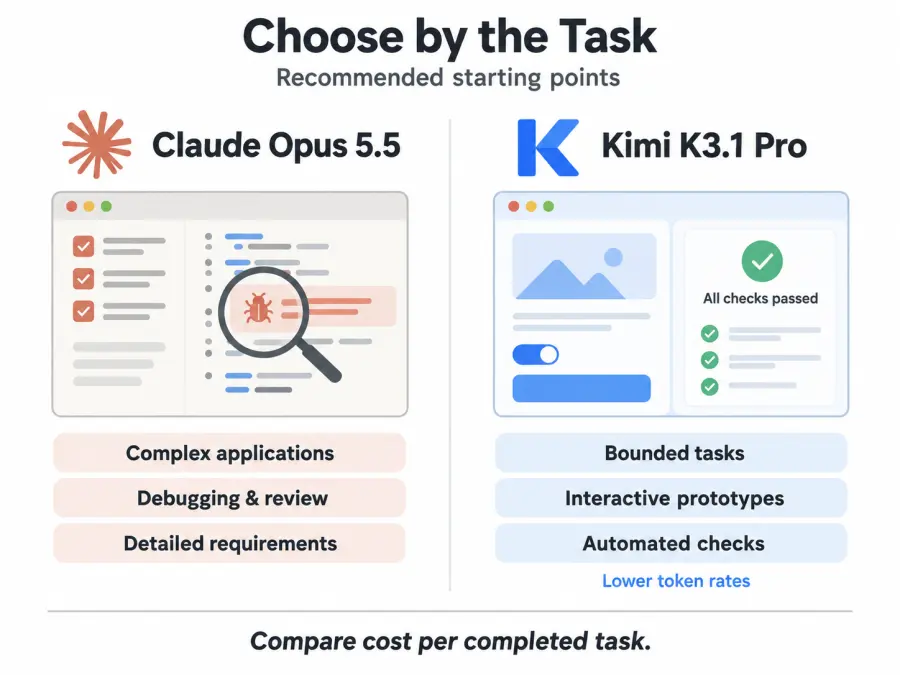
Я бы выбрал Opus 5.5 в качестве начального варианта по умолчанию для команды, которая передает агенту значительный объем работы над приложением. Обширные данные тестирования подтверждают, что с этого стоит начать, а реальный репозиторий покажет, оправдывает ли себя премиальная модель.
Kimi K3.1 Pro — практичный кандидат для снижения затрат на четко определенные задачи. Начните с задач, которые вы можете проверить или протестировать, оцените принятые результаты и постепенно расширяйте полномочия модели по мере накопления данных. Это более веская причина для перехода, чем почти равные показатели в одном бенчмарке.
Попробуйте выполнить небольшую задачу на страницах API Kimi K3.1 Pro и API Claude Opus 5.5, используйте руководства по интеграции и сравните результат, который подходит для вашего приложения.