Лучшие доступные LLM API для агентов: краткий обзор
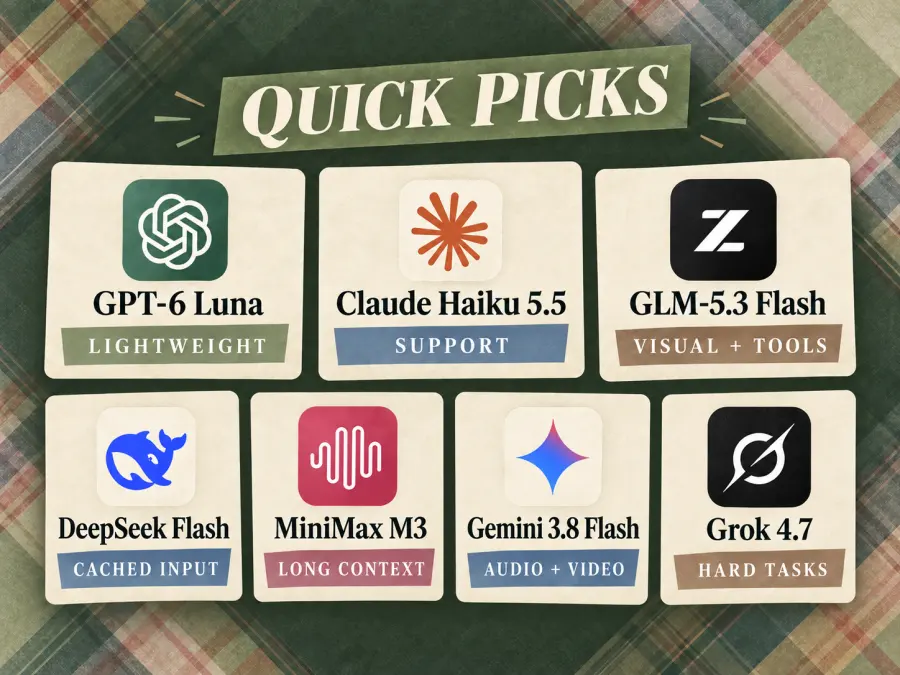
Этот список группирует модели по задачам, для которых их стоит протестировать. Это редакционная подборка, основанная на опубликованных возможностях и ценах, а не частный рейтинг производительности.
| Модель |
Строка модели GPT Proto |
Опубликованная стоимость GPT Proto (вход/выход) за 1 млн токенов |
Первая задача для тестирования |
| GPT-6 Luna |
gpt-6-luna |
$0.08 / $0.40 |
Классификация, извлечение данных и маршрутизация |
| Claude Haiku 5.5 |
См. раздел «Быстрый старт» на странице модели |
$0.09 / $0.45 для промптов ≤100 тыс. токенов |
Повторяющиеся задачи поддержки и подзадачи программирования |
| GLM-5.3 Flash |
glm-5.3-flash |
$0.15 / $0.50 |
Визуальные и инструментальные рабочие процессы |
| DeepSeek Flash |
deepseek-flash |
$0.30 / $1.20 |
Повторяющиеся инструкции и вводы с активным кэшированием |
| MiniMax M3 |
MiniMax-M3 |
$0.48 / $0.96 |
Длинные документы и исследовательские сессии |
| Gemini 3.8 Flash |
gemini-3.8-flash |
$0.90 / $4.50 |
Рабочие процессы с аудио, видео, изображениями и PDF |
| Grok 4.7 |
grok-4.7 |
$1.20 / $3.60 |
Сложное программирование и многоэтапная эскалация |
Тарифы проверены или подтверждены 8 октября 2026 г. Это тарифы GPT Proto, а не прямые промо-цены провайдеров. Haiku 5.5 стоит $0.45 за вход и $2.25 за выход на миллион токенов для промптов объемом более 100 тыс. токенов. Перед планированием бюджета уточните применимый уровень контекста, расходы на кэширование, уровень обслуживания и актуальную цену на странице каждой модели.
Сравните перед выбором: Ознакомьтесь с доступными моделями ИИ в GPT Proto и сохраняйте ID моделей из шорт-листа в конфигурации, чтобы вы могли переключаться между ними без пересборки всего агента.
Как мы ранжировали эти доступные LLM для агентного ИИ
Саймон Уиллисон предлагает полезное рабочее определение: агент LLM запускает инструменты в цикле для достижения цели. Этот цикл меняет подход к оценке доступности. Обычное сравнение чат-ботов может фокусироваться на стоимости одного ответа; сравнение агентов должно также учитывать вызовы инструментов, результаты инструментов, повторные попытки, токены рассуждения и неудачные запуски.
Мы использовали следующий порядок оценки.
1. Модель должна пройти проверку на агентные возможности
Модель не включалась в список только из-за низкой цены за токен. Каждый вариант из шорт-листа должен был иметь документированный путь для вызова функций или использования инструментов, а также удобный способ возврата структурированных данных или продолжения многоходового рабочего процесса.
2. Публичные доказательства работы агентов важнее, чем оценка общих знаний
Таблица лидеров Berkeley Function Calling Leaderboard особенно полезна для понимания того, что должна оценивать система вызова инструментов: правильный выбор функции, корректность аргументов, поведение в многоходовых диалогах и случаи, когда модель должна воздержаться от вызова инструмента. Однако её публичный рейтинг в последний раз обновлялся 12 апреля 2026 года, что предшествует появлению большинства моделей в этой статье. Поэтому мы используем их методологию, а не присваиваем старые оценки новым релизам.
Мы также ссылаемся на Artificial Analysis. Их индекс интеллекта (Intelligence Index) включает оценку агентской работы, реальных задач, автоматизации SaaS, использования терминала и работы с длинным контекстом. Это смешанный индекс — не чисто оценка вызова функций — и его следует рассматривать как предварительный показатель, а не как гарантию эффективности для конкретного агента.
3. Стоимость успешного выполнения задачи важнее цены за токен
Полезная метрика для продакшена выглядит так:
Стоимость успешной задачи = Общая стоимость API всех попыток и повторов / Количество принятых выполненных задач
Этот расчет должен включать некэшированный ввод, кэшированный ввод, вывод, скрытые или оплачиваемые токены рассуждений (где применимо), неудачные попытки и вызовы для восстановления. Если одна модель выполняет 90 задач из 100, а другая — 60, сравнение только их базовых тарифов за токены скрывает стоимость исправления оставшихся 40 задач.
4. Скорость, многословность и сложности интеграции влияют на стоимость
Количество выходных токенов в секунду измеряет только фазу генерации. Они не учитывают время до первого ответа, внутренние рассуждения, выполнение инструментов, задержки из-за ограничений частоты запросов или повторные вызовы. Слишком «многословная» модель также может превратить низкую цену за выходной токен в большой итоговый счет.
Наконец, у похожих API всё ещё есть свои специфические правила. Поля для рассуждений, неподдерживаемые параметры сэмплирования, ID ответов функций и регистр в названиях моделей могут нарушить работу даже самого переносимого процесса. Именно поэтому для каждой записи указана точная строка модели GPT Proto.
1. GPT-6 Luna — Лучший выбор для легких и высоконагруженных шагов агентов
GPT-6 Luna — наш первый выбор для частых, ограниченных по объему запросов: классификация тикетов, извлечение атрибутов продукта, выбор рабочего процесса или обобщение результатов работы инструментов. GPT Proto указывает цену $0.08 за миллион входных токенов и $0.40 за миллион выходных токенов, что является самыми низкими тарифами на ввод и вывод в этом списке.
Модель принимает текст и изображения, поддерживает структурированный вывод и предлагает контекстное окно размером 1,05 млн токенов. Регулируемое рассуждение (reasoning) позволяет разработчикам тестировать, сколько усилий требуется для выполнения задачи. Простое решение по маршрутизации редко требует такой же конфигурации, как неоднозначная задача по программированию.
Перед использованием модели в качестве контроллера вызова инструментов следует учесть одну деталь совместимости. OpenAI документирует вызов функций с поддержкой рассуждений через Responses; Chat Completions поддерживает вызов функций только с параметром reasoning_effort: "none". Используйте функцию Try this model (Быстрый старт) на странице модели в GPT Proto, чтобы проверить маршрут и поддерживаемые поля.
Роль Luna — быть недорогим первым уровнем. Она может обрабатывать рутинные шаги, в то время как более мощная модель берет управление на себя после явного сбоя или сигнала о сложности задачи. Низкая стоимость токенов полезна только в том случае, если эти первые шаги остаются точными. Чтобы подробнее изучить этот компромисс, сравните GPT-6 Luna и GPT-6 Sol для задач программирования и работы агентов.
Выбирайте GPT-6 Luna, если:
рабочий процесс содержит большие объемы классификации, извлечения данных или суммаризации;
каждый шаг имеет четкую схему и результат, который ваше приложение может проверить;
вам нужна недорогая базовая модель для существующего приложения, совместимого с OpenAI;
сложные случаи можно передать на более высокий уровень вместо бесконечных повторных попыток.
Обратите внимание на: поддержку инструментов, специфичных для эндпоинта, и повторяющиеся ошибки валидации. Используйте Luna для ограниченных задач; для сложного планирования и восстановления после ошибок оценивайте более мощную модель.
2. Claude Haiku 5.5 — Лучший выбор для недорогой поддержки и агентских задач Claude
Claude Haiku 5.5 — это мощная альтернатива для повторяющихся задач поддержки, суммаризации диалогов, классификации и небольших задач по программированию. Выпущенная 7 октября 2026 года, модель предлагает регулируемый уровень усилий для линейки Haiku и может выступать в качестве более экономичного исполнителя в рабочих процессах, где также используются более крупные модели Claude.
GPT Proto предлагает Haiku 5.5 по цене на 10% ниже официальных тарифов. Для запросов с объемом входных токенов до 100 тыс. это означает $0,09 за миллион входных токенов и $0,45 за миллион выходных токенов. При превышении 100 тыс. входных токенов соответствующие тарифы составляют $0,45 за входные и $2,25 за выходные токены.
Этот порог важнее, чем максимальное окно контекста. Haiku поддерживает 1 млн токенов контекста, но растущий диалог может перейти в более дорогой ценовой сегмент задолго до достижения этого объема. Порог применяется к входным данным каждого запроса, включая сохраненную историю диалога и результаты работы инструментов.
Адаптивное мышление включено по умолчанию, при этом уровень усилий определяет, сколько ресурсов модель тратит на задачу. Начните с простых запросов и сравните качество выполнения, задержку и количество оплачиваемых токенов, прежде чем увеличивать уровень усилий.
Выбирайте Claude Haiku 5.5, если:
агент обрабатывает повторяющиеся вопросы поддержки или занимается сортировкой тикетов;
суммаризация и сжатие состояния диалога являются частыми этапами рабочего процесса;
рабочему процессу программирования на базе Claude требуется помощь в выполнении узкоспециализированных подзадач;
большинство запросов укладываются в нижний ценовой сегмент по длине промпта.
Обратите внимание: на запросы, превышающие 100 тыс. входных токенов. Держите повторно используемое состояние компактным и проверяйте полную стоимость запроса, особенно в длинных диалогах.
3. GLM-5.3 Flash — Лучший выбор для недорогих визуальных и инструментальных агентов
GLM-5.3 Flash остается одним из наиболее полезных кандидатов для рабочих процессов, сочетающих визуальные данные с внешними инструментами. Опубликованные тарифы GPT Proto для нее составляют $0,15 за миллион входных токенов и $0,50 за миллион выходных токенов.
Z.ai поддерживает нативный ввод текста, изображений, видео и файлов, а также окно контекста в 1 млн токенов. Вызов функций, структурированный JSON, кэширование, потоковая передача и потоковые аргументы инструментов делают модель актуальной для агентов, которые анализируют документы или интерфейсы, а затем предпринимают дальнейшие действия.
Практический пример — рабочий процесс визуального контроля качества: осмотр скриншота, выявление проблемы с версткой, предложение изменений в коде и проверка отрендеренного результата с помощью инструментов приложения. Модель предоставляет решения и аргументы; агент обеспечивает работу браузера, выполнение кода и верификацию.
Главный компромисс — постоянно активное рассуждение. Это может помочь при принятии неоднозначных решений, но создает дополнительные расходы при простой маркировке или извлечении данных. GPT-6 Luna и Haiku 5.5 имеют более низкие тарифы на короткие запросы в этом списке.
Выбирайте GLM-5.3 Flash, если:
скриншоты, графики, документы или видеоданные влияют на следующее действие;
рабочий процесс требует вызова инструментов и структурированных результатов;
визуальное программирование или итеративные проверки интерфейса являются частью задачи;
открытые веса полезны наряду с доступом через API.
Обратите внимание: на рассуждения и объем вывода. Установите лимиты на генерируемые токены и шаги рабочего процесса; название «Flash» не гарантирует минимальную задержку от начала до конца.
4. DeepSeek Flash — лучший выбор для агентов с интенсивным вводом и кэшированием
DeepSeek Flash — это название маршрута для DeepSeek V4.1 Flash. Используйте deepseek-flash в запросе, а не рассматривайте версию как отдельный уровень API. Указанные в GPT Proto тарифы на ввод/вывод составляют $0.30 / $1.20 за миллион токенов.
Модель поддерживает ввод текста и изображений, контекстное окно до 1 млн токенов, вызов инструментов, вывод в формате JSON, потоковую передачу, а также работу в режиме «мышления» (thinking) или обычном режиме. Такая комбинация подходит для агентов, которые многократно считывают файлы репозитория, инструкции, документы или историю инструментов перед генерацией сравнительно небольшого результата.
Кэширование — главная причина включить эту модель в список для задач с интенсивным вводом. Стабильные инструкции и определения инструментов могут использоваться повторно во многих вызовах, но экономия зависит от реальных попаданий в кэш. Длинный промпт, который существенно меняется на каждом шаге, следует оценивать иначе.
Обработка состояния также требует внимания. В рабочих процессах с использованием инструментов в режиме «мышления» состояние рассуждений может потребоваться сохранять между вызовами. Проверьте, как выбранная конечная точка GPT Proto представляет это состояние, прежде чем переносить цикл с несколькими итерациями. Успешный первый ответ не гарантирует, что весь диалог останется совместимым.
Выбирайте DeepSeek Flash, если:
повторяющиеся инструкции или справочные материалы делают кэширование полезным;
анализ репозитория или документов составляет основной объем входных данных;
рабочий процесс выигрывает от переключения между режимами «мышления» и обычным режимом;
в одной задаче необходимо использовать изображения вместе с текстом.
Обратите внимание на: промахи кэша, слишком подробный вывод и потерю состояния вызова инструментов. Измеряйте полный цикл работы, а не оценивайте экономию только по коэффициенту кэширования.
5. MiniMax M3 — лучший выбор для агентов, работающих с длинными документами и исследованиями
MiniMax M3 стоит рассмотреть, если агенту необходимо обрабатывать большие объемы документов или длинную историю работы. На GPT Proto идентификатор модели — MiniMax-M3, а заявленные тарифы составляют $0.48 за миллион входных токенов и $0.96 за миллион выходных токенов.
Модель поддерживает использование инструментов, работу с длинным контекстом, кодинг и агентские рабочие процессы, предлагая контекстное окно объемом около 1 млн токенов. Ее роль здесь — работа с большими объемами документации: сравнение политик, анализ истории обращений, отслеживание связей между справочными файлами или сохранение промежуточных результатов исследований.
Ценовой компромисс требует пояснения. Текущие прямые тарифы MiniMax для промптов до 512 тыс. входных токенов составляют $0.30 за вход и $1.20 за выход на миллион токенов. При таких расценках у GPT Proto ниже стоимость вывода, в то время как при прямом обращении ниже стоимость ввода. Ни один из базовых тарифов не гарантирует более низкий счет для любой рабочей нагрузки.
Большое контекстное окно также не заменяет поиск или проверку данных. Загрузка в агента целого архива может увеличить расходы, не помогая ему найти нужные доказательства.
Выбирайте MiniMax M3, если:
задача зависит от нескольких документов или длительной истории работы;
агенту необходимо сохранять промежуточные выводы на протяжении нескольких этапов;
создание отчетов или пояснений делает стоимость вывода значимым фактором;
вы хотите оценить модель с открытыми весами через хостинг-доступ.
Обратите внимание на: высокие накопленные расходы на ввод и риск пропуска важных данных в длинных документах. Протестируйте рассуждения по нескольким документам и уточните возможности ввода для выбранного маршрута.
6. Gemini 3.8 Flash — лучший выбор для агентов, работающих с аудио, видео и мультимедиа
Gemini 3.8 Flash занимает свое место, когда задача включает аудио, видео, изображения или PDF-файлы наряду с текстом. GPT Proto предлагает тарифы $0.90 за миллион входных токенов и $4.50 за миллион выходных токенов для маршрута gemini-3.8-flash
Модель имеет контекстное окно около 1 млн токенов, настраиваемое мышление, вызов функций и структурированный вывод. Это практичный кандидат для рабочего процесса, который анализирует видео клиента, читает сопроводительный документ и подготавливает следующее действие в приложении.
Ее ценность заключается в работе, которую могут заменить эти входные данные. Агенту, понимающему несколько типов медиа, может потребоваться меньше отдельных этапов обработки. Проверьте поддерживаемые форматы файлов и сопоставление запросов на маршруте GPT Proto, прежде чем предполагать, что доступна вся экосистема инструментов исходной модели.
Это не самый дешевый вариант по стоимости токенов. Вводные тарифы Google составляют $0.75 за ввод и $3.75 за вывод на миллион токенов до 31 декабря 2026 года, что ниже текущих тарифов GPT Proto. Причина использовать этот маршрут — доступ к модели наряду с другими через одну учетную запись и баланс.
Выбирайте Gemini 3.8 Flash, если:
аудио или видео являются ключевыми для задачи;
один и тот же рабочий процесс должен проверять несколько типов медиа;
мультимодальная модель может упростить отдельные этапы предварительной обработки;
настраиваемое мышление полезно как для рутинных, так и для сложных запросов.
Обратите внимание на: стоимость вывода и поддержку инструментов конкретного провайдера. Проводите бенчмаркинг готового рабочего процесса, а не полагайтесь только на показатель скорости генерации.
7. Grok 4.7 — Лучший выбор для сложного программирования и многоэтапной эскалации
Grok 4.7 — это вариант для эскалации в данном списке. Он уже представлен на GPT Proto по цене $1.20 за миллион входных токенов и $3.60 за миллион выходных токенов, что соответствует тарифам, указанным для Grok 4.6.
Модель принимает текст и изображения, поддерживает вызов функций и структурированный вывод, а также предоставляет контекстное окно объемом 500 тыс. токенов. Четыре уровня рассуждения — низкий, средний, высокий и сверхвысокий — позволяют разработчикам тестировать, сколько усилий требуется для выполнения сложной задачи.
Это делает модель актуальной, когда агенту необходимо диагностировать неудачное изменение кода, координировать результаты нескольких зависимых инструментов или пересмотреть план после того, как проверка не удалась. Более дешевая модель может справиться с рутинной подготовкой, пока Grok берет на себя сложный этап.
Ограничение здесь скорее экономическое, чем техническое. Отправка каждого запроса на извлечение данных или маршрутизацию в модель для эскалации увеличивает расходы еще до того, как потребуется ее усиленная логика рассуждения. Более новый релиз с теми же тарифами на токены не гарантирует снижение итогового счета за выполненную задачу; сравните обе версии, если существующее приложение уже использует Grok 4.6.
Выбирайте Grok 4.7, если:
задача по программированию или исследованию требует принятия нескольких зависимых решений;
более дешевый маршрут постоянно не проходит заданную проверку на соответствие требованиям;
необходимо учитывать визуальные доказательства и логические рассуждения в совокупности;
успешное восстановление оправдывает дополнительные расходы на модель.
Обратите внимание на: дорогостоящие повторные попытки и чрезмерные усилия по рассуждению. Используйте модель только на определенном пути эскалации и останавливайтесь, когда для задачи требуется разрешение или отсутствующие входные данные, которые другая модель предоставить не может.
Почему дешевые токены все равно могут привести к дорогим задачам агента
Низкая стоимость токенов помогает при повторяющейся классификации или переписывании текста. Но это мало что говорит об агенте, который должен выбирать инструменты, интерпретировать их результаты и исправлять ошибки.
Модель может выдавать дешевые ответы, при этом постоянно выбирая неверную функцию или пропуская обязательный аргумент. Каждое исправление добавляет еще один вызов модели, увеличивает историю диалога и потенциально требует еще одного обращения к инструменту. Задача может стать дорогостоящей еще до того, как агент выдаст приемлемый результат.
Прежде чем передать модели управление рабочим процессом, проверьте, может ли она:
различать похожие инструменты;
создавать аргументы, соответствующие как схеме, так и бизнес-правилам;
продолжать работу после получения результата инструмента или устранимой ошибки;
распознавать, когда ни один из доступных инструментов не подходит.
Начните с определения порога приемлемости, а затем сравните общую стоимость моделей, которые его проходят. Для простого этапа извлечения данных и для контроллера, управляющего несколькими инструментами, не обязательно использовать одну и ту же модель.
Практическая стратегия маршрутизации моделей с низкими затратами
Вы можете назначать разные этапы разным моделям внутри одного агента. Рутинная подготовка направляется по бюджетному маршруту, а сложные логические задачи — по маршруту эскалации. Приложение делает этот выбор, основываясь на типе задачи, результатах проверки и лимитах расходов.
| Задача агента |
Первичная модель для оценки |
Эскалация или смена маршрута при |
| Классификация, извлечение и маршрутизация запросов |
GPT-6 Luna |
Вывод не проходит проверку или запрос неоднозначен |
| Повторяющиеся задачи поддержки и написание кода в Claude |
Claude Haiku 5.5 |
Требуется более широкое планирование или повторные попытки не увенчались успехом; проверьте расходы, если объем входных данных превышает 100 тыс. |
| Визуальные проверки и рабочие процессы с документами |
GLM-5.3 Flash |
Модель не может разрешить противоречивые данные или завершить проверку |
| Повторяющийся контекст с интенсивным кэшированием |
DeepSeek Flash |
Состояние потеряно, обработка инструментов не удалась или ожидаемая экономия кэша не достигнута |
| Длинные документы и исследовательские сессии |
MiniMax M3 |
Важные взаимосвязи между документами упущены |
| Аудио, видео и смешанные медиа-входные данные |
Gemini 3.8 Flash |
Извлеченные данные требуют отдельного, более сложного этапа планирования |
| Сложное программирование и многоэтапное восстановление |
Grok 4.7 |
Рабочий процесс достигает лимита по времени, количеству шагов или расходам |
Это лишь отправные точки для оценки. Ошибка проверки может быть вызвана промптом, определением инструмента или приложением, а не только моделью; выясните причину, прежде чем переходить на более дорогой маршрут.
Контролируйте расходы агента с помощью пяти правил:
Используйте бюджетную модель только после того, как она пройдет проверки на соответствие требованиям задачи.
Проверяйте аргументы инструментов перед выполнением.
Ограничивайте вызовы моделей, количество выходных токенов, время выполнения и расходы для каждого запуска.
Определите правило восстановления или эскалации вместо бесконечных повторных попыток одного и того же запроса.
Запрашивайте подтверждение, если действие выходит за рамки разрешений агента.
GPT Proto предоставляет доступ к поддерживаемым моделям через один API-ключ и общий баланс. Приложение или фреймворк по-прежнему управляет маршрутизацией, состоянием, выполнением инструментов и условиями остановки. Посетите страницу LLM API для AI-агентов, чтобы сравнить доступ к моделям и оценить затраты на существующий рабочий процесс. Для ограниченных этапов маршрутизации и классификации сравните Jev и LLM общего назначения, прежде чем поручать принятие решений более дорогой модели агента.
Минимальный запрос с вызовом инструментов в GPT Proto
В этом примере используется glm-5.3-flash и определяется get_order_status в качестве инструмента, который может выполнить приложение. Ответ модели может содержать запрос на вызов этой функции; сам запрос не предоставляет модели доступ к вашей системе заказов.
Откройте страницу модели GLM-5.3 Flash и выберите Попробовать эту модель для текущего руководства по быстрому запуску, затем укажите в примере свой API-ключ на стороне сервера.
curl https://gptproto.com/v1/chat/completions \
  -H "Authorization: Bearer $GPTPROTO_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "glm-5.3-flash",
    "messages": [
      {
        "role": "user",
        "content": "Where is order A-1042?"
      }
    ],
    "tools": [
      {
        "type": "function",
        "function": {
          "name": "get_order_status",
          "description": "Return the current status of one order.",
          "parameters": {
            "type": "object",
            "properties": {
              "order_id": {
                "type": "string",
                "description": "The order identifier."
              }
            },
            "required": ["order_id"],
            "additionalProperties": false
          }
        }
      }
    ],
    "tool_choice": "auto"
  }'
Для получения ответа в формате Chat Completions, совместимом с OpenAI, проверьте choices[0].message.tool_calls. Для каждого возвращенного вызова:
убедитесь, что функция разрешена для данного пользователя и задачи;
выполните синтаксический анализ и проверку аргументов;
выполните функцию в своем приложении;
верните результат в сообщении инструмента с соответствующим tool_call_id;
запросите следующий ответ модели, сохраняя любое необходимое состояние рассуждения.
Переключение модели требует проверки совместимости. Для вызова инструментов в Chat Completions модели GPT-6 Luna требуется reasoning_effort: "none"; вызов функций с поддержкой рассуждений использует Responses. Другие маршруты могут иметь иные требования к состоянию или параметрам. Проверяйте руководство по быстрому запуску для каждой модели, вместо того чтобы предполагать, что один и тот же payload будет работать везде.
Это первый запрос в цикле инструментов. Ваше приложение должно обеспечить выполнение инструмента и последующие сообщения.
Как протестировать доступный LLM API для вашего агента
Используйте репрезентативные задачи из вашего приложения. Общий бенчмарк может помочь составить шорт-лист, но модель также должна работать с вашими названиями инструментов, данными и правилами приемки.
Начните с четырех категорий:
Выбор инструмента: Предложите похожие функции и проверьте, выбирает ли модель правильную.
Несколько инструментов: Дайте запрос, требующий двух независимых результатов. Протестируйте параллельные вызовы, если маршрут их поддерживает, или выполните оба последовательно.
Запросы без инструментов: Включите вопросы, для которых не должен вызываться ни один из доступных инструментов.
Восстановление: Верните реалистичную ошибку инструмента и проверьте, исправляет ли модель свой следующий шаг, не зацикливаясь бесконечно.
Сохраняйте инструкции, определения инструментов, входные данные и критерии приемки неизменными. Используйте поддерживаемые настройки для каждого маршрута и записывайте конфигурацию его эндпоинта и рассуждений; идентичные имена параметров не всегда переносимы между провайдерами.
Запускайте каждую категорию не менее пяти раз для каждой модели. С семью моделями, четырьмя категориями и пятью повторами начальное сравнение содержит 140 запусков. Это пилотный дизайн оценки, а не утверждение о том, что эти запуски уже завершены или что пять повторов обеспечивают надежность в продакшене.
Записывайте:
принятые завершения задач;
правильный выбор инструментов и корректные аргументы;
ненужные вызовы и сбои восстановления;
ходы модели и общее время рабочего процесса;
некэшированные входные данные, чтение или запись кэша, а также оплаченные выходные токены или токены рассуждений;
применимые уровни длины промпта и другие оплачиваемые компоненты;
общую стоимость API, включая повторные попытки и неудачные обращения.
Рассчитайте:
Стоимость одной принятой задачи = Общие расходы на API за время оценки / Количество принятых завершений
Сообщайте о сбоях отдельно, особенно если модель не принимает ни одной задачи. Сравнивайте затраты только после проверки порога качества; затем расширяйте оценку вокруг тех случаев сбоев, которые важны в продакшене.
Что разработчики агентов говорят о задержках
Отзывы сообщества добавляют контекст, который не могут предоставить страницы с ценами. В одной дискуссии сообщества AI-агентов сообщалось, что простая система поиска отвечала менее чем за секунду, в то время как более агентная версия занимала почти три секунды. Для службы поддержки клиентов эта разница была названа критическим фактором.
Другие участники не согласились с универсальным выводом. Они отметили, что пользователи, занимающиеся исследованиями и внутренней аналитикой, могут мириться с гораздо более долгим ожиданием, если использование инструментов существенно улучшает ответ. Полезный урок заключается не в том, что три секунды — это всегда слишком медленно. А в том, что одна и та же модель может быть доступной для одного агента и неподходящей для другого, потому что задержка, качество и стоимость сбоев имеют разную ценность.
Относитесь к комментариям сообщества как к отчетам об опыте, а не как к результатам бенчмарков. Используйте их для выявления случаев сбоев для вашей собственной оценки.
Для своего агента измеряйте время до получения первого полезного ответа и время до завершения задачи наряду со скоростью генерации. Модель может начать быстро, но потребовать несколько дополнительных ходов для завершения. Поэтому для интерактивной поддержки и фоновых исследований могут потребоваться разные целевые показатели задержки, даже если они используют один и тот же маршрут API.
Итоговая рекомендация
Для частых, ограниченных по объему шагов начните с GPT-6 Luna. У этой модели самые низкие базовые тарифы на входные и выходные данные в этом списке, и она подходит для запросов, которые ваше приложение может проверить.
Выбирайте Claude Haiku 5.5 для повторяющихся задач поддержки и подзадач программирования в Claude, учитывая порог цен на входные данные в 100 тыс. токенов. Используйте GLM-5.3 Flash, когда скриншоты, документы или другие визуальные доказательства определяют следующее действие инструмента.
Рассмотрите DeepSeek Flash для повторяющихся входных данных с интенсивным использованием кэша, а MiniMax M3 — для сессий с длинными документами. Выбирайте Gemini 3.8 Flash, когда понимание аудио или видео позволяет сократить количество отдельных этапов обработки. Оставьте Grok 4.7 для сложных задач программирования и многоэтапного восстановления.
Окончательный выбор должен пасть на модель, которая достигает целевых показателей приемлемости при минимальной измеренной стоимости рабочего процесса. Используйте тарифы на токены для составления шорт-листа, а затем учитывайте неудачные запуски, рассуждения, инструменты и повторные попытки при принятии решения.
Готовы подключить свой шорт-лист? Изучите LLM API для AI-агентов от GPT Proto, чтобы ознакомиться с поддерживаемыми моделями, оценками рабочей нагрузки и доступом через один ключ с общим балансом. Используйте панель Попробовать эту модель на странице каждой модели для быстрого старта и ознакомьтесь с ценами GPT Proto перед масштабированием.