手頃な価格のコーディング用LLMの概要
| モデル |
評価対象の最初のワークロード |
主なトレードオフ |
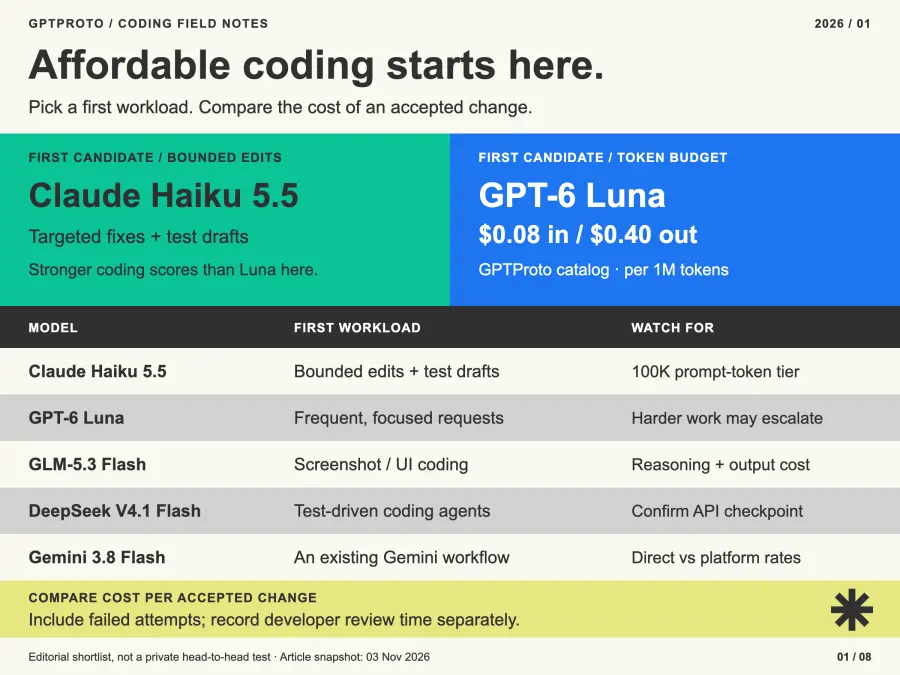
| Claude Haiku 5.5 |
限定的なコード編集、テストドラフト、およびコーディングのサブタスク |
低価格帯は10万プロンプトトークンを超えると終了します |
| GPT-6 Luna |
頻繁かつ範囲の狭いコーディングリクエスト |
より複雑なリポジトリ作業にはエスカレーションが必要になる場合があります |
| GLM-5.3 Flash |
スクリーンショットやUIリファレンスを含むコーディングタスク |
推論の負荷と出力の長さが請求額に影響します |
| DeepSeek V4.1 Flash |
テストと再試行制限のあるコーディングエージェント |
APIエイリアスによって提供されるチェックポイントを確認してください |
| Gemini 3.8 Flash |
既存のGeminiワークフロー内でのコーディング |
直接プロバイダーのプロモーション料金は、プラットフォームの提示価格と異なる場合があります |
モデルだけでなくサプライヤーも選定中であれば、弊社の開発者向けAI APIプラットフォームの比較が、アクセス、課金、統合、本番環境の制御といったより広範な疑問を解決します。
コストとコーディング能力の比較方法
手頃な価格のLLMコーディングモデルには、トークン単価が有効になる前に、タスクをこなす十分な能力が必要です。弊社ではコーディングに特化したエビデンスを優先し、その上でワークロードのコスト、コンテキストの階層、ツールの互換性、および利用可能なGPT Protoモデルページを確認しています。
以下の結果はArtificial Analysisによるものです。Terminal-Bench 4.0はエージェントによるコーディングとターミナル操作を評価し、FrontierCode 2.0はオープンソースリポジトリにおけるソフトウェアエンジニアリングを評価します。構成によって結果が異なる可能性があるため、評価された設定を各モデルの横に記載しています。
| 評価モデル |
Terminal-Bench 4.0 |
FrontierCode 2.0 |
| Claude Haiku 5.5 Max |
33% |
35% |
| GPT-6 Luna Max |
13% |
25% |
| GLM-5.3 Flash (リスト通り) |
33% |
18% |
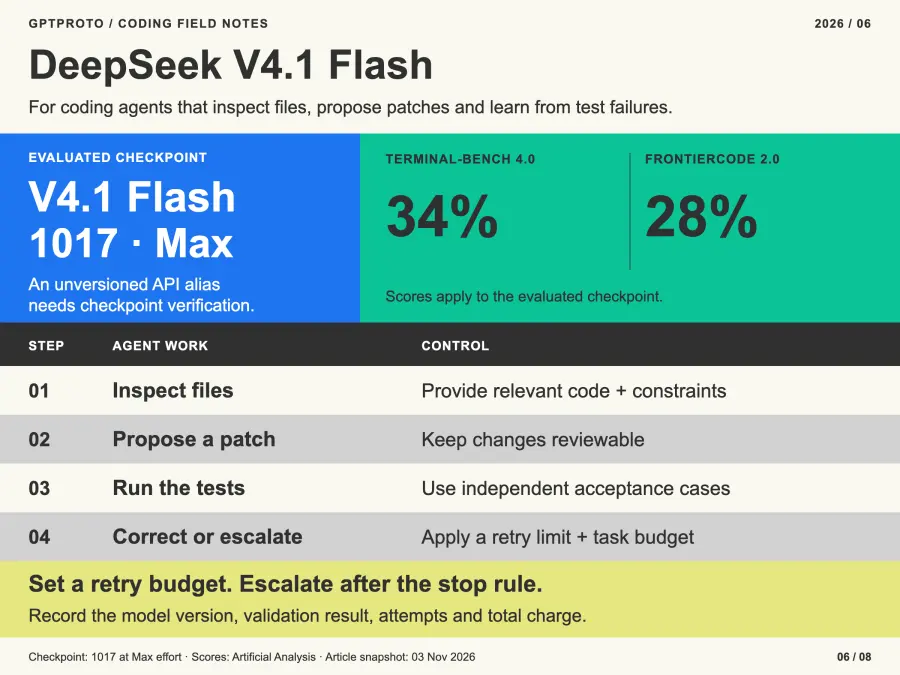
| DeepSeek V4.1 Flash 1017 Max |
34% |
28% |
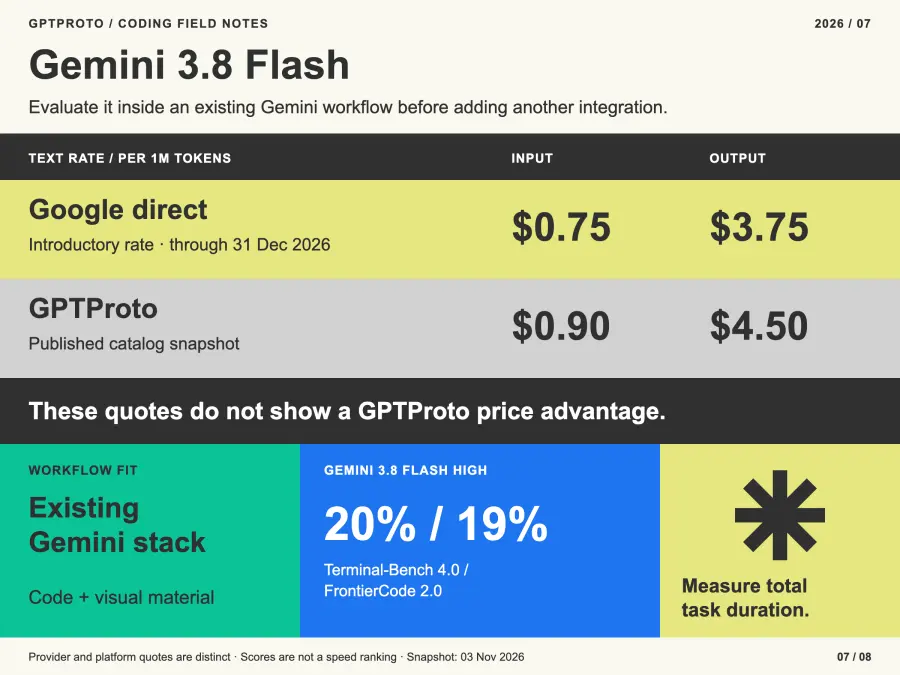
| Gemini 3.8 Flash High |
20% |
19% |
根底にある比較は、Haiku対Luna、DeepSeek対GLM Flash、そしてHaiku対Geminiです。これらのパーセンテージはそれらの評価を表すものであり、お客様のリポジトリで期待される成功率を示すものではありません。また、これらはGPT Protoのレイテンシや稼働率を保証するものでもありません。
以下の価格見積もりは、課金の計算式を明らかにするためにトークン使用量を一定に保っています。実際のモデルでは、特に推論が有効な場合、同じプロンプトでも異なるトークン数が使用される可能性があります。
手頃な価格のコーディング用LLMベスト5
1. Claude Haiku 5.5:限定的なコーディングタスク向け
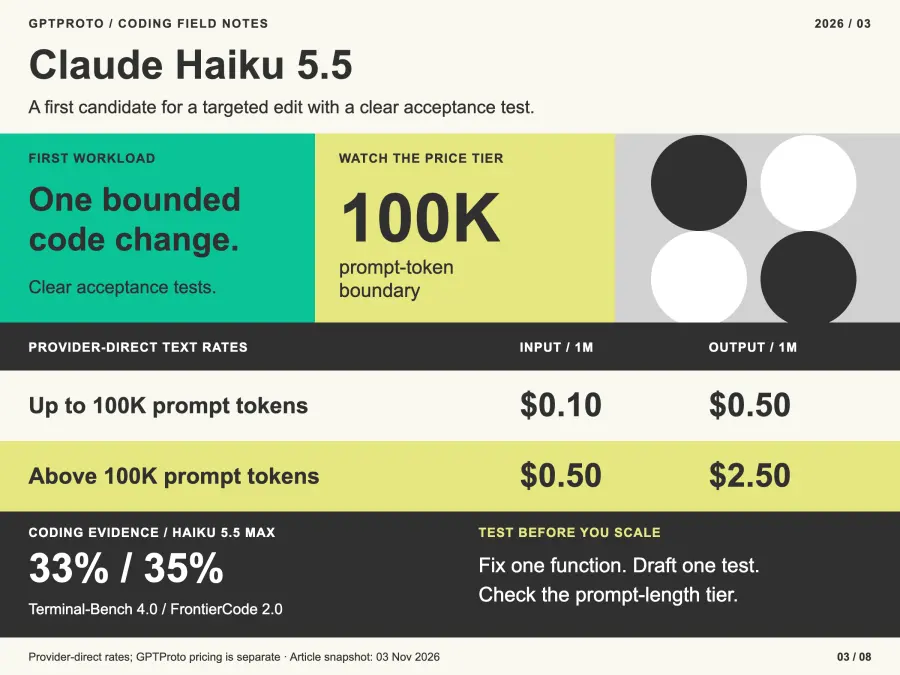
Claude Haiku 5.5は、明確な合格基準があり、プロンプトが100Kトークン未満のターゲットを絞った編集作業における最初の候補です。そのコーディング結果は、より大規模なClaudeモデルにコストを支払う前に評価する価値があります。
Anthropicのリリース発表では、HaikuはSonnetやOpusと並び、反復作業やコーディングのサブタスク向けのモデルとして位置付けられています。これは、1つの関数を修正する、テストをドラフトする、あるいは限定的な障害を調査するといった、実用的な開始範囲を示唆しています。
重要なコストの境界線はプロンプトの長さです。プロンプトが100Kトークンを超えると、アップストリームの入出力レートは100万トークンあたり0.10ドル/0.50ドルから0.50ドル/2.50ドルに上昇します。コンテキストウィンドウが大きいからといって、その全範囲で最安値のティアが利用できるわけではありません。
2. GPT-6 Luna:頻繁かつ集中的なリクエスト向け
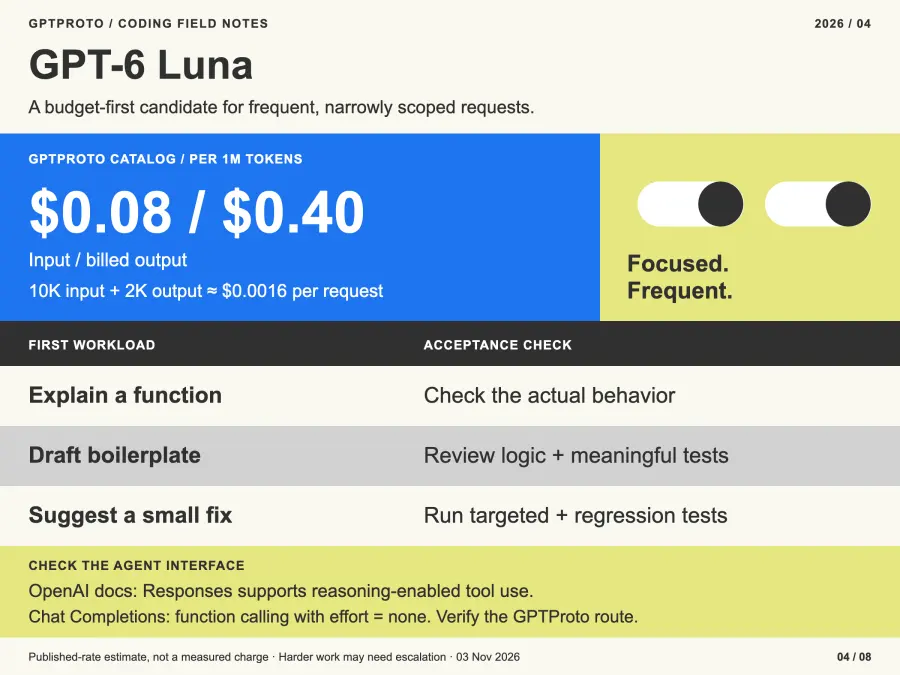
GPT-6 Lunaは、関数の説明、ボイラープレートの作成、既存のテストで判断可能な小さな修正など、繰り返される限定的なリクエストに対する予算重視の候補です。
公開されているGPT Protoカタログレートは、100万トークンあたり入力0.08ドル、出力0.40ドルです。公開されているコーディングスコアはHaikuより低いため、タスク固有の評価を通じてLunaの役割を広げていくのが良いでしょう。
エージェントを構築する際は、統合インターフェースを確認してください。OpenAIモデルのドキュメントでは、Responsesを通じた推論対応のツール使用が規定されています。Chat Completionsでは、推論の取り組み(reasoning effort)を「なし」に設定することで関数呼び出しが可能です。モデルの切り替えを単なる設定変更として扱う前に、GPT Protoのルートが何を公開しているかを確認してください。
3. GLM-5.3 Flash:予算重視のビジュアルコーディング向け
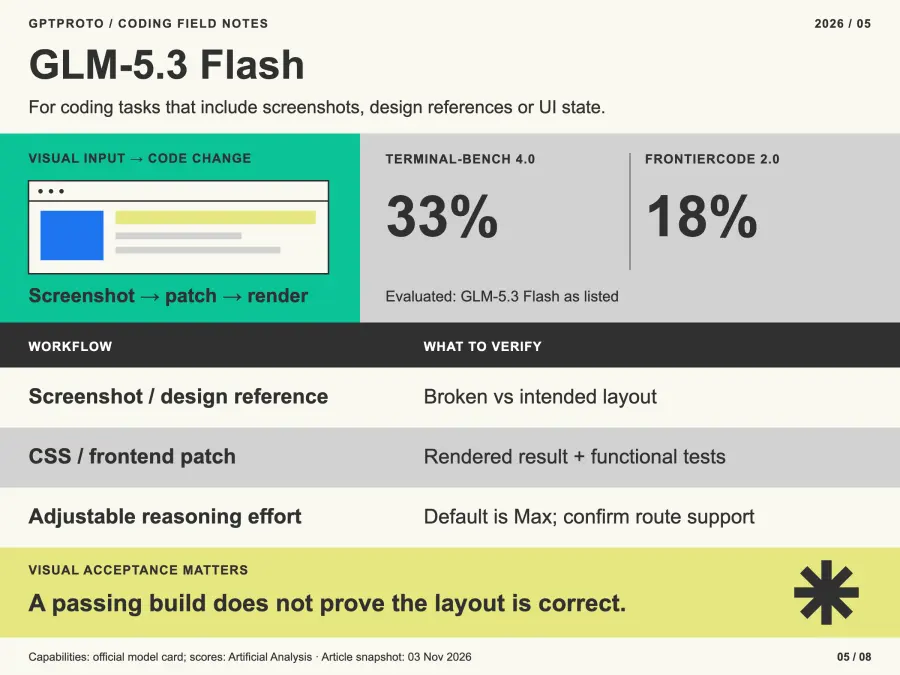
GLM-5.3 Flashは、コーディングタスクにスクリーンショット、デザインリファレンス、またはレンダリングされたインターフェースが含まれる場合の候補リストに入れるべきモデルです。例えば、フロントエンドのアシスタントは、CSSの変更を提案する前に、壊れたレイアウトと意図された状態を比較する必要があるかもしれません。
公式のGLM-5.3 Flashモデルカードには、マルチモーダル入力、オープンウェイト、および調整可能な推論の取り組みが記載されています。公開されているデフォルトの取り組みは「最大」です。ホストされたルートがそれをどのようにサポートしているかを確認した上で、別の設定を使用してください。
その2つのコーディングスコアには大きな差があります。これは、1つの最終的なベンチマークをコード編集の普遍的なランキングとして扱うのではなく、タスクの組み合わせをテストすべき理由となります。ビジュアルの修正にはレンダリングによる比較も必要であり、コンパイルだけではレイアウトが正しいかどうかを判断できません。
4. テスト駆動型コーディングエージェント向け DeepSeek V4.1 Flash
DeepSeek Flashは、ファイルの検査、変更の提案、テスト失敗の受け取り、そして予算内での再試行を行うエージェントにとって評価に値するモデルです。
10月17日のリリース発表では、コーディングパフォーマンス、タスク完了速度、出力長の改善について説明されています。当社の表にある独立した結果は、特に「Max effort」設定のV4.1 Flash 1017を指しています。バージョン指定のないエイリアスだけでは、使用しているプラットフォームがそのチェックポイントを提供しているとは限らないため、可能な限り解決済みのバージョンを記録してください。
DeepSeek、GLM、Qwen、Kimiのより広範な比較については、当社のコーディング向け中国語LLM比較をご覧ください。困難なリポジトリ変更で予算ルートを使い果たした時のために、より強力な候補も利用できるようにしておきましょう。
5. 既存のGeminiワークフロー向け Gemini 3.8 Flash
Gemini 3.8 Flashは、アプリケーションですでにGeminiを使用している場合や、コードと視覚資料を組み合わせる場合に検討すべき候補です。別のプロバイダー固有の統合を追加する前に、既存のワークフローで評価してください。
Googleのモデルアップデートでは、調整可能な思考プロセスと、2026年12月31日までの導入価格として100万トークンあたり入力0.75ドル/出力3.75ドルが記載されています。公開されているGPT Protoカタログのスナップショットは0.90ドル/4.50ドルです。これらの数値は、GPT ProtoがGoogleの現在のプロモーションよりも安価であるという主張を裏付けるものではありません。
Geminiはワークフローへの適合性という点で含めるべきであり、「Flash」という名前から速度のタイトルを与えるべきではありません。実際のプロンプトを使用して、回答が得られるまでの時間とタスク全体の所要時間を測定してください。
コーディング用LLM APIの価格比較
この表は、GPT Protoの請求レートではなく、指定された条件下でのプロバイダー直接の公開レートを使用しています。ソースとワークロードを明示することで、比較の再現性を確保しています。
「小規模リクエスト」には、10Kの入力トークンと2Kの課金対象出力トークンが含まれます。「リポジトリベースライン」には、200Kの入力トークンと20Kの課金対象出力トークンが含まれます。いずれもキャッシュヒットがないものと仮定しており、課金対象出力には該当する場合、推論トークンを含める必要があります。
| モデルと価格条件 |
入力 / 出力(100万トークンあたり) |
小規模リクエスト |
リポジトリベースライン |
| Haiku 5.5(プロンプトトークン100Kまで) |
$0.10 / $0.50 |
$0.0020 |
次のティアを使用 |
| Haiku 5.5(プロンプトトークン100K超) |
$0.50 / $2.50 |
該当なし |
$0.1500 |
| GPT-6 Luna(基本コンテキストティア内) |
$0.10 / $0.50 |
$0.0020 |
$0.0300 |
| GLM-5.3 Flash(公開標準レート) |
$0.15 / $0.50 |
$0.0025 |
$0.0400 |
| DeepSeek Flash(アップストリームのピークレート) |
$0.30 / $1.20 |
$0.0054 |
$0.0840 |
| Gemini 3.8 Flash(導入時の直接レート) |
$0.75 / $3.75 |
$0.0150 |
$0.2250 |
レートの根拠は、リンク先のモデルドキュメントおよび上記の独立した比較に基づいています。DeepSeekのリリースノートでは、オフピーク時のトークンレートがピーク時の半分であることが確認されています。Lunaは、272K入力トークンを超えるリクエスト全体に対してより高いレートを適用します。Geminiの導入レートは2026年に終了します。予算を立てる前に、適用されるルートと日付を確認してください。
GPT Protoへのアクセスについては、リンク先のモデルページにあるライブ価格パネルをご利用ください。カタログの明確な例として、低価格ティアにおけるLunaの$0.08/$0.40とHaikuの$0.09/$0.45があります。同じ小規模リクエストの推定額は、それぞれ$0.0016と$0.0018となります。これらは公開レートに基づく計算であり、実際の請求額ではありません。
月に10,000件の小規模リクエストを行う小規模アプリケーションの場合、アップストリームのLunaまたは低ティアのHaikuの例では、再試行やその他の料金を除いて合計$20となります。この見積もりは、アプリケーションが異なる量のコンテキストを送信したり、はるかに長い出力を生成したりする場合には役に立たなくなります。
キャッシュには独自の計算が必要です。キャッシュされていない入力、キャッシュ読み取り、キャッシュ書き込みやストレージ、そして課金対象の出力を加算してください。安定したリポジトリプレフィックスは役立つ可能性がありますが、プロンプトを変更したりキャッシュをミスしたりすると、節約効果は変わります。
開発者Simon Willison氏によるHaiku 5.5のテストは、異なる設定が時間とコストにどのような影響を与えるかを示す具体的な例です。また、トークナイザーの変更についても論じています。予算編成の教訓は、すべてのモデルが同一のテキストに対して同じトークン数を請求すると仮定するのではなく、実際の使用量を測定することです。
コーディングタスクに適したモデルの選び方
| タスク |
推奨候補 |
受け入れ基準 |
| 限定的なコード修正やバグ修正 |
Haiku 5.5 および Luna |
ターゲットテストおよび既存のリグレッションテスト |
| ユニットテストやボイラープレートの作成 |
Luna および Haiku 5.5 |
アサーションのレビューおよび意味のある失敗ケースの検証 |
| 視覚的なフロントエンドの修正 |
GLM-5.3 Flash および Gemini 3.8 Flash |
レンダリング結果の比較および機能テスト |
| マルチステップのコーディングエージェント |
DeepSeek Flash および Haiku 5.5 |
タスク完了、有効なツール呼び出し、リトライ回数、および合計コスト |
これらは評価の出発点です。モデルの誤った前提をそのまま繰り返すような生成テストは、機能が間違っていてもパスしてしまう可能性があります。独立した受け入れテストケースを維持し、テスト自体の変更内容を精査してください。
ドキュメント検索、リクエストの分類、サポートタスクなども行うエージェントについては、当社のAIエージェント向け低コストLLM APIガイドで、より広範なワークロードの組み合わせを解説しています。
プレミアムなコーディングモデルが必要な場合
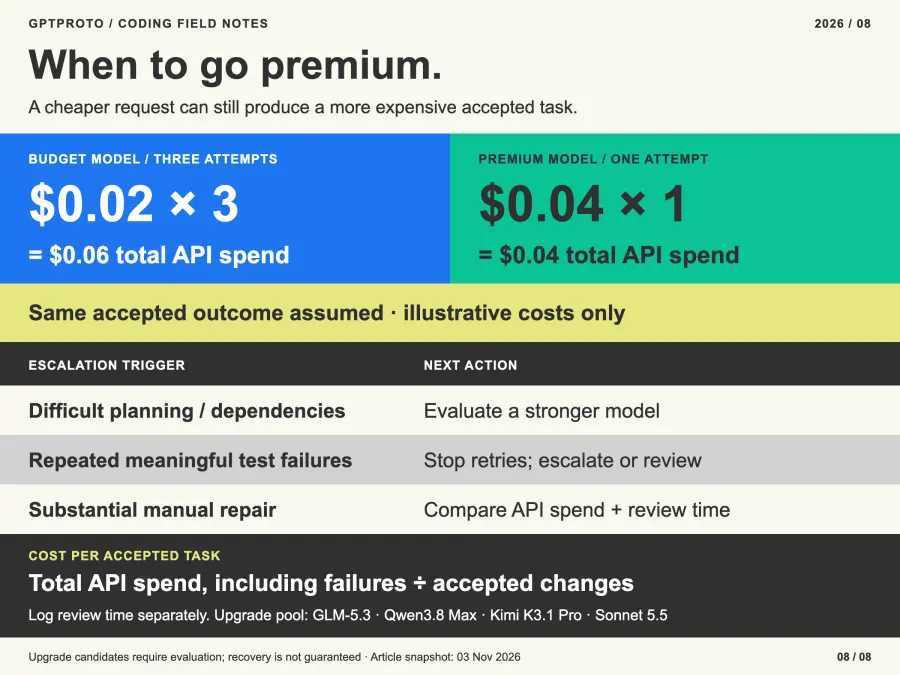
高度な計画が必要なタスク、意味のあるテストで繰り返し失敗するタスク、または大幅な手動修正が必要な場合は、上位モデルへエスカレーションしてください。GLM-5.3、Qwen3.8 Max、Kimi K3.1 Pro、およびClaude Sonnet 5.5は、そうした作業のための別の評価プールを形成できます。これらをここに含めるのは調査すべきアップグレードパスであり、低コストモデルで失敗したタスクを常に解決できると主張するものではありません。
「受け入れタスクあたりのコスト」を使用してください。これは評価全体でのAPI総支出を、受け入れられた変更数で割ったものです。失敗した試行の支出も含めてください。API料金の安さによって開発者の修正コストが隠れてしまわないよう、レビュー時間は別途記録してください。
例として、$0.02の試行を3回行うと合計$0.06になります。同じタスクを1回で完了させる$0.04の試行の方が、全体としては安上がりです。そのトレードオフが妥当かどうかは、測定された成功率に基づいて判断してください。
低コストモデルで無限リトライを避ける方法
最初のリクエストの前に、受け入れチェックと停止ルールを設定してください。実用的な初期ポリシーは、「最初の1回試行し、テスト失敗に基づいて1回修正を行い、それでもダメならエスカレーションまたは人間によるレビューを行う」というものです。観測された結果とタスク予算に基づいて、このポリシーを調整してください。
アプリケーションには、モデルとチェックポイント、推論設定、トークン使用量、経過時間、検証結果、および合計料金を記録する必要があります。モデルがパッチを提案し、ランナーがテストを実行し、ルーティングロジックが次のアクションを決定します。
マルチモデルAPIはアクセスと請求を簡素化します。テストの合格、予算を考慮したルーティング、自動エスカレーションには、依然として検証済みのプラットフォーム機能やアプリケーションロジックが必要です。当社の開発者向けAIゲートウェイガイドでは、さまざまなアクセス層と制御層を比較しています。
GPT Protoで手頃なコーディングモデルを試す
候補のモデルページを開き、Try this modelを選択して、現在のクイックスタートと料金を確認してください。APIキーと残高を準備します。パネルにCopy Markdown for AIが表示されている場合は、そのガイドをタスクと受け入れ基準とともにコーディングアシスタントに渡してください。実際のキーは、ローカル環境またはサーバーのシークレットストアに保持してください。
再現可能な最初の演習として、このページネーション関数を修正してみましょう。ページは1から始まり、pageとper_pageは整数で、1未満の値の場合はValueErrorを発生させ、入力リストは変更しないようにする必要があります。
以下を新しい作業フォルダにrequest_patch.pyとして保存してください。これはPythonの標準ライブラリを使用し、候補となる関数をリクエストし、構文をチェックして、レビュー用に保存するものです。返されたコードを実行することはありません。
import ast
import json
import os
import time
from pathlib import Path
from urllib.error import HTTPError, URLError
from urllib.request import Request, urlopen

key = os.environ.get("GPTPROTO_API_KEY")
if not key:
    raise SystemExit("環境変数にGPTPROTO_API_KEYを設定してください。")

source = """def paginate(items, page, per_page):
    start = page * per_page
    return items[start:start + per_page]
"""
task = (
    "paginateを修正してください。ページは1から始まります。pageとper_pageは "
    "整数です。いずれかが1未満の場合はValueErrorを発生させてください。最後のページを超えた場合は "
    "空のリストを返してください。itemsをミューテート(変更)しないでください。シグネチャは維持してください。 "
    "Markdownや説明を含めず、関数のみを返してください。\n\n" + source
)
payload = {
    "model": os.environ.get("GPTPROTO_MODEL", "gpt-6-luna"),
    "messages": [{"role": "user", "content": task}],
}
request = Request(
    "https://gptproto.com/v1/chat/completions",
    data=json.dumps(payload).encode("utf-8"),
    headers={
        "Authorization": f"Bearer {key}",
        "Content-Type": "application/json",
    },
    method="POST",
)
started = time.perf_counter()
try:
    with urlopen(request, timeout=60) as response:
        result = json.load(response)
except HTTPError as exc:
    raise SystemExit(f"APIがHTTP {exc.code}を返しました。") from exc
except (URLError, TimeoutError) as exc:
    raise SystemExit("リクエストが失敗したか、タイムアウトしました。") from exc

try:
    code = result["choices"][0]["message"]["content"]
except (KeyError, IndexError, TypeError) as exc:
    raise SystemExit("APIレスポンスに候補となるテキストが含まれていません。") from exc
if not isinstance(code, str) or not code.strip():
    raise SystemExit("レスポンスにPythonコードが含まれていませんでした。")
code = code.strip()
try:
    ast.parse(code)
except SyntaxError as exc:
    raise SystemExit("レスポンスを確認してください。プレーンなPythonではありません。") from exc

Path("candidate.py").write_text(code + "\n", encoding="utf-8")
print("candidate.pyを保存しました。テストを実行する前に確認してください。")
print("秒数:", round(time.perf_counter() - started, 2))
print("使用量:", json.dumps(result.get("usage", {})))
以下の受け入れチェックを test_candidate.py として保存してください:
import unittest
from candidate import paginate


class PaginationTests(unittest.TestCase):
    def test_pages(self):
        items = [0, 1, 2, 3, 4]
        self.assertEqual(paginate(items, 1, 2), [0, 1])
        self.assertEqual(paginate(items, 2, 2), [2, 3])
        self.assertEqual(paginate(items, 3, 2), [4])
        self.assertEqual(paginate(items, 4, 2), [])
        self.assertEqual(items, [0, 1, 2, 3, 4])

    def test_empty_input(self):
        self.assertEqual(paginate([], 1, 2), [])

    def test_invalid_values(self):
        for page, per_page in [(0, 2), (-1, 2), (1, 0), (1, -1)]:
            with self.subTest(page=page, per_page=per_page):
                with self.assertRaises(ValueError):
                    paginate([0, 1], page, per_page)


if __name__ == "__main__":
    unittest.main()
環境キーを設定したら、python request_patch.pyを実行します。candidate.pyを確認し、python -m unittest -v test_candidate.pyを実行してください。構文チェックはPythonがその出力を解析できることを確認するだけであり、テストによって記述された動作が評価されます。この小さな演習は、リポジトリ規模のベンチマークではありません。
別のドキュメント化されたモデルIDを使用して、GPTPROTO_MODELで繰り返します。成功だけでなく失敗も記録し、返された使用量と適用される課金レートを組み合わせて料金を比較してください。タイムアウトや試行の失敗も評価記録に含める必要があります。
1つの限定的なタスクを選択し、その受け入れチェックを固定したまま、2つの候補を比較します。Claude Haiku 5.5 APIページまたはGPT-6 Luna APIページを開いて現在の価格を確認し、最初のコーディングリクエストを開始してください。