Aktualisiert am 21. September 2026
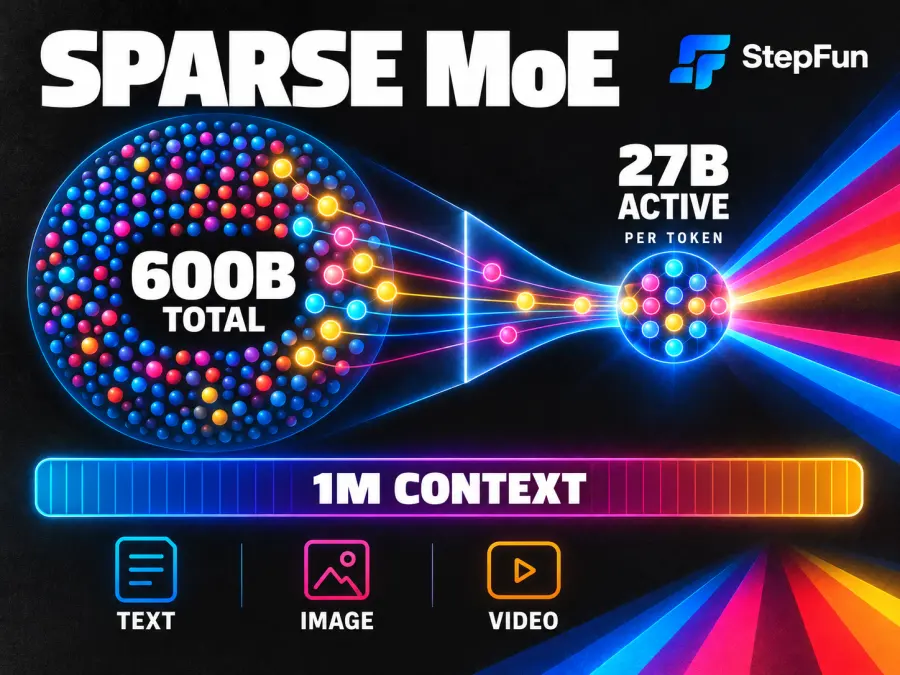
Step 5 Preview ist StepFuns neues Flaggschiffmodell für logisches Denken, Programmierung, lang laufende Agenten, professionelle Recherche und Finanzanwendungen. Die Eckdaten sind ungewöhnlich: eine dünn besetzte Mixture-of-Experts-Architektur mit 600 Milliarden Parametern, 27 Milliarden aktive Parameter pro Token, ein Kontextfenster von 1 Million Tokens und native Eingabe von Text, Bildern und Videos.
Diese Spezifikationen machen das chinesische KI-Modell interessant, sagen aber noch nicht aus, ob es sich für den Einsatz in einer Produktionsumgebung eignet. Unabhängige Tests bescheinigen ihm einen kleinen Vorsprung bei der Intelligenz gegenüber GLM 5.3 Flash und DeepSeek V4.1 Flash; beide Konkurrenten sind günstiger, und DeepSeek ist schneller.
Ein Hinweis zur Verfügbarkeit ist wichtig, bevor wir fortfahren: Step 5 Preview ist über die eigene API von StepFun verfügbar, aber Stand 21. September 2026 noch nicht auf GPTProto verfügbar. GPTProto plant, das Modell später hinzuzufügen. Entwickler, die heute ein Modell über GPTProto benötigen, können GLM 5.3 Flash, DeepSeek Flash testen oder den Katalog der Textmodelle durchstöbern.
Was ist Step 5 Preview?
Step 5 Preview ist ein multimodales Reasoning-Modell, das vom in Shanghai ansässigen Unternehmen StepFun entwickelt wurde. Es soll planen, Tools aufrufen, Ergebnisse prüfen, seinen Ansatz überarbeiten und so lange weitermachen, bis es ein fertiges Ergebnis liefert.
Hier sind die wichtigsten Fakten aus der offiziellen Modelldokumentation und der Launch-Seite von StepFun:
| Spezifikation |
Step 5 Preview |
| Entwickler |
StepFun |
| Modell-ID |
step-5-preview |
| Architektur |
Sparse Mixture of Experts |
| Parameter |
600B insgesamt, 27B aktiv pro Token |
| Kontextfenster |
1M Tokens |
| Maximale Ausgabe |
64K Tokens |
| Eingabe |
Text, Bilder und Video |
| Ausgabe |
Text |
| Reasoning-Steuerung |
low, medium oder high |
| API-Status |
Bei StepFun verfügbar |
| Open-Weight-Status |
Veröffentlichung für den 15. Oktober 2026 geplant |
| GPT Proto-Status |
Noch nicht verfügbar; Integration geplant |
„Preview“ ist wichtig. Die API kann bereits verwendet werden, aber Verhalten, Limits, Preise und sogar der Name können sich vor einer stabilen Veröffentlichung noch ändern. StepFun zufolge werden die Modellgewichte am 15. Oktober 2026 veröffentlicht. Bis dahin sollte das Modell als gehostetes proprietäres Modell betrachtet werden – nicht als Open-Weight-Modell, das bereits selbst gehostet werden kann.
Funktionen und Architektur von Step 5 Preview
600B Parameter, ohne alle 600B zu aktivieren
Step 5 Preview verwendet eine Sparse-Mixture-of-Experts-Architektur (MoE). Insgesamt umfasst das Modell 600 Milliarden Parameter, aber pro Token sind nur 27 Milliarden aktiv. Ein Routing-System wählt die Experten aus, die für die jeweilige Eingabe relevant sind.
„600B“ bezeichnet die Gesamtkapazität; es bedeutet nicht, dass jedes Token die Kosten eines dichten 600B-Modells verursacht. Für die Inferenz-Effizienz ist die Zahl der aktiven Parameter aussagekräftiger, doch tatsächliche Leistung hängt weiterhin von Hardware, Batching, Reasoning-Länge und Anbieterkapazität ab.
Ein Kontext mit 1M Tokens und eine Ausgabe mit 64K Tokens
Das Kontextfenster mit 1 Million Tokens ist auf große Repositories, Berichte, Unterhaltungen und Dokumentensammlungen ausgelegt. Die maximale Ausgabe beträgt 64.000 Tokens. Auch bei großem Kontext ist eine disziplinierte Informationssuche wichtig: Mehr Material kann irrelevante Belege, widersprüchliche Anweisungen und höhere Kosten mit sich bringen.
Prompt-Caching macht wiederholte Arbeit mit derselben Codebasis, Richtliniensammlung oder demselben Forschungskorpus deutlich günstiger, als nicht zwischengespeicherte Eingaben wiederholt zu senden.
Text-, Bild- und Videoeingaben
Das Modell akzeptiert Text, bis zu 60 Bilder pro Anfrage und Videos. Bilder können im JPEG-, PNG-, WebP- oder statischen GIF-Format vorliegen. Zu den Videoformaten gehören MP4, QuickTime und Matroska; StepFun empfiehlt Clips mit einer Länge von weniger als fünf Minuten.
In Datenbanken von Drittanbietern werden möglicherweise nur Text- und Bildeingaben aufgeführt. Das widerspricht StepFun nicht unbedingt. Artificial Analysis dokumentiert beispielsweise die Modalitäten, die in seinem Eintrag und seinen Tests abgedeckt werden, während StepFun die Video-Unterstützung in der eigenen API dokumentiert. Für Implementierungslimits sollten Sie die Dokumentation des Anbieters verwenden, für Leistungsvergleiche unabhängige Tests.
Tool-Aufrufe bedeuten keinen integrierten Zugriff auf die Außenwelt
Step 5 Preview unterstützt Streaming, Function Calling, den JSON-Modus, JSON Schema und eine einstellbare Reasoning-Intensität. Das Modell kann jedoch nicht eigenständig im Web suchen, Code ausführen oder auf Dateien von Entwicklern zugreifen. StepFun weist ausdrücklich darauf hin, dass die integrierende Anwendung Suche, Codeausführung, Dokumentenverarbeitung und andere Tools bereitstellen muss.
Das Modell kann entscheiden, wann und wie es ein Tool verwendet. Das umgebende Agentensystem kontrolliert jedoch die verfügbaren Tools, Berechtigungen und Ergebnisvalidierung.
Step 5 Preview für Coding und agentische Aufgaben
In einem Coding-Agent erhält das Modell ein Ziel, liest Dateien, nimmt Änderungen vor, führt Tests aus, wertet Fehler aus und wiederholt den Prozess. Dank des langen Kontexts kann es die Repository-Struktur und frühere Entscheidungen über mehrere Durchläufe hinweg berücksichtigen.
StepFun gibt für das Modell bei hoher Reasoning-Intensität folgende Ergebnisse an:
| Benchmark |
Ergebnis von Step 5 Preview |
Was getestet wird |
| DeepSWE v1.1 |
67.7% |
Softwareentwicklung auf Repository-Ebene |
| StepCodeBench |
49.0% |
Programmieraufgaben in mehreren Sprachen |
| Terminal-Bench v4 |
33.3% |
Coding- und Terminal-Tool-Nutzung |
| Agents’ Last Exam (ALE-CLI) |
29.5% |
Aufgaben für Agenten zur Computernutzung |
| GPQA Diamond |
93.5% |
Reasoning und Wissen auf Hochschulniveau |
| HLE |
46.5% |
Breit gefächerte, schwierige Expertenfragen |
Diese Ergebnisse wurden vom Anbieter gemeldet. StepCodeBench ist ein interner Benchmark; einige Konkurrenzmodelle verwenden die Reasoning-Stufe „Max“, während Step 5 „High“ nutzt; und bei manchen Vergleichen mit HLE und Tools kommen unterschiedliche Teilmengen zum Einsatz. Die Ergebnisse zeigen Leistungsfähigkeit, aber keine garantierte Überlegenheit bei einem bestimmten Repository.
StepFun räumt bei den schwierigsten, lang andauernden Coding-Aufgaben eine erhebliche Leistungslücke ein. Testen Sie die Fehlerbehebung, Funktionserweiterungen, Testgenerierung und das Zurücksetzen von Änderungen mit Ihrem eigenen Code und messen Sie anschließend die Zahl der akzeptierten Aufgaben pro Dollar und Minute.
Frühe Erfahrungsberichte aus der Community sind rar. In einem Launch-Thread auf Linux DO gefiel einem Nutzer das sichtbare Zwischendenken; in Reddit-Diskussionen ging es eher um durchgesickerte oder gespiegelte Gewichte als um die Zuverlässigkeit im Produktivbetrieb. Solche Anekdoten vom Launch-Tag liefern Anhaltspunkte für Tests, aber keine Rangfolge.
Warum Step 5 Preview auf Finanzen ausgerichtet ist
Bei Step 5 Preview im Finanzbereich geht es nicht einfach darum, Fragen zur Buchhaltung zu beantworten. StepFun zielt auf Analysten-Workflows ab, in denen Unternehmensberichte und Marktdaten zusammengetragen, Definitionen abgeglichen, Bewertungen erstellt, Berechnungen durchgeführt und prüfbare Berichte erstellt werden. Quellen, Annahmen, Formeln und Sensitivitäten müssen nachvollziehbar bleiben.
StepFun gibt für den externen Benchmark FrontierFinance 66.4% an. Außerdem meldet das Unternehmen 74.5% bei FinStepBench LiveSearch, 60.6% bei CorporateValuation und 55.8% bei Finance Deep Research. Die letzten drei Benchmarks stammen von StepFun selbst und sollten daher weniger stark gewichtet werden als unabhängige Tests, bis Dritte die Ergebnisse reproduziert haben.
Ein gutes Ergebnis macht unbeaufsichtigte Finanzentscheidungen nicht sicher. Sorgen Sie für nachvollziehbare Quellenangaben, Berechnungsverläufe, Freigabeschritte und menschliche Prüfung – insbesondere bei Anlage-, Kredit-, Steuer- oder Compliance-Entscheidungen.
Wie gut schneidet Step 5 Preview in unabhängigen Tests ab?
Artificial Analysis bewertet Step 5 Preview mit einem Intelligence-Index-Wert von 44. Auf der API von StepFun wurden eine Ausgabe von 99.8 Tokens pro Sekunde, eine Zeit bis zum ersten Token von 2.96 Sekunden und Kosten von $0.72 pro Intelligence-Index-Aufgabe gemessen.
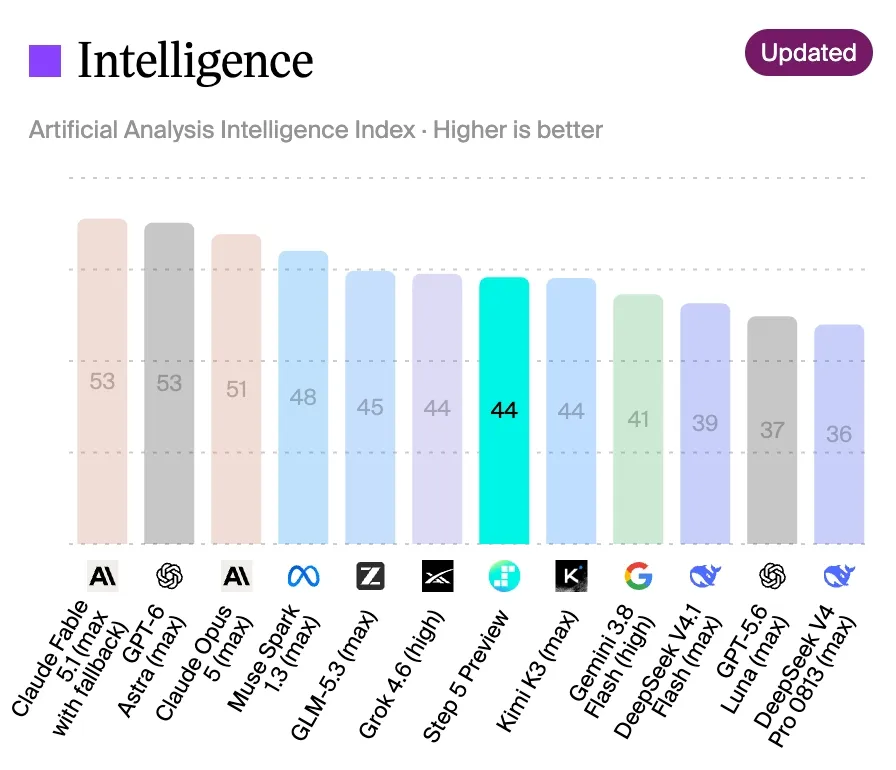
Der wichtige Vorbehalt betrifft die Ausführlichkeit: Bei der Evaluation wurden 160 Millionen Ausgabetokens erzeugt, gegenüber einem Median von 92 Millionen für die Klasse. Selbst ein günstiger Tokenpreis kann zu hohen Kosten pro Aufgabe führen. Deshalb benötigen Produktivsysteme Ausgabelimits, eine angemessene Reasoning-Intensität und Abbruchbedingungen.
Unabhängige Tests führen außerdem Text- und Bildeingaben, aber keine Videoeingaben auf. Das spiegelt den Umfang des Modelleintrags beim Evaluator wider; für die Videofähigkeit ist weiterhin die offizielle API-Dokumentation von StepFun maßgeblich. Wenn Sie diese beiden Arten von Nachweisen getrennt betrachten, wird ein Unterschied im Testumfang nicht fälschlich als Widerspruch interpretiert.
Die Preise von Step 5 Preview erklärt
Auf der offiziellen Preisseite von StepFun werden drei Tarife pro 1 Million Tokens aufgeführt:
| Tokentyp |
Preis |
| Nicht zwischengespeicherte Eingabe |
$1.00 |
| Zwischengespeicherte Eingabe |
$0.05 |
| Ausgabe |
$2.70 |
Bei Step 5 Preview umfasst der Preis für Eingaben bei einem Cache-Miss das Schreiben neuer Inhalte in den Cache. Bei der Abrechnung der Ausgabe zählen sowohl Reasoning-Tokens als auch die endgültige Antwort; verstecktes Reasoning ist also nicht kostenlos.
Zum Beispiel kosten 100.000 nicht zwischengespeicherte Eingabetokens plus 10.000 Ausgabetokens etwa $0.127. Ist die Eingabe vollständig zwischengespeichert, kostet dieselbe Anfrage etwa $0.032. Tool-Schleifen, Wiederholungen und die Länge des Reasonings können die Gesamtkosten verändern.
Das ist der Preis von StepFun, nicht der Preis von GPT Proto. GPT Proto hat das Modell noch nicht aufgenommen, daher gibt es keinen gültigen GPT Proto-Preis für Step 5 Preview.
Step 5 Preview im Vergleich zu GLM 5.3 Flash und DeepSeek Flash
Diese Tabelle verwendet Daten von Artificial Analysis mit Stand vom 21. September 2026. DeepSeek Flash bezeichnet DeepSeek V4.1 Flash bei maximaler Reasoning-Intensität.
| Modell |
Intelligence Index |
Ausgabegeschwindigkeit |
Eingabe / Ausgabe pro 1M Tokens |
Kosten pro Aufgabe |
Kontext |
Gewichte |
| Step 5 Preview |
44 |
99.8 tok/s |
$1.00 / $2.70 |
$0.72 |
1M |
Geplant für 15. Okt. |
| GLM 5.3 Flash |
42 |
95.0 tok/s |
$0.15 / $0.50 |
$0.25 |
1M |
Offen, MIT |
| DeepSeek V4.1 Flash |
39 |
242.3 tok/s |
$0.30 / $1.20 |
$0.27 |
1M |
Offen, MIT |
GLM 5.3 Flash im Vergleich zu Step 5 Preview
Step 5 Preview liegt beim Index um zwei Punkte vorn und erreicht eine ähnliche Geschwindigkeit. GLM ist deutlich günstiger, und seine MIT-lizenzierten Gewichte sind bereits verfügbar. Step 5 ist für Finanz-Workflows oder offizielle Videoeingaben interessanter; GLM ist der bessere Ausgangspunkt, wenn Kosten und Self-Hosting wichtig sind.
Step 5 Preview im Vergleich zu DeepSeek Flash
Step 5 liegt beim Index um fünf Punkte vorn, aber DeepSeek ist mehr als doppelt so schnell, kostet pro Aufgabe deutlich weniger und ist bereits als Open-Weight-Modell verfügbar. Wählen Sie Step 5 nur, wenn sein Reasoning genug zusätzliche akzeptierte Arbeit liefert, um langsamere und teurere Durchläufe zu rechtfertigen.
GPT Proto bietet derzeit sowohl GLM 5.3 Flash als auch DeepSeek Flash an. Einen ausführlicheren Vergleich dieser verfügbaren Optionen finden Sie unter GLM 5.3 Flash im Vergleich zu DeepSeek V4 Flash.
Wie können Sie auf Step 5 Preview zugreifen?
Entwickler können StepFuns Endpunkt POST /v1/chat/completions mit der Modell-ID step-5-preview aufrufen. Das Anfrageformat entspricht dem OpenAI-Stil für Chat-Completions. Dieses Beispiel richtet sich direkt an StepFun; es ist kein GPT Proto-Endpunkt.
curl https://api.stepfun.ai/v1/chat/completions \
  -H "Content-Type: application/json" \
  -H "Authorization: Bearer $STEP_API_KEY" \
  -d '{
    "model": "step-5-preview",
    "messages": [
      {
        "role": "user",
        "content": "Review this repository migration plan and list the three highest-risk assumptions."
      }
    ],
    "reasoning_effort": "medium",
    "max_tokens": 1200
  }'
Vor dem Einsatz in der Produktion sollten Sie in der offiziellen API-Referenz die aktuellen Parameter, Fehlermeldungen, Ratenlimits und multimodalen Anfrageformate prüfen.
Wenn Sie einen einzigen Kontostand und eine einheitliche Oberfläche für viele Modelle bevorzugen: GPT Proto plant, Step 5 Preview später hinzuzufügen. Solange das Modell nicht im aktuellen Katalog erscheint, sollten Sie nicht davon ausgehen, dass ein ähnlicher Name, ein Drittanbieter-Mirror oder eine inoffizielle Route die GPT Proto-Integration ist.
Lohnt es sich, Step 5 Preview auszuprobieren?
Step 5 Preview sollte für lange Dokumente, Coding-Agenten, multimodale Forschung oder nachvollziehbare Finanz-Workflows kontrolliert evaluiert werden. Der unabhängige Intelligence-Index-Wert ist stark, und der Kontext mit 1M Tokens ist nützlich.
Es ist nicht die Standardwahl. GLM ist günstiger und als Open-Weight-Modell verfügbar; DeepSeek ist deutlich schneller; und Step 5 ist weiterhin ausführlich, in der Preview-Phase und bei GPT Proto nicht verfügbar.
Die beste Entscheidungsgrundlage ist die erledigte und geprüfte Arbeit – nicht die Parameterzahl oder ein einzelner Benchmark. Führen Sie dieselben repräsentativen Aufgaben mit jedem Kandidaten aus, erfassen Sie Korrektheit, Eingriffsrate, Latenz und Gesamtkosten für Tokens und wählen Sie dann das Modell, das die niedrigsten Kosten pro akzeptiertem Ergebnis erzielt.