Warum der Leak des Claude-Quellcodes für Entwickler heute wichtig ist
Manchmal stammen die besten Lektionen der Softwareentwicklung aus unbeabsichtigten Offenlegungen. Der jüngste Leak des Claude-Quellcodes, der entstand, als Anthropic versehentlich vollständige Source Maps in einem öffentlichen npm-Paket veröffentlichte, ist ein hervorragendes Beispiel. Für alle, die im KI-Bereich entwickeln, war es, als hätte jemand einen Lehrplan für eine Meisterklasse auf einer Parkbank liegen lassen.
Dies war nicht nur ein kleiner Ausrutscher: Der Leak des Claude-Quellcodes offenbarte die interne TypeScript-Logik von Claude Code. Er gab uns einen seltenen, unverfälschten Einblick darin, wie ein führendes Forschungslabor einen produktionsreifen KI-Agenten strukturiert. Es ging um die konkrete Umsetzung komplexer Tool-Schleifen und kritischer Berechtigungen.
Der Vorfall wurde schnell behoben, doch die Erkenntnisse aus dem Leak des Claude-Quellcodes kursieren weiterhin unter Praktikern. Er macht deutlich, was es bedeutet, mit einem KI-zentrierten Ansatz zu entwickeln, und zeigt, dass selbst die größten Unternehmen beim Veröffentlichen von Code in der unberechenbaren npm-Welt vor Herausforderungen stehen.
Darum geht es: Nur selten sehen wir das Gerüst hinter diesen Modellen. Der Leak des Claude-Quellcodes zog den Vorhang vor der „Agentenschleife“ zurück. Er zeigte genau, wie Anthropic in Echtzeitumgebungen mit dem Spannungsfeld zwischen menschlicher Absicht und maschineller Ausführung umgeht.
Das Source-Map-Problem hinter dem Leak des Claude-Quellcodes
Die Ursache des Leaks war erstaunlich banal. In der Eile beim Weiterentwickeln hat ein Entwickler vermutlich vergessen, die Source Maps vor der Veröffentlichung in der npm-Registry zu entfernen. Dadurch konnte jeder mit einem Decompiler die ursprünglichen TypeScript-Dateien aus dem obfuskierten JavaScript rekonstruieren.
Es handelt sich um einen Fehler, den wir wahrscheinlich alle schon beinahe gemacht haben. Im Zusammenhang mit dem Leak des Claude-Quellcodes wurde er jedoch zu einer großen Lernchance für die Community. Wir erfuhren, dass das Tool auf Node.js basiert und React mit Ink für seine Terminaloberfläche verwendet.
Der eigentliche Wert des Leaks lag jedoch in der Logik. Die Source Maps lieferten eine Landkarte für den Umgang mit asynchronen Tool-Aufrufen bei gleichzeitig reaktionsschneller Terminaloberfläche. Es war eine Meisterklasse moderner TypeScript-Architektur, speziell für eine KI-Anwendung optimiert.
Und seien wir ehrlich: Der Leak gab uns auch einen Einblick in die menschliche Seite von Anthropic. Der Code war sauber, gut kommentiert und zeigte ein tiefes Sicherheitsbewusstsein. Er bewies, dass sich gute Entwicklungspraktiken selbst in einem Leak abheben und Respekt verdienen.
Der Leak des Claude-Quellcodes erinnert daran, dass Transparenz in der KI-Architektur – selbst wenn sie unbeabsichtigt entsteht – dem gesamten Entwicklerökosystem hilft, seine Implementierungsstrategien zu verbessern.
Aus Sicherheitsfehlern im Leak des Claude-Quellcodes lernen
Jeder Entwickler weiß, dass Sicherheit aus mehreren Ebenen besteht. Der Leak bestätigte, dass Anthropic dieses Thema sehr ernst nimmt. Obwohl der Leak selbst ein Sicherheitsversäumnis war, zeigte der interne Code einen ausgeklügelten Ansatz für Sandboxing und Nutzereinwilligung, der viele überraschte.
Bei der Analyse des Leaks erkennen wir, wie zwischen sicheren und unsicheren Befehlen unterschieden wird. Das Modell wird nicht blind vertraut. Ein mehrstufiger Prüfprozess stellt sicher, dass die KI auf dem lokalen Dateisystem nicht außer Kontrolle gerät.
Diese Erkenntnisse lassen sich auf eigene Projekte übertragen. Wer ein Tool entwickelt, das über eine API Code ausführt, benötigt eine Berechtigungspipeline. Der Leak zeigte genau, wie eine solche Pipeline in der Produktion aussehen kann.
Wenn Sie der Entwicklung voraus sein möchten, behalten Sie die neuesten Updates aus der KI-Branche im Blick, um zu sehen, wie andere Unternehmen auf solche Offenlegungen reagieren. Der Leak ist nur ein Kapitel in der sich entwickelnden Geschichte der KI-Sicherheit.
Architektur-Erkenntnisse aus dem Leak des Claude-Quellcodes
Die zentrale Architektur basiert auf einer „berechtigungsgeprüften Streaming-Tool-Schleife“. Das klingt kompliziert, ist aber elegant: Das Modell beginnt sofort mit der Arbeit, noch bevor es seine Überlegungen zur gesamten Aufgabe abgeschlossen hat.
Das System ist auf hohe Reaktionsfähigkeit ausgelegt. Sobald das Modell ein Tool aufrufen muss, erfolgt die Ausführung als Stream. Dadurch sinkt die wahrgenommene Latenz für den Nutzer – ein großes Problem vieler KI-Anwendungen.
Eine weitere interessante Erkenntnis war der Einsatz von React und Ink. Eine Kommandozeilenoberfläche, die sich so flüssig wie eine Web-App anfühlt, ist schwer umzusetzen. Die komponentenbasierte Darstellung von Terminalausgaben ist dafür ein geeigneter Ansatz.
Der Leak zeigte außerdem einen mehrstufigen Startprozess. Das Tool lädt seine Komponenten schrittweise und priorisiert zunächst die Sicherheitsmodule. So wird die Vertrauensgrenze eingerichtet, bevor umfangreiche KI-Logik oder API-Aufrufe im Hintergrund initialisiert werden.
Streaming-Tools im Leak des Claude-Quellcodes
Bei einfachen Implementierungen wartet man auf die vollständige API-Antwort. Der Leak zeigte einen besseren Ansatz: Durch das Streamen von Tool-Aufrufen kann der Agent bereits einen Bash-Befehl ausführen, während das Modell noch beschreibt, was es tut.
Diese „Streaming zuerst“-Mentalität zieht sich durch das gesamte System. Tools werden als gleichzeitig sicher oder seriell eingestuft. So kann das Framework die Ausführungsreihenfolge optimieren, ohne dass Nutzer komplexe Threading-Logik manuell verwalten müssen.
Startet das Modell einen gefährlichen Befehl, kann das System den Prozess während des Streams beenden. Unterbrechbarkeit ist ein zentraler Bestandteil der Architektur und kein nachträglicher Zusatz.
Für Nutzer einer einheitlichen API sind diese Muster besonders wertvoll. Sie können die vollständige API-Dokumentation lesen, um ähnliche Streaming-Muster bei der Anbindung verschiedener LLMs über eine einzige Schnittstelle umzusetzen.
Der Leak zeigt auch den Umgang mit der „Tool-Suche“. Statt jede Tool-Definition in den Prompt zu laden, sucht das System die passende Definition bei Bedarf. Das spart viele Tokens und hält das Kontextfenster übersichtlich.
Es geht um Effizienz. Die Verwaltung des Prompts ist ebenso wichtig wie die Verwaltung des Codes. Werden Tool-Schemata nur bei Bedarf angezeigt, bleiben API-Kosten niedrig und die Geschwindigkeit hoch.
Ein Dienst wie GPT Proto kann helfen, diese Kosten weiter zu optimieren. GPT Proto bietet bis zu 70 % Rabatt auf gängige KI-APIs – entscheidend bei häufigen Tool-Schleifen wie denen, die der Leak sichtbar machte.
Die Agentenschleife im Leak des Claude-Quellcodes verwalten
Die Agentenschleife bildet das Herzstück des Systems. Sie ist als robuste Zustandsmaschine umgesetzt und verarbeitet Nutzereingaben, Modellausgaben, Tool-Ausführung und Fehlerbehandlung zuverlässig.
Besonders auffällig ist der Umgang mit mehrstufigen Aufgaben. Das System wiederholt nicht einfach blind Aktionen, sondern merkt sich bereits unternommene Versuche und verhindert so endlose Rekursionen fehlschlagender Befehle.
Der Leak enthüllte außerdem einen „Mailbox“-Mechanismus für die Zusammenarbeit mehrerer Agenten innerhalb desselben Prozesses. Dadurch können Systemteile Berechtigungen und Statusaktualisierungen synchronisieren, ohne komplexe Interprozesskommunikation zu benötigen.
Diese interne Koordination macht Claude Code so leistungsfähig. Der Leak lieferte eine Blaupause für Agenten, die tatsächlich als Team arbeiten können – ein deutlicher Fortschritt gegenüber den üblichen einmaligen Prompts.
Die vierstufige Berechtigungspipeline des Claude-Quellcode-Leaks
Sicherheit ist die größte Hürde für KI-Agenten mit Schreibzugriff auf einen Rechner. Der Leak offenbarte ein vierstufiges Abwehrsystem, das schädliche Absichten erkennt, bevor sie der Umgebung Schaden zufügen können.
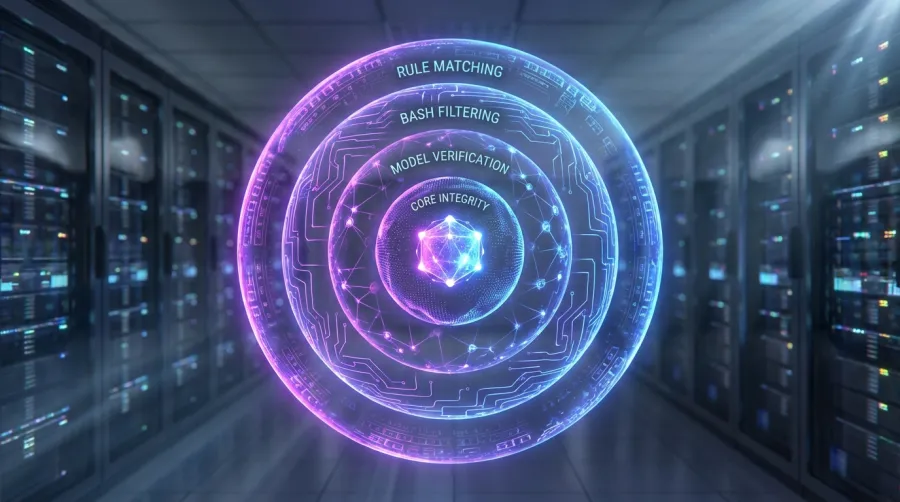
Zuerst prüft ein „Rule Matcher“ Benutzerkonfigurationen schnell und deterministisch. Ist der Zugriff auf ein bestimmtes Verzeichnis gesperrt, stoppt diese Ebene die KI sofort – ohne teuren API-Aufruf.
Danach folgt der „Bash Classifier“. Mithilfe von Regex-Mustern und Heuristiken sucht er nach bekannten gefährlichen Befehlen. Das ist einfach, aber wirksam und bildet die erste Verteidigungslinie gegen offensichtlichen Schadcode oder versehentliche Löschungen.
Die dritte Ebene ist der „Transcript Classifier“. Er untersucht den Gesprächskontext und fragt: „Ergibt dieser Befehl angesichts der Nutzeranfrage tatsächlich Sinn?“
Ist das System weiterhin unsicher, ruft es unabhängig ein separates, kleineres Claude-Modell auf. Dieses „Schiedsrichter“-Modell bewertet ausschließlich die Sicherheit der geplanten Aktion und schafft einen guten Ausgleich zwischen Geschwindigkeit und Schutz.
Ein tieferer Blick auf die Sicherheitslogik des Claude-Quellcode-Leaks
Der Einsatz eines unabhängigen Sicherheitsmodells ist eine zentrale Erkenntnis. Er verhindert, dass der Hauptagent seine eigene Arbeit kontrolliert – ein Mechanismus, der durch Prompt Injection leicht umgangen werden könnte. Das Schiedsrichtermodell bleibt objektiv.
Auch Modi mit automatischer Genehmigung werden durch interne Filter geschützt. Selbst bei vollständiger Kontrolle durch die KI bleiben die Sicherheitsprüfungen aktiv: „Wir vertrauen dir, aber auch unseren Sicherheitskontrollen.“
Dieser mehrschichtige Ansatz minimiert Fehlalarme und maximiert die Sicherheit. Man benötigt kein einziges riesiges Modell für alle Aufgaben, sondern kann spezialisierte Tools und APIs kombinieren, um die Zuverlässigkeit deutlich zu erhöhen.
Wer sich wegen der Kosten zusätzlicher Sicherheitsaufrufe sorgt, kann die API-Abrechnung effizienter verwalten, indem die kostengünstigsten verfügbaren Modelle für die jeweilige Aufgabe eingesetzt werden.
- Regelbasierte Filterung zur sofortigen Blockierung
- Mustererkennung für bekannte gefährliche Bash-Befehle
- Kontextuelle Analyse des Gesprächsverlaufs
- Unabhängige Modellprüfung für Aktionen mit hohem Risiko
Vertrauensgrenzen auf Grundlage des Claude-Quellcode-Leaks umsetzen
Eine „Vertrauensgrenze“ ist der Punkt, an dem die KI von einem Änderungsvorschlag zur tatsächlichen Ausführung übergeht. Der Leak zeigt, dass diese Grenze im Code ausdrücklich verwaltet wird. Sie ist kein einfacher boolescher Wert, sondern ein komplexer Zustand.
Aufgaben vor und nach der Nutzerbestätigung werden getrennt behandelt. So kann die KI selbst im Hintergrund keine sensiblen Systembereiche berühren, ohne ein ausdrückliches „grünes Licht“ des Entwicklers.
Dieses Design verhindert, dass die KI durch Halluzinationen in einen geschützten Ordner gelangt. Ein gutes KI-Tool sollte den Modellausgaben ebenso skeptisch gegenüberstehen wie der Nutzer. Sicherheit ist ein kontinuierlicher Prüfprozess.
Berechtigungen sollten granular sein. Geben Sie einem Agenten nicht einfach „Zugriff“, sondern Zugriff auf eine bestimmte Aufgabe, für eine bestimmte Dauer und unter bestimmten Bedingungen. Genau das ist der hier gezeigte Goldstandard der KI-Sicherheit.
Token-Optimierung und Kontextverwaltung im Claude-Quellcode-Leak
Ein großes Problem bei APIs ist das begrenzte Kontextfenster. Die Anthropic-Ingenieure erweisen sich als Meister der Kontextverwaltung: Sie laden nicht einfach das gesamte Projekt in den Prompt und hoffen auf das Beste.
Das System erstellt den Prompt dynamisch aus Quellen wie CLAUDE.md, Speicherdateien und dem aktuellen Git-Status. So erhält das Modell genau die benötigten Informationen und nichts Überflüssiges, wodurch die Token-Anzahl niedrig bleibt.
Wenn das Kontextfenster voll wird, stürzt das System nicht ab. Eine automatische Zusammenfassung komprimiert die ältesten Gesprächsteile und schafft Platz für neue Informationen.
Dieser fortlaufende Kontext ist für lange Sitzungen entscheidend. Er bewahrt über Stunden hinweg die Kohärenz und verbindet lokales Dateisystem mit entfernter KI-API.
Intelligente Kontextkomprimierung im Claude-Quellcode-Leak
Die Zusammenfassungsstrategie löscht alte Nachrichten nicht einfach. Die KI fasst zentrale Erkenntnisse und Zustandsänderungen zusammen. So bleibt der wichtige Kontext erhalten, während überflüssige Inhalte entfallen.
Außerdem gibt es ein standardmäßiges Limit für Ausgabetokens. Das verhindert ausufernde Antworten, verbessert die Prägnanz und senkt Antwortzeit sowie API-Kosten.
Wer eigene Tools entwickelt, kann die API-Nutzung in Echtzeit überwachen, um die Auswirkungen verschiedener Strategien auf die Kosten zu beurteilen. Der Leak bietet dafür eine gute Vorlage.
Eine weitere Erkenntnis sind „Memory“-Dateien. Dabei handelt es sich um lokale Dateien, in denen der Agent langfristige Projektinformationen speichert. Sie dienen als dauerhafter Zusatzkontext zwischen Sitzungen und Modellaufrufen.
Lokaler Speicher ist der beste Freund von KI-Entwicklern. Nicht jede Information muss jedes Mal an das Modell gesendet werden. Wer Daten lokal speichert und nur bei Bedarf übermittelt, gewinnt bei Geschwindigkeit und Kosten.
| Kontextstrategie |
Im Leak offenbarte Methode |
Vorteil |
| Prompt-Erstellung |
Zusammenstellung aus mehreren Quellen (Git, MD, lokale Dateien) |
Hochrelevanter Kontext mit weniger irrelevanten Tokens. |
| Fensterverwaltung |
Automatische Zusammenfassung früher Nachrichten |
Sitzungen ohne spürbare Begrenzung, ohne Limits zu erreichen. |
| Ausgabekontrolle |
Strenge Token-Limits und Streaming |
Schnellere Antworten und niedrigere API-Kosten pro Durchlauf. |
Progressive Offenlegung von Tools im Claude-Quellcode-Leak
Eine der innovativsten Erkenntnisse ist die „progressive Offenlegung“. Die meisten KI-Agenten definieren alle Tools im System-Prompt. Bei 50 Tools sind bereits Tausende Tokens verbraucht, bevor der Nutzer ein Wort eingibt.
Claude Code stellt zunächst nur die Tool-Namen bereit. Erkennt das Modell, dass es ein Tool benötigt, ruft es über eine spezielle „ToolSearch“-Funktion das vollständige JSON-Schema dieses Tools ab. Das ist ein großer Effizienzgewinn.
So kann eine große Bibliothek von „Skills“ bereitgestellt werden, ohne den Prompt aufzublähen. Hunderte spezialisierte Tools können verfügbar sein, während das Modell nur für die tatsächlich verwendeten Tools „bezahlt“.
Der Leak zeigt ein klares Verständnis der KI-Ökonomie: Jeder Token kostet. Werden Tool-Definitionen erst bei Bedarf geladen, sinken die Kosten und die Reaktionsfähigkeit steigt.
Erweiterbarkeit und das Skill-System im Claude-Quellcode-Leak
Der Leak enthüllte ein sehr flexibles „Skill“-System. Ein Skill ist im Wesentlichen eine Markdown-Datei, die bestimmte Fähigkeiten beschreibt. Sie enthält Metadaten darüber, wann der Skill aktiviert wird und welche Tools er benötigt.
Skills werden kontextabhängig aktiviert. Wird beispielsweise eine Python-Datei bearbeitet, werden Python-spezifische Skills geladen. So bleibt die KI auf die aktuelle Aufgabe fokussiert.
Der Leak zeigte außerdem ein leistungsfähiges „Hook“-System. Entwickler können an verschiedenen Punkten des Lebenszyklus eigene Logik einschleusen – vor dem Start eines Tools, nach dessen Abschluss oder beim Beginn einer Sitzung.
Diese Erweiterbarkeit macht Claude Code zu mehr als einer einfachen Hülle. Es ist ein Framework, auf dem die Community spezialisierte KI-Coding-Assistenten entwickeln kann.
Eigene Skills auf Grundlage des Claude-Quellcode-Leaks entwickeln
Das Markdown-basierte Skill-System ist besonders praktisch, weil es für Menschen lesbar ist. Für eine neue Fähigkeit genügt eine Beschreibung mit einfachen Triggern – dafür ist keine Senior-Erfahrung erforderlich.
Die Skills werden indexiert und über eine lokale Datenbank schnell anhand des aktuellen Dateipfads oder Git-Branches gefunden. So lässt sich eine große Zahl von Erweiterungen effizient verwalten.
Der Leak deutet außerdem auf eine Art „Marketplace“ hin. Die Struktur für den Austausch von Skills zwischen Nutzern ist vorhanden und könnte ein lebendiges Ökosystem ähnlich den VS-Code-Erweiterungen ermöglichen.
Wer eigene Agenten entwickeln möchte, kann die intelligenten KI-Agenten von GPT Proto ausprobieren, die häufig solche modularen Skill-Systeme integrieren. Das ist besonders dank der Erkenntnisse aus dem Leak leichter als ein Start von Grund auf.
Model Context Protocol (MCP) im Claude-Quellcode-Leak
Der Leak bestätigte die enge Integration des Model Context Protocol (MCP). Dabei handelt es sich um einen Standard, über den KI-Modelle mit externen Datenquellen und Tools interagieren. MCP entwickelt sich zum Branchenstandard für agentische Workflows.
Der Agent unterstützt mehrere MCP-Server und verwendet eine dreistufige Authentifizierung. So wird sichergestellt, dass nur autorisierte Tools mit dem Modell kommunizieren können – entscheidend für eine sichere Umgebung.
MCP ist kein bloßes Zusatzmodul, sondern ein Kernbestandteil der Architektur. Die Tool-Schleife verarbeitet asynchrone MCP-Aufrufe und hält die Benutzeroberfläche auch beim Warten auf externe Daten reaktionsfähig.
Durch diese Integration kann Claude Code mit vielen Diensten kommunizieren. Von Datenbank-Connectors bis zu Websuch-Tools bietet MCP eine einheitliche Schnittstelle, die die Entwicklung von KI-Agenten vereinfacht.
Die verborgene unterhaltsame Seite und die Zukunft des Claude-Quellcode-Leaks
Neben der ernsthaften Technik enthüllte der Leak auch Persönlichkeit. Tief in den Dateien befand sich ein vollständiges System für ein elektronisches Haustier namens „Buddy“, offenbar als Aprilscherz mit 18 Arten und ASCII-Animationen geplant.
„Buddy“ erinnert daran, dass die Menschen hinter komplexen Systemen auch Spaß haben. Dieses kleine Detail macht das Projekt zugänglicher und menschlicher. Selbst führende KI-Forscher freuen sich über ein gutes Easter Egg.
Auf der geschäftlichen Seite zeigt der Leak einen Weg zur „Schwarm“-Intelligenz. Der Code unterstützt die Zusammenarbeit mehrerer Agenten in einem Prozess – eine nächste Entwicklungsstufe der KI-gestützten Programmierung.
Der Leak deutet außerdem auf ein dauerhaftes Aufgabensystem hin. Damit kann die KI cron-ähnliche Jobs im Hintergrund ausführen, etwa Tests starten oder einen Server überwachen, auch wenn der Nutzer nicht am Rechner sitzt.
Buddy-Systeme und Schwärme im Claude-Quellcode-Leak
Die „Swarm“-Funktion ist besonders beeindruckend. Mit `AsyncLocalStorage` in Node.js hält sie die Kontexte verschiedener Agenten innerhalb desselben Threads getrennt. Das ist ein ressourcenschonender Ansatz für die Orchestrierung mehrerer Agenten.
Statt für jeden Agenten einen neuen, langsamen und speicherintensiven Prozess zu starten, hält dieser Ansatz alles leichtgewichtig. Er ist eine Meisterklasse der Node.js-Optimierung für KI-Workloads.
Die Schwärme kommunizieren über eine gemeinsame „Mailbox“, über die sie Nachrichten austauschen und Berechtigungen synchronisieren. So bleiben alle Agenten jederzeit an den Zielen und Sicherheitspräferenzen des Nutzers ausgerichtet.
Diese Architektur ist eine Blaupause für die Zukunft der Arbeit. Statt eines einzigen KI-Assistenten werden wir Schwärme spezialisierter Agenten haben, die nahtlos zusammenarbeiten.
Was uns der Leak des Claude-Quellcodes über produktive KI lehrt
Die wichtigste Erkenntnis ist, dass produktive KI zu 90 % aus Engineering und zu 10 % aus Modellaufrufen besteht. Die Komplexität liegt nicht darin, das Modell zum Sprechen zu bringen, sondern in Berechtigungen, Kontext und einer reaktionsfähigen Benutzeroberfläche.
Ein erfolgreiches KI-Tool muss mit einem sicherheits- und effizienzorientierten Ansatz entwickelt werden. Eine API auf ein Skript zu setzen reicht nicht. Erforderlich ist ein robustes Framework, das mit unvorhersehbaren KI-Ausgaben umgehen kann.
Wer etwas auf diesem Niveau entwickeln möchte, sollte alle verfügbaren KI-Modelle erkunden, um das richtige Gleichgewicht aus Geschwindigkeit und Intelligenz zu finden. Selbst die besten Modelle benötigen eine starke unterstützende Codebasis.
Und Sie müssen es nicht allein tun. Mit einer Plattform wie GPT Proto können Sie mehrere Modelle über eine einzige API nutzen und so Multi-Agenten-Schwärme sowie Schiedsrichtermodelle leichter implementieren.
Nutzen Sie also die Lehren aus dem Leak und beginnen Sie mit dem Entwickeln. Die Blaupause ist verfügbar, die Tools stehen bereit, und das Potenzial KI-gestützter Entwicklung wird gerade erst sichtbar. Denken Sie nur daran, Ihre Source Maps vor der Veröffentlichung zu entfernen.
Verfasst von: GPT Proto
„Erschließen Sie die weltweit führenden KI-Modelle mit der einheitlichen API-Plattform von GPT Proto.“