Preços de API 30% Mais Baixos
A GPTProto lista entrada de texto a US$ 0,42 e saída de áudio a US$ 8,40 por 1M de tokens—30% abaixo dos preços publicados de US$ 0,60 e US$ 12,00 da OpenAI.

Chat, agentes de programação e trabalho com documentos. Preço por 1M de tokens — entrada, entrada em cache e saída são cobradas separadamente. GPTProto está 30% abaixo das tarifas oficiais.
| Cenário | Lista de OpenAI | OpenRouter | GPTProto | Economia / mês |
|---|---|---|---|---|
| Pessoal10M tokens / mês | $28.80 | $30.38 | $20.16 | −$8.64≈ $103.68 / ano |
| Equipe100M tokens / mês | $288.00 | $303.84 | $201.60 | −$86.40≈ $1036.80 / ano |
| Empresarial500M tokens / mês | $1440.00 | $1519.20 | $1008.00 | −$432.00≈ $5184.00 / ano |
Gere fala com som natural e controle em linguagem simples sobre sotaque, emoção, entonação, ritmo, tom e sussurro. A acessível API GPT-4o-mini-TTS na GPTProto usa uma única chave de API e o mesmo saldo de conta que 200+ outros modelos de IA.
Preços de API 30% Mais Baixos
A GPTProto lista entrada de texto a US$ 0,42 e saída de áudio a US$ 8,40 por 1M de tokens—30% abaixo dos preços publicados de US$ 0,60 e US$ 12,00 da OpenAI.
Geração de Fala Direcionável
Descreva em linguagem natural como uma frase deve soar. Direcione o sotaque, a variação emocional, a entonação, o ritmo, o tom ou o sussurro pelo campo de instruções do modelo.
13 Vozes Integradas
Escolha entre 13 vozes documentadas, incluindo alloy, coral, marin e cedar. A OpenAI atualmente recomenda marin ou cedar quando a qualidade da saída é a prioridade.
Streaming e Seis Formatos
Retorne áudio em MP3, Opus, AAC, FLAC, WAV ou PCM. O streaming permite que a reprodução comece antes que o arquivo completo esteja disponível; WAV e PCM evitam a sobrecarga de decodificação em fluxos de trabalho sensíveis à latência.
O GPT-4o-mini-TTS é o modelo de texto para fala da OpenAI para aplicativos que já têm texto escrito e precisam de áudio falado controlável. Ele aceita apenas texto e retorna apenas áudio. Ao contrário de um modelo de chat geral, ele não foi projetado para analisar imagens, transcrever fala recebida, manter um longo histórico de conversa ou retornar uma resposta em texto.
A principal vantagem do modelo em relação aos fluxos de TTS mais antigos baseados em configurações predefinidas é o campo instructions. Em vez de selecionar apenas uma voz e uma velocidade, os desenvolvedores podem descrever a entrega pretendida em linguagem natural: calma ou animada, conversacional ou formal, suave ou enérgica, com orientações para sotaque, ritmo, entonação e ênfase. Isso torna a API GPT-4o-mini-TTS da OpenAI útil para narração, onboarding de produto, áudio de acessibilidade, diálogos de jogos e respostas faladas geradas a partir da saída de texto de um aplicativo.
| Especificação | GPT-4o-mini-TTS |
| String do modelo | gpt-4o-mini-tts |
| Modalidade de entrada | Texto |
| Modalidade de saída | Áudio |
| Entrada máxima | 2.000 tokens de entrada por solicitação |
| Vozes integradas | 13 |
| Formatos de saída | MP3, Opus, AAC, FLAC, WAV, PCM |
| Entrega | Resposta de áudio completa ou áudio em streaming |
| Velocidade ajustável | 0.25 a 4.0; padrão 1.0 |
| Preços do GPTProto | $0.42 por entrada de texto / $8.40 por saída de áudio por 1M de tokens |
O GPT-4o-mini-TTS documenta atualmente as vozes integradas alloy, ash, ballad, coral, echo, fable, nova, onyx, sage, shimmer, verse, marin, e cedar. A OpenAI recomenda experimentar marin ou cedar primeiro para obter uma saída focada em qualidade. As vozes podem gerar fala em vários idiomas, mas são otimizadas para o inglês. Por isso, teste nomes, siglas, números e a pronúncia local com roteiros reais antes do lançamento.
A voz e o formato resolvem problemas diferentes. A voz determina o som base; a instrução controla a entrega; o formato de resposta determina como o áudio se encaixa no produto.
| Formato | Ideal para |
| MP3 | Reprodução geral na web, downloads e arquivos compactos |
| Opus | Streaming pela internet e aplicativos de comunicação |
| AAC | Aplicativos móveis e fluxos de publicação de vídeo |
| FLAC | Armazenamento sem perdas, edição e arquivamento |
| WAV | Reprodução de baixa latência e edição de áudio sem decodificação de áudio compactado |
| PCM | Áudio bruto de 24 kHz, 16 bits little-endian para pipelines de reprodução personalizados |
Use o MP3 como padrão prático. Escolha Opus quando a largura de banda for importante, FLAC quando o armazenamento sem perdas for importante e WAV ou PCM quando evitar a sobrecarga de decodificação for mais importante do que o tamanho do arquivo.
Um prompt útil do GPT-4o-mini-TTS descreve quatro coisas: o papel do falante, o ouvinte, a intenção emocional e a entrega. Mantenha o roteiro falado no campo input e coloque a direção de voz no campo instructions. Essa separação torna os prompts mais fáceis de reutilizar e testar.
| Aplicação | Exemplo de prompt com instructions |
| Suporte ao cliente | Fale com calma e de forma tranquilizadora. Use um tom de conversa caloroso, ritmo moderado e ênfase suave no próximo passo. Não soe excessivamente alegre. |
| Onboarding de produto | Soe amigável, claro e confiante. Mantenha um ritmo ágil, faça uma pausa breve após cada ação e enfatize os nomes dos botões sem soar como um anúncio. |
| Narração em formato curto | Use um estilo documental intimista com energia controlada. Comece com suavidade, desperte curiosidade no meio e diminua o ritmo na frase final. |
| Leitura de acessibilidade | Leia com clareza em um ritmo constante. Pronuncie cada número e sigla de forma distinta, evite emoção dramática e faça pausas entre títulos e corpo do texto. |
Altere uma variável por vez ao testar uma voz da API GPT-4o-mini-TTS. Primeiro selecione a voz base, depois refine o tom e o ritmo e, por fim, teste a pronúncia. Isso facilita identificar se um problema vem da escolha da voz, da instrução ou do texto de origem.
Narração e locuções: Converta artigos, vídeos de produto, lições e roteiros curtos em áudio falado consistente.
Orientação no aplicativo: Leia em voz alta etapas de onboarding, alertas, dicas de navegação ou resumos gerados.
Saída de agente de voz: Transforme uma resposta de texto de um assistente em fala transmitida em streaming. Use um fluxo de trabalho da API Realtime quando o produto precisar de interação bidirecional completa, de fala para fala.
Acessibilidade: Adicione versões faladas de mensagens, documentos e conteúdo de interface para usuários que preferem ou precisam de áudio.
Entrega multilíngue: Gere fala a partir de texto em idiomas suportados e teste cada idioma de destino, pois as vozes integradas são otimizadas para o inglês.
A entrada máxima é de 2.000 tokens por solicitação, e não uma janela de contexto de 128K. Divida materiais mais longos nos limites de frases ou parágrafos. Reutilize a mesma voz, instrução, velocidade e formato de resposta para cada segmento e evite cortar uma frase, número ou nome próprio entre duas solicitações. Após a geração, ouça as emendas para verificar se há pausas repetidas, ênfase inconsistente ou mudanças de pronúncia.
Para reprodução interativa, solicite streaming para que o aplicativo possa começar a reproduzir o áudio antes de a geração terminar. Para narração pré-gravada, gere arquivos completos e faça uma verificação de qualidade antes de publicar. Em ambos os casos, informe claramente aos usuários finais que a voz é gerada por IA e não humana.
Guias, comparações e atualizações relacionadas a este modelo.
Todos os artigos
Compare as melhores ferramentas de IA de texto para fala para TikTok e YouTube, incluindo opções gratuitas, qualidade de voz, direitos comerciais, fluxos de trabalho de vídeo e automação de API.
Compare preços, velocidade, benchmarks e casos de uso do Gemini 3.6 Flash e do Gemini 3.5 Flash-Lite. Veja qual novo modelo do Google se encaixa na sua carga de trabalho de IA.
Compare as melhores APIs de IA de texto para fala quanto a qualidade de voz, agentes em tempo real, áudio multilíngue, preços, planos gratuitos, clonagem de voz e uso em produção.
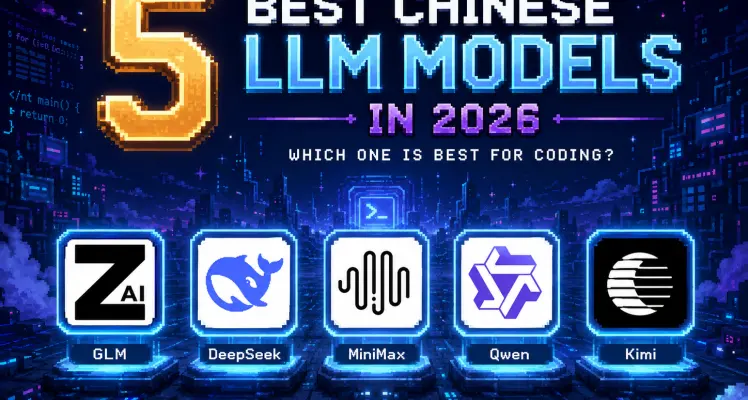
Compare Kimi K3, GLM 5.2, Qwen3.7 Max, MiniMax M3 e DeepSeek V4 Pro para programação, custo, velocidade, contexto de 1M e acesso a pesos abertos.