Qwen 3.7 Plus vs Qwen 3.8 Max: Resposta Rápida
| Caso de uso |
Melhor escolha |
Por quê |
| Melhor qualidade geral de resposta |
Qwen 3.8 Max |
Ele lidera por uma ampla margem em avaliações independentes de inteligência e agentes de programação. |
| Cargas de trabalho rotineiras de API |
Qwen 3.7 Plus |
Preço de tabela mais baixo e velocidade de saída medida substancialmente maior. |
| Programação difícil em nível de repositório |
Qwen 3.8 Max |
Melhor desempenho em tarefas independentes de engenharia de software. |
| Programação frontend |
Qwen 3.8 Max |
Forte posição na WebDev Arena e melhor raciocínio visual. |
| Classificação ou extração em alto volume |
Qwen 3.7 Plus |
A qualidade máxima geralmente é desnecessária para tarefas restritas e repetíveis. |
| Agentes visuais |
Qwen 3.8 Max |
A Roboflow encontrou uma grande vantagem de precisão em seis avaliações de visão. |
| Menor custo por token |
Qwen 3.7 Plus |
A entrada começa a um quinto do preço de tabela internacional do Max. |
| Respostas longas e traços estendidos de agentes |
Qwen 3.8 Max |
A saída máxima é de 131.072 tokens, o dobro do limite do Plus. |
Nosso veredito: Qwen 3.8 Max vence a comparação de capacidade. Qwen 3.7 Plus vence como a opção econômica padrão. Para muitos sistemas de produção, a configuração mais sensata é encaminhar solicitações normais para o Plus e escalar os casos difíceis para o Max.
O que mudou do Qwen 3.7 Plus para o Qwen 3.8 Max?
O Qwen 3.7 Plus é posicionado como um modelo de produção mais rápido e de custo mais baixo. O Qwen 3.8 Max é a opção principal para raciocínio complexo, programação, agentes e trabalho multimodal.
A documentação oficial do Qwen 3.7 Plus lista uma janela de contexto de 1 milhão de tokens, pensamento híbrido, chamada de funções, saída estruturada, pesquisa na web e cache de prompt. A documentação do Qwen 3.8 Max mantém a mesma escala de entrada, mas aumenta o comprimento máximo de saída e adiciona controle mais direto sobre o esforço de raciocínio.
| Especificação |
Qwen 3.7 Plus |
Qwen 3.8 Max |
| ID do modelo |
qwen3.7-plus |
qwen3.8-max |
| Período de lançamento |
Maio/Junho de 2026 |
Agosto de 2026 |
| Arquitetura |
397B de parâmetros totais, 17B ativos |
2,4T de parâmetros totais, 95B ativos |
| Entradas |
Texto, imagem, vídeo |
Texto, imagem, vídeo |
| Saída |
Texto |
Texto |
| Janela de contexto |
1.000.000 de tokens |
1.000.000 de tokens |
| Entrada máxima |
991.808 tokens |
991.808 tokens |
| Saída máxima |
65.536 tokens |
131.072 tokens |
| Comprimento máximo de pensamento |
262.144 tokens |
262.144 tokens |
| Chamada de funções |
Sim |
Sim |
| Saída estruturada |
Sim |
Sim |
| Ajuste fino |
Não |
Não |
| Pesos abertos |
Nenhum lançamento aberto correspondente |
Pesos Qwen3.8 2.4T-A95B lançados separadamente |
A API gerenciada qwen3.8-max e os pesos Qwen3.8-2.4T-A95B lançados separadamente pertencem à mesma família, mas podem diferir em serviço, limites e recursos. Uma implantação auto-hospedada não reproduzirá necessariamente todos os resultados da nuvem.
Preços do Qwen 3.7 Plus vs Qwen 3.8 Max
Os preços da Alibaba Cloud variam por região, comprimento de contexto, cache e descontos temporários. A tabela abaixo usa os preços de tabela internacionais duráveis mostrados para a implantação de Singapura, em vez de uma promoção de curto prazo.
| Modelo e tamanho da solicitação |
Entrada por 1M de tokens |
Saída por 1M de tokens |
| Qwen 3.7 Plus, até 256K de entrada |
$0,40 |
$1,60 |
| Qwen 3.7 Plus, acima de 256K até 1M de entrada |
$1,20 |
$4,80 |
| Qwen 3.8 Max |
$2,00 |
$6,00 |
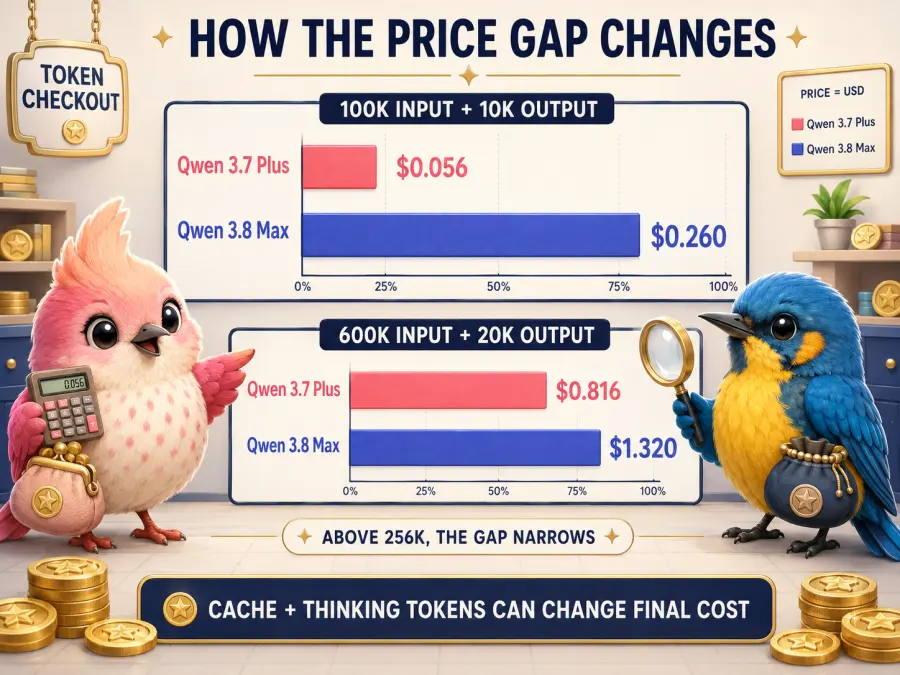
O Plus é cinco vezes mais barato para entrada apenas em seu nível de contexto inferior. Acima de 256K tokens de entrada, seu preço internacional aumenta e a diferença diminui.
Aqui estão dois exemplos simplificados antes de cache, tokens de pensamento ou cobranças específicas da plataforma:
Uma solicitação com 100K tokens de entrada e 10K tokens de saída custa cerca de $0,056 no Qwen 3.7 Plus e $0,260 no Qwen 3.8 Max.
Uma solicitação com 600K tokens de entrada e 20K tokens de saída custa cerca de $0,816 no Qwen 3.7 Plus e $1,320 no Qwen 3.8 Max.
O comprimento da solicitação, a saída, os acertos de cache e as tentativas repetidas alteram a fatura efetiva. Verifique a página oficial de preços do Model Studio para sua região.
 O GPT Proto atualmente lista o Qwen 3.8 Max a $1,80 por milhão de tokens de entrada e $5,40 por milhão de tokens de saída, com taxas separadas de gravação e leitura de cache. Confirme os números atuais na
Desempenho: Qwen 3.8 Max é mais forte, mas mais lento
A comparação independente mais clara vem do Artificial Analysis. Sua comparação direta de modelos relata:
| Medição independente |
Qwen 3.7 Plus |
Qwen 3.8 Max |
| Índice de Inteligência |
39 |
58 |
| Velocidade de saída |
56,1 tokens/s |
20,7 tokens/s |
| Tempo até o primeiro token |
2,17 s |
2,51 s |
O Max produz melhores resultados em uma ampla variedade de avaliações, mas o Plus gera respostas muito mais rápido. O tempo até o primeiro token é relativamente próximo; a maior diferença aparece após o início da geração.
Para chat ou um assistente de IDE, 56 tokens por segundo pode parecer muito mais responsivo do que 21. Para uma revisão offline que evita um erro grave, o Max pode justificar a espera. A latência também depende da carga do provedor, do comprimento do prompt e da localização, então teste o endpoint de produção.
Qual é melhor para programação?
Para programação, o Qwen 3.8 Max é o melhor modelo no geral. O Qwen 3.7 Plus continua sendo a escolha prática para trabalhos mais curtos e bem delimitados.
Use o Plus para explicações de funções, estruturação de testes unitários, conversão de dados, clientes de API repetitivos e edições restritas com requisitos explícitos. Use o Max para rastrear bugs em vários arquivos, planejar migrações, revisar lógica sensível à segurança, resolver ambiguidades ou operar um agente em um repositório.
O Coding Agent Index v1.4 da Artificial Analysis usou a mesma configuração de teste do Claude Code para ambos os modelos. Seus resultados publicados mostram uma liderança substancial para o Max:
| Resultado do agente de programação |
Qwen 3.7 Plus |
Qwen 3.8 Max |
| Índice de Agente de Programação |
38 |
61 |
| DeepSWE |
19% |
52% |
| Terminal-Bench v2.1 |
72% |
84% |
| SWE-Atlas-QnA |
24% |
48% |
| Custo registrado por tarefa |
$6,30 |
$3,23 |
| Tempo registrado por tarefa |
10,7 min |
29,9 min |
O Plus tem o preço por token mais baixo e terminou mais rápido, mas o Max registrou um custo menor por tarefa concluída nesta avaliação. Taxa de sucesso, cache, mix de saída e tentativas repetidas podem superar o preço de tabela. Isso não prova que o Max é sempre mais barato; mostra que o preço por token é um proxy ruim para o custo de concluir trabalho difícil de software.
Em um teste independente de bugs ocultos compartilhado por Paweł Huryn, 11 modelos enfrentaram 105 bugs ocultos em dois repositórios e foram julgados às cegas. O Qwen 3.8 Max corrigiu 19 em cerca de 148 minutos a um custo relatado próximo de $31. Não foi o vencedor geral, mas corrigiu unicamente um bug. O Plus não foi testado, então isso é evidência sobre o Max, não uma comparação direta.
O Max tem mais probabilidade de justificar seu custo quando um patch com falha cria outro ciclo de revisão. O Plus é mais eficiente quando a tarefa já está decomposta e é fácil de verificar.
Qual é melhor para programação frontend?
O Qwen 3.8 Max é a escolha mais forte para programação frontend, especialmente quando o prompt inclui capturas de tela, restrições de layout ou critérios de aceitação visual.
Em 21 de agosto de 2026, o ranking preliminar de frontend da WebDev Arena colocou o Qwen 3.8 Max em quarto lugar com uma pontuação de 1675 ± 14. Os rankings da Arena mudam conforme os votos se acumulam, então isso deve ser lido como um instantâneo datado, e não como uma classificação permanente.
A comparação de visão de seis tarefas da Roboflowde visão também encontrou uma diferença significativa:
| Resultado de visão |
Qwen 3.7 Plus |
Qwen 3.8 Max |
| Média em seis avaliações |
67,4% |
84,0% |
| OCR |
86,5% |
92,8% |
| Raciocínio visual, esforço baixo |
39,7% |
73,5% |
| Tempo médio de resposta |
7,0 s |
18,0 s |
| Custo relatado por amostra |
$0,0008 |
$0,0074 |
A vantagem visual do Max importa quando um agente compara uma página renderizada com uma referência, lê texto em uma captura de tela ou diagnostica problemas de layout. O Plus continua preferível para geração direta de componentes a partir de um sistema de design apenas de texto.
Os rankings visuais dependem da visão de votação. A Arena colocou o Max em segundo lugar em uma visão com controle de estilo em 21 de agosto e em sexto sem controle de estilo em 27 de agosto. Portanto, sua colocação exata depende da configuração de avaliação.
Qual é melhor para desenvolvedores que criam agentes?
Ambos os modelos suportam chamada de funções e saída estruturada. Ambos podem aceitar imagens e vídeo. O Qwen 3.7 Plus usa pensamento híbrido: o raciocínio é ativado por padrão, mas os desenvolvedores podem desativá-lo ou definir um orçamento de pensamento onde houver suporte. O Qwen 3.8 Max expõe níveis de reasoning_effort como low, medium e xhigh na API da Alibaba Cloud, com xhigh documentado como padrão.
Raciocínio mais longo pode consumir mais tokens e adicionar latência. Comece com a configuração mais baixa que passa na sua avaliação, depois aumente-a para solicitações difíceis. Verifique o suporte do provedor, pois um parâmetro da Alibaba Cloud não está automaticamente disponível em todos os endpoints compatíveis.
O Max pontua mais alto na comparação de agentes de programação, e sua saída máxima de 131.072 tokens é o dobro do limite do Plus. O Plus continua sendo um bom coordenador para chamadas de ferramentas frequentes e de baixo risco, como classificação, verificação de esquema ou seleção simples de ferramentas.
O suporte em lote precisa de verificação regional. As interfaces de lote do Plus podem ter um limite de contexto menor. O lote do Max está documentado para Pequim, mas não para Singapura ou implantações globais.
Qual modelo é mais econômico?
O Qwen 3.7 Plus é mais econômico para solicitações previsíveis e fáceis. O Qwen 3.8 Max pode ser mais econômico para tarefas difíceis se reduzir falhas, tentativas repetidas e revisão humana.
Use três medições: custo por token, onde o Plus vence; custo por tarefa bem-sucedida, que depende da dificuldade e das tentativas; e custo de uma resposta errada, que pode favorecer o Max para alterações de código e ações de ferramentas com consequências.
Se o Plus precisar de várias tentativas e uma revisão de desenvolvedor, o Max pode ser mais barato, apesar de sua taxa mais alta. Enviar todas as solicitações de extração ou formatação para o Max, no entanto, paga por qualidade que o aplicativo pode não usar.
Crie um conjunto de testes representativo com uma condição clara de aprovação, depois registre latência, tokens, tentativas e sucesso final. Compare o fluxo de trabalho concluído, não apenas a primeira linha da fatura.
Contexto Longo, Vídeo e Trabalho Multimodal
Ambos os modelos anunciam uma janela de contexto de 1 milhão de tokens. O Plus é adequado para extração de grandes conjuntos de documentos quando as respostas são curtas e bem especificadas, embora sua taxa internacional mude acima de 256K de entrada. O Max é melhor para síntese entre documentos, evidências conflitantes e relatórios longos.
Ambas as páginas oficiais listam entrada de imagem e vídeo. O Max é mais seguro para interpretação visual que orienta ações; o Plus é mais barato para OCR mais simples ou extração de metadados. Teste limites e formatos de mídia no provedor real.
Uma Estratégia Prática de Roteamento de Produção
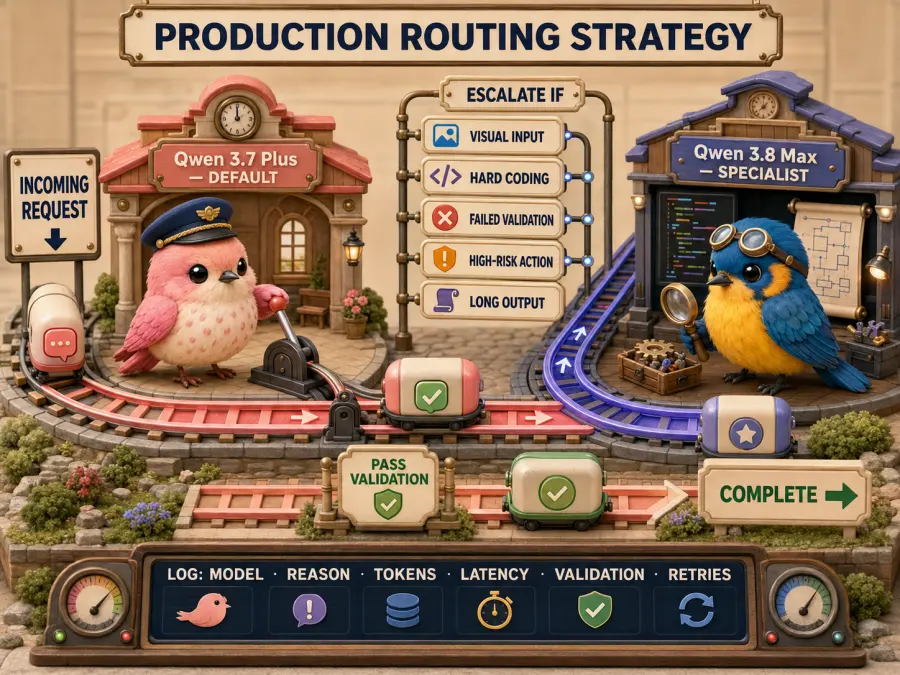
A melhor decisão entre Qwen 3.7 Plus e Qwen 3.8 Max pode ser usar ambos.
Encaminhe para Qwen 3.7 Plus por padrão quando a solicitação for curta, restrita, de baixo risco ou fácil de verificar. Escalone para Qwen 3.8 Max quando uma ou mais destas condições se aplicarem:
A solicitação inclui uma captura de tela, diagrama ou vídeo que deve ser interpretado com precisão.
Uma tarefa de programação abrange vários arquivos ou exige depuração de uma causa raiz desconhecida.
Uma primeira tentativa do Plus falha na validação ou retorna baixa confiança.
O agente pode realizar uma ação irreversível ou cara.
A tarefa precisa de uma resposta gerada muito longa.
A revisão humana custa mais do que a diferença de preço do modelo.
Registre o modelo selecionado, o motivo do roteamento, tokens, latência, resultado da validação e tentativas. O tráfego real mostrará quais regras economizam dinheiro.
Como chamar o Qwen 3.8 Max no GPT Proto
Nota editorial antes da publicação: O GPT Proto preparou a página do modelo Qwen 3.8 Max, mas o endpoint deve passar por um teste de fumaça ao vivo antes que esta seção seja publicada como uma API disponível. Até então, altere o título para “Qwen 3.8 Max está chegando ao GPT Proto”, mantenha o link da página do modelo e remova o comando abaixo.
Depois que o modelo estiver ativo, a seguinte solicitação compatível com OpenAI pode ser usada como um teste básico de conectividade:
curl --request POST "https://gptproto.com/v1/chat/completions" \
  --header "Authorization: Bearer $GPTPROTO_API_KEY" \
  --header "Content-Type: application/json" \
  --data '{
    "model": "qwen3.8-max",
    "messages": [
      {
        "role": "user",
        "content": "Revise este plano de implementação e identifique os pontos de falha de maior risco."
      }
    ]
  }'
Comece com texto e confirme o ID do modelo, campos de uso, latência e erros. Teste controles de raciocínio, mídia, inferência em lote e campos específicos do provedor separadamente.
Visite a página da API do Qwen 3.8 Max para disponibilidade e preços atuais.
Veredito Final: Qwen 3.7 Plus ou Qwen 3.8 Max?
Escolha Qwen 3.8 Max se você quer o melhor modelo desta comparação. Sua liderança é mais clara em resultados independentes de inteligência, tarefas de agentes de programação, avaliação de frontend, raciocínio visual e comprimento máximo de saída.
Escolha Qwen 3.7 Plus se sua carga de trabalho for rotineira, de alto volume, sensível à latência ou fácil de validar. Ele produz tokens muito mais rápido na medição da Artificial Analysis e tem um preço de tabela inicial muito mais baixo.
Use o Plus como padrão e o Max como caminho de escalonamento. Se apenas um modelo puder ser implantado, o Max é a escolha mais segura com foco em qualidade; o Plus é a melhor escolha com foco em orçamento.