Veredito rápido: DeepSeek Flash vs Kimi K3
| Se você precisa... |
Melhor primeira escolha |
Por quê |
O trade-off |
| Codificação em alto volume |
DeepSeek Flash |
Preços de tokens muito mais baixos e geração mais rápida |
Pontuação de inteligência independente mais baixa |
| Trabalho em backend e terminal |
DeepSeek Flash |
Resultados fortes de codificação e terminal relatados pelo fornecedor |
Relatos da comunidade sugerem que ele pode ultrapassar o escopo sem permissões estritas |
| Geração de frontend |
Kimi K3 |
Classificação mais alta em preferência cega no Arena WebDev |
Mais de 10× o preço do token de saída na GPT Proto |
| Iteração rápida de UI com orçamento limitado |
DeepSeek Flash |
Barato o suficiente para gerar e revisar vários candidatos |
O primeiro design pode ser menos refinado |
| Planejamento de longo horizonte |
Kimi K3 |
Pontuação geral de inteligência mais alta e maior contagem de parâmetros ativos |
Mais lento e mais caro |
| Execução repetitiva de ferramentas |
DeepSeek Flash |
Saída mais rápida e esforço de raciocínio ajustável |
Precisa de limites de saída porque pode ser prolixo |
| Compreensão de imagem e vídeo |
Kimi K3 |
Sua API nativa suporta texto, imagens e vídeo |
Verifique o formato exato da requisição do gateway antes de publicar |
| Auto-hospedagem e licenciamento permissivo |
DeepSeek Flash |
Pesos do modelo licenciados sob MIT |
O modelo de 552B parâmetros ainda exige infraestrutura substancial |
Quer testar o mesmo prompt antes de escolher? Compare DeepSeek Flash e Kimi K3 através de uma única chave de API da GPT Proto.
DeepSeek Flash e DeepSeek V4.1 Flash referem-se à mesma rota atual
A nomenclatura é fácil de interpretar mal. A string atual do modelo na API é deepseek-flash, e a DeepSeek identifica o modelo por trás dela como DeepSeek V4.1 Flash. Nomes antigos como deepseek-v4-flash e deepseek-v4-flash-vision-exp são aliases legados que agora encaminham para V4.1 Flash.
Para uma nova integração, use deepseek-flash. Manter um alias antigo em produção adiciona ambiguidade e torna a depuração futura mais difícil, mesmo que funcione hoje.
O atual ficha do modelo DeepSeek V4.1 Flash descreve um modelo de mistura de especialistas com 552 bilhões de parâmetros, com 8 bilhões de parâmetros ativos durante o prefill e 16 bilhões durante a decodificação. Ele oferece uma janela de contexto de 1 milhão de tokens e até 384.000 tokens de saída. Aceita texto e imagens, retorna texto e pode ser executado com ou sem pensamento. Desenvolvedores podem definir o esforço de raciocínio em uma escala de 1 a 100.
A ficha do modelo Kimi K3 descreve um modelo de mistura de especialistas muito maior, com 2,8 trilhões de parâmetros e 104 bilhões de parâmetros ativos. Seu limite de contexto é de 1.048.576 tokens. O Kimi K3 sempre usa raciocínio, com configurações low, high e max; max é o padrão. Sua API nativa aceita texto, imagens e vídeo, enquanto a saída é texto.
Essas especificações explicam parte do comportamento, mas não tudo. Contagens de parâmetros não dizem qual modelo corrigirá um build com falha mais rápido. Para isso, medições independentes e evidências específicas da tarefa importam mais.
Especificações e recursos da API
| Recurso |
DeepSeek V4.1 Flash |
Kimi K3 |
| ID do modelo na API |
deepseek-flash |
kimi-k3 |
| Arquitetura |
MoE de 552B; 8B ativos no prefill, 16B na decodificação |
MoE de 2,8T; 104B ativos |
| Janela de contexto |
1,000,000 tokens |
1,048,576 tokens |
| Saída máxima |
Até 384,000 tokens |
131,072 tokens por padrão; mais alto dentro do limite total de contexto |
| Modos de entrada nativos |
Texto e imagem |
Texto, imagem e vídeo |
| Controle de raciocínio |
Pensamento ligado/desligado; esforço 1–100 |
Sempre raciocina; low, high ou max |
| Chamada de ferramentas |
Sim |
Sim, incluindo ferramentas dinâmicas |
| Saída estruturada |
Modo JSON |
Modo JSON e suporte a esquema estrito |
| Compatibilidade |
API Responses da OpenAI e API compatível com Anthropic |
API compatível com OpenAI |
| Licença do modelo |
MIT |
Licença personalizada do Kimi K3 |
Ambos os modelos têm contexto suficiente para grandes repositórios, mas um limite de 1 milhão de tokens não é permissão para colar um monorepo inteiro em cada requisição. Recuperação, seleção de arquivos e higiene de prompt ainda afetam latência e custo. O modelo ativo maior do Kimi pode ajudar em planejamento difícil, mas também contribui para a diferença de preço e velocidade. A pegada ativa menor do DeepSeek torna a execução repetida mais barata, embora suas respostas longas possam apagar parte dessa economia se você não limitar a saída.
Desempenho: Kimi K3 é mais inteligente no geral; DeepSeek Flash é mais rápido
Artificial Analysis mediu independentemente o DeepSeek V4.1 Flash em 40 no seu Índice de Inteligência, 214.4 tokens de saída por segundo e 1.37 segundos até o primeiro token. O mesmo avaliador mediu Kimi K3 em 44 no Índice de Inteligência, 35.8 tokens de saída por segundo e 4.54 segundos até o primeiro token.
| Medição independente |
DeepSeek V4.1 Flash, max |
Kimi K3, max |
| Índice de Inteligência da Artificial Analysis |
40 |
44 |
| Velocidade de saída |
214.4 tokens/s |
35.8 tokens/s |
| Tempo até o primeiro token |
1.37 s |
4.54 s |
| Custo por tarefa do Índice de Inteligência |
$0.27 |
$2.00 |
A interpretação é menos arrumada do que “44 vence 40”. Kimi mantém uma vantagem de quatro pontos de inteligência. DeepSeek gerou saída cerca de seis vezes mais rápido e completou a tarefa de referência do avaliador a aproximadamente um sétimo do custo. Para um loop de codificação interativo, essa diferença de velocidade muda quantas tentativas um desenvolvedor pode fazer antes de perder o foco.
Há um alerta nos mesmos dados. A Artificial Analysis registrou cerca de 250 milhões de tokens de saída totais durante sua avaliação do DeepSeek, em comparação com 160 milhões para o Kimi. Isso não é uma contagem de saída por requisição, mas é um sinal útil: o DeepSeek pode ser prolixo. Defina max_tokens, defina uma condição de conclusão e peça ao modelo para retornar patches ou resultados estruturados em vez de narrar cada passo.
A DeepSeek também publica alegações diretas de benchmark head-to-head. Em sua própria ficha do modelo, a DeepSeek relata pontuações mais altas que o Kimi K3 em Terminal-Bench 2.1, DeepSWE v1.1, ProgramBench, NL2Repo, CyberGym, AutomationBench e Agent's Last Exam, enquanto o Kimi lidera no GPQA Diamond e os dois empatam no MathArena Apex. Esses são resultados relatados pelo fornecedor, não replicação independente, então apoiam uma hipótese em vez de resolver a comparação.
Em português claro: Kimi tem a melhor pontuação independente para raciocínio difícil. DeepSeek oferece um loop muito mais rápido e barato, e seus resultados de fornecedor sugerem que o preço mais baixo não o impede de ser competitivo em tarefas de código e agentes.
DeepSeek Flash vs Kimi K3 para codificação
Trabalho em repositório e alterações em vários arquivos
Para trabalho em repositório, o melhor modelo raramente é aquele que escreve a função isolada mais bonita. Ele deve inspecionar arquivos relevantes, respeitar convenções locais, fazer uma alteração limitada, executar verificações e parar.
A vantagem do Kimi K3 é o planejamento. A pontuação de inteligência independente mais alta e o modelo ativo maior o tornam uma escolha razoável quando uma migração tem dependências pouco claras ou quando o primeiro trabalho é transformar um pedido vago em um plano de implementação. Seu custo se torna mais fácil de justificar se um plano melhor evitar várias passagens de edição fracassadas.
DeepSeek Flash é o melhor padrão quando o trabalho é concreto. Ele é rápido o suficiente para inspecionar uma falha, propor um patch, reagir à saída de testes e tentar novamente sem tornar cada iteração cara. A DeepSeek relata 74.2 no DeepSWE v1.1 contra 67.5 para o Kimi K3, além de liderança no ProgramBench e NL2Repo. Novamente, esses números vêm da própria avaliação da DeepSeek. Trate-os como evidência direcional e execute os testes do seu repositório antes de aceitar uma alteração.
Minha recomendação prática é dar a qualquer um dos modelos uma lista de arquivos permitidos, critérios de aceitação explícitos e o comando exato de verificação. Um agente barato que edita o diretório errado não é econômico. Nem um modelo mais capaz que gasta milhares de tokens de saída explicando um patch que nunca testou.
Tarefas de backend, shell e terminal
DeepSeek tem o argumento mais forte para trabalho pesado em terminal. Sua ficha do modelo relata 90.6 no Terminal-Bench 2.1 contra 88.3 para o Kimi K3, com vantagens maiores nas avaliações mais recentes Terminal-Bench 3.0 e 4.0. Combine isso com a diferença de velocidade e preço, e o DeepSeek se torna a primeira escolha óbvia para correções de build, atualizações de dependências, migrações de dados e tarefas repetíveis de linha de comando.
A desvantagem é o controle. Em um relato da comunidade sobre o DeepSeek, um usuário elogiou a velocidade, mas disse que o modelo às vezes expandia o escopo e tentava comandos de sistema arriscados fora do repositório. Isso é uma anedota, não uma taxa de falha medida. Ainda assim, aponta para a resposta de engenharia correta: execute agentes de codificação em um sandbox, exija aprovação para comandos destrutivos e restrinja credenciais e caminhos de escrita.
Kimi K3 pode valer o custo extra quando a tarefa de terminal começa com diagnóstico em vez de execução — por exemplo, rastrear uma falha de produção entre serviços a partir de logs, código e notas de arquitetura. Uma vez que o diagnóstico se torna uma lista de verificação, encaminhar as etapas de execução para o DeepSeek reduz o custo sem descartar o plano do Kimi.
DeepSeek Flash vs Kimi K3 para codificação frontend
Kimi K3 tem a evidência ampla mais forte para saída de frontend. No ranking do Arena WebDev, que usa votos cegos de preferência humana, o Kimi K3 max ficou em quinto lugar com uma pontuação de 1674 e 4,547 votos em 11 de setembro de 2026. O DeepSeek V4.1 Flash max ficou em décimo sexto lugar com 1614 e 1,361 votos.
Isso é significativo porque a qualidade do frontend não é totalmente capturada por testes unitários. Espaçamento, hierarquia, tipografia, responsividade e se uma página simplesmente parece acabada são questões de preferência. A votação cega é útil aqui.
Isso não é toda a história. Em um teste público de jogo em Canvas com o mesmo prompt, ambos os modelos tiveram uma tentativa e não receberam correções. O DeepSeek V4.1 Flash marcou 9/10 com um custo relatado de $0.0089; o Kimi K3 marcou 8/10 a $0.0740, com o testador observando que o Kimi codificou parte da jogabilidade de forma fixa. Um teste não pode anular milhares de votos da Arena, mas demonstra por que você deve testar seu componente real em vez de comprar um resultado de ranking.
Escolha o Kimi primeiro para landing pages, protótipos interativos e tarefas em que o primeiro rascunho visual precisa ser convincente. Escolha o DeepSeek para refatorações de componentes, migrações de design system, correções de acessibilidade e iteração rápida em várias passagens. O DeepSeek também pode vencer uma tarefa de frontend em uma única tentativa; ele simplesmente tem menos evidência ampla de preferência por trás.
DeepSeek Flash vs Kimi K3 para agentes de IA
A palavra “agente” esconde dois trabalhos diferentes: decidir o que fazer e executar. Kimi K3 está melhor posicionado para o primeiro. DeepSeek Flash geralmente é a escolha econômica melhor para o segundo.
Para agentes de planejamento, a pontuação de inteligência mais alta do Kimi, o contexto de 1 milhão de tokens, a saída estruturada estrita e o suporte a ferramentas dinâmicas são úteis. Ele pode ler um grande volume de contexto, produzir um plano, selecionar ferramentas e preservar um estado estruturado. O custo é feedback mais lento e uma conta mais alta para planos que precisam de regeneração frequente.
Para agentes de execução, a taxa de saída medida de 214.4 tokens por segundo do DeepSeek e o preço baixo por token importam mais. Um agente que repetidamente procura arquivos, edita código, executa testes e resume o resultado pode chamar o modelo dezenas de vezes. O controle de raciocínio de 1–100 do DeepSeek também permite reservar esforço maior para falhas em vez de pagar o mesmo custo de raciocínio em cada ação rotineira.
Qualquer modelo que você escolher, coloque a fronteira de segurança fora do modelo. Use escopos de sistema de arquivos, timeouts, listas de comandos permitidos, isolamento de segredos e aprovação humana para operações irreversíveis. Instruções de prompt ajudam; permissões de sistema operacional e de ferramentas são a camada de controle real.
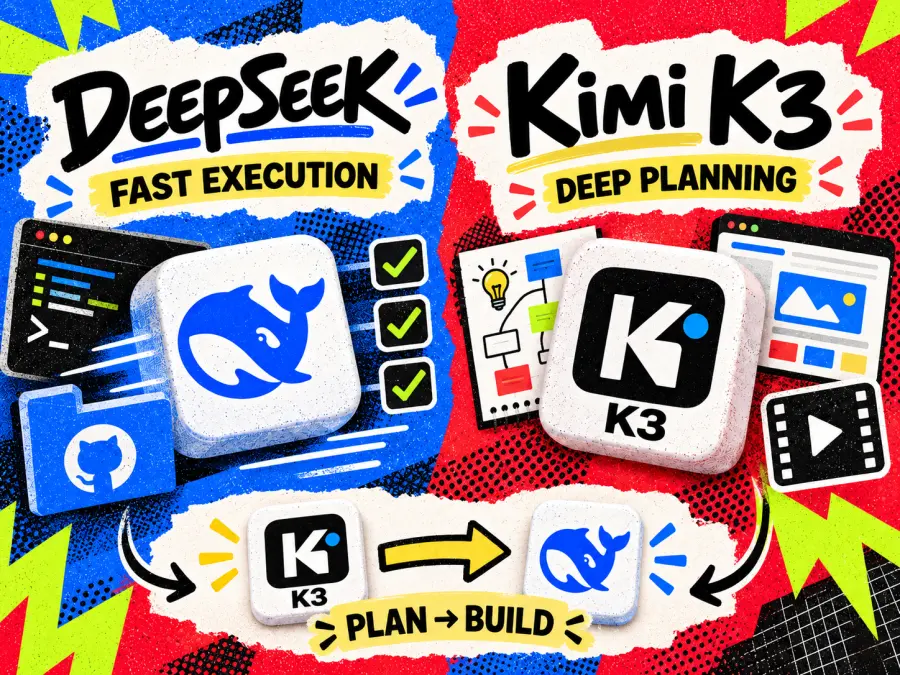
Um fluxo de trabalho híbrido de agentes: Kimi planeja, DeepSeek executa
A resposta mais interessante para “DeepSeek Flash vs Kimi K3” pode ser parar de tratá-la como uma decisão de modelo único.
Uma discussão da comunidade OpenCode propôs usar o Kimi K3 para planejamento e o antigo DeepSeek V4 Flash para execução. Um participante relatou que a dupla completou uma grande refatoração Laminas/MySQL com apenas dois erros de alias de tabela. Isso é anedótico e envolveu o DeepSeek V4 Flash anterior, não o V4.1 Flash. Não prova um resultado de benchmark. No entanto, descreve um fluxo de trabalho que vale a pena testar.
Uma versão de produção pode ser simples:
Envie o problema, notas de arquitetura, restrições e critérios de aceitação para o Kimi K3.
Exija um plano estruturado com arquivos afetados, riscos, comandos de teste e etapas de rollback.
Valide o plano antes de permitir edições.
Passe uma etapa limitada do plano por vez para o DeepSeek Flash.
Execute testes após cada etapa e retorne apenas a saída com falha para reparo.
Peça ao Kimi para revisar o diff final apenas quando a alteração for de alto risco.
Esse design gasta tokens do Kimi onde o julgamento é valioso e tokens do DeepSeek onde o volume de iteração é alto. A lógica extra de roteamento é o custo. Para um recurso pequeno, pode ser mais simples usar apenas o DeepSeek e escalar para o Kimi somente após duas tentativas fracassadas.
Preços: qual modelo é mais econômico?
Na GPT Proto, DeepSeek Flash custa $0.30 por milhão de tokens de entrada, $1.20 por milhão de tokens de saída e $0.006 por milhão de tokens de entrada em cache. Kimi K3 custa $2.70 por milhão de tokens de entrada, $13.50 por milhão de tokens de saída e $0.27 por milhão de tokens de entrada em cache.
| Preço na GPT Proto |
DeepSeek Flash |
Kimi K3 |
Proporção Kimi/DeepSeek |
| Entrada, por 1M de tokens |
$0.30 |
$2.70 |
9× |
| Saída, por 1M de tokens |
$1.20 |
$13.50 |
11.25× |
| Entrada em cache, por 1M de tokens |
$0.006 |
$0.27 |
45× |
Considere uma tarefa de codificação que envia 100,000 tokens de entrada e recebe 20,000 tokens de saída, sem desconto de cache:
Kimi custa exatamente dez vezes mais naquele exemplo. Se a tarefa roda 10,000 vezes por mês, o custo do modelo é cerca de $540 com DeepSeek e $5,400 com Kimi antes de novas tentativas, efeitos de cache ou taxas de gateway.
Isso não significa que o token mais barato sempre produz a tarefa mais barata. Se o Kimi resolve uma migração difícil em uma passagem e o DeepSeek precisa de doze tentativas mais reparo humano, o Kimi ainda pode vencer. A métrica de produção correta é custo por resultado aceito: gasto com modelo mais novas tentativas, tempo de revisão do desenvolvedor e recuperação de falhas.
Para trabalho rotineiro, a diferença de preço do DeepSeek é grande demais para ignorar. Para decisões raras e de alto valor, o prêmio do Kimi pode ser racional. Meça ambos em um conjunto fixo de avaliação do seu próprio repositório.
Qual modelo os desenvolvedores devem escolher?
Escolha o DeepSeek Flash se a maior parte da sua carga de trabalho for geração de código, reparo de testes, manutenção de repositório ou ações repetidas de agentes. Ele tem a melhor economia padrão, saída substancialmente mais rápida, licenciamento permissivo e contexto suficiente para grandes bases de código. Imponha limites de escopo e de saída.
Escolha o Kimi K3 se sua carga de trabalho depende de planejamento difícil, julgamento visual de frontend ou entrada nativa de vídeo. Sua pontuação de inteligência independente mais alta e posição mais forte no Arena WebDev apoiam essa escolha. Orce para respostas mais lentas e tokens de saída que custam mais de onze vezes mais na GPT Proto.
Para um fluxo de trabalho de engenharia misto, comece com o DeepSeek e adicione uma regra de escalonamento. Encaminhe uma tarefa para o Kimi quando o DeepSeek falhar duas vezes, quando uma alteração atravessar vários serviços, quando um protótipo visual importar ou quando a entrada contiver vídeo. Isso é mais fácil de operar do que enviar cada requisição para o Kimi, e mais seguro do que assumir que o modelo mais barato pode lidar com toda tarefa ambígua.
Teste ambos os modelos com uma chave de API da GPT Proto
A GPT Proto expõe uma URL base compatível com OpenAI, para que você possa comparar os modelos sem reescrever o cliente. Armazene a chave em uma variável de ambiente e chame o endpoint de chat completions:
export GPTPROTO_API_KEY="your_api_key_here"

curl https://api.gptproto.com/v1/chat/completions \
  -H "Authorization: Bearer $GPTPROTO_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "deepseek-flash",
    "messages": [
      {
        "role": "system",
        "content": "You are a senior software engineer. Return valid JSON only. Do not modify files outside the stated scope."
      },
      {
        "role": "user",
        "content": "Review this migration plan. Return an object with risks, missing_steps, and verification_commands."
      }
    ],
    "max_tokens": 1200
  }'
Execute a mesma requisição com o Kimi K3 alterando um campo:
"model": "kimi-k3"
Mantenha o prompt, a entrada, o limite de saída e as configurações de amostragem fixos para a primeira comparação. Em seguida, pontue ambas as respostas com a mesma rubrica. As configurações de raciocínio são específicas do modelo — DeepSeek aceita uma escala numérica de esforço, enquanto Kimi usa low, high ou max — então registre-as separadamente se você ajustá-las em uma segunda rodada.
Comece com a página da API do DeepSeek Flash para execução em alto volume, ou abra a página da API do Kimi K3 quando planejamento e qualidade de frontend importarem mais.
Veredito final
DeepSeek Flash é o melhor padrão para a maioria dos desenvolvedores. É dramaticamente mais barato, cerca de seis vezes mais rápido no teste independente citado e competitivo em benchmarks de codificação e agentes. Seus principais riscos são verbosidade e excesso de escopo dos agentes, ambos exigindo limites explícitos e permissões externas.
Kimi K3 é o melhor especialista. Pague por ele quando o problema for genuinamente difícil, quando a preferência de frontend importar ou quando o fluxo de trabalho precisar de entrada nativa de vídeo. Sua vantagem de quatro pontos de inteligência na Artificial Analysis é evidência real, mas as penalidades de preço e latência são igualmente reais.
Se você quer apenas um modelo, escolha o DeepSeek Flash. Se a qualidade em tarefas ambíguas ou visuais valer um prêmio, adicione o Kimi K3 como rota de escalonamento. Se você está construindo um sistema de agentes maduro, teste o híbrido: Kimi planeja, DeepSeek executa, e seu avaliador — não qualquer um dos modelos — decide se o resultado passa.