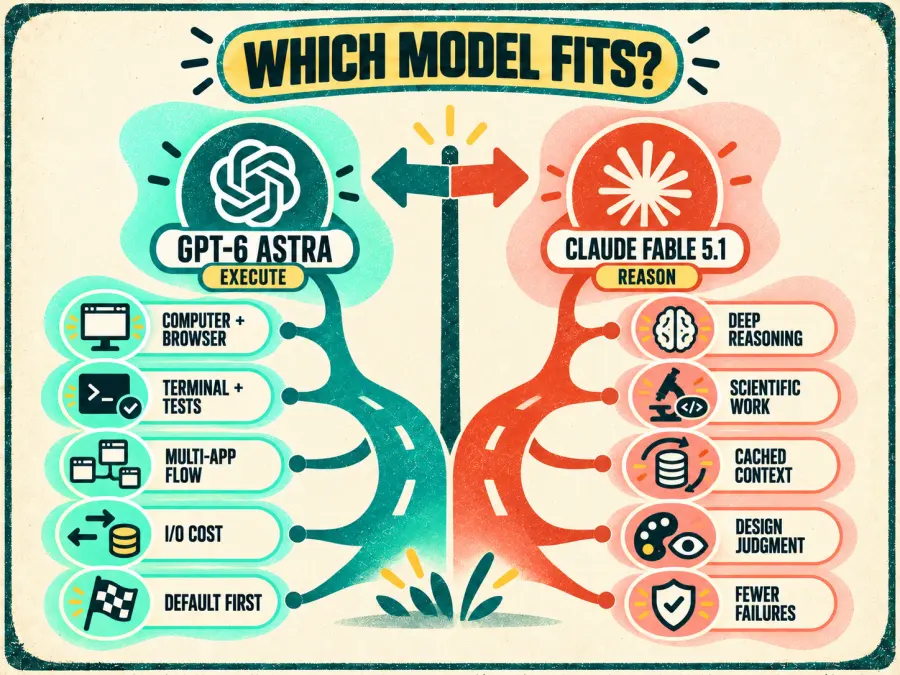
GPT-6 Astra vs. Claude Fable 5.1: Kurzurteil
| Entscheidung |
Bessere Wahl |
Warum |
| Coding-Agenten, die Code bearbeiten, testen und debuggen |
GPT-6 Astra |
Stärkere Ergebnisse bei Terminal- und Automatisierungsaufgaben; geringere Kosten pro Aufgabe im unabhängigen Vergleich |
| Anspruchsvolle wissenschaftliche Aufgaben oder wissensintensive Arbeit |
Claude Fable 5.1 |
Liegt im aktuellen unabhängigen Vergleich bei SciCode, HLE, AA-Briefcase und GDPval-AA v2 vorn |
| Agenten für Browser- und Computernutzung |
GPT-6 Astra |
Entwickelt für Computernutzung, asynchrone Tools und Steuerung während eines Durchlaufs |
| Erster Entwurf für ein designorientiertes Frontend |
Knapp: Claude Fable 5.1 |
In Community-Tests werden oft die Interaktionsdetails und die Lesbarkeit des Codes bevorzugt; einen maßgeblichen Frontend-Benchmark gibt es nicht |
| Frontend-Implementierung plus Browser-QA |
GPT-6 Astra |
Die bessere Wahl, wenn der Agent implementieren, rendern, prüfen, testen und Fehler beheben muss |
| Agent mit umfangreicher Cache-Nutzung und langen Laufzeiten |
Claude Fable 5.1 |
Laut offizieller Preisangabe kosten Cache-Lesezugriffe 0,25 $ pro Million Tokens, verglichen mit 1,00 $ bei Astra |
| Niedrigster GPT Proto-Standardpreis pro Token |
GPT-6 Astra |
Die aktuellen Preise betragen 8 $ für Eingaben und 40 $ für Ausgaben pro Million Tokens |
| Niedrigste gemessene Kosten pro unabhängiger Benchmark-Aufgabe |
GPT-6 Astra |
3,26 $ gegenüber 7,63 $ im aktuellen Artificial-Analysis-Vergleich mit maximalem Aufwand |
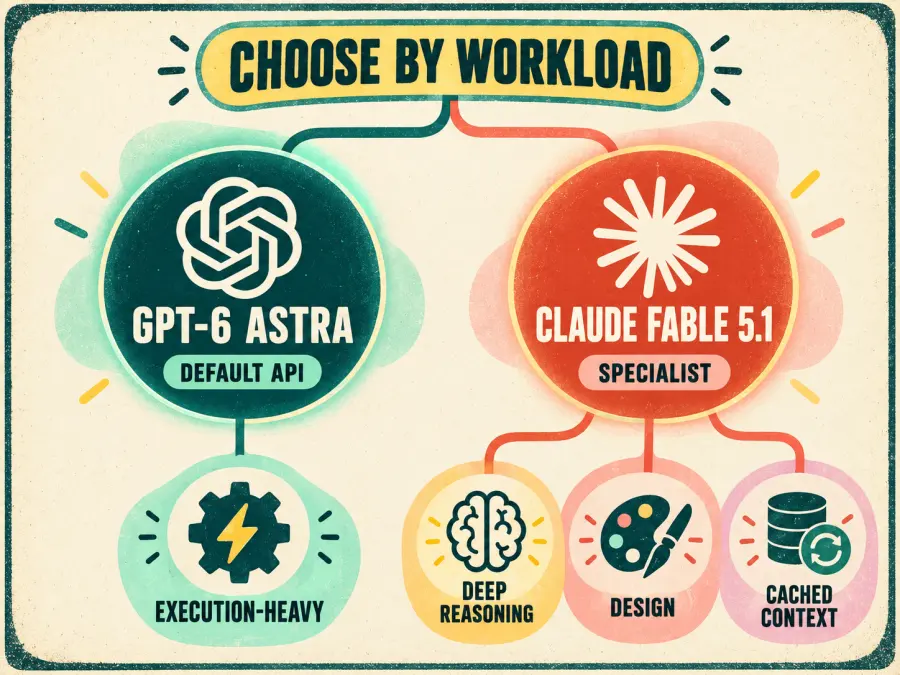
Wenn Sie eine einzige Standard-API-Option benötigen, beginnen Sie mit Astra für aktionsorientierte Aufgaben und halten Sie Fable 5.1 als Ausweichoption für schwierige Schlussfolgerungen, wissenschaftlichen Code oder Designentscheidungen bereit. Bei Workloads mit einem großen, stabilen Prompt-Präfix sollten Sie Fable vor der Entscheidung testen: Die Cache-Kosten können den vermeintlichen Preisvorteil umkehren.
Spezifikationen und Unterschiede für Entwickler
| Spezifikation |
GPT-6 Astra |
Claude Fable 5.1 |
| Anbieter |
OpenAI |
Anthropic |
| API-Modell-ID |
gpt-6-astra |
claude-fable-5-1 |
| Veröffentlichungsdatum |
3. September 2026 |
1. September 2026 |
| Kontextfenster |
1.050.000 Tokens |
1.000.000 Tokens |
| Maximale Ausgabe |
128.000 Tokens |
128.000 Tokens |
| Ein- und Ausgabe |
Text- und Bildeingabe; Textausgabe |
Text- und Bildeingabe; Textausgabe |
| Wissensstand bis |
30. April 2026 |
Juni 2026 |
| Steuerung des Reasonings |
low, medium, high, xhigh, max |
Adaptives Denken ist immer aktiviert; der Aufwand lässt sich von „low“ bis „max“ anpassen |
| Zentrale Agentensteuerungen |
Asynchrone Tool-Aufrufe, Steuerung während eines Durchlaufs, Computernutzung, gehostete Tools |
Beibehaltene Gedankengänge, Aufwand pro Nachricht, systemseitige Nachrichten mit Gültigkeit für einen Durchlauf, Fortschrittsmeldungen |
| Feinabstimmung |
Nicht unterstützt |
Nicht als Standardfunktion von Fable 5.1 aufgeführt |
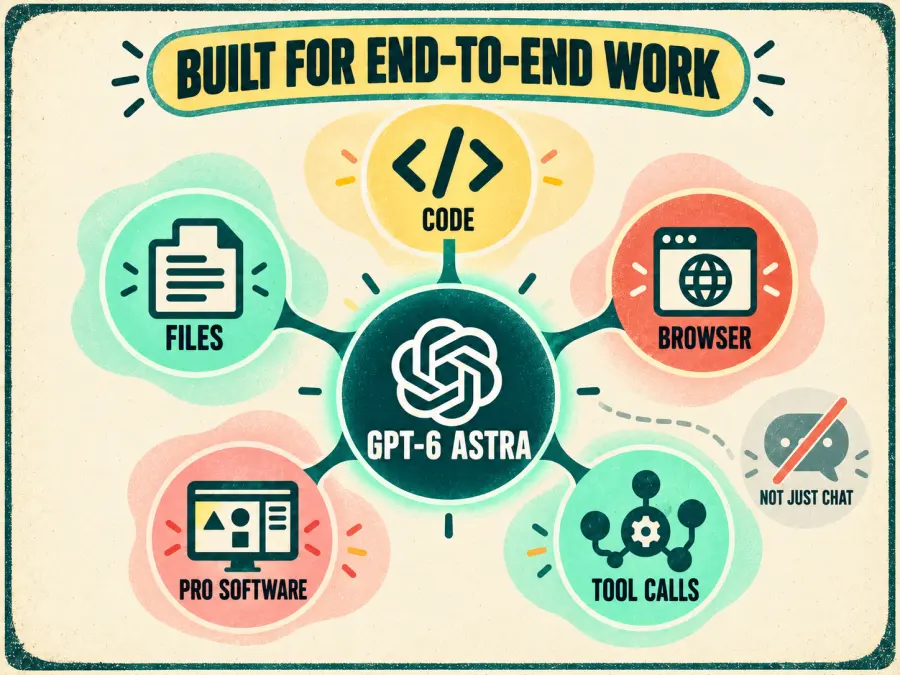
OpenAI positioniert Astra als Modell für komplexe End-to-End-Aufgaben in den Bereichen Code, Browser, Dateien und professionelle Software. Seine API-Steuerungen sind wichtig, wenn ein Agent bereits arbeitet: Nutzer können die Aufgabe während der Ausführung lenken, und asynchrone Tool-Aufrufe verringern Leerlaufzeiten, während externe Aufgaben erledigt werden. Siehe die Dokumentation zum GPT-6-Astra-Modell und den Einführungsbericht.
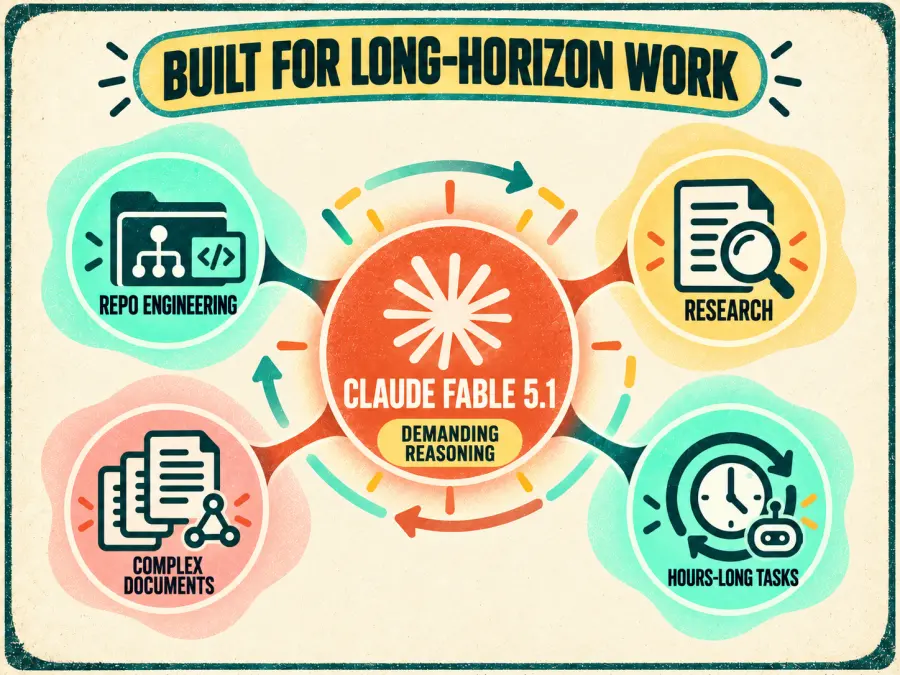
Anthropic positioniert Fable 5.1 für anspruchsvolle Schlussfolgerungen und agentische Aufgaben mit langem Zeithorizont. Da das adaptive Denken immer aktiviert ist, eignet sich das Modell weniger, wenn Sie einen wirklich schnellen Modus ohne Reasoning benötigen. Aufwand pro Nachricht und beibehaltene Gedankengänge helfen jedoch, in langen Sitzungen den Zusammenhang zu wahren. In der Dokumentation zu Claude Fable 5.1 werden außerdem API-spezifische Migrationsdetails erläutert: Die erzwungenen Werte tool_choice any und tool werden nicht unterstützt, und einige Steuerungsmöglichkeiten während eines Gesprächs befinden sich noch in der Beta.
Benchmarks: Der Sieger hängt von der Vergleichstabelle ab
Von OpenAI gemeldete Ergebnisse sprechen für GPT-6 Astra
Der Einführungsvergleich von OpenAI zeigt Astra bei den meisten veröffentlichten Ergebnissen für Coding, Terminal, Automatisierung, Mathematik und Wissenschaft vorn. Da diese Ergebnisse vom Anbieter stammen, sollten sie als Anlass für weitere Prüfungen dienen – nicht als Ersatz für Ihre eigene Evaluierung.
| Benchmark |
GPT-6 Astra |
Claude Fable 5.1 |
Führend |
| Terminal-Bench 4.0 |
57,9 % |
55,8 % |
Astra |
| DeepSWE v1.1 |
74,1 % |
67,4 % |
Astra |
| FrontierCode Main |
53,3 % |
50,9 % |
Astra |
| FrontierCode Extended |
64,5 % |
63,6 % |
Astra |
| AutomationBench |
41,4 % |
31,4 % |
Astra |
| Terminal-Bench Science 0.1 |
64,6 % |
52,6 % |
Astra |
| FrontierMath Tier 4 v2 |
97,6 % |
87,8 % |
Astra |
| GPQA Diamond |
96,0 % |
93,7 % |
Astra |
| Humanity's Last Exam mit Tools |
57,2 % |
65,0 % |
Fable 5.1 |
Quelle: Einführungsbericht von OpenAI zu GPT-6 Astra. Toolzugriff, Prompts, Reasoning-Aufwand, Tokenbudgets und Wiederholungsregeln beeinflussen diese Ergebnisse.
Die wichtige Ausnahme ist Humanity's Last Exam mit Tools, wo Fable 5.1 vorn liegt. Das ist ein früher Hinweis darauf, dass sich „besseres Modell“ nicht auf eine einzige Anbietertabelle reduzieren lässt.
Der neueste unabhängige Vergleich endet unentschieden: 53 zu 53
Einige Suchergebnisse, die unmittelbar nach Astras Einführung veröffentlicht wurden, nennen noch ein älteres Ergebnis von Artificial Analysis: 61 für Astra und 66 für Fable 5.1. Im aktuellen Live-Vergleich wird der Intelligence Index v4.3 verwendet; beide Modelle erreichen 53 Punkte. Diese Aktualisierung ist der größte Unterschied zwischen diesem Artikel und vielen frühen Vergleichen.
| Artificial-Analysis-v4.3-Evaluierung |
GPT-6 Astra max |
Claude Fable 5.1 max |
Führend |
| Intelligence Index |
53 |
53 |
Unentschieden |
| AA-Briefcase |
1.562 |
1.662 |
Fable 5.1 |
| GDPval-AA v2 |
1.580 |
1.763 |
Fable 5.1 |
| AutomationBench-AA |
68 % |
59 % |
Astra |
| Terminal-Bench v4.0 |
59 % |
52 % |
Astra |
| SciCode |
56 % |
63 % |
Fable 5.1 |
| Humanity's Last Exam |
55 % |
59 % |
Fable 5.1 |
| GDP.pdf |
31 % |
26 % |
Astra |
| CritPt |
32 % |
30 % |
Astra |
| AA-Omniscience |
43 |
43 |
Unentschieden |
| AA-LCR v1.1 |
81 % |
85 % |
Fable 5.1 |
Quelle: Live-Vergleich von Artificial Analysis: GPT-6 Astra vs. Claude Fable 5.1, abgerufen am 8. September 2026.
Die Verteilung ist aussagekräftiger als das unentschiedene Gesamtergebnis. Astra liegt bei Automatisierung, Terminalaufgaben, PDF-Aufgaben und Critical-Point-Reasoning vorn. Fable liegt bei professioneller Wissensarbeit, wissenschaftlichem Coding, HLE und Reasoning mit langem Kontext vorn. Wählen Sie den Benchmark, der der Arbeit, die Sie tatsächlich ausliefern, am nächsten kommt.
GPT-6 Astra vs. Claude Fable 5.1 beim Coding
Astra für Ausführung und Fehlerbehebung wählen
Astra ist der bessere Ausgangspunkt, wenn ein Coding-Agent mehr leisten muss, als nur einen Patch zu erstellen. Besonders gut eignet es sich für Workflows, in denen das Modell Folgendes tun muss:
ein großes Repository untersuchen und Abhängigkeiten nachverfolgen;
mehrere Dateien bearbeiten und Projektkonventionen einhalten;
Shell-Befehle und Testsuiten ausführen;
eine fehlerhafte Umgebung diagnostizieren;
die Anwendung in einem Browser rendern;
Fehler untersuchen und so lange iterieren, bis die Abnahmekriterien erfüllt sind.
Die Spitzenwerte bei Terminal-Bench, DeepSWE und AutomationBench stützen diesen Anwendungsfall. Noch wichtiger ist, dass diese Fähigkeiten zu den Ausführungssteuerungen des Modells passen. Ein hoher Coding-Wert ist weniger wertvoll, wenn das umgebende System das Modell nicht über einen langen Zyklus aus Planen, Handeln, Beobachten und Beheben hinweg auf Kurs halten kann.
Fable 5.1 für klaren Code und spezialisiertes Reasoning wählen
Fable 5.1 ist einen A/B-Test wert, wenn die Schwierigkeit darin liegt, das Problem zu verstehen, gut lesbaren Code zu erstellen oder wissenschaftliche und analytische Details zu durchdenken. Die unabhängigen Spitzenwerte bei SciCode, AA-Briefcase, GDPval-AA v2 und HLE sprechen dafür.
Das bedeutet nicht, dass Fable ein schwacher agentischer Coding-Assistent ist. Anthropic berichtet, dass frühe Partner das Modell für Änderungen in mehreren Repositories, Untersuchungen von Vorfällen, Browser-Agenten und Coding von Anfang bis Ende eingesetzt haben. Diese Partnerberichte finden sich in Anthropics eigener Ankündigung von Fable 5.1 und sind daher nützliche Beispiele, aber keine neutralen Direktvergleiche.
Die praktische Aufteilung für Entwickler sieht so aus:
Verwenden Sie Astra, wenn Erfolg bedeutet: Die Aufgabe wurde ausgeführt, bestanden und überprüft.
Verwenden Sie Fable 5.1, wenn Erfolg bedeutet: Das Design oder die Schlussfolgerung ist schlüssig, überprüfbar und leicht zu warten.
Einen breiteren Überblick über die Modellfamilien finden Sie unter Claude vs. ChatGPT fürs Coding.
GPT-6 Astra vs. Claude Fable 5.1 beim Frontend-Coding
Es gibt keinen allgemein anerkannten Benchmark, der ein gutes Gespür für Frontend-Design zuverlässig misst. SWE-Benchmarks testen die Arbeit in Repositories; visuelle Hierarchie, ausgefeilte Interaktionen, responsives Verhalten, Barrierefreiheit oder die Treue zu einer Referenzgrafik bewerten sie nicht zuverlässig.
Die verfügbaren Praxiserfahrungen deuten auf eine sinnvolle Aufteilung hin:
Fable 5.1 für den ersten designorientierten Implementierungsentwurf. Häufig erstellt es gut lesbaren Code und ausgefeilte kleine Interaktionen.
Astra für die Full-Stack-Ausführung und Browser-QA. Es ist besser dafür geeignet, die Anwendung auszuführen, das gerenderte Ergebnis zu prüfen, Animationen oder Geometrie nachzubilden und Fehler zu beheben.
In einem öffentlichen Vergleich mit sechs Aufgaben bescheinigte Abel Baruwa Astra fünf Siege, darunter flüssigere Animationen und bessere 3D-Arbeit. Gleichzeitig lobte er bei Fable 5.1 ausgefeilte Buttons, Animationen und Interaktionsdetails. Das ist der einmalige Test eines einzelnen Erstellers, kein kontrollierter Benchmark.
Ein guter Produktionsworkflow kann beide Modelle einsetzen: Bitten Sie Fable um die Komponentenarchitektur und den ersten visuellen Entwurf. Verwenden Sie anschließend Astra mit Browser-Tools, um Breakpoints, Konsolenfehler, Tastaturnavigation, Ladezustände und pixelgenaue Abnahmekriterien zu testen. Wenn Sie nur eines wählen können, nehmen Sie Astra, wenn Überprüfung wichtiger ist als der erste Designentwurf; wählen Sie Fable, wenn ein Entwickler jede Änderung prüft und visuelle Feinheiten entscheidend sind.
GPT-6 Astra vs. Claude Fable 5.1 für Agenten
Die Modellqualität ist nur eine Ebene eines Agenten. Tool-Umgebung, Berechtigungen, Zustandsverwaltung, Wiederholungsrichtlinien und Evaluator entscheiden oft darüber, ob ein Durchlauf erfolgreich ist.
| Anforderung an den Agenten |
Besserer Ausgangspunkt |
Begründung |
| Bedienung von Browser oder Desktop |
GPT-6 Astra |
Von Haus aus auf Computernutzung und visuelle Überprüfung ausgerichtet |
| Langer Terminal-Workflow |
GPT-6 Astra |
Aktuell stärkere Evaluierungen für Terminal und Automatisierung |
| Asynchrone externe Tools |
GPT-6 Astra |
Unterstützt asynchrone Tool-Aufrufe und Steuerung während eines Durchlaufs |
| Sehr großer, wiederholt verwendeter Kontext |
Claude Fable 5.1 |
Deutlich günstigere Cache-Lesezugriffe |
| Agent für intensive Recherche oder wissenschaftliche Aufgaben |
Claude Fable 5.1 |
Stärkere relevante unabhängige Evaluierungen |
| Strenge Orchestrierung mit erzwungenen Tools |
GPT-6 Astra oder eine angepasste Fable-Tool-Umgebung |
Fable 5.1 lehnt tool_choice: any und tool ab; verwenden Sie stattdessen auto, none oder strikte Schemas |
| Strenge Anforderungen an die Aufbewahrung sensibler Daten |
Vor der Wahl von Fable prüfen |
Fable 5.1 erfordert eine Aufbewahrungsfrist von 30 Tagen, sofern Anthropic nicht ausdrücklich eine Ausnahme genehmigt |
Sichern Sie bei beiden Modellen destruktive Aktionen durch Genehmigungsschritte ab, validieren Sie Tool-Argumente, setzen Sie Grenzen für Iterationen und Ausgaben und definieren Sie einen Ausweichpfad. Ein Agent, der Browser oder Terminal bedienen kann, benötigt außerdem klare Autorisierungsgrenzen. Starke Benchmark-Ergebnisse ersetzen keine Sicherheitsmaßnahmen auf Anwendungsebene.
Preise: Listenpreis, Cache-Preis und Kosten pro Aufgabe
Offizielle API-Preise
Beide Modelle haben denselben offiziellen Standardpreis für Ein- und Ausgaben. Der wesentliche Unterschied in der Preisliste betrifft Cache-Lesezugriffe.
| Offizieller Preis pro 1 Mio. Tokens |
GPT-6 Astra |
Claude Fable 5.1 |
| Eingabe |
10,00 $ |
10,00 $ |
| Ausgabe |
50,00 $ |
50,00 $ |
| Cache-Schreibvorgang (5 Minuten) |
12,50 $ |
12,50 $ |
| Cache-Lesezugriff |
1,00 $ |
0,25 $ |
| Batch-Ein-/Ausgabe |
50 % Rabatt |
50 % Rabatt |
Quellen: Dokumentation der OpenAI-API-Modelle und Dokumentation zu Claude Fable 5.1.
Anthropic schätzt, dass Fable 5.1 durch den niedrigeren Preis für Cache-Lesezugriffe die Kosten typischer Workloads im Vergleich zu Fable 5 um etwa 25 % und die Kosten stark agentischer Workloads um bis zu etwa 45 % senkt. Diese Angaben beruhen auf von Anthropic gemessenen Workload-Mischungen und sind keine Garantie für jede Anwendung.
Bei Astra ist außerdem der Umgang mit langem Kontext zu beachten. Bei direkten OpenAI-Anfragen mit mehr als 272.000 Eingabetokens wird die gesamte Anfrage zu höheren Preisen abgerechnet: 2× für Eingaben und Eingaben aus dem Cache sowie 1,5× für Ausgaben. Kalkulieren Sie Tests mit langem Kontext separat, statt die Kosten aus einer kurzen Anfrage hochzurechnen.
GPT Proto-Preise
Am 8. September 2026 listen die aktuellen GPT Proto-Rechner folgende Standardpreise auf:
| GPT Proto-Preis pro 1 Mio. Tokens |
GPT-6 Astra |
Claude Fable 5.1 |
| Eingabe |
8,00 $ |
9,00 $ |
| Ausgabe |
40,00 $ |
45,00 $ |
| Cache-Schreibvorgang |
10,00 $ |
11,25 $ |
| Cache-Lesezugriff |
0,80 $ |
0,225 $ |
Bei einer Anfrage mit 1.500 neuen Eingabetokens und 800 Ausgabetokens kostet Astra ohne Cache-Aktivität ungefähr 0,044 $ und Fable 5.1 ungefähr 0,0495 $. Bei diesem einfachen Anfrageformat ist Astra günstiger.
Nehmen wir nun 3.000 Tokens für Cache-Schreibvorgänge und 25.000 Tokens für Cache-Lesezugriffe hinzu. Die geschätzten Gesamtkosten betragen dann etwa 0,094 $ für Astra und 0,0889 $ für Fable 5.1. Fable ist günstiger, weil Cache-Lesezugriffe deutlich weniger kosten.
Deshalb gibt es auf die Frage „Welches Modell ist kosteneffizienter?“ zwei richtige Antworten:
Astra ist bei GPT Proto pro Standard-Ein- und Ausgabetoken günstiger.
Fable 5.1 kann bei langen, wiederholungsreichen Sitzungen mit einer hohen Cache-Trefferquote günstiger sein.
Prüfen Sie vor dem Produktionseinsatz den aktuellen Astra-Preisrechner und den Preisrechner für Fable 5.1.
Kosten pro Aufgabe erzählen eine andere Geschichte
Der aktuelle Vergleich von Artificial Analysis mit maximalem Aufwand meldet folgende Werte:
| Unabhängige Effizienzkennzahl |
GPT-6 Astra |
Claude Fable 5.1 |
| Gemischter Preis pro 1 Mio. Tokens |
7,70 $ |
7,175 $ |
| Kosten pro Aufgabe |
3,26 $ |
7,63 $ |
| Ausgabetokens pro Aufgabe |
27.000 |
78.000 |
| Reasoning-Tokens pro Aufgabe |
17.000 |
47.000 |
| Ausgabegeschwindigkeit |
59 Tokens/s |
70 Tokens/s |
| Zeit bis zum ersten Token |
322,48 s |
277,47 s |
| Gesamtdauer pro Aufgabe |
467,25 s |
724,10 s |
Fable hat in diesem Setup den niedrigeren gemischten Tokenpreis und generiert Tokens schneller. Dennoch liegen Astras Kosten pro Aufgabe etwa 57 % niedriger, weil das Modell deutlich weniger Ausgabe- und Reasoning-Tokens benötigt. Auch die gemessene Aufgabe erledigt Astra insgesamt schneller.
Das beweist nicht, dass Astra in Ihrem Repository günstiger sein wird. Es zeigt, dass der Tokenpreis allein kein ausreichendes Kaufkriterium ist. Erfassen Sie die Gesamtausgaben pro akzeptierter Aufgabe – einschließlich Wiederholungsversuchen, Ausweichaufrufen, durch Tools erzeugtem Kontext und menschlichem Prüfaufwand.
Was Entwickler berichten
Frühe Community-Berichte liefern zusätzliche Einblicke, bleiben aber anekdotisch. Prompts, Tools, Modellaufwand, Abonnementlimits und Aufgabenbedingungen werden selten kontrolliert.
Dan Shippers erster Eindruck von Astra hob die ungewöhnlich starke Computernutzung sowie die Leistungen bei 3D- und Visualisierungsaufgaben hervor. Zugleich warnte er, dass das Modell Aufgaben überkomplizieren kann, insbesondere bei höherem Aufwand. Siehe den Originalbeitrag auf X.
In einem ausführlichen direkten Vergleich eines Machine-Learning-Workflows fand ein Reddit-Nutzer Astra agentischer und stärker beim Debugging und bei der Reproduzierbarkeit. Lesbaren Code, Schreibstil, das Befolgen von Anweisungen und den Analysebericht von Fable 5.1 zog der Nutzer jedoch vor. Der Beitrag dokumentiert auch konkrete Fehler beider Modelle. Siehe den vollständigen ML-Vergleich.
Öffentliche Frontend- und 3D-Vergleiche bevorzugen oft Astras Ausführung oder Realismus, schreiben Fable aber ausgefeilte Interaktionen zu. Diese Tests liefern Hypothesen für Ihren Evaluierungssatz, bestimmen jedoch keinen allgemeinen Sieger.
Das wiederkehrende Muster ist aussagekräftiger als jede einzelne virale Demo: Astra treibt die Arbeit tendenziell energisch voran; Fable erstellt häufig ein klareres oder durchdachteres Ergebnis. Beide können überzeugend vorgetragene, aber überprüfbare Fehler machen.
Ein faires Evaluierungsverfahren für Ihren API-Workload
Vergleichen Sie nicht ein Modell in einer ausgereiften Coding-Umgebung mit dem anderen in einem einfachen Chatfenster. Halten Sie das Umfeld der Modelle so ähnlich wie möglich.
Wählen Sie 20–50 repräsentative Aufgaben aus der tatsächlichen Produktionsarbeit aus.
Geben Sie beiden Modellen denselben Repository-Zustand, Prompt, dieselben Tool-Berechtigungen und Abnahmekriterien.
Stimmen Sie den Reasoning-Aufwand so weit wie möglich aufeinander ab.
Legen Sie identische Zeit-, Token-, Iterations- und Wiederholungsbudgets fest.
Führen Sie jede Aufgabe mehr als einmal aus, um Zufallstreffer einzelner Durchläufe zu reduzieren.
Bewerten Sie die Ergebnisse nach Möglichkeit mit ausführbaren Tests oder anhand eines verblindeten Bewertungsrasters.
Erfassen Sie Erfolgsquote im ersten Durchlauf, endgültigen Erfolg, Laufzeit, Tokens, Cache-Lesezugriffe, Wiederholungen und Minuten für menschliche Prüfungen.
Berechnen Sie die Kosten pro akzeptiertem Ergebnis, nicht nur die Kosten pro Token.
Verwenden Sie ein Bewertungsraster wie dieses:
| Kennzahl |
Gewichtung |
Astra |
Fable 5.1 |
| Aufgabenerfolg |
40 % |
|
|
| Korrektheit / Erfolgsquote der Tests |
20 % |
|
|
| Zeitaufwand für menschliche Prüfung |
15 % |
|
|
| End-to-End-Latenz |
10 % |
|
|
| Gesamtkosten pro akzeptiertem Ergebnis |
10 % |
|
|
| Wartbarkeit des Codes oder Artefakts |
5 % |
|
|
Ändern Sie die Gewichtungen, bevor Sie die Ergebnisse ansehen. Andernfalls ist es leicht, die Maßstäbe nachträglich zugunsten des Modells zu verschieben, das Sie ohnehin bevorzugen.
Beide Modelle über die GPT Proto-API testen
GPT Proto stellt beide Modellrouten über denselben OpenAI-kompatiblen Chat-Completions-Endpunkt bereit. Verwenden Sie für einen ersten A/B-Test denselben Prompt und ändern Sie nur die Modell-ID.
Anfrage an GPT-6 Astra
curl --request POST "https://gptproto.com/v1/chat/completions" \
  --header "Authorization: Bearer $GPTPROTO_API_KEY" \
  --header "Content-Type: application/json" \
  --data '{
    "model": "gpt-6-astra",
    "messages": [
      {
        "role": "user",
        "content": "Review this implementation plan. Identify failure modes, then return a prioritized test plan."
      }
    ]
  }'
Anfrage an Claude Fable 5.1
curl --request POST "https://gptproto.com/v1/chat/completions" \
  --header "Authorization: Bearer $GPTPROTO_API_KEY" \
  --header "Content-Type: application/json" \
  --data '{
    "model": "claude-fable-5-1",
    "messages": [
      {
        "role": "user",
        "content": "Review this implementation plan. Identify failure modes, then return a prioritized test plan."
      }
    ]
  }'
Für einen aussagekräftigen Coding- oder Agentenvergleich führen Sie diese Aufrufe innerhalb desselben Evaluators aus und statten Sie beide Routen mit gleichwertigen Tools aus. Protokollieren Sie Nutzung und Latenz bei jedem Versuch und bewerten Sie anschließend das erzeugte Artefakt statt der Sprachgewandtheit der Antwort.
Welches Modell sollten Sie wählen?
Wählen Sie GPT-6 Astra, wenn die meisten dieser Aussagen zutreffen:
Ihr Agent arbeitet in einem Terminal, Browser, Repository oder einer professionellen Anwendung.
Erledigung und Überprüfung sind wichtiger als der Schreibstil.
Sie möchten die niedrigeren GPT Proto-Standardpreise für Ein- und Ausgaben.
Ihre Workloads ähneln Tests für Automatisierung, Terminal, PDFs oder mehrstufige Ausführung.
Sie möchten asynchrone Tool-Aufrufe oder die Möglichkeit, den Agenten während eines Durchlaufs zu steuern.
Wählen Sie Claude Fable 5.1, wenn die meisten dieser Aussagen zutreffen:
Ihre schwierigsten Aufgaben betreffen wissenschaftliches Coding, Recherche, Planung oder wissensintensive Arbeit.
Gut lesbarer Code und ausgefeilte Interaktionsdetails sind besonders wichtig.
In langen Sitzungen wird wiederholt derselbe umfangreiche Kontext gelesen.
Ihr Workload profitiert von beibehaltenen Gedankengängen und anpassbarem Aufwand pro Nachricht.
Ihre eigene Evaluierung zeigt trotz der höheren GPT Proto-Standardpreise weniger Wiederholungen oder geringeren menschlichen Prüfaufwand.
Nutzen Sie beide Modelle, wenn sie unterschiedliche Fehlerarten aufweisen. Ein praktischer Router kann ausführungsintensive Aufgaben an Astra, analytische oder designorientierte Aufgaben an Fable 5.1 senden und fehlgeschlagene Aufgaben mit dem jeweils anderen Modell erneut versuchen. Eine intelligente Weiterleitung ist oft kosteneffizienter, als jedes Anliegen einem einzigen Frontier-Modell zu überlassen.
Fazit
Für die meisten API-Teams, die zwischen OpenAI GPT-6 Astra und Anthropic Claude Fable 5.1 wählen, ist Astra die bessere erste Option für Coding-Ausführung, Browser- oder Computernutzung und Agenten-Workflows. Es verbindet stärkere ausführungsorientierte Benchmark-Ergebnisse mit aktuell niedrigeren GPT Proto-Standardpreisen und geringeren gemessenen Kosten pro unabhängiger Benchmark-Aufgabe.
Fable 5.1 bleibt die bessere Spezialistenoption, wenn wissenschaftliches oder wissensintensives Reasoning, wartbarer Code, eine ausgefeilte Benutzeroberfläche oder wiederholt verwendeter Cache-Kontext über den Erfolg entscheiden. Dank der niedrigeren Preise für Cache-Lesezugriffe kann es außerdem günstiger sein, obwohl seine Standard-Tokenpreise bei GPT Proto höher liegen.
Am zuverlässigsten ist ein A/B-Test auf Aufgabenebene. Beginnen Sie mit GPT-6 Astra, vergleichen Sie denselben Workload mit Claude Fable 5.1 und setzen Sie das Modell ein, das pro akzeptiertem Ergebnis weniger kostet.