Claude vs. ChatGPT fürs Programmieren: Kurzurteil
Die beste Wahl hängt davon ab, wie du programmierst und wie viel der Aufgabe die KI selbstständig erledigen soll.
| Programmieraufgabe |
Besserer Einstieg |
Warum |
| Kleine Funktionen und Skripte |
Unentschieden |
Die Qualität des Prompts und die Modellstufe sind meist wichtiger als der Anbieter |
| Interaktives Pair-Programming |
Claude Code |
Schnelles Feedback und umfassende Anpassungsmöglichkeiten im Terminal |
| Lange, autonome Programmieraufgaben |
Codex |
Stark bei Delegation, Prüfung und Hintergrund-Workflows |
| Frontend- und UI-Erstellung |
Claude |
Ein leichter qualitativer Vorteil bei visueller Umsetzung und Iteration |
| Fehlersuche mit starker Terminal-Nutzung |
ChatGPT/Codex |
GPT-5.6 Sol liegt im gemeinsamen Terminal-Bench-Vergleich knapp vorn |
| Refactoring eines ganzen Repositorys |
Claude Opus 5 |
Starke Leistung bei Code-Migrationen und der Entwicklung über mehrere Dateien hinweg |
| Python-Entwicklung |
Unentschieden |
Der Gewinner hängt von der Aufgabe, den Bibliotheken, den Tests und dem Zugriff auf das Repository ab |
| Große Codebasen |
Claude, leichter Vorteil |
Starkes Schlussfolgern über Repositorys hinweg, obwohl beide Modellfamilien inzwischen sehr große Kontexte unterstützen |
| Einstiegsabo fürs Programmieren |
ChatGPT Plus |
Das veröffentlichte Codex-Kontingent lässt sich in der Regel einfacher einschätzen und ausschöpfen |
| API-Bereitstellung |
Hängt von der Modellstufe ab |
Die Kosten pro akzeptiertem Ergebnis sind wichtiger als der Preis einer einzelnen Anfrage |
Wähle Claude für enge Zusammenarbeit und umfangreiche, miteinander verknüpfte Änderungen. Entscheide dich für ChatGPT mit Codex, wenn du Aufgaben lieber delegierst und anschließend prüfst. API-Teams sollten einzelne Modelle bewerten, statt einen der Anbieter als einheitliches Produkt zu betrachten.
Was vergleichen wir: Claude, ChatGPT, Claude Code oder Codex?
Der Unterschied zwischen Claude und ChatGPT beginnt bei den jeweiligen Produkten.
Claude.ai und ChatGPT sind allgemeine Anwendungen zum Erklären, Erstellen und Überprüfen von Code. Claude Code und Codex sind Programmieragenten, die Repositorys untersuchen, Dateien bearbeiten, Befehle und Tests ausführen sowie Fehler beheben können. Dadurch wird aus der Aufgabe „Code schreiben“ die Aufgabe „eine funktionierende Änderung erstellen und überprüfen“.
APIs bilden eine weitere Ebene: Die umgebende Anwendung wählt Dateien und Tools aus, führt Befehle aus, gibt Fehler zurück und entscheidet, wann die Arbeit abgeschlossen ist. Ein Modell, das im Chat eine korrekte Funktion schreibt, kann sich innerhalb eines Agenten daher anders verhalten. Ein fairer Vergleich von Claude AI und ChatGPT muss sowohl das Modell als auch seine Arbeitsumgebung berücksichtigen.
Aktuelle Claude- und GPT-Modelle fürs Programmieren
Ein aktueller Vergleich von Claude und ChatGPT fürs Programmieren muss gleichwertige Modellstufen gegenüberstellen. Anthropic empfiehlt Claude Opus 5 für die meisten komplexen Workloads und Fable 5.1 für besonders anspruchsvolle Aufgaben mit langem Zeithorizont. OpenAI positioniert GPT-5.6 Sol als Flaggschiff für komplexe Programmieraufgaben, Terra und Luna sind für leichtere Workloads gedacht.
| Modell |
Geeignet für |
Kontextfenster |
Wichtigster Kompromiss |
| Claude Fable 5.1 |
Anspruchsvolle, lang laufende agentische Programmieraufgaben |
1 Mio. Token |
Höchster Claude-API-Preis und höhere Latenz |
| Claude Opus 5 |
Komplexe Programmierung, Migrationen und Arbeit an Repositorys |
1 Mio. Token |
Teurer als Modelle der mittleren Preisklasse |
| Claude Sonnet 5 |
Alltägliche Programmieraufgaben mit geringerer Latenz |
1 Mio. Token |
Geringere Leistungsgrenze bei den schwierigsten Entwicklungsaufgaben |
| GPT-5.6 Sol |
Komplexe Programmierung, Agenten und Terminal-Aufgaben |
1,05 Mio. Token |
Höhere Kosten und Latenz als bei kleineren GPT-Modellen |
| GPT-5.6 Terra |
Alltägliche Entwicklung und Produktionsaufgaben |
1,05 Mio. Token |
Bei den schwierigsten Aufgaben weniger leistungsfähig als Sol |
| GPT-5.6 Luna |
Gezielte Skripte und Transformationen mit hohem Volumen |
1,05 Mio. Token |
Nicht für die unklarsten Entwicklungsaufgaben vorgesehen |
Die aktuellen Claude-Modellfamilien und OpenAI-Modellfamilien findest du auf GPT Proto. Für anspruchsvolle Programmieraufgaben sind die relevantesten Einzelseiten Claude Fable 5.1, Claude Opus 5 und GPT-5.6 Sol. Für routinemäßige Produktionsaufgaben ist GPT-5.6 Terra ein wirtschaftlicherer Vergleichspunkt.
Stimme die Modelle auf den jeweiligen Workload ab und ermittle anschließend die Gesamtkosten für ein akzeptables Ergebnis.
Was Programmier-Benchmarks tatsächlich zeigen
Die aktuellen Benchmark-Ergebnisse sprechen nicht für einen eindeutigen Gesamtsieger. Claude liegt bei einigen Tests zu Repositorys und Codegenerierung vorn, während GPT-5.6 Sol einen gemeinsamen Terminal-Benchmark knapp anführt.
| Benchmark |
Claude-Ergebnis |
GPT-Ergebnis |
Was das nahelegt |
| Terminal-Bench 2.1 |
Fable 5.1: 85.02 % |
GPT-5.6 Sol: 85.77 % |
GPT liegt bei terminalbasierten Agentenaufgaben knapp vorn |
| SWE-bench Verified |
Opus 5: 97.00 % |
GPT-5.6 Sol: 96.20 % |
Beide sind bei realen Problemen in Repositorys äußerst konkurrenzfähig |
| Vibe Code Bench |
Fable 5.1: 90.26 % |
GPT-5.6 Sol: 80.50 % |
Claude zeigt Vorteile bei der durchgängigen App-Erstellung |
| LiveCodeBench |
Fable 5.1: 90.52 % |
— |
Starke Problemlösung bei Code, aber kein umfassender Produktvergleich |
Diese Ergebnisse stammen aus Vals-Bewertungen von Claude Fable 5.1, Claude Opus 5 und GPT-5.6 Sol, müssen aber im Kontext betrachtet werden.
Fable 5.1 wurde beispielsweise mit serverseitigen Claude-Fallbacks bei Verweigerungen bewertet. Laut Vals sinkt der Wert bei Terminal-Bench 2.1 von 85.02 % auf 79.03 %, wenn Aufgaben mit Fallback-Unterstützung als Fehlschläge gewertet werden. Auch die Bewertungseinstellungen unterscheiden sich: Fable 5.1 und GPT-5.6 Sol nutzten den maximalen Aufwand, während Opus 5 bei Terminal-Bench mit hohem Aufwand getestet wurde.
Claude schneidet bei Codegenerierung, Migrationen und der Erstellung von Anwendungen besonders gut ab. GPT-5.6 Sol liegt bei der Behebung von Problemen in Repositorys nahe dran und ist beim gemeinsamen Terminal-Benchmark leicht vorn. Bei anderen Agenten, Tools oder Codebasen kann sich die Reihenfolge umkehren.
Claude vs. ChatGPT für die Codegenerierung
Bei kleinen, klar definierten Aufgaben zur Codegenerierung liegen Claude und ChatGPT so nah beieinander, dass es keinen verlässlichen Gesamtsieger gibt. Beide können Funktionen, Datentransformationen, API-Handler, Testfälle und kleine Anwendungen erstellen, wenn der Prompt die relevanten Anforderungen enthält.
Claude eignet sich gut als Einstieg für die Implementierungsplanung und die Koordination von Änderungen über mehrere Dateien hinweg. ChatGPT ist ebenso praktisch für gezielte Skripte, strukturierte Ausgaben und Aufgaben mit klar definiertem Abschlusskriterium. Mit Codex können GPT-Modelle Änderungen implementieren und überprüfen, statt nur Code vorzuschlagen.
Wenn du Claude und ChatGPT fürs Programmieren vergleichst, gib beiden dieselbe Sprache und dieselben Abhängigkeitsversionen, zu bearbeitenden Dateien, erwarteten Verhaltensweisen, Kompatibilitätsbedingungen und erforderlichen Tests vor. Eine kürzere Antwort kann trotzdem besser sein, wenn der Code gleich beim ersten Versuch besteht. Miss die akzeptierten Ergebnisse, nicht den Eindruck, den die Antwort macht.
Claude vs. ChatGPT beim Debugging
Der Vergleich von Claude und ChatGPT beim Debugging umfasst mehr als einen einzelnen Fall. Einen eingefügten Stacktrace zu untersuchen ist etwas anderes, als eine Regression in einem unbekannten Repository aufzuspüren. 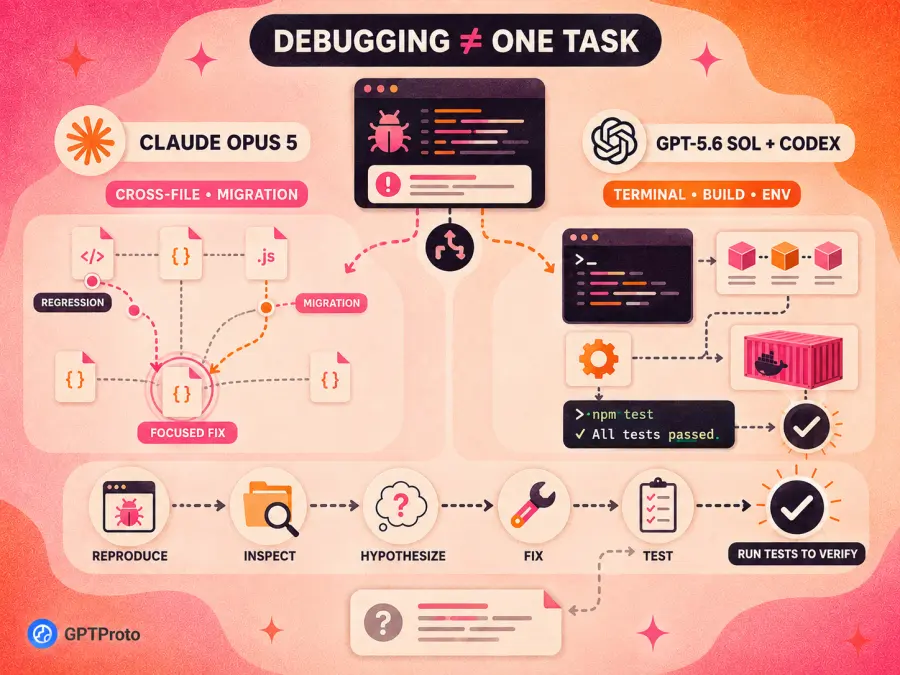
Bei einer einzelnen Fehlermeldung können beide Produkte in der Regel mögliche Ursachen erläutern und Prüfungen vorschlagen. Das Ergebnis hängt stark davon ab, ob der Nutzer den umgebenden Code, die Laufzeitversion, die Abhängigkeitsversionen, die Eingabedaten und den vollständigen Fehler statt nur der letzten Zeile angibt.
Bei Problemen mit Terminal, Abhängigkeiten, Builds und Umgebungen ist GPT-5.6 Sol mit Codex ein guter Ausgangspunkt. Der knappe Vorsprung bei Terminal-Bench deutet auf Stärken bei Aufgaben hin, die Interaktionen über die Befehlszeile erfordern. Unter den angegebenen Einstellungen beträgt der Abstand zu Fable 5.1 jedoch weniger als einen Prozentpunkt.
Bei Fehlern in dateiübergreifender Logik, Migrationen und Architekturregressionen ist Claude Opus 5 eine sinnvolle erste Wahl. Seine starken Ergebnisse bei Repository- und Code-Migrationstests deuten darauf hin, dass es effektiv sein kann, wenn eine Fehlerbehebung das Verständnis der Zusammenhänge zwischen mehreren Modulen erfordert.
In der Praxis hängt die Qualität beim Debugging davon ab, ob der Agent den Fehler reproduzieren, relevante Dateien untersuchen, eine überprüfbare Hypothese aufstellen, eine gezielte Korrektur vornehmen und die betroffenen Tests ausführen kann. Hat er keinen Zugriff auf die Umgebung, solltest du seine Antwort als Hypothese behandeln – nicht als verifizierte Fehlerbehebung.
Claude vs. ChatGPT fürs Frontend-Programmieren
Claude hat beim Frontend-Programmieren einen leichten qualitativen Vorteil, insbesondere wenn eine visuelle Richtung in Komponenten, Layouts, responsives Verhalten, Animationen oder interaktive Zustände übertragen werden soll. Erste Berichte zu Claude Opus 5 heben auch Verbesserungen bei Full-Stack-Anwendungen hervor, darunter visuelle und interaktive Aufgaben.
Das bedeutet nicht, dass jede Claude-Ausgabe ausgefeilt aussieht. Bei vagen Briefings können beide Produkte auf generische Karten, Farbverläufe und Desktop-Layouts zurückgreifen. Gib ihnen dieselbe Designvorlage, dieselben Viewport-Größen, dasselbe Framework, dieselben Markenrichtlinien, Interaktionszustände, Barrierefreiheitsanforderungen und Abnahmekriterien.
Keines der Modelle sollte seine eigene visuelle Ausgabe allein anhand des Quellcodes beurteilen. Die Leistung verbessert sich, wenn der Agent die Seite starten, Screenshots prüfen, sie mit der Vorlage vergleichen und das CSS überarbeiten kann. Claude liefert vielleicht den besseren ersten Versuch; der bessere Workflow ist jedoch der, der eine visuelle Überprüfung einschließt.
Claude vs. ChatGPT für Python
Bei Claude vs. ChatGPT für Python gibt es keinen allgemeinen Sieger, denn „Python-Programmierung“ reicht von einem Skript mit zehn Zeilen zum Umbenennen von Dateien bis hin zu einem großen Django-Dienst oder einer Machine-Learning-Pipeline.
| Python-Aufgabe |
Besserer Einstieg |
| Kleines Automatisierungsskript |
Claude oder ChatGPT |
| Datenbereinigung und -transformation |
Ein ausgewogenes Modell wie Sonnet 5 oder GPT-5.6 Terra |
| Umfangreiches Refactoring einer Python-Anwendung |
Claude Opus 5 |
| Fehlersuche bei CLI, Paket oder Umgebung |
GPT-5.6 Sol mit Codex |
| Lange Erläuterung zu einem Notebook |
Claude ist oft leichter nachvollziehbar |
| Wiederholte Transformationen mit hohem Volumen |
Ein kleineres, günstigeres Modell nach der Validierung |
Bewerte beide in derselben Umgebung und prüfe die Kompatibilität der Abhängigkeiten, Sonderfälle, Dateiverarbeitung, Typprüfungen, Linting und die Ergebnisse von pytest. Eine klare Erklärung ist weniger wichtig als ein verifiziertes Verhalten.
Claude vs. ChatGPT für große Codebasen
Claude ist für viele Analysen ganzer Repositorys, Code-Migrationen und koordinierte Änderungen über mehrere Dateien hinweg die stärkere erste Wahl. Claude Opus 5 schneidet bei Code-Migrations- und Repository-Benchmarks stark ab, während Fable 5.1 für anspruchsvolle, lang laufende agentische Aufgaben vorgesehen ist.
Die Größe des Kontextfensters allein erklärt diesen Vorteil jedoch nicht. Die aktuellen Claude-Flaggschiffmodelle bieten ein Kontextfenster von bis zu 1 Mio. Token, während die GPT-5.6-Familie etwa 1,05 Mio. Token unterstützt. Beide können umfangreiche Codebestände aufnehmen, aber ein ganzes Repository wahllos einzufügen kann Token verschwenden und relevante Abhängigkeiten verschleiern.
Die Leistung bei großen Codebasen hängt davon ab, ob der Agent das Repository erfassen, relevante Dateien finden, Projektanweisungen befolgen, Schnittstellen beibehalten und Änderungen überprüfen kann. Eine gezielte Kontextauswahl und -verdichtung kann wichtiger sein als das beworbene Maximum.
Wähle Claude Opus 5 für umfangreiche Migrationen, architektonisches Schlussfolgern oder koordinierte Änderungen an miteinander verknüpften Modulen. GPT-5.6 Sol mit Codex ist eine gute Wahl, wenn die Aufgabe klar definiert ist, stark auf das Terminal setzt und sich für einen längeren autonomen Durchlauf eignet. Teile sehr große Änderungen in beiden Fällen in überprüfbare Schritte auf und verlange an jedem Übergang Tests.
Claude Code vs. Codex: Der Agent kann genauso wichtig sein wie das Modell
Claude Code und Codex unterscheiden sich im Workflow, noch bevor man ihre Standardmodelle berücksichtigt.
| Aspekt |
Claude Code |
Codex |
| Typischer Workflow |
Interaktive Entwicklung im Terminal |
Delegieren, ausführen und prüfen |
| Repository-Anweisungen |
CLAUDE.md |
AGENTS.md |
| Anpassungsmöglichkeiten |
Umfangreiche Hooks, Skills und Agentenkonfiguration |
Mehr verwaltete Standardeinstellungen und Sandbox-Steuerungen |
| Feedback-Stil |
Schnell und interaktiv |
Überlegter und autonomer |
| Geeignet für |
Entwickler, die eng eingebunden bleiben |
Hintergrundarbeit, Überprüfungen und parallele Aufgaben |
| Wichtigster Kompromiss |
Komplexe Sitzungen können Kontingente schnell aufbrauchen |
Manche Aufgaben dauern länger |
Ein nützlicher Test eines Drittanbieters von Composio hilft dabei, das Agenten-Framework vom zugrunde liegenden Modell zu unterscheiden. Die Evaluatoren führten dasselbe DeepSeek V4 Flash-Modell mit Claude Code und Codex aus: mit 30 identischen Aufgaben über mehrere Anwendungen hinweg, derselben gehosteten MCP-Konfiguration, maximalem Reasoning und einem Zeitlimit von 900 Sekunden pro Aufgabe.
| Ergebnis |
Claude Code |
Codex |
| Bestandene Aufgaben |
16/30 |
16/30 |
| Median der Bearbeitungszeit |
122,7 Sekunden |
245,0 Sekunden |
| Tool-Aufrufe |
358 |
448 |
| Geschätzte Gesamtkosten |
$3.116 |
$1.294 |
| Kosten pro Erfolg |
$0.195 |
$0.081 |
Beide Agenten-Frameworks erzielten gleich viele bestandene Aufgaben. Claude Code war bei der medianen Bearbeitungszeit etwa doppelt so schnell, während Codex rund 58 % weniger kostete. Der vollständige Vergleich von Composio stützt eine begrenzte Schlussfolgerung: Claude Code lieferte in diesem Setup schnelleres Feedback, während Codex das Budget besser ausschöpfte. Das beweist nicht, dass Claude-Modelle intelligenter sind, denn in beiden Tools wurde dasselbe Drittanbietermodell verwendet.
Nutzungslimits von Claude Pro im Vergleich zu ChatGPT Pro
Die Nutzungslimits von Claude Pro im Vergleich zu ChatGPT Pro werden häufig mit irreführenden festen Nachrichtenkontingenten beschrieben. Bei beiden Anbietern hängt der Verbrauch vom ausgewählten Modell, der Kontextlänge, dem Reasoning-Aufwand, den Tools und der Komplexität der Aufgabe ab.
Der derzeit ähnlichste Preisvergleich sieht so aus:
| Monatspreis |
Anthropic-Tarif |
OpenAI-Tarif |
| $20 |
Claude Pro |
ChatGPT Plus |
| $100 |
Claude Max 5x |
ChatGPT Pro 5x |
| $200 |
Claude Max 20x |
ChatGPT Pro 20x |
Die Claude-Nutzung wird gemeinsam für Claude.ai, Claude Desktop und Claude Code verwendet. Die Tarife kombinieren Sitzungslimits von fünf Stunden mit Wochenlimits. Nutzer können auf eine Zurücksetzung warten, ein Upgrade durchführen oder separat abgerechnetes Nutzungsguthaben aktivieren.
ChatGPT Work und Codex nutzen ebenfalls das jeweils geltende Nutzungskontingent gemeinsam. OpenAI veröffentlicht grobe Schätzungen für lokale Codex-Nachrichten pro Fünf-Stunden-Zeitraum. Für GPT-5.6 Sol liegen die aktuellen Richtwerte bei etwa 10–100 mit Plus, 50–500 mit Pro 5x und 200–2.000 mit Pro 20x. Cloud-Aufgaben können mehr verbrauchen als lokale Nachrichten, und zwei ähnlich wirkende Aufgaben können unterschiedlich viel Kontingent beanspruchen.
Diese Angaben sind Richtwerte für die Planung, keine Garantien. Eine lange Aufgabe an einem Repository kann mehr Kapazität verbrauchen als mehrere gezielte Änderungen. Für 20 $ ist ChatGPT Plus im Allgemeinen der verlässlichere Einstieg für die dauerhafte Nutzung von Agenten; intensive Nutzer von Claude Code benötigen möglicherweise das Max-Kontingent oder zusätzliches Nutzungsguthaben. Bei 100 $ und 200 $ ist der bevorzugte Workflow wichtiger als der angegebene Multiplikator.
Claude vs. ChatGPT API für Entwickler
Abotarife sind für Menschen gedacht, die direkt mit Claude- oder ChatGPT-Produkten arbeiten. Entwickler, die Anwendungen erstellen, sollten stattdessen API-Modelle und nutzungsbasierte Abrechnung vergleichen.
| Workload |
Claude-Option |
GPT-Option |
| Anspruchsvollste agentische Aufgaben mit langem Zeithorizont |
Claude Fable 5.1 |
GPT-5.6 Sol |
| Komplexe tägliche Programmieraufgaben |
Claude Opus 5 |
GPT-5.6 Sol |
| Ausgewogener Produktions-Workload |
Claude Sonnet 5 |
GPT-5.6 Terra |
| Fokussierte Aufgaben mit hohem Volumen |
Claude Haiku 4.5 |
GPT-5.6 Luna |
Offizielle Tokenpreise können bei der Auswahl eines ersten Modells helfen, zeigen aber nicht die Gesamtkosten eines Programmier-Workflows. Ein leistungsfähigeres Modell kann mit weniger Wiederholungen zum Ziel kommen. Ein günstigeres Modell kann sich für repetitive Aufgaben rechnen, aber teuer werden, wenn Entwickler seine Ergebnisse wiederholt korrigieren müssen.
Erfasse für deine eigenen Aufgaben die Erfolgsquote beim ersten Versuch, bestandene Tests, Wiederholungen, Eingriffe durch Menschen, fehlgeschlagene Tool-Aufrufe, Gesamttoken, Zeit und Kosten pro akzeptiertem Ergebnis. Je nach Phase kann ein anderes Modell gewinnen: Claude für die Repository-Analyse, GPT für die terminalintensive Implementierung und ein kleineres Modell für repetitive Transformationen.
Kannst du Claude- und GPT-Modelle gemeinsam verwenden?
Du musst dich nicht für jeden Programmier-Workload auf einen Anbieter festlegen. Anwendungen können Aufgaben je nach Komplexität, Latenz, Kosten oder Art der Entwicklungsarbeit weiterleiten.
GPT Proto bietet über einen API-Schlüssel und ein gemeinsames Guthaben Zugriff auf die Claude- und GPT-Modellfamilien. So kannst du dieselben Evaluierungsaufgaben einfacher an beide Anbieter senden, Qualität und Kosten vergleichen und Modelle wechseln, ohne separate Abrechnungskonten bei den Anbietern verwalten zu müssen.
Das bedeutet nicht, dass ein GPT Proto-Schlüssel in jedem nativen Programmier-Client ein Claude- oder ChatGPT-Abo ersetzt. Entwickler können unterstützte Claude- und GPT-APIs aus ihren eigenen Anwendungen aufrufen; die Kompatibilität hängt weiterhin davon ab, ob benutzerdefinierte Endpunkte und Anfrageschemata unterstützt werden.
Claude oder ChatGPT fürs Programmieren: Fazit
Wähle Claude, wenn du die meiste Zeit in einem interaktiven Terminal-Workflow arbeitest, Wert auf die Frontend-Umsetzung legst oder ein Modell brauchst, das über ein großes, zusammenhängendes Repository hinweg schlussfolgern kann. Claude Opus 5 ist ein sinnvoller Einstieg für die meisten komplexen Entwicklungsaufgaben, während Fable 5.1 für die schwierigsten Aufgaben mit langem Zeithorizont gedacht ist.
Wähle ChatGPT mit Codex, wenn du Aufgaben lieber delegierst und anschließend prüfst, autonome Aufgaben mit intensiver Terminal-Nutzung bearbeitest oder Programmierfunktionen in einem umfassenderen ChatGPT-Abo nutzen möchtest. GPT-5.6 Sol ist die leistungsstärkste GPT-Option für schwierige Aufgaben; Terra und Luna können die Kosten bei klareren und repetitiveren Aufgaben senken.
Entscheide bei der API-Entwicklung anhand deiner eigenen Abnahmetests, ob Claude oder ChatGPT fürs Programmieren besser geeignet ist. Führe dieselben Aufgaben, Tools und Tests mit vergleichbaren Modellstufen aus und miss erfolgreiche Ergebnisse, Korrekturen, Latenz und Kosten. Die öffentlich verfügbaren Daten zeigen zwei äußerst konkurrenzfähige Modellfamilien – keinen dauerhaften Champion.