O que uma alternativa à API Venice deveria realmente substituir?
Uma comparação útil começa com os verdadeiros diferenciais da Venice, não com uma lista genérica de recursos.
A Venice expõe mais de 350 modelos de texto, imagem, vídeo e áudio por meio de uma única chave. Sua API é amplamente compatível com clientes OpenAI, enquanto quatro modos de privacidade — Anonymous, Private, trusted execution environment (TEE) e end-to-end encrypted (E2EE) — a diferenciam. Ela também oferece suporte a créditos pré-pagos, uma franquia diária de DIEM e pagamentos em USDC via x402.
Esses pontos fortes têm limites. TEE e E2EE atualmente suportam apenas texto, e E2EE desativa recursos que exigem texto não criptografado, incluindo pesquisa na web, memória, resumos e algumas ferramentas. A Venice pode anexar seu prompt de sistema, a menos que isso seja desativado, e as janelas de descontinuação de modelos podem ser de apenas 7 a 15 dias.
Avaliei cada concorrente da API Venice com base em seis perguntas:
Cobertura: Quais modelos de texto, imagem, vídeo e áudio estão disponíveis?
Compatibilidade: Um cliente OpenAI consegue se conectar apenas alterando a URL base e o nome do modelo?
Privacidade: A proteção é contratual, técnica ou depende do provedor?
Operações: Como filas, tentativas, cold starts, limites e descontinuações são tratados?
Personalização: Fine-tuning, adaptadores, modelos personalizados ou auto-hospedagem estão disponíveis?
Custo: Quais taxas ou custos de infraestrutura existem além da tarifa listada?
Nenhuma alternativa vence nas seis. A melhor escolha depende de qual benefício da Venice é essencial e qual é apenas conveniente.
Melhores alternativas à API Venice: comparação rápida
| Classificação |
Alternativa |
Melhor para |
Modalidades |
Caminho compatível com OpenAI |
Principal trade-off |
| 1 |
GPT Proto |
Acesso multimodal acessível |
Texto, imagem, vídeo, áudio |
Sim |
Não alega privacidade TEE ou E2EE no estilo da Venice |
| 2 |
OpenRouter |
Roteamento de LLM e fallback entre provedores |
Principalmente texto e visão |
Sim |
Privacidade e disponibilidade variam conforme o provedor roteado |
| 3 |
Together AI |
Modelos de pesos abertos e fine-tuning |
Texto, imagem, vídeo, áudio |
Sim, em vários endpoints |
Menos útil para acesso amplo a modelos fechados |
| 4 |
Fireworks AI |
Inferência de modelos abertos em produção |
Principalmente texto e modelos abertos multimodais |
APIs no estilo OpenAI e Anthropic |
Mais focado em infraestrutura do que em catálogo |
| 5 |
fal |
Aplicações de imagem e vídeo |
Imagem, vídeo, áudio, 3D |
Não é uma API de chat substituta direta |
Esquemas específicos de modelo exigem código de fluxo de trabalho |
| 6 |
Replicate |
Experimentos com modelos da comunidade e personalizados |
Texto, imagem, vídeo, áudio |
Não |
Cold starts e integração específica de previsão |
| 7 |
vLLM |
Privacidade e controle auto-hospedados |
Principalmente modelos de linguagem e embedding |
Sim |
Você é responsável por GPUs, segurança, escalabilidade e operações |
1. GPT Proto — Melhor alternativa geral e acessível à API Venice
O GPT Proto é a opção mais próxima para desenvolvedores que usam a Venice como gateway único. Ele oferece mais de 200 modelos de texto, imagem, vídeo e áudio. Sua URL base compatível com OpenAI significa que muitas integrações de chat precisam apenas de uma nova chave, URL e identificador de modelo.
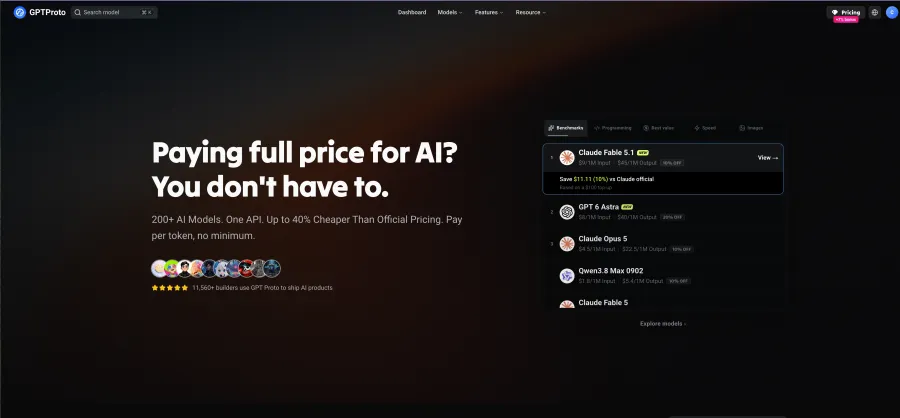
O catálogo inclui opções de imagem e vídeo de famílias chinesas de modelos, útil ao comparar qualidade visual e custo-benefício além dos fornecedores norte-americanos habituais.
O GPT Proto aplica desconto sobre o preço oficial dos modelos e usa cobrança pay-as-you-go sem mínimo. Um exemplo atual com GLM-5.3:
| Plataforma |
Entrada por 1M de tokens |
Saída por 1M de tokens |
| GPT Proto |
$1.26 |
$3.96 |
| Together AI |
$1.40 |
$4.40 |
| Venice API |
$1.75 |
$5.50 |
Com 100 milhões de tokens de entrada e 20 milhões de tokens de saída, essas tarifas implicam US$ 205,20 no GPT Proto, US$ 228 na Together AI e US$ 285 na Venice. Isso varia conforme o modelo; recalcule para o seu próprio mix.
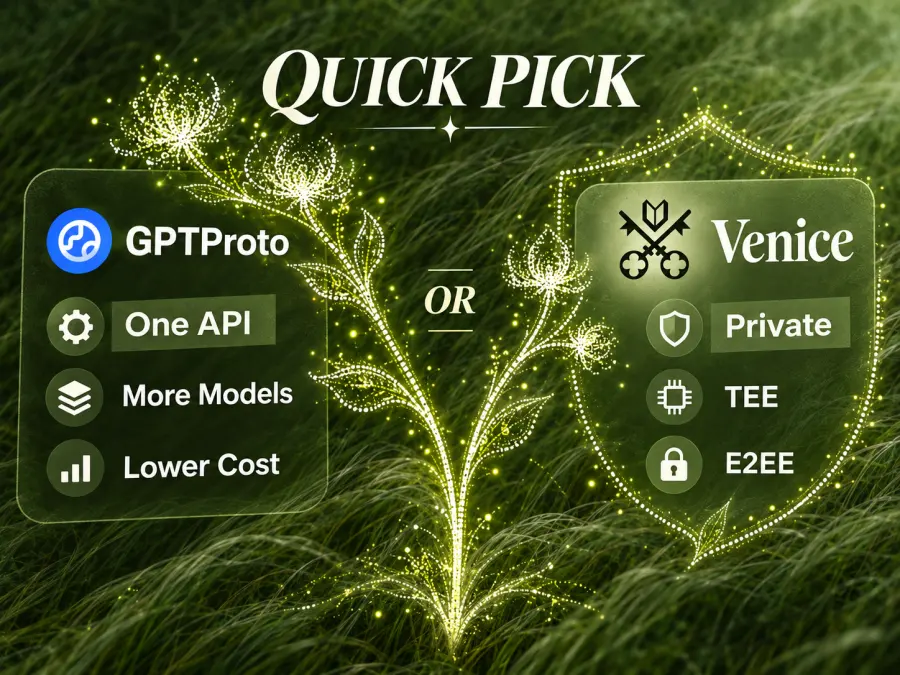
O GPT Proto não é uma substituição equivalente em privacidade. Ele não anuncia o design de quatro modos da Venice nem os caminhos TEE e E2EE somente texto. Se a separação criptográfica for necessária, um custo menor não é substituto.
Melhor para: Produtos SaaS, agentes de IA, ferramentas internas e aplicações multimodais que desejam ampla escolha de modelos e preços de uso previsíveis.
Por que está em primeiro lugar: Ele combina uma única chave, muitos modelos, requisições familiares e economia forte.
Explore o gateway de modelos do GPT Proto se custo e cobertura multimodal forem seus principais critérios de seleção.
2. OpenRouter — Melhor para roteamento de LLM e fallbacks
O OpenRouter é uma forte alternativa à API Venice quando seu principal problema é roteamento resiliente de modelos de linguagem. Ele pode rotear requisições entre vários provedores, aplicar fallbacks e permitir que equipes usem suas próprias chaves de provedor. Sua interface compatível com OpenAI o torna acessível para aplicações que já usam o SDK da OpenAI.
O roteamento também é a complicação. Privacidade, retenção, processamento regional e disponibilidade variam conforme o provedor. Equipes de produção devem fixar rotas permitidas e verificar a política de cada provedor.
Compras de crédito têm uma taxa de 5,5%, com mínimo de US$ 0,80, então o custo efetivo não é apenas a tarifa de inferência exibida.
É menos atraente para produtos de imagem ou vídeo porque é principalmente um marketplace de roteamento de modelos de linguagem.
Melhor para: Equipes que precisam de acesso a LLMs entre provedores, fallbacks automáticos e controles de roteamento.
Escolha-o em vez do GPT Proto quando: Seleção de provedor e lógica de failover importarem mais do que um catálogo amplo de mídia ou o menor custo efetivo de gateway.
3. Together AI — Melhor para modelos abertos e fine-tuning
A Together AI é adequada para equipes que constroem em torno de modelos de pesos abertos. Ela oferece mais de 100 modelos serverless e APIs para chat, visão, imagens, fala, embeddings e outras cargas de trabalho, com padrões no estilo OpenAI em vários endpoints.
Equipes podem fazer fine-tuning de modelos, treinar adaptadores LoRA e executá-los na mesma plataforma. A inferência em lote pode reduzir custos elegíveis em até 50% para avaliação offline, rotulagem, sumarização ou preenchimentos retroativos.
Ela não é um gateway neutro para todos os principais modelos fechados. Escolha sua profundidade de personalização quando planejar construir sobre famílias como Llama, Qwen ou DeepSeek.
Melhor para: Produtos com modelos abertos, programas de fine-tuning, pipelines de avaliação e inferência em lote.
Fique atento a: Diferenças no nível do endpoint. “Compatível com OpenAI” ainda não garante que cada campo, sequência de chamadas de ferramentas ou evento de streaming se comporte de forma idêntica.
4. Fireworks AI — Melhor para inferência de modelos abertos em produção
A Fireworks AI serve mais de 100 modelos abertos por meio de implantações serverless, dedicadas sob demanda e reservadas. Ela oferece suporte a chamadas de função, saídas estruturadas, fine-tuning e personalização LoRA.
Um protótipo pode começar com inferência serverless e depois migrar para capacidade dedicada para maior exigência de throughput ou latência. Interfaces compatíveis com OpenAI e Anthropic reduzem alterações no cliente para requisições comuns.
Ele não é o melhor catálogo de modelos fechados ou ferramentas de mídia para criadores. Seu valor está no desempenho de inferência e no controle de implantação.
Melhor para: Aplicações de produção que padronizam modelos abertos e planejam capacidade dedicada.
Escolha-o em vez da Together AI quando: Desempenho de serving e controles de implantação pesarem mais do que pesquisa ampla, treinamento ou experimentação multimodal.
5. fal — Melhor alternativa à API Venice para imagem e vídeo
A fal oferece mais de 1.000 modelos de imagem, vídeo, áudio e 3D. Ela oferece suporte a requisições síncronas, jobs enfileirados, webhooks e conexões em tempo real para gerações que podem levar segundos ou minutos.
A fal documenta até 10 tentativas automáticas de repetição para algumas falhas e geralmente cobra por saídas bem-sucedidas, não por erros de fila ou servidor.
Ela não é uma substituta direta do chat da Venice: os modelos têm seus próprios esquemas, e URLs de mídia geradas podem permanecer públicas até expirarem. Ativos confidenciais exigem um fluxo de armazenamento e exclusão deliberado.
Melhor para: Aplicações criativas, edição de imagem, geração de vídeo, ferramentas de áudio e pipelines de produção de mídia.
Escolha-a em vez do GPT Proto quando: Profundidade de modelos de mídia e orquestração de jobs importarem mais do que manter texto e mídia atrás de uma única API no estilo OpenAI.
6. Replicate — Melhor para modelos da comunidade e personalizados
O Replicate oferece mais de 100 modelos oficiais, além de modelos da comunidade, fine-tunes, modelos privados e implantações personalizadas. A cobrança por tempo de processamento ou específica do modelo permite que equipes testem modelos incomuns sem provisionar hardware.
Modelos públicos compartilhados podem fazer cold boot ou entrar em fila, e a integração gira em torno de previsões, não de um contrato de chat da OpenAI. Endpoints padrão de previsão permitem cerca de 600 requisições por minuto, e muitos outros endpoints cerca de 3.000, sujeitos às condições do modelo e da conta.
Ele funciona melhor como laboratório de modelos ou camada de execução personalizada, não como uma API de chat uniforme.
Melhor para: Testar modelos da comunidade, implantar modelos personalizados e lançar protótipos antes que os requisitos de infraestrutura se definam.
Fique atento a: Latência de cold start, esquemas por modelo, persistência de saída e a diferença entre hardware compartilhado e dedicado.
7. vLLM — Melhor alternativa auto-hospedada para controle máximo
O vLLM executa modelos compatíveis na infraestrutura que você controla. Ele expõe endpoints de chat, completions, responses e embeddings compatíveis com OpenAI, com streaming, saída estruturada e chamada de ferramentas quando houver suporte.
Ele pode manter prompts, pesos, logs e caminhos de rede dentro do seu ambiente, mas você precisa configurar isolamento, criptografia, logging, backups e retenção. Sua configuração --api-key não protege todos os endpoints, então implantações reforçadas precisam de um proxy reverso autenticado.
Não há markup de gateway, mas custos de GPU, engenharia, monitoramento, escalabilidade e plantão permanecem. Utilização alta e constante pode justificá-los; tráfego em picos muitas vezes não.
Melhor para: Implantações reguladas, redes privadas, cargas de trabalho sustentadas com modelos abertos e equipes com experiência em operações de GPU.
Não o escolha se: Você precisa de modelos fechados, amplitude imediata de catálogo ou um serviço gerenciado sem propriedade de infraestrutura.
Qual alternativa à API Venice você deve escolher?
Use a decisão que corresponde ao seu gargalo:
| Seu principal requisito |
Melhor escolha |
Por quê |
| Uma API acessível para muitas modalidades |
GPT Proto |
Catálogo amplo, acesso compatível com OpenAI e preços de modelos com desconto |
| Roteamento automático entre provedores de LLM |
OpenRouter |
Políticas de roteamento, fallbacks e suporte a traga sua própria chave |
| Fine-tuning de modelos abertos |
Together AI |
Fine-tuning, LoRA, jobs em lote e inferência serverless |
| Serving de modelos abertos em produção |
Fireworks AI |
Vários níveis de implantação e controles focados em inferência |
| Catálogo profundo de imagem e vídeo |
fal |
Catálogo amplo de mídia, além de filas, webhooks e tentativas |
| Testes de modelos da comunidade ou personalizados |
Replicate |
Camada flexível de previsão e amplo ecossistema de modelos públicos |
| Privacidade no nível da infraestrutura |
vLLM |
Caminho de dados auto-hospedado e controle operacional total |
| Modos Private, TEE ou E2EE específicos da Venice |
Fique com a Venice |
Nenhuma das alternativas gerenciadas duplica o design completo de privacidade |
A maioria das equipes não precisa reproduzir todos os recursos da Venice. Elas precisam de um gateway confiável, os modelos certos e uma fatura previsível. O GPT Proto é o melhor padrão; a classificação muda quando roteamento, fine-tuning, especialização em mídia ou privacidade criptográfica dominam.
Como migrar da API Venice para o GPT Proto
Para uma integração padrão de chat-completions, a primeira alteração de código é pequena:
| Configuração |
Venice API |
GPT Proto |
| Variável de ambiente da chave de API |
Sua chave da Venice |
GPTPROTO_API_KEY |
| URL base |
URL base da API Venice |
https://gptproto.com/v1 |
| Modelo |
Identificador de modelo da Venice |
Identificador de modelo do GPT Proto, como glm-5.3 |
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["GPTPROTO_API_KEY"],
    base_url="https://gptproto.com/v1",
)

response = client.chat.completions.create(
    model="glm-5.3",
    messages=[
        {
            "role": "user",
            "content": "Resuma os principais riscos neste plano de lançamento de produto.",
        }
    ],
)

print(response.choices[0].message.content)
A compatibilidade com OpenAI cobre o formato da requisição, não o comportamento idêntico. Antes de migrar tráfego de produção, teste:
Modo JSON e saída restrita por esquema
Definições de ferramentas, chamadas paralelas de ferramentas e resultados de ferramentas em vários turnos
Ordem de eventos de streaming e contabilização de uso
Objetos de erro, códigos de status repetíveis e comportamento de timeout
Limites de janela de contexto e comportamento de truncamento
Entradas e saídas de imagem, áudio ou vídeo usadas pela sua aplicação
Aliases de modelos, avisos de descontinuação e comportamento de fallback
Quaisquer parâmetros específicos da Venice, incluindo seu controle de prompt de sistema
Um relatório público de desenvolvedor mostrou o porquê: uma camada genérica de SDK compatível descartou metadados de raciocínio durante o uso de ferramentas Gemini em vários turnos, e a requisição seguinte falhou com um 400. Isso não era necessariamente um defeito da Venice; mostra como adaptadores podem perder estado específico do provedor.
Envie primeiro uma pequena porcentagem do tráfego, compare latência e validade da saída estruturada, e mantenha um interruptor de roteamento reversível até os erros se estabilizarem. A URL base é a parte fácil; a auditoria de comportamento é a migração.
Quando você deve ficar com a API Venice?
Fique com a Venice quando uma destas condições define o produto:
Você precisa de seus modos específicos de inferência Anonymous, Private, TEE ou E2EE.
Você quer acesso a mais de 350 modelos sob seu catálogo e políticas atuais.
Sua aplicação depende da seleção permissiva de modelos da Venice.
A franquia DIEM ou pagamentos em USDC via x402 se encaixam no seu modelo de cobrança.
Você já testou parâmetros específicos da Venice e não ganha o suficiente com a migração para justificar outro ciclo de compatibilidade.
Linguagem de não retenção não é o mesmo que criptografia ponta a ponta, e auto-hospedagem não é segura apenas porque o servidor está na sua conta. Compare modelos de ameaça, não rótulos.
Se você ficar, defina a preferência de prompt de sistema da Venice, monitore descontinuações e verifique quais modos de privacidade suportam suas ferramentas. E2EE não pode coexistir com recursos do lado do servidor que exigem texto não criptografado.
Veredito final
O GPT Proto é a principal alternativa à API Venice em 2026 para desenvolvedores que buscam acesso acessível a modelos de texto, imagem, vídeo e áudio por meio de uma API familiar. Ele oferece a substituição prática mais próxima para o papel de gateway da Venice, com preço mais baixo na comparação do GLM-5.3 e alterações mínimas de código para requisições de chat padrão.
O OpenRouter é melhor para roteamento entre provedores. Together AI e Fireworks AI são melhores para personalização de modelos abertos e inferência em produção. A fal lidera para fluxos de trabalho específicos de mídia, o Replicate para experimentação da comunidade, e o vLLM para controle auto-hospedado.
A Venice ainda vence quando sua arquitetura de privacidade é o fator decisivo. Nenhuma alternativa gerenciada neste ranking deve ser descrita como substituta completa dos modos Private, TEE e E2EE da Venice.
Escolha dois finalistas, reproduza um conjunto de testes representativo e compare custo total, latência p95, validade da saída e recuperação de falhas. Para a maioria das equipes sem um requisito de privacidade específico da Venice, GPT Proto é a primeira opção que eu testaria.