Обзор доступных LLM для программирования
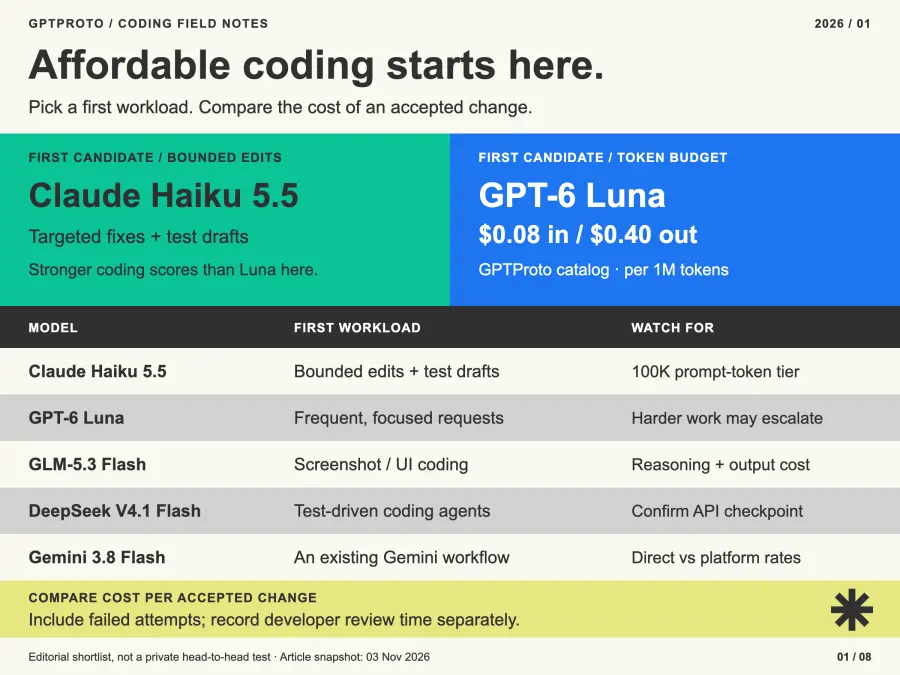
| Модель |
Первая задача для оценки |
Главный компромисс |
| Claude Haiku 5.5 |
Локальное редактирование кода, черновики тестов и подзадачи по программированию |
Низкий ценовой уровень заканчивается после 100 тыс. токенов промпта |
| GPT-6 Luna |
Частые, узкоспециализированные запросы по коду |
Для сложной работы с репозиторием может потребоваться более мощная модель |
| GLM-5.3 Flash |
Задачи по коду, включающие скриншоты или ссылки на UI |
Сложность рассуждений и длина вывода влияют на стоимость |
| DeepSeek V4.1 Flash |
Агенты для программирования с тестами и лимитами повторных попыток |
Уточните чекпоинт, предоставляемый через API-алиас |
| Gemini 3.8 Flash |
Программирование внутри существующего рабочего процесса Gemini |
Промо-тарифы провайдеров отличаются от цен на платформе |
Если вы выбираете поставщика, а не только модель, наше сравнение AI API платформ для разработчиков охватывает более широкие вопросы доступа, биллинга, интеграции и контроля производства.
Как мы сравниваем стоимость и возможности программирования
Доступная LLM для программирования должна обладать достаточными способностями для задачи, прежде чем цена за токен станет оправданной. Мы отдаем приоритет доказательствам эффективности в кодинге, затем проверяем стоимость рабочей нагрузки, уровни контекста, совместимость с инструментами и наличие страницы модели в GPT Proto.
Следующие результаты получены от Artificial Analysis. Terminal-Bench 4.0 оценивает агентское программирование и использование терминала; FrontierCode 2.0 оценивает разработку ПО в open-source репозиториях. Различные конфигурации могут изменить результаты, поэтому оцениваемые настройки указаны рядом с каждой моделью.
| Оцениваемая модель |
Terminal-Bench 4.0 |
FrontierCode 2.0 |
| Claude Haiku 5.5 Max |
33% |
35% |
| GPT-6 Luna Max |
13% |
25% |
| GLM-5.3 Flash (как указано) |
33% |
18% |
| DeepSeek V4.1 Flash 1017 Max |
34% |
28% |
| Gemini 3.8 Flash High |
20% |
19% |
В основе сравнений лежат Haiku против Luna, DeepSeek против GLM Flash и Haiku против Gemini. Эти проценты описывают результаты оценок, а не ожидаемый уровень успеха в вашем репозитории. Они также не определяют задержку или время безотказной работы GPT Proto.
Приведенные ниже оценки цен предполагают постоянное использование токенов для демонстрации принципов биллинга. Реальные модели могут использовать разное количество токенов для одного и того же промпта, особенно при включенном режиме рассуждений.
5 лучших доступных LLM для программирования
1. Claude Haiku 5.5 для ограниченных задач по программированию
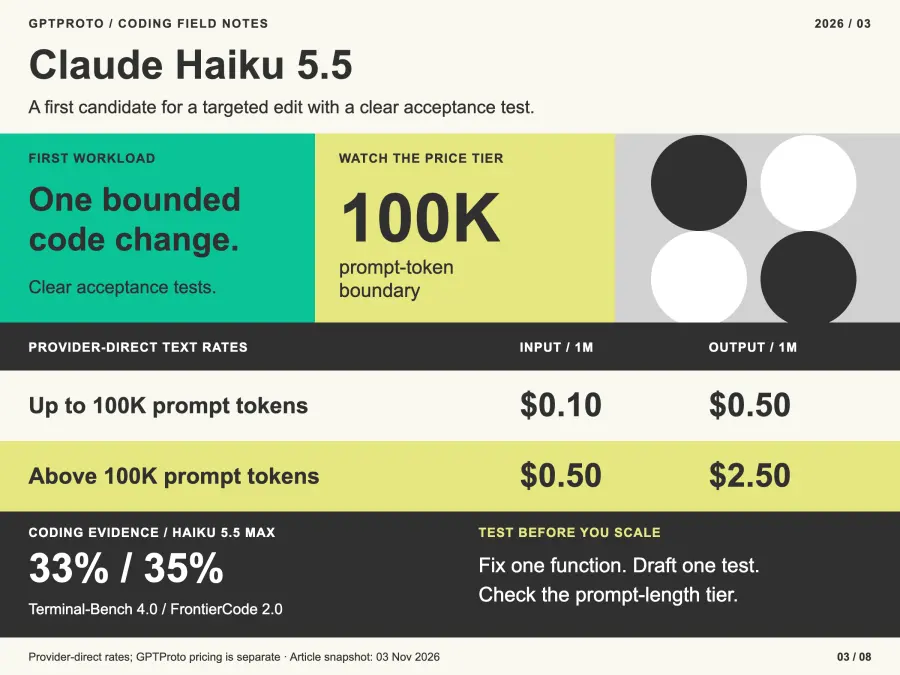
Claude Haiku 5.5 — наш первый кандидат для точечного редактирования кода с четким тестом на принятие и промптом менее 100 тыс. токенов. Его результаты в программировании делают его достойным тестирования перед оплатой более крупной модели Claude.
Анонс выпуска от Anthropic позиционирует Haiku как модель для повторяющейся работы и подзадач по программированию наряду с Sonnet и Opus. Это предполагает практическую область применения: исправить одну функцию, составить черновик теста или исследовать локализованную ошибку.
Важным ценовым порогом является длина промпта. Базовые тарифы на ввод/вывод возрастают с $0.10/$0.50 до $0.50/$2.50 за миллион токенов при превышении 100 тыс. токенов в промпте. Большое контекстное окно не означает, что самый дешевый тариф доступен во всем этом окне.
2. GPT-6 Luna для частых целевых запросов
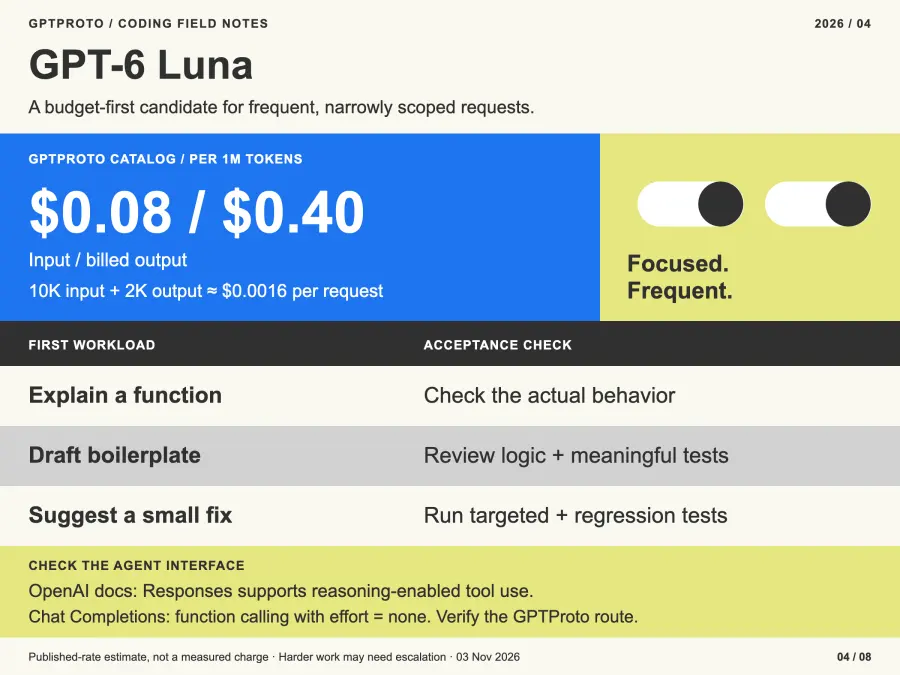
GPT-6 Luna — бюджетный кандидат для повторяющихся, ограниченных запросов: объяснить функцию, составить шаблонный код или предложить небольшое исправление, которое могут оценить существующие тесты.
Опубликованный тариф в каталоге GPT Proto составляет $0.08 за ввод и $0.40 за вывод на миллион токенов. Публичные оценки по программированию ниже, чем у Haiku, поэтому мы бы позволили Luna заслужить более широкую роль через оценку конкретных задач.
Проверяйте поверхность интеграции при создании агента. Документация модели OpenAI определяет использование инструментов с поддержкой рассуждений через Responses; Chat Completions разрешает вызов функций с параметром reasoning effort, установленным в значение none. Убедитесь, что именно предоставляет маршрут GPT Proto, прежде чем рассматривать переключение моделей как изменение только конфигурации.
3. GLM-5.3 Flash для бюджетного визуального программирования
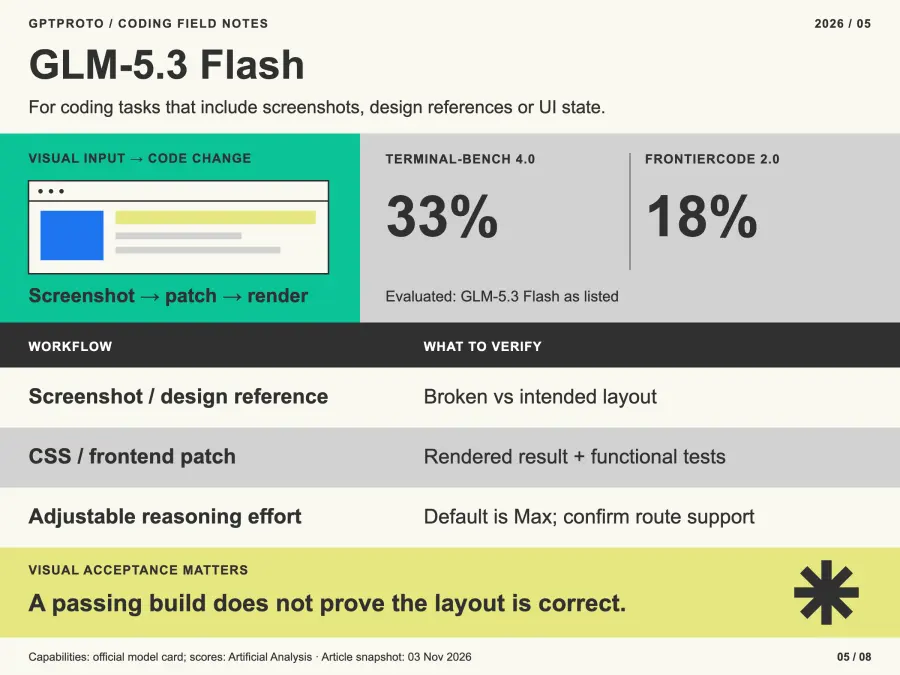
GLM-5.3 Flash входит в шорт-лист, когда задача по программированию включает скриншот, дизайн-референс или отрендеренный интерфейс. Например, фронтенд-ассистенту может потребоваться сравнить сломанную верстку с целевым состоянием перед предложением изменений в CSS.
В официальной карточке модели GLM-5.3 Flash задокументированы мультимодальный ввод, открытые веса и настраиваемое усилие рассуждения (reasoning effort). Опубликованное значение по умолчанию — максимальное. Используйте другую настройку только после проверки того, как хостинговый маршрут поддерживает её.
Его две оценки по программированию существенно различаются. Это повод протестировать ваш набор задач, а не рассматривать один терминальный бенчмарк как универсальный рейтинг редактирования кода. Визуальные исправления также требуют отрендеренного сравнения; одной компиляции недостаточно, чтобы установить, что верстка корректна.
4. DeepSeek V4.1 Flash для агентов, работающих по методологии TDD
DeepSeek Flash стоит рассмотреть для агентов, которые анализируют файлы, предлагают изменения, получают отчеты об ошибках в тестах и повторяют попытки в рамках заданного бюджета.
В анонсе релиза от 17 октября описаны улучшения производительности при написании кода, скорости выполнения задач и длины вывода. Независимые результаты в нашей таблице относятся именно к версии V4.1 Flash 1017 в режиме Max effort. Неверсионный псевдоним сам по себе не гарантирует, что ваша платформа использует именно этот чекпоинт; фиксируйте разрешенную версию, если она доступна.
Для более широкого обзора DeepSeek, GLM, Qwen и Kimi ознакомьтесь с нашим сравнением китайских LLM для программирования. Держите более мощные модели наготове на случай, если сложные изменения в репозитории исчерпают бюджетный лимит.
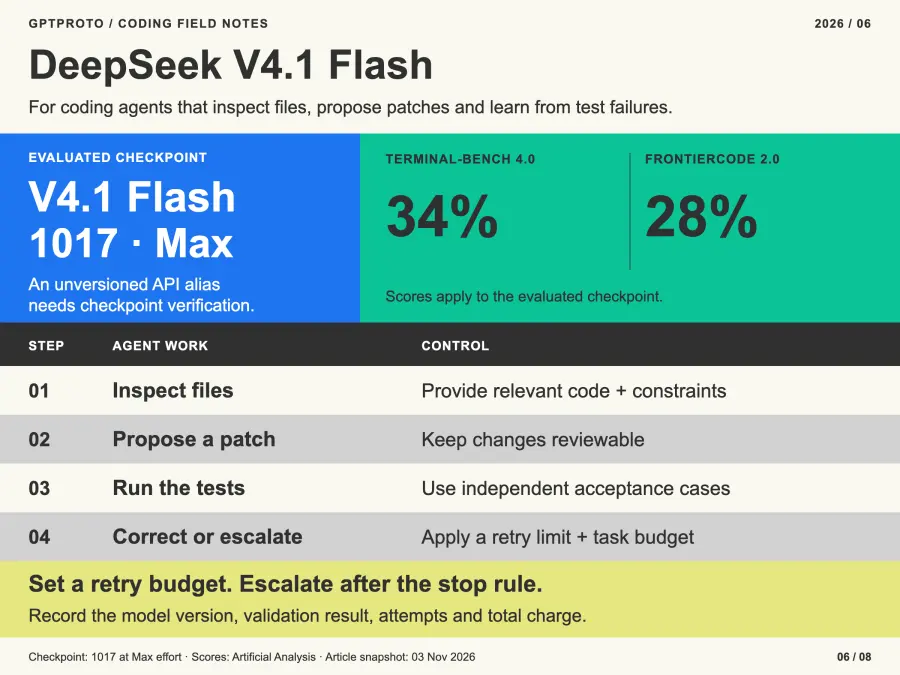
5. Gemini 3.8 Flash для существующих рабочих процессов Gemini
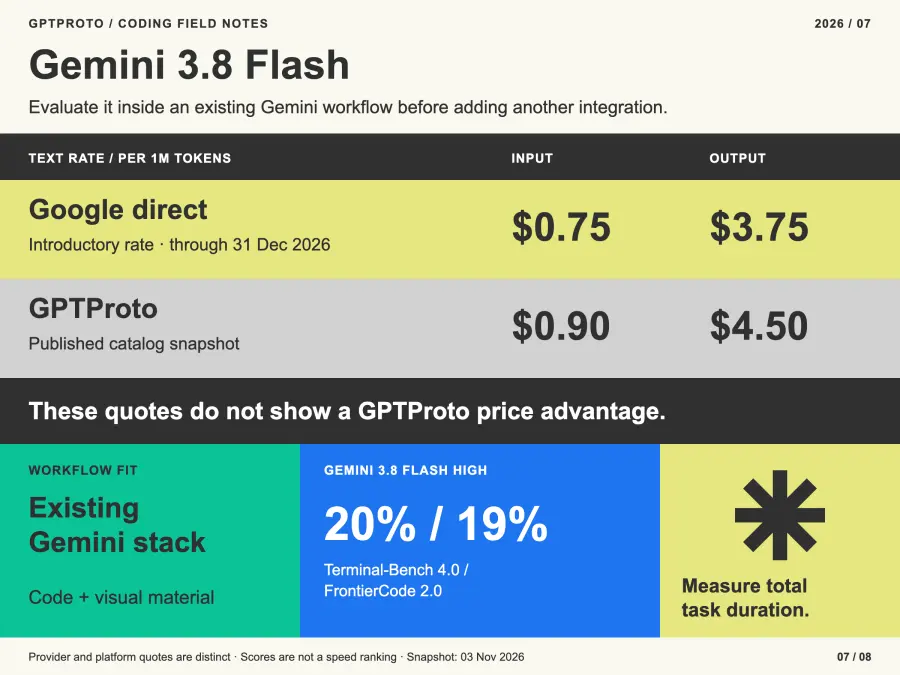
Gemini 3.8 Flash — подходящий кандидат, если ваше приложение уже использует Gemini или сочетает код с визуальными материалами. Оцените его в текущем рабочем процессе, прежде чем добавлять еще одну специфическую интеграцию от другого провайдера.
Обновление модели от Google документирует настраиваемое мышление и вводную прямую ставку провайдера в размере $0.75 за вход / $3.75 за выход на миллион токенов до 31 декабря 2026 года. Опубликованный снимок каталога GPT Proto составляет $0.90/$4.50. Эти цифры не подтверждают утверждение, что GPT Proto дешевле текущей акции Google.
Мы бы включили Gemini из-за соответствия рабочим процессам, а не из-за того, что в названии есть слово Flash. Измеряйте время до получения полезного ответа и общую продолжительность выполнения задачи на ваших промптах.
Сравнение цен на API нейросетей для программирования
В этой таблице используются публичные тарифы провайдеров при указанных условиях, а не биллинг GPT Proto. Использование прямых источников и конкретных рабочих нагрузок делает сравнение воспроизводимым.
Малый запрос содержит 10 тыс. входных и 2 тыс. оплачиваемых выходных токенов. Базовая нагрузка репозитория содержит 200 тыс. входных и 20 тыс. оплачиваемых выходных токенов. В обоих случаях предполагается отсутствие попаданий в кэш; оплачиваемый вывод должен включать токены рассуждения, где это применимо.
| Модель и условия ценообразования |
Вход / выход за 1 млн токенов |
Малый запрос |
Базовая нагрузка репозитория |
| Haiku 5.5 при промпте до 100 тыс. токенов |
$0.10 / $0.50 |
$0.0020 |
Используйте следующий уровень |
| Haiku 5.5 при промпте более 100 тыс. токенов |
$0.50 / $2.50 |
Не применимо |
$0.1500 |
| GPT-6 Luna в рамках базового уровня контекста |
$0.10 / $0.50 |
$0.0020 |
$0.0300 |
| GLM-5.3 Flash по опубликованному стандартному тарифу |
$0.15 / $0.50 |
$0.0025 |
$0.0400 |
| DeepSeek Flash по пиковому тарифу провайдера |
$0.30 / $1.20 |
$0.0054 |
$0.0840 |
| Gemini 3.8 Flash по начальному прямому тарифу |
$0.75 / $3.75 |
$0.0150 |
$0.2250 |
Данные о тарифах взяты из документации к моделям и независимых сравнений выше. Примечания к выпуску DeepSeek подтверждают, что тарифы в непиковые часы вдвое ниже стандартных. Luna применяет более высокие тарифы к полному запросу при превышении 272 тыс. входных токенов. Вводные тарифы Gemini заканчиваются в 2026 году. Проверяйте актуальный маршрут и дату перед планированием бюджета.
Для доступа через GPT Proto используйте панель цен в реальном времени на страницах соответствующих моделей. Два наглядных примера из каталога: Luna по $0.08/$0.40 и Haiku по $0.09/$0.45 на бюджетном уровне. Тот же малый запрос оценивается в $0.0016 и $0.0018 соответственно. Это расчеты по опубликованным тарифам, а не фактические списания.
Для небольшого приложения, выполняющего 10 000 малых запросов в месяц, пример с Luna или Haiku на бюджетном уровне составит $20 до учета повторных попыток и других сборов. Эта оценка перестает быть полезной, если приложение отправляет другой объем контекста или генерирует гораздо более длинные ответы.
Кэширование требует отдельного расчета: добавьте некэшированный ввод, чтение из кэша, любые записи в кэш или хранилище и оплачиваемый вывод. Стабильный префикс репозитория может помочь, но изменение промпта или промах мимо кэша меняют экономию.
Тест разработчика Саймона Уиллисона с Haiku 5.5 дает конкретный пример того, как разные настройки усилий меняют время и стоимость. В нем также обсуждаются изменения токенизатора. Урок для планирования бюджета: измеряйте фактическое использование, а не предполагайте, что каждая нейросеть считает одинаковое количество токенов для идентичного текста.
Какая модель подходит для вашей задачи по программированию
| Задача |
Рекомендуемые кандидаты |
Проверка принятия |
| Локальное изменение кода или исправление ошибки |
Haiku 5.5 и Luna |
Целевые тесты плюс существующие регрессионные тесты |
| Написание модульных тестов или шаблонного кода |
Luna и Haiku 5.5 |
Проверка утверждений и верификация значимых случаев сбоев |
| Исправление визуального интерфейса |
GLM-5.3 Flash и Gemini 3.8 Flash |
Сравнение рендеринга плюс функциональные тесты |
| Многошаговый агент для программирования |
DeepSeek Flash и Haiku 5.5 |
Завершенная задача, корректные вызовы инструментов, количество повторных попыток и общая стоимость |
Это отправные точки для оценки. Сгенерированный тест, который просто повторяет ошибочное предположение модели, может пройти проверку, в то время как функция останется неисправной. Сохраняйте независимые сценарии принятия и проверяйте изменения в самих тестах.
Для агентов, которые также ищут документы, классифицируют запросы или выполняют задачи поддержки, наше руководство по доступным LLM API для ИИ-агентов охватывает более широкий спектр рабочих нагрузок.
Когда стоит использовать премиальную модель для программирования
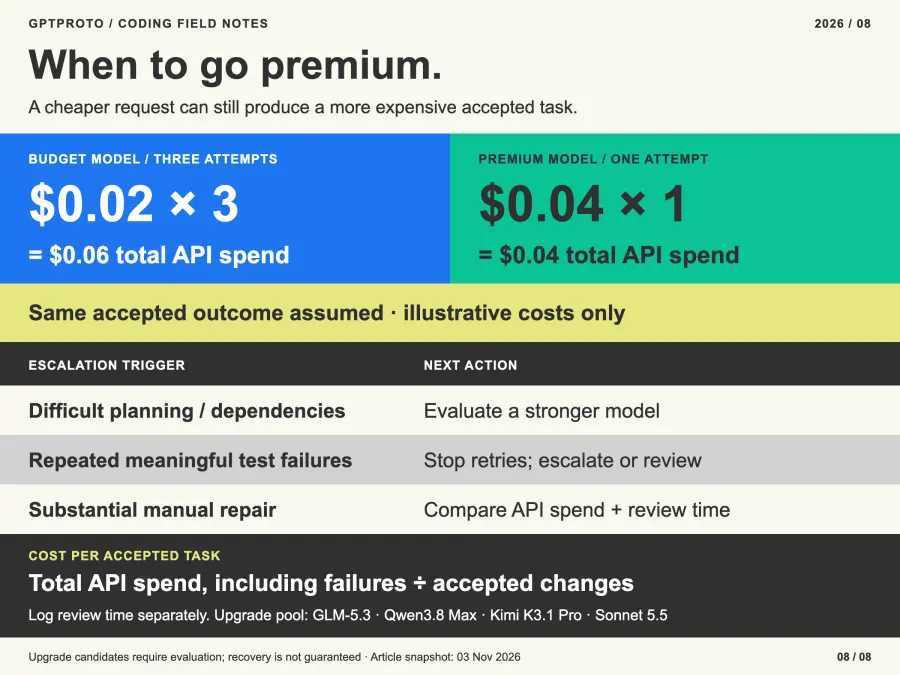
Переходите на более мощные модели, если задача требует сложного планирования, неоднократно проваливает значимые тесты или требует существенной ручной доработки. GLM-5.3, Qwen3.8 Max, Kimi K3.1 Pro и Claude Sonnet 5.5 могут сформировать отдельный пул для такой работы. Их включение сюда — это путь к обновлению, который стоит изучить, а не утверждение, что они всегда исправляют задачи, с которыми не справились бюджетные модели.
Используйте показатель стоимости одной принятой задачи: общие расходы на API за время оценки, деленные на количество принятых изменений. Включайте расходы на неудачные попытки. Учитывайте время на проверку отдельно, чтобы низкий счет за API не скрывал дорогостоящую ручную работу разработчика.
Для наглядного сравнения: три попытки по $0.02 стоят $0.06. Одна попытка за $0.04, которая сразу завершает ту же задачу, в итоге обходится дешевле. Ваши измеренные показатели успеха решают, оправдан ли этот компромисс.
Как использовать бюджетные модели без бесконечных повторных попыток
Установите правила проверки принятия и остановки перед первым запросом. Практичная политика — это одна начальная попытка, одна корректировка на основе сбоя теста, а затем эскалация или проверка человеком. Корректируйте эту политику, основываясь на наблюдаемых результатах и бюджете задачи.
Приложение должно записывать модель и контрольную точку, настройки рассуждения, использование токенов, затраченное время, результат проверки и общую стоимость. Модель предлагает патч; ваш раннер выполняет тесты; ваша логика маршрутизации решает, что делать дальше.
API с поддержкой нескольких моделей упрощает доступ и биллинг. Прохождение тестов, маршрутизация с учетом бюджета и автоматическая эскалация по-прежнему требуют проверенных функций платформы или логики приложения. Наше руководство по ИИ-шлюзам для разработчиков сравнивает различные уровни доступа и контроля.
Попробуйте доступную модель для кодинга через GPT Proto
Откройте страницу выбранной модели, выберите Попробовать эту модель, ознакомьтесь с кратким руководством и тарифами. Подготовьте API-ключ и баланс. Если на панели доступна опция Скопировать Markdown для ИИ, передайте это руководство вашему ИИ-ассистенту вместе с задачей и критериями приемки. Храните реальный ключ в локальной среде или защищенном хранилище сервера.
Для первого воспроизводимого упражнения исправьте эту функцию пагинации: страницы начинаются с единицы, page и per_page — целые числа, значения меньше единицы должны вызывать ValueError, а исходный список должен оставаться неизменным.
Сохраните следующий код как request_patch.py в новой рабочей папке. Он использует стандартную библиотеку Python, запрашивает функцию-кандидат, проверяет её синтаксис и сохраняет для проверки. Он не выполняет полученный код.
import ast
import json
import os
import time
from pathlib import Path
from urllib.error import HTTPError, URLError
from urllib.request import Request, urlopen

key = os.environ.get("GPTPROTO_API_KEY")
if not key:
    raise SystemExit("Установите GPTPROTO_API_KEY в вашей среде.")

source = """def paginate(items, page, per_page):
    start = page * per_page
    return items[start:start + per_page]
"""
task = (
    "Исправь paginate. Страницы начинаются с 1. page и per_page — "
    "целые числа; вызови ValueError, если любое из них меньше 1. Возвращай "
    "пустой список после последней страницы. Не изменяй items. Сохрани "
    "сигнатуру. Возвращай только функцию, без Markdown "
    "или пояснений.\n\n" + source
)
payload = {
    "model": os.environ.get("GPTPROTO_MODEL", "gpt-6-luna"),
    "messages": [{"role": "user", "content": task}],
}
request = Request(
    "https://gptproto.com/v1/chat/completions",
    data=json.dumps(payload).encode("utf-8"),
    headers={
        "Authorization": f"Bearer {key}",
        "Content-Type": "application/json",
    },
    method="POST",
)
started = time.perf_counter()
try:
    with urlopen(request, timeout=60) as response:
        result = json.load(response)
except HTTPError as exc:
    raise SystemExit(f"API вернул HTTP {exc.code}.") from exc
except (URLError, TimeoutError) as exc:
    raise SystemExit("Запрос не удался или истекло время ожидания.") from exc

try:
    code = result["choices"][0]["message"]["content"]
except (KeyError, IndexError, TypeError) as exc:
    raise SystemExit("В ответе API нет текста кандидата.") from exc
if not isinstance(code, str) or not code.strip():
    raise SystemExit("Ответ не содержал кода на Python.")
code = code.strip()
try:
    ast.parse(code)
except SyntaxError as exc:
    raise SystemExit("Проверьте ответ; это не чистый Python.") from exc

Path("candidate.py").write_text(code + "\n", encoding="utf-8")
print("candidate.py сохранен. Проверьте его перед запуском тестов.")
print("Секунд:", round(time.perf_counter() - started, 2))
print("Использование:", json.dumps(result.get("usage", {})))
Сохраните эти проверки приемки как test_candidate.py:
import unittest
from candidate import paginate


class PaginationTests(unittest.TestCase):
    def test_pages(self):
        items = [0, 1, 2, 3, 4]
        self.assertEqual(paginate(items, 1, 2), [0, 1])
        self.assertEqual(paginate(items, 2, 2), [2, 3])
        self.assertEqual(paginate(items, 3, 2), [4])
        self.assertEqual(paginate(items, 4, 2), [])
        self.assertEqual(items, [0, 1, 2, 3, 4])

    def test_empty_input(self):
        self.assertEqual(paginate([], 1, 2), [])

    def test_invalid_values(self):
        for page, per_page in [(0, 2), (-1, 2), (1, 0), (1, -1)]:
            with self.subTest(page=page, per_page=per_page):
                with self.assertRaises(ValueError):
                    paginate([0, 1], page, per_page)


if __name__ == "__main__":
    unittest.main()
После настройки ключа окружения запустите python request_patch.py. Проверьте candidate.py, а затем выполните python -m unittest -v test_candidate.py. Проверка синтаксиса лишь подтверждает, что Python может обработать вывод; тесты оценивают заявленное поведение. Это небольшое упражнение не является бенчмарком уровня репозитория.
Повторите процесс с другим задокументированным ID модели через GPTPROTO_MODEL. Регистрируйте как сбои, так и успешные результаты, а также используйте данные об использовании вместе с соответствующим тарифом для сравнения расходов. Тайм-аут или неудачная попытка также должны быть включены в отчет об оценке.
Выберите одну узкую задачу, сохраните фиксированными критерии приемки и сравните двух кандидатов. Откройте страницу API Claude Haiku 5.5 или страницу API GPT-6 Luna, чтобы ознакомиться с текущими ценами и начать свой первый запрос на написание кода.