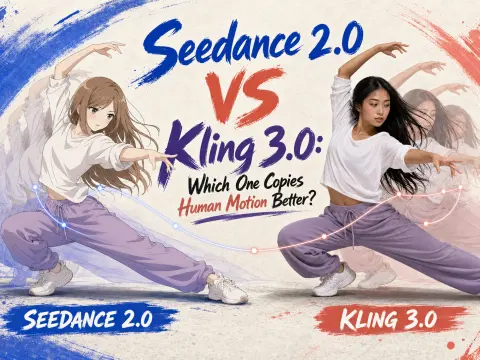
Primeiro, vamos esclarecer o que significa "copiar movimento"
A maioria das comparações mistura duas capacidades que parecem semelhantes, mas se comportam de maneiras completamente diferentes.
A primeira é a síntese de movimento: você descreve uma ação em palavras e o modelo inventa a física — ângulos das articulações, transferência de peso, continuidade do movimento. É aqui que o vídeo gerado por IA historicamente desmorona. Ações humanas rápidas são a coisa mais difícil de falsificar, porque seu olhar é treinado para reconhecê-las. Um cotovelo ligeiramente errado parece "errado" instantaneamente, até mesmo para não especialistas. Quando as pessoas dizem que um clipe parece "IA", um movimento humano quebrado geralmente é o motivo.
A segunda é a transferência de movimento: você fornece ao modelo uma referência — uma imagem, um clipe, às vezes uma voz — e pede que ele leve esse movimento ou identidade exatos para uma nova geração. Aqui, o modelo não está inventando o movimento; está copiando-o e redirecionando-o. Problema diferente, arquitetura diferente, vencedor diferente.
Mantenha essas duas capacidades separadas e toda a comparação deixa de ser confusa. O Kling 3.0 foi desenvolvido para ser forte na primeira. O Seedance 2.0 foi desenvolvido para ser forte na segunda. Todo o restante abaixo decorre disso.
Especificações lado a lado
Os dois modelos foram lançados com poucos dias de diferença no início de 2026 e ambos são realmente capazes, então a ficha técnica é mais parecida do que o marketing sugere.
| |
Kling 3.0 |
Seedance 2.0 |
| Laboratório |
Kuaishou |
ByteDance (Dreamina / Doubao / CapCut) |
| Lançamento |
5 de fev. de 2026 (Kuaishou) |
Fev. de 2026; lançamento no CapCut em 26 de mar. (TechCrunch) |
| Resolução máxima |
4K nativo, 3840×2160 (Kuaishou) |
1080p no lançamento, 4K adicionado posteriormente (BytePlus) |
| Taxa de quadros |
Até 60 fps (Kuaishou) |
Não especificada oficialmente |
| Duração máxima |
15 s (Kuaishou) |
15 s, seis proporções de tela (TechCrunch) |
| Múltiplas tomadas |
Até 6 tomadas em um clipe, no estilo de um diretor (Kuaishou) |
Construção de sequência por meio de várias entradas de referência |
| Áudio nativo |
Música, efeitos sonoros e sincronização labial em 5 idiomas (Kuaishou) |
Diálogos, efeitos sonoros e música nativos (BytePlus) |
| Entradas de referência |
Texto / imagem / vídeo / áudio (arquitetura MVL) |
Imagens + clipes de vídeo + áudio combinados em uma única etapa (BytePlus) |
| Disponibilidade nos EUA |
Disponível |
Indisponível nos EUA no lançamento (revisão de direitos autorais) (TechCrunch) |
Uma observação sobre a linha da resolução, antes que alguém dê importância excessiva a ela: o 4K nativo a 60 fps do Kling é o número mais alto no papel, e a Kuaishou deixa claro que ele é renderizado, não ampliado. Mas quase ninguém que gera clipes curtos para redes sociais ou anúncios precisa de 4K/60 — você está pagando tempo e dinheiro de renderização por pixels que serão destruídos pela própria compressão da plataforma. Considere o 4K um recurso desejável para o raro trabalho de transmissão ou tela grande, não o fator que decide essa disputa.
Rodada 1: gerar movimento humano a partir de um prompt — Kling 3.0
Este é o território do Kling, e é por isso que a questão do movimento humano merece ser feita.
A Kuaishou reconstruiu o Kling 3.0 com base no que chama de arquitetura Visual Language multimodal (MVL), processando texto, imagem, áudio e vídeo em um único sistema em vez de unir ferramentas separadas. A afirmação que me interessa — e esta é uma afirmação do fornecedor, portanto avalie-a de acordo — é que o modelo mantém a anatomia humana consistente durante ações rápidas e complexas. O tema recorrente em avaliações independentes feitas na prática confirma isso: ações complexas como dançar, correr e artes marciais apresentam muito menos falhas de membros que se transformam e dedos extras, problemas que afetam exatamente este cenário.
Minha leitura, tratando o consenso dos avaliadores como uma indicação, não como verdade absoluta: se o seu prompt for "uma dançarina faz um giro completo e aterrissa", o Kling é a aposta mais segura para obter uma tomada limpa nas primeiras tentativas. Ele também segue as instruções de perto — movimentos de câmera, iluminação e texto na tela —, então o que você gera precisa de menos ajustes antes de ser utilizável.
O preço desse controle? O Kling é mais literal. Dê a ele um prompt vago e ambicioso, do tipo "surpreenda-me", com uma cena caótica, e ele tende a ficar mais próximo da instrução literal do que da atmosfera que você pretendia alcançar. Ele recompensa prompts escritos como um diretor e pune prompts vagos com resultados sem personalidade.
Rodada 2: copiar movimento a partir de uma referência — Seedance 2.0
Agora mude o trabalho. Você não está descrevendo o movimento em palavras; tem um clipe com exatamente o movimento desejado e precisa transferi-lo.
O recurso definidor do Seedance 2.0 é a fusão multimodal de referências. A própria ByteDance explica que você combina imagens, vídeos e áudios como referências em uma única geração, além de contar com edição no local e extensão de vídeo. A cobertura da TechCrunch acrescenta a parte concreta: é possível conduzir uma geração a partir de um vídeo de referência, não apenas de uma imagem estática, e o modelo renderiza textura, movimento e iluminação realistas a partir dele. Em termos simples — se o briefing é "reproduza esta performance", esta é a ferramenta realmente projetada para isso. O Kling pode animar a partir de uma imagem, mas não oferece a mesma profundidade de "bloqueie esta referência e respeite-a". No GPT Proto especificamente, o modo de geração orientado por referência é documentado como um recurso exclusivo do Seedance — o Kling oferece modos orientados por prompt, não o mesmo caminho de fusão de referências.
Esse design orientado por referências também explica por que o Seedance lidera o placar independente. A arena de vídeo da Artificial Analysis, que classifica os modelos por votos humanos às cegas usando prompts idênticos, coloca o Dreamina Seedance 2.0 em primeiro lugar em texto para vídeo com áudio (Elo em torno de 1.219) e em primeiro lugar em imagem para vídeo (em torno de 1.344) em meados de 2026 — à frente do Kling 3.0 Pro, que fica em torno de 1.105 no ranking de texto para vídeo com áudio. Portanto, em qualidade de saída preferida, o Seedance está mensuravelmente à frente.
Duas ressalvas honestas, porque essa classificação não conta toda a história. Primeiro, desligue o áudio e o ranking muda bastante — o Seedance cai para cerca do quarto lugar e o Kling para o quinto, atrás de outros modelos, o que indica que parte da liderança do Seedance vem da preferência das pessoas pelo som integrado, não apenas pelos visuais. Segundo, e este é o ponto mais importante para quem desenvolve APIs: o Seedance não estava disponível nos EUA no lançamento. A ByteDance suspendeu a distribuição mais ampla devido a disputas de direitos autorais com estúdios de Hollywood e incorporou proteções — ele não gera a partir de rostos reais e inclui uma marca-d'água invisível. Se o seu produto atende usuários dos EUA diretamente na web aberta, essa diferença de disponibilidade é uma restrição real de planejamento, não uma nota de rodapé.
Rodada 3: emoção e microexpressão
A variação dessa pergunta que mais recebo é, na verdade, sobre rostos — ele consegue criar um sorriso convincente que chega aos olhos, um lampejo de dúvida, uma risada genuína? Aqui preciso ser direto sobre as evidências: nenhum dos laboratórios publica um benchmark de "emoção facial", e a Artificial Analysis mede a preferência geral, não especificamente a microexpressão. Portanto, esta seção é uma avaliação, sinalizada como tal.
O que posso dizer é fundamentado. A vantagem do Seedance nos testes de preferência às cegas aparece principalmente em pequenos comportamentos humanos convincentes — o tipo de realismo sutil e em close que sustenta cenas emocionais. A força do Kling está no extremo oposto: ações físicas, amplas e com o corpo inteiro permanecem coerentes. Para um close fechado em que toda a cena depende de uma expressão, eu começaria testando o Seedance. Para um momento emocional transmitido pela linguagem corporal do outro lado de uma sala, a coerência de movimento do Kling tende a vendê-lo melhor. Se a performance facial for decisiva para o seu caso de uso, não confie em nenhum dos dois — gere a mesma cena em ambos e julgue com os seus próprios olhos. As APIs tornam isso barato, que é exatamente o objetivo da próxima seção.
Teste os dois você mesmo: o código
Os dois modelos ficam atrás de um único endpoint no GPT Proto, o que significa que você pode fazer um teste A/B com o mesmo briefing exato sem gerenciar dois fornecedores, duas chaves ou duas contas de cobrança. A geração de vídeo é assíncrona: você faz um POST de uma solicitação, recebe um id de volta e depois consulta o resultado.
Veja o Kling 3.0 gerando movimento humano a partir de um prompt de texto — seu ponto forte:
import requests, time

BASE = "https://gptproto.com/api/v3"
HEADERS = {"Authorization": "GPTPROTO_API_KEY", "Content-Type": "application/json"}

def generate(path, payload):
    r = requests.post(f"{BASE}/{path}", headers=HEADERS, json=payload)
    r.raise_for_status()
    job = r.json()["data"]
    get_url = job["urls"]["get"]  # e.g. https://gptproto.com/api/v3/predictions/{id}/result

    # poll until the job leaves the queued/running state
    while True:
        res = requests.get(get_url, headers=HEADERS).json()["data"]
        status = res["status"]
        if status in ("succeeded", "failed", "expired"):
            return res
        time.sleep(5)

kling = generate(
    "kling/kling-v3.0-std/text-to-video",
    {
        "prompt": "A martial artist performs a fast spinning kick, "
                  "full body in frame, weight shifting naturally on landing.",
        "aspect_ratio": "16:9",
        "duration": 5,
        "resolution": "1080p",
        "generate_audio": True,
        "seed": -1,
    },
)
print(kling["status"], kling.get("outputs"))
E aqui está o Seedance 2.0 em seu modo de referência para vídeo, copiando o movimento de um clipe de referência para um novo personagem — exatamente o trabalho que ele domina. O mesmo auxiliar, com caminho e payload diferentes:
# reference-to-video: `videos` carries the motion to copy, `images` the character
seedance = generate(
    "bytedance/dreamina-seedance-2-0-260128/reference-to-video",
    {
        "prompt": "The character performs the exact routine from the reference video, "
                  "matching timing and body movement, new studio background.",
        "videos": ["https://your-cdn.com/motion-reference.mp4"],  # motion to replicate
        "images": ["https://your-cdn.com/character.png"],          # up to 10 references
        "aspect_ratio": "9:16",
        "duration": 5,
        "resolution": "1080p",
        "generate_audio": True,
        "seed": -1,
    },
)
print(seedance["status"], seedance.get("outputs"))
Se preferir cURL para um teste rápido:
curl --location 'https://gptproto.com/api/v3/kling/kling-v3.0-std/text-to-video' \
  --header 'Authorization: GPTPROTO_API_KEY' \
  --header 'Content-Type: application/json' \
  --data '{
    "prompt": "A dancer completes a full spin and lands cleanly.",
    "aspect_ratio": "16:9",
    "duration": 5,
    "resolution": "1080p"
  }'
Substitua GPTPROTO_API_KEY pela sua chave real. O modo de referência para vídeo do Seedance aceita arrays — videos, images (até 10) e audios — para que você possa fixar um clipe de movimento, um personagem e uma voz em uma única chamada; de acordo com a documentação do GPT Proto, esse modo de referência é exclusivo do Seedance aqui, que é a razão prática pela qual ele domina a cópia de movimentos. O Kling cobre o lado da geração a partir de prompts por meio dos modos padrão e de controle de movimento. O suporte a parâmetros varia conforme o modelo, portanto confira os campos exatos na página de cada modelo antes de executar em produção. A questão é que o formato do endpoint, a autenticação e o loop de consulta são idênticos, então testar o mesmo briefing nos dois exige apenas uma pequena alteração.
Então, qual você deve escolher?
- Você está gerando ações humanas a partir de texto — dança, esportes, coreografias de luta, qualquer coisa rápida e de corpo inteiro: Kling 3.0. Escreva o prompt como um diretor e ele recompensará você.
- Você precisa copiar uma performance específica de um clipe de referência para um novo personagem ou cena: Seedance 2.0. A fusão de referências é aquilo para o qual ele foi desenvolvido, e a arena de votos às cegas concorda quanto à qualidade da saída.
- Sua cena depende de uma expressão facial em close: comece com o Seedance 2.0, mas gere nos dois e avalie você mesmo — este é o único eixo que eu não decidiria com base em uma ficha técnica.
- Você precisa de 4K/60 para transmissão ou tela grande: o Kling 3.0 é o único que oferece 4K nativo a 60 fps atualmente.
- Você publica para usuários dos EUA na web aberta e precisa de disponibilidade garantida: leve em conta que o Seedance sofreu restrições no lançamento por motivos de direitos autorais — acessá-lo por meio de uma plataforma de API é o caminho prático, e vale confirmar isso para o seu caso específico.
Ambos estão disponíveis agora por meio de uma única conta: Kling 3.0 e Seedance 2.0. Consulte a linha completa de modelos de vídeo se quiser compará-los também com Veo ou Hailuo, e a página de preços apresenta os custos atuais por geração.