GLM-5.2 vs Kimi K3 em resumo
| Categoria |
GLM-5.2 |
Kimi K3 |
Vencedor prático |
| Arquitetura |
MoE com 753 bilhões de parâmetros, cerca de 40 bilhões ativos por token |
MoE com 2,8 trilhões de parâmetros, 16 de 896 especialistas ativados |
Kimi K3 em escala; o tamanho, por si só, não prova qualidade |
| Janela de contexto |
1 milhão de tokens |
1 milhão de tokens |
Empate |
| Saída máxima |
128 mil tokens |
Até 1 milhão de tokens quando configurado explicitamente |
Kimi K3 |
| Entrada |
Texto |
Texto, imagens e vídeos |
Kimi K3 |
| Controle de raciocínio |
Vários modos; High e Max no GPT Proto |
Raciocínio sempre ativado, com esforço baixo, alto e máximo; máximo por padrão |
Depende do endpoint e da tarefa |
| Recursos para desenvolvedores |
Chamadas de função, JSON, cache, MCP |
Chamadas de função, JSON, cache, carregamento dinâmico de ferramentas, visão |
Kimi K3 para agentes multimodais; caso contrário, próximos |
| Pesos abertos |
Disponível agora sob a licença MIT |
Disponível sob a Licença personalizada do Kimi K3 |
GLM para licenciamento permissivo e menor consumo de recursos; Kimi para um teto de capacidade mais alto |
| Preço oficial da API por 1 milhão de tokens |
$1,40 de entrada, $0,26 de entrada em cache, $4,40 de saída |
$3 de entrada, $0,30 de entrada em cache, $15 de saída |
GLM-5.2 |
| Melhor para |
Revisão rotineira de código, refatoração de repositórios, automação em alto volume, hospedagem própria |
Tarefas agentic difíceis, depuração visual, frontend, desenvolvimento 3D e de jogos |
Depende da tarefa |
| Infraestrutura para hospedagem própria |
753 bilhões no total / cerca de 40 bilhões ativos |
2,8 trilhões no total / 104 bilhões ativos; cerca de 1,56 TB; recomenda-se usar mais de 64 aceleradores |
GLM-5.2 para a maioria das implantações privadas |
As especificações vêm da documentação e do model card do GLM-5.2, além do model card, da licença e do relatório técnico do Kimi K3 lançado. Ambos os modelos agora publicam seus pesos. A diferença prática já não é entre aberto e fechado; é entre MIT e uma licença personalizada, e entre um modelo de 753 bilhões e um modelo de 2,8 trilhões com uma infraestrutura de implantação muito maior.
Os benchmarks de programação favorecem o Kimi K3, mas leia as notas de rodapé
A comparação publicada pela Moonshot dá ao Kimi K3 uma liderança clara nos benchmarks de programação mais relevantes para agentes:
| Benchmark |
Kimi K3 |
GLM-5.2 |
Diferença |
| DeepSWE |
67.5 |
46.2 |
+21.3 K3 |
| Terminal-Bench 2.1 |
88.3 |
82.7 |
+5.6 K3 |
| Program Bench |
77.8 |
63.7 |
+14.1 K3 |
| FrontierSWE |
81.2 |
67.3 |
+13.9 K3 |
| SWE-Marathon |
42.0 |
13.0 |
+29.0 K3 |
| Kimi Code Bench 2.0 |
72.9 |
64.2 |
+8.7 K3 |
Esses números foram publicados pelo fornecedor, não por um laboratório independente em um confronto controlado. As notas do benchmark da própria Moonshot dizem que os modelos às vezes foram executados em frameworks de agentes diferentes, incluindo Kimi Code, Claude Code e Codex. As pontuações do FrontierSWE também foram recalculadas a partir dos resultados brutos. Isso não torna os resultados inúteis, mas significa que uma diferença de 10 pontos não pode ser atribuída apenas ao modelo-base.
As evidências independentes apontam na mesma direção, com uma conclusão menor e mais plausível. A Artificial Analysis atribui ao Kimi K3 57 pontos em seu Intelligence Index, contra 51 do GLM-5.2 Max. Ela também estima um preço combinado de $2,31 por milhão de tokens para o K3 e $0,90 para o GLM, usando uma combinação de 7:2:1 de entrada em cache, entrada nova e saída.
Minha leitura: Kimi K3 é o vencedor em capacidade. As evidências não são suficientemente confiáveis para afirmar que ele é sempre melhor, mas são consistentes o bastante para que eu desse ao K3 a primeira tentativa em uma tarefa de programação excepcionalmente difícil. O argumento contrário do GLM-5.2 é econômico, não acadêmico.
Um teste real de jogo 3D torna a diferença visível
As pontuações de programação são abstratas. Uma cena 3D não é. Ela revela se o modelo consegue coordenar layout, comportamento da câmera, iluminação, interação, estado e iteração visual, em vez de apenas produzir arquivos sintaticamente válidos.
Uma comparação pública no X deu ao Kimi K3, ao GLM-5.2 e ao Claude Opus 4.8 o mesmo prompt de mundo 3D e mostrou as saídas para avaliação às cegas. Esta é uma demonstração qualitativa, não um benchmark: um prompt, uma execução e uma configuração de agente que pode afetar o resultado. Seu valor está em permitir que o leitor inspecione os mundos reais em vez de confiar em uma pontuação.
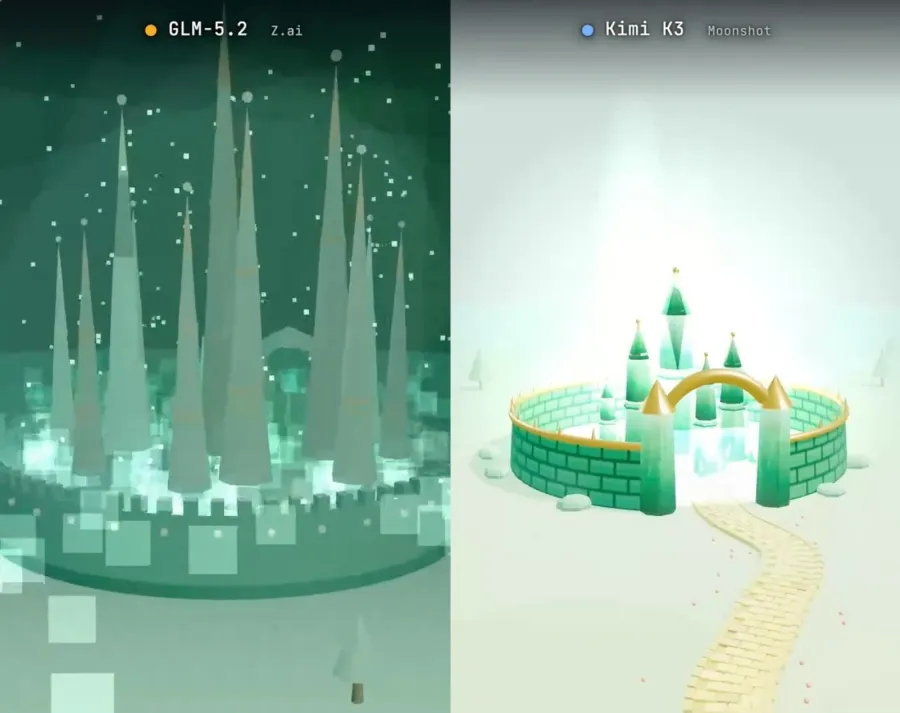
O K3 tem uma vantagem estrutural para esse tipo de trabalho. Ele aceita imagens e vídeos nativamente, permitindo que um agente renderize a cena, envie a captura de tela de volta ao modelo e peça que ele corrija cortes, espaçamento, contraste ou enquadramento da câmera. A Moonshot chama isso de fluxo de trabalho de visão no circuito em seu blog técnico do K3. O GLM-5.2 aceita apenas texto. Uma ferramenta externa de navegador pode descrever capturas de tela ou fornecer logs, mas isso adiciona outro componente e outro ponto em que informações podem ser perdidas.
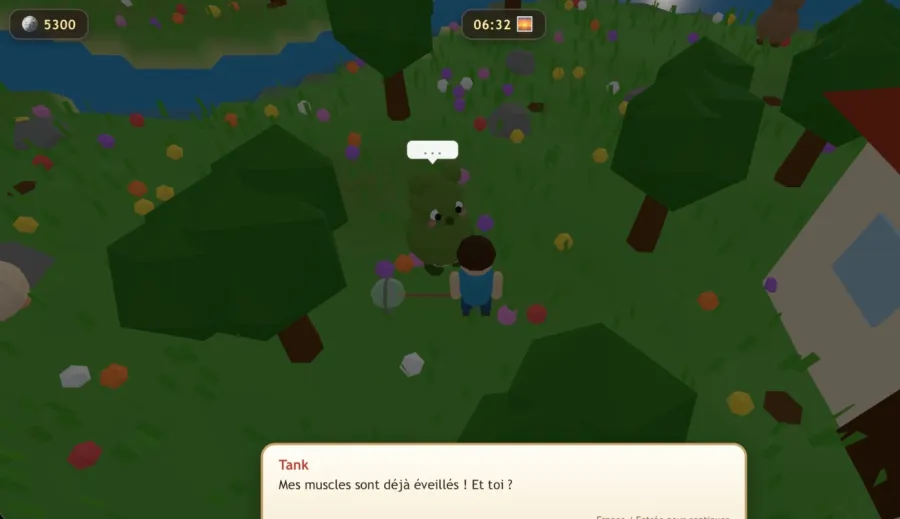
O GLM não deve ser descartado como modelo para programação de jogos. Em um relato da comunidade no Reddit, um desenvolvedor começou com uma pasta vazia e pediu ao GLM-5.2, executado pelo modo de planejamento do Claude Code, que criasse um jogo no estilo Animal Crossing em HTML, JavaScript e Three.js. O resultado continha cerca de 2.800 linhas e conectava movimentação, diálogos de NPCs, pesca, economia, loja, museu, moradia, móveis e LocalStorage. A execução relatada usou cerca de 11,7 milhões de tokens de entrada e 138 mil tokens de saída, com 29 minutos e 43 segundos de tempo de API e 1 hora e 21 minutos de tempo total.
O autor também relatou bugs e problemas de balanceamento. Ótimo. Essa irregularidade torna o exemplo mais útil do que um vídeo promocional polido do fornecedor. Ela mostra que o GLM-5.2 consegue montar um protótipo coerente; não mostra que o código está pronto para produção ou que supera o K3.
Para código de jogos, 3D interativo ou trabalho de frontend orientado por capturas de tela, eu escolheria o Kimi K3. Para um ciclo de jogo especificado por texto, em que o custo importa mais do que a iteração visual, o GLM-5.2 continua sendo uma opção confiável.
Qual modelo é melhor para revisão de código e correção de bugs?
Os testes A/B públicos diretos de revisão de código entre GLM-5.2 e Kimi K3 ainda são escassos. Vale dizer isso claramente. As tabelas de benchmarks testam resolução de problemas e execução por agentes, mas não nos dizem se algum dos modelos detectará o bug de autorização em seu pull request sem inundar a revisão com comentários de estilo.
Para correção de bugs difíceis, o K3 tem evidências mais fortes. Sua liderança no DeepSWE, Program Bench e SWE-Marathon sugere melhor desempenho quando um modelo precisa inspecionar uma base de código, elaborar um plano, editar arquivos, executar ferramentas e se recuperar de tentativas malsucedidas. A visão nativa também importa quando a falha é visível em um navegador, tela de celular, gráfico ou viewport de CAD.
Para a revisão cotidiana, eu começaria com o GLM-5.2. A Z.ai o recomenda explicitamente para auditorias de projetos, refatoração de longo prazo, migrações de API e trabalhos restritos por regras de lint, build, testes e dependências. Seu guia oficial incentiva os desenvolvedores a declarar limites como “não introduzir dependências” e “não alterar contratos de API”, exigindo depois a verificação de build, lint e testes. Isso se aproxima de um fluxo de revisão real.
O custo reforça esse argumento. A maioria dos pull requests não são problemas do SWE-Marathon. Pagar o adicional de saída do K3 para renomear um método, adicionar testes ou revisar uma alteração CRUD rotineira é difícil de justificar. Direcione as revisões comuns para o GLM; encaminhe apenas falhas ambíguas, defeitos visuais ou problemas persistentes em vários arquivos para o K3.
Preços da API: o Kimi K3 vale mais do que o GLM-5.2?
Nas tarifas oficiais, o GLM-5.2 custa $1,40 por milhão de tokens de entrada novos, $0,26 por entrada em cache e $4,40 por saída. O Kimi K3 custa respectivamente $3, $0,30 e $15. A entrada nova do Kimi custa cerca de 2,1 vezes mais, enquanto sua saída custa cerca de 3,4 vezes mais.
Considere um trabalho agregado de programação que consome 1 milhão de tokens de entrada novos e 100 mil tokens de saída ao longo de seu ciclo de agente:
| Carga de trabalho |
GLM-5.2 |
Kimi K3 |
| 1 milhão de entrada nova + 100 mil de saída |
$1,84 |
$4,50 |
| 1 milhão de entrada em cache + 100 mil de saída |
$0,70 |
$1,80 |
Essas estimativas excluem novas tentativas, cobranças de ferramentas externas e impostos. Elas também pressupõem que o provedor reconheça o prefixo repetido como armazenável em cache. A Moonshot relata taxas de acerto de cache superiores a 90% em cargas de trabalho de programação, mas seu resultado depende de prompts estáveis e do histórico de conversa preservado.
O K3 vale a diferença? Para uma tarefa difícil em que uma tentativa malsucedida custa duas horas de trabalho de um engenheiro, sim. Para revisão contínua de código ou manutenção em massa de repositórios, geralmente não. Uma vantagem independente de 6 pontos em inteligência não justifica automaticamente um preço combinado de tokens 2,6 vezes maior.
Recursos de API que os desenvolvedores realmente notarão
Ambos os modelos oferecem uma janela de contexto de 1 milhão de tokens, chamadas de função, streaming, saída estruturada e cache de contexto. Ambos podem operar por trás de um cliente compatível com OpenAI. As diferenças aparecem na operação.
O Kimi K3 aceita texto, imagens e vídeos por meio de seu serviço hospedado, oferece carregamento dinâmico de ferramentas e pode retornar saídas muito longas. Ele sempre raciocina, mas o model card atual agora documenta esforços de raciocínio `low`, `high` e `max`, com `max` como padrão. Os agentes ainda precisam preservar a mensagem completa do assistente, incluindo o histórico de raciocínio, entre os turnos; trocar outro modelo pelo K3 no meio de uma sessão pode desestabilizar a saída.
O K3 também pode ser proativo demais. A Moonshot recomenda instruções de sistema mais rigorosas ou um arquivo AGENTS.md quando o modelo não deve tomar decisões fora de um limite definido. Esse alerta importa em produção. Um modelo que corrige problemas adjacentes sem permissão pode parecer diligente em uma demonstração e se tornar um risco em um repositório regulamentado.
O GLM-5.2 é mais simples de orçar. Os desenvolvedores podem selecionar modos de raciocínio em vez de pagar pelo raciocínio máximo em cada solicitação. Ele oferece suporte a MCP e já é distribuído sob uma licença MIT, permitindo que as equipes inspecionem, ajustem ou hospedem os pesos por conta própria hoje. O custo é a multimodalidade: o modelo-base aceita apenas texto. Se seu ciclo de programação depende de capturas de tela, você precisa de outro componente de visão ou deve escolher o K3.
Implantação de pesos abertos: MIT vs a licença do Kimi K3
Ambos os modelos agora podem ser baixados, mas não oferecem as mesmas condições de implantação.
O GLM-5.2 usa a licença MIT. O Kimi K3 usa uma licença personalizada que permite amplo uso, modificação, ajuste fino, implantação e redistribuição, mas adiciona condições para empresas grandes de Model-as-a-Service e produtos comerciais muito grandes. Uma startup que cria um assistente interno de programação e uma plataforma de inferência de alta receita não enfrentam a mesma análise da licença do K3.
A diferença de hardware é igualmente importante. O GLM-5.2 tem 753 bilhões de parâmetros no total, com cerca de 40 bilhões ativos por token. O Kimi K3 tem 2,8 trilhões de parâmetros no total, 104 bilhões de parâmetros ativos e um repositório oficial de cerca de 1,56 TB. A Moonshot recomenda 64 aceleradores ou mais. O K3 oferece um teto de capacidade maior; o GLM é o projeto de hospedagem própria mais prático para a maioria das equipes.
Isso muda o veredito, mas não a política de roteamento. Use o GLM para cargas de trabalho rotineiras, sensíveis a custo ou privadas. Encaminhe para o K3 quando o raciocínio visual ou a dificuldade da tarefa justificarem a conta de API ou a infraestrutura mais pesada.
Comparação das APIs de programação GLM-5.2 vs Kimi K3 no GPT Proto
O GPT Proto disponibiliza ambos os modelos por meio de um endpoint compatível com OpenAI. Você pode abrir a página do modelo GLM-5.2, a página do modelo Kimi K3 ou navegar pelo catálogo completo de modelos. O benefício prático não é um novo agente de programação; é a possibilidade de executar a mesma solicitação nos dois modelos com uma única chave e comparar as saídas antes de definir regras de roteamento.
Instale o SDK atual do OpenAI para Python, exporte sua chave e execute este script:
python3 -m pip install --upgrade "openai>=1.0"
export GPTPROTO_API_KEY="your-key-here"
import os
from pathlib import Path

from openai import OpenAI


client = OpenAI(
    api_key=os.environ["GPTPROTO_API_KEY"],
    base_url="https://api.gptproto.com/v1",
)

task = """Review this Python function for correctness and security.
Return: (1) confirmed bugs, (2) a corrected implementation, and
(3) three pytest tests. Do not report style-only issues.

from pathlib import Path

def read_user_file(root: str, filename: str) -> str:
    path = Path(root) / filename
    return path.read_text(encoding="utf-8")
"""

models = ["glm-5.2", "kimi-k3.0"]

for model in models:
    response = client.chat.completions.create(
        model=model,
        messages=[
            {
                "role": "system",
                "content": (
                    "You are a senior application-security reviewer. "
                    "State uncertainty and avoid speculative findings."
                ),
            },
            {"role": "user", "content": task},
        ],
    )
    output = response.choices[0].message.content or ""
    Path(f"review-{model}.md").write_text(output, encoding="utf-8")
    print(f"Saved review-{model}.md")
O exemplo pode ser executado como está depois que você definir GPTPROTO_API_KEY. Ele pede que ambos os modelos encontrem o risco de path traversal e produzam testes, salvando revisões Markdown separadas. Se o ID de um modelo mudar durante a implementação, copie o ID atual exibido na página do modelo no GPT Proto.
Em produção, não escolha um vencedor com base em um único prompt. Crie um conjunto de 20 a 50 tarefas de seus próprios repositórios, remova os segredos e avalie descobertas confirmadas, falsos positivos, taxa de aprovação dos testes, total de tokens e tempo total. A página inicial do GPT Proto é o ponto de partida para criar a chave de API compartilhada.
Qual você deve escolher?
Escolha o Kimi K3 se sua tarefa combinar programação com capturas de tela ou vídeos, se você estiver criando uma experiência frontend ou 3D, ou se uma falha difícil com várias etapas custar mais do que os tokens adicionais. Escolha seus pesos apenas se sua equipe puder sustentar a infraestrutura e tiver analisado a Licença do Kimi K3.
Escolha o GLM-5.2 para revisão rotineira de código, auditorias de repositórios, refatoração, migrações e automação de programação em alto volume. Ele continua sendo a melhor opção padrão para hospedagem própria quando a licença MIT, uma infraestrutura menor e um custo previsível importam mais do que o teto de capacidade superior do K3.
Para uma carga de trabalho mista, faça roteamento em vez de declarar lealdade: GLM-5.2 primeiro, Kimi K3 quando houver escalonamento. O lançamento dos pesos do K3 acrescenta controle de implantação; não elimina a vantagem econômica e operacional do GLM.