Краткий обзор GPT-6.2 Astra
| Вопрос |
Краткий ответ |
| Что такое GPT-6.2 Astra? |
Самая мощная модель OpenAI GPT-6.2 для сложного программирования и профессиональных задач |
| Дата выпуска |
17 ноября 2026 г. |
| ID модели API |
gpt-6.2-astra |
| Контекстное окно |
1,05 млн токенов |
| Максимальный ввод / вывод |
922 000 / 128 000 токенов |
| Модальности |
Ввод текста и изображений; вывод текста |
| Стандартная цена API OpenAI |
$8 за ввод, $0,40 за кэшированный ввод и $40 за вывод на 1 млн токенов |
| Цена GPT Proto |
$6,40 за ввод, $0,32 за кэшированный ввод и $32 за вывод на 1 млн токенов — скидка 20% |
| Лучшее применение |
Сложная отладка, проверка кода, миграции, анализ данных, профессиональные документы, наука, CAD и 3D-процессы |
| Лучший вариант на каждый день |
GPT-6.2 Sol для рутинного программирования, написания текстов и более бюджетных задач |
В документации к моделям OpenAI указана поддержка ответов и чат-комплитов, а также инструментов, включая веб-поиск, поиск по файлам, интерпретатор кода, хостинг-оболочку, компьютерное управление, MCP и генерацию изображений. Сама модель возвращает текст. Готовые электронные таблицы, слайды, сайты или 3D-активы зависят от инструментов и среды выполнения вокруг нее.
Что на самом деле обсуждают первые пользователи?
Дискуссия после запуска сосредоточена не столько на результатах бенчмарков, сколько на разрыве между «сырыми» возможностями и повседневной практичностью.
1. Astra отлично справляется с проверкой и исправлением существующих систем
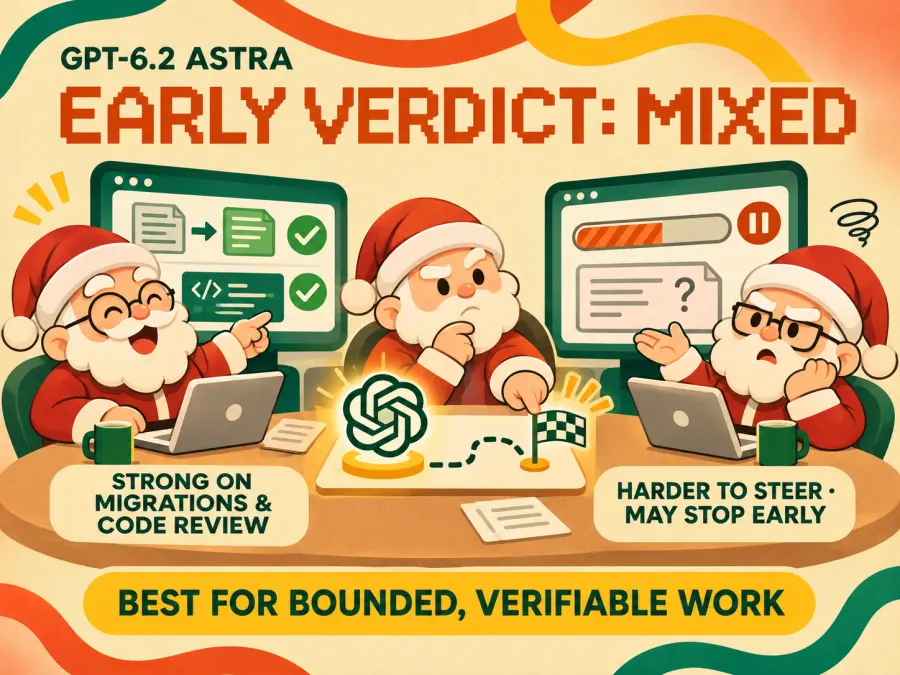
Раннее тестирование GitHub Copilot показало, что GPT-6.2 Astra обнаруживает значительно больше реальных проблем при проверке кода, чем GPT-6 Astra, при этом используя меньше токенов. Для продакшн-команды это важнее, чем очередная демо-версия: ценная работа часто заключается в поиске дефектов, сохранении существующего поведения и подтверждении исправлений с помощью тестов.
Инженер Тибор Блахо описал использование Astra в повседневной работе с инфраструктурой и ПО, включая управление серверами, резервное копирование, мониторинг, исследования, администрирование, отладку и проверку кода. Его яркий пример — обновление многомиллионного легаси-приложения и его старых зависимостей до актуальной версии языка. Он сообщил о получении рабочего результата локально примерно через три часа и успешном прохождении тестов после чистой сборки примерно через шесть часов, отметив при этом, что работа еще оставалась.
Это частный случай, а не контролируемый бенчмарк. Тем не менее, это полезный пример, так как он включает реальную кодовую базу, затраченное время и этап верификации. Он также указывает на практический рабочий процесс: Блахо использует Astra и модели Claude для исследования и проверки работы друг друга, вместо того чтобы полагаться на то, что одна модель найдет все дефекты.
2. Длительные автономные запуски могут разочаровывать
Негативные отзывы также вполне конкретны. В раннем обзоре Дэна Шиппера говорится, что Astra часто останавливалась слишком рано при выполнении комплексных задач по написанию кода и была настолько лаконичной, что за ходом её мыслей становилось трудно следить. Итан Моллик назвал её работу неровной и сложной в управлении: нейросеть успешно создала амбициозный проект космического лифта на Blender и Unity, однако он всё равно не стал использовать её как повседневную модель.
Подробный отчет разработчика Тео также неоднозначен. Он похвалил Astra как инструмент для ревью кода, отметил, что она находит нестандартные решения, и приписал ей разработку обратного прокси-сервера, который может сэкономить его компании 25 000 долларов в месяц. При этом он сообщил о длительных процессах, которые зависали на вопросах, на которые модель не могла ответить, о циклах без прогресса и о резюме, которые было сложнее понять, чем сами изменения в коде.
Эти примеры не доказывают, что каждый запуск Astra будет неудачным. Они указывают на один и тот же риск под разными углами: модель может быть достаточно способной для выполнения работы, но ею сложно управлять, когда цель не имеет четких границ.
3. Лаконичный вывод — это либо эффективность, либо нехватка контекста
В собственном руководстве по промптингу GPT-6.2 от OpenAI говорится, что Astra по умолчанию более лаконична и прямолинейна. Для ответа в поддержке, комментария к ревью кода или краткой сводки для руководства это может быть полезно. Но для сложного объяснения это может выглядеть так, будто модель пропустила логические шаги, необходимые читателю.
Это объясняет, почему ранние реакции так противоречивы. Люди, тестирующие четко ограниченные задачи, могут видеть меньше «воды» и использовать меньше токенов. Люди, использующие Astra как помощника в долгосрочном проекте, могут столкнуться с резкими ответами, необъяснимыми решениями или преждевременной передачей управления.
4. Настоящий вопрос в типе задачи, а не в том, «умная» ли Astra
Полученные данные позволяют провести простую черту:
| Тип задачи |
Подходит для Astra |
| Четкая цель, инструменты, тесты и финишная прямая |
Отличный кандидат |
| Важное ревью, где пропущенные дефекты стоят дорого |
Отличный кандидат |
| Работа с данными из нескольких источников или документами с проверяемым результатом |
Отличный кандидат |
| Рутинные письма, заметки с встреч или небольшие правки кода |
Обычно лучше сначала использовать Sol |
| Исследования с открытым финалом, требующие оценки важности |
Сравните с Fable 5.2 и оставьте проверку за человеком |
| Многочасовая автономная сборка с неоднозначными решениями |
Тщательно протестируйте перед использованием |
Подходит ли GPT-6.2 Astra для повседневной работы?
Да, но для большинства повседневных задач она не требуется. Для заметок по встречам, рутинных писем, кратких исследований, небольших правок кода или черновиков GPT-6.2 Sol является более естественным выбором. Это модель, которую OpenAI позиционирует для повседневных задач, а стоимость токенов у нее на 75% ниже, чем у Astra. GPT Proto применяет одинаковую скидку 20% к обеим моделям, поэтому разница в цене остается прежней.
Astra становится полезной, когда обычная рабочая задача превращается в сложную и высокоценную. «Проверь этот пулл-реквест» может подойти для Sol; «отследи этот периодический сбой в трех сервисах, исправь его и запусти затронутые рабочие процессы» — это задача для Astra. «Сделай краткую сводку по этому CSV» — это рутина; «найди проблемы с качеством данных, объясни статистические ловушки и создай редактируемую рабочую книгу для принятия решений» — здесь Astra оправдывает свою стоимость.
Практические примеры ежедневного использования, о которых сообщалось до сих пор, включают отладку, серверные операции, мониторинг, резервное копирование, проверку кода, исследования с использованием нескольких источников и офисное администрирование. Общая черта здесь не профессия, а то, что задача обладает достаточной сложностью, чтобы выиграть от более глубокого рассуждения, и достаточной структурой, чтобы проверить результат.
Для чего хороша GPT-6.2 Astra?
Анализ кода, поиск первопричин и модернизация устаревших систем
Это наиболее понятный практический сценарий использования. Предоставьте Astra неработающий рабочий процесс, соответствующие логи, репозиторий и команды для тестирования. Попросите нейросеть отследить ошибку между сервисами, внедрить максимально точечное и безопасное исправление, а затем запустить затронутые тесты. Это соответствует рекомендованному OpenAI рабочему процессу Astra, а также положительным отзывам от GitHub и первых инженеров.
Обновление устаревшего кода может стать особенно удачным решением, так как эта задача сложна, но поддается проверке. Модель может изучить старые зависимости, обновлять код поэтапно и многократно запускать чистую сборку. Человеку по-прежнему необходимо определять требования к совместимости и проверять миграцию. Фраза «Все тесты пройдены» является доказательством только в том случае, если набор тестов охватывает все важные аспекты поведения системы.
Для обычного ревью pull-request или небольших правок может быть достаточно GPT-6.2 Sol. OpenAI прямо рекомендует Sol для повседневного программирования, при этом он стоит в четыре раза дешевле стандартных тарифов Astra на ввод и вывод данных.
Анализ данных, дашборды и редактируемые рабочие книги
Ценность Astra заключается не просто в написании SQL-запросов. Она может изучать данные, замечать проблемы с качеством, формулировать предположения, проводить анализ и превращать результаты в рабочую книгу, график или дашборд, которые может проверить другой человек.
Независимый тест анализа данных Plotly предоставляет полезный пример реальной задачи. Astra ответила на 41 из 43 вопросов, обнаружила все внедренные проблемы с качеством данных, избежала всех пяти статистических ловушек и выполнила задачу за $4.11. Среднее время ответа на вопрос составило 12.4 секунды против 26.9 секунд у GPT-6 Astra. Компромисс важен: она пропустила два скрытых паттерна, а GPT-6.1 Sol достигла идеального результата в этом тесте за $2.61. Astra была быстрой и способной, но не всегда является самым дешевым или точным вариантом.
Пример оценки Alderfen от OpenAI демонстрирует документальную сторону тех же возможностей. Astra создала редактируемую рабочую книгу DCF, которая прогнозирует выручку до 2031 года, сверяет три финансовые отчетности, рассчитывает стоимость на акцию и размещает ключевые факторы рядом с таблицей чувствительности. Воспринимайте это как демо от вендора, а не как независимое доказательство. Тем не менее, это полезный шаблон для теста, который вы можете воспроизвести со своей собственной электронной таблицей.
Финансы, бухгалтерский учет, юридическая работа и профессиональная документация
GPT-6.2 Astra была обучена соблюдать профессиональные стандарты при создании презентаций, электронных таблиц, служебных записок и документов. OpenAI сообщает о достижениях в рабочих процессах, связанных с финансами, бухгалтерским учетом, консалтингом, продажами и юридической практикой. Результаты клиентов, представленные на странице запуска, включают сокращение количества циклов проверки приложений, дашбордов и презентаций, а также уменьшение времени выполнения долгосрочных бухгалтерских задач. Поскольку это результаты, отобранные самим вендором, их следует рассматривать как многообещающие сценарии использования, а не как гарантированные показатели.
Лучше всего модель справляется с проверяемыми результатами:
Финансовая модель, формулы которой согласуются и корректно реагируют при изменении исходных данных.
Юридическая записка, утверждения в которой можно подтвердить ссылками на предоставленные нормативные акты и исходные документы.
Презентация, которая следует существующему шаблону и превращает каждый заголовок в обоснованный вывод.
Трекер соответствия требованиям, который сопоставляет каждое требование с доказательствами, ответственным лицом и статусом.
Независимые данные менее оптимистичны в отношении творческих задач. В реалистичной оценке рабочей среды от Epoch AI ни одна из протестированных моделей не достигла стандартов сотрудников Epoch ни в одной из задач. GPT-6.2 Astra набрала в среднем 65%, что на 17 пунктов ниже, чем у Claude Fable 5.2. В Epoch отметили, что Astra улучшилась по сравнению с GPT-6 Astra в лаконичности изложения, графическом дизайне и исследованиях центров обработки данных, но при этом может быть излишне осторожной и опускать выводы, которые подтверждаются имеющимися доказательствами.
Это кажущееся противоречие и есть суть. Astra может быть очень сильна, когда критерии и желаемый результат четко определены. Когда же работа требует принятия решений о том, что важно, формирования обоснованных предположений и итеративной работы над неопределенным планом исследования, выбор модели и контроль со стороны человека значат гораздо больше.
Научный анализ и технические исследования
OpenAI позиционирует науку как флагманский сценарий использования Astra и сообщает о передовых результатах в терминальных научных рабочих процессах. Отдельный сигнал от ранних пользователей поступил от биомедицинского исследователя Дерьи Унутмаза, который отдал предпочтение Astra для науки и долгосрочного программирования, при этом все еще предпочитая Opus 5.5 за дизайнерский вкус и эмоциональный интеллект. Он также описал свой опыт биомедицинских исследований с Astra как весьма успешный.
Это не означает, что Astra может самостоятельно создавать исследования, готовые к публикации. Оценка Epoch показала, что передовые модели по-прежнему склонны использовать существующие идеи, слишком полагаться на первые попытки и испытывают трудности с определением наиболее важных выводов. Используйте Astra для поиска, написания кода для анализа, сравнения источников, проверки гипотез или критического разбора черновиков. Не воспринимайте уверенный исследовательский нарратив как валидацию.
CAD, симуляции, 3D-дизайн и визуальные прототипы
Здесь примеры запуска выглядят интереснее, чем игры. OpenAI продемонстрировала, как Astra моделирует компоненты транспортных средств, пишет решатель на Python для динамики шасси, анимирует результат в Blender и создает руководство по сборке и каталог запчастей для радиоуправляемого багги. Эти примеры объединяют визуальное мышление, написание кода, использование компьютера и документирование в единый рабочий процесс.
Такое сочетание может помочь на этапе инженерных изысканий: превратить справочные изображения и руководства в редактируемую модель, протестировать изменения в симуляции и создать визуальное пояснение для рецензента. Физический дизайн все равно требует инженерной проверки. Правдоподобная анимация не является доказательством того, что нагрузки, допуски, материалы или требования безопасности верны.
Может ли GPT-6.2 Astra создавать игры?
Да. Meridian Sound Racing — это играбельная браузерная демо-версия, а проект космического лифта Итана Моллика объединил Blender, Unity, браузерный интерфейс и симуляцию физики невесомости.
Но фраза «может создать игру» — не лучшее описание для Astra. Эти проекты доказывают, что нейросеть способна координировать код, 3D-ассеты, инструменты и взаимодействие в рамках масштабной разработки. Те же возможности полезны для симуляций, обучающих сред, цифровых двойников, конфигураторов продуктов и интерактивных историй на основе данных.
Творческая последовательность также требует проверки. Первые пользователи отмечали сильное визуальное чутье модели по умолчанию, но при этом повторяющиеся паттерны дизайна и слабый контроль над стилем. Предоставьте Astra визуальный референс, типографику, целевую аудиторию, правила взаимодействия и четкие анти-цели. И оценивайте вторую итерацию, а не только первый скриншот.
Как получить лучшие результаты от GPT-6.2 Astra
Отзывы сообщества говорят о том, что для Astra требуется более четкое техническое задание, чем для обычного запроса в чат. OpenAI также предупреждает, что модель может предложить следующий шаг и ждать, если намерение пользователя неясно.
Используйте структуру промпта, подобную этой:
Цель:
Выполнить [конкретный результат].

Считается выполненным, когда:

1. [Критерий приемки]

2. [Тест или доказательство]

3. [Требуемый формат вывода]

Автономность:
Делайте разумные, обратимые предположения и продолжайте работу без ожидания.
Спрашивайте только в том случае, если решение существенно изменит результат или приведет к необратимым действиям.

Ограничения:

- Сохранять [существующее поведение или стиль].

- Не менять [область вне рамок проекта].

- Использовать [инструменты, файлы, источники или соглашения].

Верификация:
Запустить [тесты или проверки]. Явно сообщать о любом отсутствующем файле, не сработавшем инструменте, неподтвержденном предположении или незавершенном этапе.

Финальная передача:
Обобщить, что было изменено, что было проверено, оставшиеся риски и общее использование/стоимость.
Для многоходовой работы с API сохраняйте префикс промпта неизменным и добавляйте новые инструкции. OpenAI заявляет, что это сохраняет логику рассуждений и улучшает повторное использование кэша промптов. Для фронтенд-задач или визуальной работы предоставьте реальный референс, укажите желаемую типографику и изображения. «Сделай современно» — это не дизайн-система.
Сколько стоит выполнение задачи в GPT-6.2 Astra?
Тарифы указаны в долларах США за миллион токенов для запросов объемом до 272 000 входных токенов. Для строк GPT Proto применяется текущая скидка 20% от стандартных тарифов OpenAI.
Для запроса с 20 000 некэшированных входных токенов и 5 000 оплачиваемых выходных токенов стандартная стоимость составит $0.36 в GPT-6.2 Astra, $0.45 в GPT-6 Astra и $0.09 в GPT-6.2 Sol. По текущим тарифам GPT Proto такое же количество токенов стоит $0.288 в Astra или $0.072 в Sol. Реальная задача агента может включать повторные вызовы модели, повторное использование кэшированного контекста, повторные попытки использования инструментов или создание гораздо более длинного результата.
При превышении 272 000 входных токенов в одном запросе тарифы Astra на ввод и кэширование удваиваются, а стоимость вывода увеличивается в 1,5 раза по сравнению с тарифом для короткого контекста для всего запроса. Контекстное окно в 1,05 млн токенов полезно, но его небрежное заполнение может привести к крупному счету. Оценивайте стоимость выполнения всей задачи, а не только цену за миллион токенов.
Пример с Plotly наглядно это показывает: 43 аналитических вопроса обошлись в $4.11 при использовании GPT-6.2 Astra по сравнению с $19.97 при использовании GPT-6 Astra. При этом GPT-6.2 Sol стоил $1.22 и выполнил лишь на один вопрос меньше. Обновление Astra действительно значительно, однако более дешевая модель может быть экономически выгоднее для рутинного производственного трафика.
Оба маршрута со скидкой уже доступны. Ознакомьтесь со страницей модели GPT-6.2 Astra или страницей модели GPT-6.2 Sol, чтобы узнать текущий ID модели и формат запроса перед отправкой производственного трафика. В коллекции моделей OpenAI перечислены остальные доступные модели OpenAI.
Лучше ли GPT-6.2 Astra, чем Claude Fable 5.2?
Не во всех видах задач.
OpenAI сообщает, что Astra более чем в два раза превзошла Fable 5.2 по показателю успешного прохождения юридических тестов при стоимости примерно в шесть раз ниже. Однако в Cognition’s FrontierCode 2.0 модель Fable 5.2 показала более высокие результаты при внесении изменений в существующие кодовые базы. Оценка Epoch для задач с открытым финалом также отдала предпочтение Fable 5.2 с преимуществом в 17 баллов.
| Выбирайте GPT-6.2 Astra, когда… |
Выбирайте Claude Fable 5.2, когда… |
| Критически важны проверка кода, отладка, использование инструментов или проверяемые технические результаты |
Задача имеет открытый финал и требует глубокого понимания того, что действительно важно |
| Вам нужны рабочие процессы с CAD, симуляциями, 3D или компьютерным управлением |
Стиль взаимодействия и понятные развернутые объяснения важнее |
| Важны стоимость повторяющихся задач и эффективность кэширования |
Ваши собственные тесты показывают меньше вмешательств или лучшее завершение задач |
| Вам нужна вторая модель для проверки работы другого агента |
Вам нужна вторая модель, чтобы оспорить предположения и патчи Astra |
Самый практичный ответ — использовать обе модели. Рабочий процесс перекрестной проверки, описанный Тибором Блахо, выглядит более убедительно, чем объявление одного универсального победителя: пусть одна модель занимается реализацией или исследованием, а вторая ищет пропущенные дефекты и необоснованные допущения.
Для творческого сравнения используйте интерактивный бриф по акварели из нашего теста Claude Fable 5.2. Дайте обеим моделям один и тот же существующий проект и попросите создать новый элемент управления, не нарушая работу текущих. Сравните точность с первой попытки, количество правок, качество объяснений, общее количество токенов и стоимость выполнения задачи. Доступ к Fable можно найти на странице API Claude Fable 5.2.
Где можно использовать GPT-6.2 Astra?
ChatGPT Work: GPT-6.2 Astra доступна в версии Work, а не в обычном чат gpt. Доступ зависит от вашего тарифного плана, настроек рабочего пространства и статуса развертывания.
Codex: Да. Выберите Astra в приложении Codex или используйте /model в CLI. Это рекомендуемый OpenAI вариант для отслеживания сложных ошибок в сервисах, а также для завершения исправлений и тестирования.
Claude Code: Нативной опции для GPT-6.2 Astra не существует. В документации шлюза LLM от Anthropic указано, что маршрутизация Claude Code на модели, отличные от Claude, через шлюз не поддерживается.
OpenAI API: Используйте официальный ID модели gpt-6.2-astra. OpenAI рекомендует использовать Responses API для рабочих процессов с вызовом инструментов.
GPT Proto: И GPT-6.2 Astra, и GPT-6.2 Sol доступны по цене на 20% ниже стандартных тарифов OpenAI API. Выбирайте Astra для сложных задач на рассуждение и профессиональных результатов, которые можно проверить; выбирайте Sol для рутинного программирования, написания текстов и больших объемов работы. В графике раннего развертывания GPT-6.2 Astra зафиксированы первые появления модели в Codex.
Следующий запрос использует актуальный ID модели Astra. Вы можете скопировать новейший фрагмент интеграции прямо со страницы модели.
curl --fail-with-body --silent --show-error \
  https://gptproto.com/v1/chat/completions \
  --header "Authorization: Bearer ${GPTPROTO_API_KEY}" \
  --header 'Content-Type: application/json' \
  --data '{
    "model": "gpt-6.2-astra",
    "messages": [
      {
        "role": "user",
        "content": "Мы продали 12 единиц по $25 каждая. Себестоимость каждой единицы — $10. Верните выручку и валовую прибыль в USD в формате JSON, используя ключи revenue и gross_profit."
      }
    ]
  }'
Выручка должна составить $300, а валовая прибыль — $180. Для более дешевого рутинного запуска переключитесь на точный ID модели, указанный на странице GPT-6.2 Sol. Вы также можете просмотреть коллекцию моделей OpenAI для поиска других доступных вариантов.
Итоги
Самое убедительное преимущество GPT-6.2 Astra заключается не в том, что она может создать игру. Это способность объединять рассуждения, код, инструменты, файлы и работу с компьютером для задач, имеющих измеримый результат: исправленная и протестированная ошибка, миграция, которая успешно собирается, рабочая книга, которая проходит сверку, или анализ, раскрывающий свои допущения.
Ограничения столь же практичны. Первые пользователи неоднократно описывают модель, которая может блестяще справляться с задачей, но при этом оставаться трудной в управлении или понимании на длинной дистанции. Используйте Sol для рутинной работы. Используйте Astra, когда задача достаточно сложна, чтобы оправдать это, точно определите критерии «готовности», проверьте результат и сравните его с Fable 5.2 в тех задачах, где важны исследовательское суждение и стиль совместной работы.