Обзор Qwen 4 Max: от слепого тестирования «Qoduck» до 14-дневной предварительной версии
Если вам нужен практический обзор Qwen 4 Max, начните с четырех дней, предшествовавших его публичному анонсу. В период с 7 по 10 ноября 2026 года анонимная модель под кодовым названием Qoduck появилась внутри Qoder — агентной IDE для программирования. Разработчики, тестировавшие Qoduck, заметили необычную закономерность: вместо того чтобы быстро выдавать фрагмент кода за один проход и ждать обратной связи от человека, модель тратила от десяти до пятнадцати минут на запуск проверок оболочки, создание пользовательских SVG-ресурсов с нуля и выполнение модульных тестов для своих собственных diff-файлов, прежде чем выдать окончательный ответ.
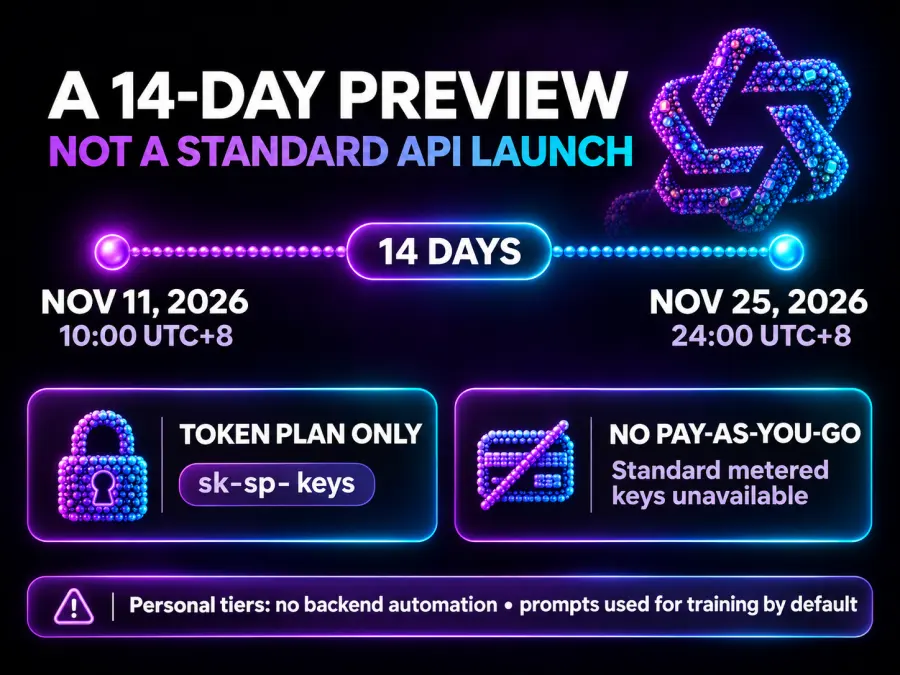
11 ноября 2026 года в 10:00 UTC+8 компания Alibaba подтвердила, что Qoduck — это новейшая модель Qwen 4 Max, и открыла к ней доступ в Alibaba Cloud Model Studio под идентификатором модели qwen4-max-preview (в некоторых конфигурациях клиентов упоминается как qwen4.0-max-preview). Вместо полноценного коммерческого запуска с прайс-листом за токены, Alibaba представила этот релиз — часто описываемый в документации для разработчиков как ознакомительная версия Qwen 4 Max на 14 дней — предназначенный для стресс-тестирования агентных рабочих процессов в таких инструментах разработки, как Claude Code, Cursor, Cline и Qoder.
| Спецификации |
Статус подтвержден (qwen4-max-preview) |
Источник / Техническое примечание |
| Официальный ID модели |
qwen4-max-preview |
Документация Alibaba Cloud Model Studio / Bailian |
| Период предварительного доступа |
11 нояб. 2026 (10:00) – 25 нояб. 2026 (24:00 UTC+8) |
Строго ограниченный 14-дневный доступ |
| Контекстное окно |
1 000 000 токенов (макс. вход: 967 000 токенов) |
Проверено по документации CN и международной версии |
| Макс. выходных токенов |
393 216 всего (131 072 финальный вывод + 262 144 рассуждения) |
max_tokens ограничивает сумму мышления и вывода |
| Входные / Выходные модальности |
Вход: текст, изображение, видео · Выход: текст |
В предварительной версии нет нативного аудиовхода |
| Управление рассуждением |
reasoning_effort: low, medium, xhigh |
Мышление включено по умолчанию; стандартно установлено xhigh |
| Поддерживаемые API-протоколы |
OpenAI Chat Completions, Responses API, Anthropic Messages |
Требуется специальный эндпоинт плана токенов sk-sp- |
| Размер параметров и веса |
Не разглашается (закрытая коммерческая версия) |
Цифры 2.4T / 95B в сети относятся к Qwen3.8-Max |
| Официальная таблица бенчмарков |
Не опубликована на момент запуска |
Циркулирующий показатель GameFeel 49.9 относится к Qwen-4-Flash-Early |
Понимание того, что такое qwen 4 max explained как поколенческий шаг, сводится к тому, как модель расходует вычислительные мощности во время вывода. Там, где предыдущие версии рассматривали вызов инструментов как дополнительную функцию, основное обновление qwen 4 max upgrade встраивает цикл самопроверки в процесс рассуждения по умолчанию. Когда модель просят создать веб-приложение или исправить утилиту командной строки, она регулярно связывает десятки вызовов инструментов — проверяя деревья каталогов, запуская pytest или локальные headless-браузеры, выявляя собственные ошибки синтаксиса или верстки и переписывая неисправные строки до того, как пользователь увидит результат.
Архитектура, размер модели и проверка реальности бенчмарков
Два заблуждения в настоящее время доминируют в результатах поиска по запросам qwen 4 max size и qwen 4 max benchmark. Их прояснение — самый быстрый способ понять, что на самом деле выпустила Alibaba, а что остается нераскрытым.
Во-первых, Alibaba не раскрыла общее или активное количество параметров для alibaba qwen 4 max. В нескольких сторонних блогах она указана как модель с 2,4 триллионами параметров типа Mixture-of-Experts (MoE) с 95 миллиардами активных параметров на токен. Эти точные цифры относятся к предыдущему флагману, Qwen3.8-Max, который был выпущен в сентябре 2026 года. Хотя Qwen 4 Max почти наверняка использует разреженную архитектуру MoE для экономичного обслуживания контекстного окна в 1 млн токенов, любая конкретная цифра в триллионы параметров, которую вы встретите в ноябре 2026 года, является непроверенным наследием поколения 3.8.
То, что мы знаем об архитектуре, исходит из технического релиза Alibaba от августа 2026 года для Qwen3.8-Flash-Next, которую команда Qwen прямо обозначила как испытательный стенд для проверки ключевых архитектурных обновлений серии Qwen 4. В этом предварительном отчете задокументированы четыре структурных изменения, которые объясняют, как qwen4-max-preview справляется с рабочими нагрузками в миллион токенов:
Гибридное внимание GDN + QSA: Сочетание слоев линейного внимания Gated DeltaNet (GDN) с разреженным вниманием Qwen (QSA) сократило задержку префилла (TTFT) при контексте в 1 000 000 токенов до 7,6 раз по сравнению со стандартным полным вниманием.
4-потоковые управляемые остаточные соединения: Расширение ширины остаточного потока с помощью обучаемых гейтов улучшает градиентный поток и маршрутизацию признаков между слоями во время глубоких многошаговых рассуждений.
N-граммные слои эмбеддингов: Внедрение локального контекста из нескольких токенов непосредственно на этапе эмбеддинга разгружает ранние блоки внимания от лексического сопоставления с образцом.
Обучение с оптимизатором Muon: Переход на оптимизацию крупномасштабного предварительного обучения с помощью Muon повысил эффективность выборки на корпусах кода и формальной логики.
Во-вторых, если вы ищете результаты qwen 4 max benchmark, вы, скорее всего, столкнетесь с утверждениями, что Qwen 4 Max набрала 49,9 баллов в GameFeel Bench v1.4, опередив Claude Opus 5.5 с 47,2 баллами. Я проверил таблицу лидеров и базовые логи коммитов: этот результат 49,9 был зафиксирован ранней, облегченной тестовой контрольной точкой под названием Qwen-4-Flash-Early (внутреннее кодовое имя hawk), а не qwen4-max-preview. По состоянию на 13 ноября 2026 года Alibaba не публиковала официальную таблицу лидеров MMLU-Pro, SWE-bench Verified или AIME для Qwen 4 Max.
Что вы можете проверить прямо сейчас, так это механику qwen 4 max context window и её лимит вывода — и именно здесь разработчики, переходящие на эту модель, сталкиваются с трудностями. Хотя контекстное окно вмещает 1 000 000 токенов (с задокументированным потолком промпта в 967 000 токенов), максимальный вывод указан как 393 216 токенов на международном портале, а на внутреннем портале он разбит на 262 144 токена рассуждений плюс 131 072 токена финального ответа.
Вот в чем подвох: параметр API max_tokens в qwen4-max-preview регулирует sum (сумму) reasoning_content и content. Поскольку по умолчанию модель использует reasoning_effort: "xhigh" (наивысший из трех доступных параметров: low, medium и xhigh), сложный запрос по программированию может легко израсходовать от 15 000 до 40 000 токенов внутри скрытого блока размышлений. Если ваш текущий клиентский код передает max_tokens: 4096 или 8192, модель исчерпает весь лимит в процессе размышления и вернет пустую строку content. Чтобы избежать незаметного усечения, либо увеличьте max_tokens выше 65 536, либо принудительно установите reasoning_effort на значение medium для стандартных задач.
Практический обзор Qwen 4 Max: что на самом деле показывают тесты сообщества и СМИ
Поскольку Alibaba пропустила публикацию традиционного пресс-релиза с бенчмарками, самые достоверные данные для qwen 4 max review поступают от инженерных команд, которые интегрировали qwen4-max-preview в рабочие среды агентов в первые 48 часов после запуска превью-версии. Их логи демонстрируют четкую закономерность: каждый скачок в качестве вывода сопровождается заметным увеличением задержки и стоимости токенов.
11 ноября японская ИИ-консалтинговая компания WEEL опубликовала трехэтапную оценку, протестировав превью-модель в задачах синтеза фронтенда, исследования по нескольким источникам и отладки на уровне репозитория внутри Claude Code:
Пользовательская целевая страница на 908 строк в формате SVG (против Qwen 3.8 Max): При получении идентичного промпта на создание адаптивной целевой страницы для клиники физиотерапии с тематикой леса, Qwen3.8-Max справилась примерно за 9,5 минут, но подтянула случайные стоковые фотографии из внешних источников, которые нарушили сетку или не загрузились. qwen4-max-preview потребовалось около 17 минут — почти в два раза больше. Вместо использования ненадежных внешних URL-адресов модель десятки раз вызывала интерпретатор кода (Code Interpreter) в фоновом режиме для программной отрисовки пользовательских SVG-иллюстраций лесных крон, архитектуры клиники и иконок персонала, предоставив HTML-файл на 908 строк без единого битого элемента.
Автономная отладка CLI в Claude Code (пройдено 36/36 тестов): Команда WEEL направила Claude Code (работающий на qwen4-max-preview через совместимый с Anthropic эндпоинт) на локальный Python CLI для ведения домашней бухгалтерии (kakeibo) и попросила добавить флаги --export-csv и --month с модульными тестами. Выполнение заняло 11 минут 48 секунд. После написания первоначальной реализации модель запустила pytest, обнаружила 2 провальных теста — включая граничный случай, когда отрицательная валютная строка, например -100日元, ошибочно интерпретировалась библиотекой Python argparse как флаг командной строки — и самостоятельно исправила парсер. Без дополнительных подсказок она также добавила заголовок utf-8-sig BOM, чтобы японские символы не искажались в Microsoft Excel, и экранировала ведущие символы =, +, - и @ для предотвращения инъекций формул в CSV. Все 36 тестов были пройдены, при этом было израсходовано всего 0,4% месячной квоты плана Lite.
Самопроверяемое исследование политики: Получив задачу составить сравнительную таблицу субсидий для малого и среднего бизнеса в Японии на 2026 год, модель потратила 2 минуты на выполнение более десятка веб-запросов по порталам министерств и еще 5 минут на запуск grep и скриптов проверки на Python, чтобы убедиться, что столбцы таблицы Markdown не сместились, прежде чем представить результат за 8 минут.
Два дня спустя, 13 ноября, китайское технологическое издание Silicon Star (GuiXingRen) устроило визуальный и 3D-инженерный стресс-тест для qwen4-max-preview. При запросе на создание классической SVG-анимации «пеликан на велосипеде» модель проработала движение педалей и параллакс теней деревьев, попутно добавив слайдер скорости 0,5x–1,75x и переключатель тем «день/сумерки/ночь». В более сложном тесте на Three.js — создании играбельной 3D-игры с бумажным самолетиком под названием Paper Skies, где самолет пролетает через окно спальни в сад, — рецензенты отметили, что физика и обработка препятствий соответствуют ориентированной на творчество модели Claude Fable 5.1 от Anthropic, хотя она все еще уступает более новой Claude Fable 5.2 в качестве шейдеров. Когда модель попросили переработать адаптивную домашнюю страницу Silicon Star, она запустила локальный браузер, обнаружила, что внешние миниатюры статей возвращают ошибки 403 hotlink, автоматически заменила их стилизованными SVG-градиентными плейсхолдерами и завершила второй раунд редакционных правок макета за 5 минут.
Отзывы разработчиков в X (ранее Twitter) и на японских форумах добавляют важные нюансы к каждому преимуществу qwen 4 max. Разработчик @round_boys продемонстрировал, как модель отрисовывает полноценную 3D-сцену с использованием Java и Three.js за один проход, однако отметил, что выполнение потребовало около 69 000 токенов. Другие ранние пользователи, измерявшие «сырую» пропускную способность, сообщили о скорости потоковой передачи около 33 токенов в секунду при стандартной настройке xhigh. Они также отметили, что траектории использования инструментов с обучением с подкреплением (RL) иногда излишне усложняют простые операции чтения файлов — это напоминание о том, что суффикс -preview следует воспринимать буквально.
Ценообразование Qwen 4 Max, правила тарифного плана Token Plan и ограничения для продакшена
Если вы ищете qwen 4 max pricing в надежде найти стандартную таблицу «$X за миллион входных токенов», вы ее не найдете. Alibaba не предлагает тарификацию с оплатой по факту использования (pay-as-you-go) для qwen4-max-preview. Единственный способ отправлять запросы — это активная подписка Alibaba Cloud Model Studio Token Plan (ранее называвшаяся Coding Plan), которая тарифицируется в абстрактных ежемесячных «Кредитах», а не в долларах за токен.
На международном портале QwenCloud тарифный план Token Plan разделен на уровни для частных лиц и команд:
Тариф Lite (3 за первый месяц для новых пользователей): Включает 20 000 Кредитов в месяц, регулируется строгим скользящим лимитом в 1 200 Кредитов на 5-часовой интервал и 9 000 Кредитов в неделю.
Тариф Pro (15 за первый месяц): Включает 100 000 Кредитов в месяц с ограничением в 6 000 Кредитов на 5-часовой интервал и 45 000 Кредитов в неделю. (На внутреннем китайском портале Alibaba тарифы Lite и Pro стоят 39 юаней и 199 юаней в месяц соответственно, с акцией на первый месяц за полцены — 19,5 юаней и 99,5 юаней).
Скидка 14-дневного превью (11–25 ноября 2026 г.): В течение двухнедельного периода превью дневные вызовы (08:00–22:00 UTC+8) потребляют только 20% от стандартного веса Кредитов, а ночные вызовы в непиковое время (22:00–08:00 UTC+8) получают дополнительную скидку 80% сверх этого — снижая эффективный расход Кредитов до всего лишь 4% от обычных тарифов.
Для индивидуального разработчика, работающего в IDE по ночам за $3, такая математика выглядит очень привлекательно. Однако для инженерной команды, создающей продукт или запускающей автоматизированных CI/CD агентов, Token Plan создает три серьезных препятствия для продакшена:
Запрет на бэкенд-автоматизацию и API-интеграцию: Условия Token Plan от Alibaba прямо ограничивают использование персональных ключей Lite и Pro (sk-sp-) только интерактивным кодингом, инициируемым человеком внутри поддерживаемых плагинов IDE. Использование ключа подписки для работы автоматизированного бэкенд-скрипта, клиентской SaaS-функции или пакетного конвейера данных нарушает условия обслуживания и приводит к блокировке аккаунта.
Обязательное обучение на данных в персональных тарифах: Согласно правилам Token Plan, персональные подписки Lite и Pro по умолчанию включают все промпты, контекст репозитория и завершения моделей в программу улучшения обучения моделей Alibaba — и возможности отказаться от этого нет. Только корпоративный тариф Team Plan ($40 за место/месяц) гарантирует отсутствие хранения данных и их использования для обучения.
Скользящие 5-часовые лимиты и завершение работы 25 ноября: Даже если ваш рабочий процесс является чисто внутренним, скользящий лимит в 1 200 Кредитов на 5 часов не может покрыть всплески активности нескольких разработчиков, а эндпоинт qwen4-max-preview запланирован к закрытию 25 ноября 2026 года в 24:00 UTC+8.
Сравнение: Qwen 4 Max против Qwen 3.8 Max, Kimi K3.1 Pro, GLM-5.3 и Claude Opus 5.5
Поскольку вы не можете подключить qwen4-max-preview к промышленному бэкенду сегодня, практический вопрос, стоящий за каждым запросом на сравнение, заключается в том, какая флагманская модель с оплатой по факту использования (pay-as-you-go) справляется с той же агентной рабочей нагрузкой в 1 млн токенов контекста без привязки к подписке или риска использования данных для обучения.
| Модель |
Биллинг и доступность |
Контекстное окно |
Макс. вывод |
Поддерживаемые типы входных данных |
Тариф GPT Proto (вход / выход на 1 млн) |
Qwen4-Max-Preview (qwen4-max-preview) |
Только 14-дневная предварительная версия (заканчивается 25 ноября); подписка на план токенов ($6–$30/мес) |
1 000 000 |
393 216 (вкл. 262 тыс. CoT) |
Текст, изображение, видео |
Не хостится (нет API с оплатой по факту) |
Qwen3.8 Max 0902 (qwen3.8-max-0902) |
Промышленная оплата по факту использования |
1 000 000 |
65 536+ |
Текст, изображение, видео, аудио, документ |
4.20 (на 30% ниже официального прайс-листа) |
Kimi K3.1 Pro (kimi-k3.1-pro) |
Промышленная оплата по факту использования |
1 048 576 (1.05 млн) |
131 072 |
Текст, изображение, документ |
10.00 ($0.20 за кэшированный ввод) |
GLM-5.3 (glm-5.3) |
Промышленная оплата по факту использования |
1 050 000 (1.05 млн) |
128 000 |
Текст, изображение, документ |
3.74 (на 15% ниже официального прайс-листа) |
Claude Opus 5.5 (claude-opus-5-5) |
Промышленная оплата по факту использования |
1 000 000 |
128 000 |
Текст, изображение, документ |
18.00 (на 10% ниже официального прайс-листа) |
Qwen 4 Max против Qwen 3.8 Max
При оценке qwen 4 max vs qwen 3.8 max, компромисс заключается в выборе между временем автономной проверки и стабильностью работы в продакшене, а также поддержкой более широкого спектра модальностей. Как показал тест WEEL на лендинге (17 минут против 9,5 минут), Qwen 4 Max готов тратить вдвое больше времени на выполнение фоновых проверок Python и синтез пользовательских SVG. Однако qwen4-max-preview отказывается от нативной обработки аудио и документов в своей предварительной версии и не может быть вызван на основе оплаты за токен.
Если ваш конвейер уже опирается на форматирование промптов Alibaba, многоязычную токенизацию или мультимодальное зрение, qwen3.8-max-0902 — это готовый к продакшену флагман, который стоит выбрать сегодня. Он предлагает то же контекстное окно на 1 000 000 токенов, принимая на вход текст, изображения, видео, аудио и документы. В GPT Proto модель qwen3.8-max-0902 работает по цене 4.20 за 1 млн выходных токенов — это на 30% ниже официальной цены Alibaba, — и вы можете сравнить её с более легкими моделями с открытыми весами в хабе моделей Qwen.
Qwen 4 Max против Kimi K3.1 Pro
Сравнение qwen 4 max vs kimi k3.1 pro проводилось в тестах Blender MCP и WebGL от Silicon Star 13 ноября, и разница между двумя моделями очевидна: Qwen 4 Max мыслит как инженер-механик, а Kimi K3.1 Pro — как промышленный дизайнер.
В промпте для Blender ("Док для обслуживания орбитального мегакорабля Юпитера") и тесте глубоководных ворот WebGL ("Врата десяти тысяч приливов") модель qwen4-max-preview построила более плотные внутренние ребра жесткости, сложные стыковочные узлы и рабочий слайдер интерфейса уровня прилива, который динамически пересчитывал высоту воды и показатели давления. Тем не менее, рецензенты стабильно ставили kimi-k3.1-pro более высокие оценки за визуальную композицию, освещение шейдеров воды и гармонию цветов. Если вы создаете пользовательские интерфейсы, интерактивные 3D-веб-проекты или агентов для работы с длинными документами, которым сегодня требуется контекстное окно на 1 048 576 токенов (1,05 млн) и до 131 072 выходных токенов, Kimi K3.1 Pro доступна на GPT Proto по цене 10.00 за 1 млн выходных токенов (с учетом кэшированного ввода, цена снижается до $0.20 за 1 млн).
Qwen 4 Max против GLM-5.3
Разработчики, которые ищут qwen 4 max vs glm5.3, обычно стремятся к высокой эффективности кодинга и использования инструментов по выгодной цене. Хотя промо-акция Qwen 4 Max "Lite" за $3 в первый месяц выглядит дешево на бумаге, 5-часовой лимит кредитов и запрет на автоматизированные скрипты делают ее непригодной для работы парка фоновых агентов.
Модель glm-5.3 от Z.ai решает эту проблему через API с оплатой по факту использования. Она даже немного превосходит Qwen 4 Max по общей емкости контекста — предлагая контекстное окно 1,05 млн токенов в сочетании с лимитом вывода 128K — и принимает на вход текст, изображения и документы. По цене 3.74 за 1 млн выходных токенов на GPT Proto (на 15% ниже официального тарифа Z.ai), GLM-5.3 является наиболее экономически эффективной "рабочей лошадкой" с оплатой по мере использования для автоматизированных ботов проверки PR, маршрутизации инструментов с высокой нагрузкой и генерации кода из нескольких файлов.
Qwen 4 Max против Claude Opus 5.5
Alibaba внедрила нативную совместимость с Anthropic Messages API в qwen4-max-preview специально для разработчиков, сравнивающих qwen 4 max vs claude opus 5.5 в Claude Code. Как показал тест Python CLI от WEEL, Qwen 4 Max уже способен выполнять 12-минутный цикл исправления pytest и находить скрытые ошибки argparse и CSV-инъекций.
В чем claude-opus-5-5 сохраняет решающее преимущество, так это в эффективности траектории, скорости потоковой передачи и надежности SLA для продакшена. Тестировщики сообщества отметили, что ранняя RL-настройка Qwen 4 Max может приводить к зацикливанию на избыточных проверках оболочки со скоростью ~33 токена/с при рассуждениях уровня xhigh. Когда вы занимаетесь рефакторингом критически важных репозиториев, где недопустимы пустая трата ресурсов инструментов или обучение на данных персонального уровня, Claude Opus 5.5 обеспечивает контекстное окно 1 млн токенов и 128K выходных токенов с качественным следованием инструкциям. Через GPT Proto вы можете использовать claude-opus-5-5 по цене 18.00 за 1 млн выходных токенов — на 10% ниже официальных цен Anthropic.
Как вызывать производственные альтернативы через единый API
Если вы хотите использовать четыре флагманские модели, упомянутые выше, не управляя отдельными SDK поставщиков, окнами кредитов подписки или региональными эндпоинтами sk-sp-, GPT Proto предоставляет доступ ко всем им через единый маршрут, совместимый с OpenAI (https://gptproto.com/v1/chat/completions).
Перед тем как копировать фрагмент кода, обратите внимание на одну деталь аутентификации: как описано в нашем руководстве по аутентификации и на странице быстрого старта, всегда передавайте свой ключ в заголовке Authorization с префиксом Bearer (Authorization: Bearer $GPTPROTO_API_KEY). Ниже приведен пример из документации, показывающий, как вызвать qwen3.8-max-0902 и переключиться напрямую на glm-5.3, kimi-k3.1-pro или claude-opus-5-5, изменив всего одну строку:
curl --request POST "https://gptproto.com/v1/chat/completions" \
  --header "Authorization: Bearer $GPTPROTO_API_KEY" \
  --header "Content-Type: application/json" \
  --data '{
    "model": "qwen3.8-max-0902",
    "messages": [
      {
        "role": "user",
        "content": "Проверь этот Python CLI-парсер на наличие конфликтов флагов с отрицательными числами и рисков CSV-инъекций."
      }
    ]
  }'
import os
from openai import OpenAI

client = OpenAI(
    base_url="https://gptproto.com/v1",
    api_key=os.environ["GPTPROTO_API_KEY"],
)

# Свободно меняйте ID модели между флагманами с контекстом 1M:

# "qwen3.8-max-0902" ($1.40/$4.20) | "glm-5.3" ($1.19/$3.74)

# "kimi-k3.1-pro" ($2.00/$10.00)   | "claude-opus-5-5" ($3.60/$18.00)
response = client.chat.completions.create(
    model="qwen3.8-max-0902",
    messages=[
        {
            "role": "user",
            "content": "Проверь этот Python CLI-парсер на наличие конфликтов флагов с отрицательными числами и рисков CSV-инъекций.",
        }
    ],
)

print(response.choices[0].message.content)