A Resposta Curta: Como Você Deve Fazer Prompts para o GPT Image 2.5?
Um prompt confiável do GPT Image 2.5 nomeia o ativo primeiro, depois descreve o que deve estar visível. Se você estiver editando uma imagem, separe a alteração solicitada de tudo que deve permanecer inalterado.
Use isto como uma lista de verificação, não como uma sintaxe rígida:
Entregável


+ Assunto


+ Cena


+ Composição


+ Direção visual visível


+ Texto exato, se necessário


+ Papéis das imagens de referência, se necessário


+ Alteração solicitada, para uma edição


+ Regras de preservação


+ Exclusões
Uma geração simples pode precisar apenas dos cinco primeiros itens. Um pôster precisa de regras de texto explícitas. Uma edição de imagem precisa de um limite claro entre alterar e preservar. Várias imagens de referência precisam de papéis separados.
Não há truque secreto de formatação. O guia de prompts de imagem da OpenAI diz que prompts curtos, prosa, seções marcadas e estruturas semelhantes a JSON podem expressar a mesma intenção. Use o formato que torna o briefing mais fácil de ler, testar e revisar.
Teste 1: Como Fazer Prompts no GPT Image 2.5 para uma Foto Realista
O primeiro teste usa um conceito original de retrato editorial inspirado na fotografia de estúdio clássica: cachos castanhos, veludo bordô, renda marfim, luz direcional quente e textura de filme visível. As referências guiam apenas a direção visual; o prompt não pede ao modelo que reproduza a identidade de uma pessoa real.
As duas tentativas foram executadas no mesmo fluxo de trabalho de imagem do ChatGPT. O ChatGPT não expõe uma seed fixa nem a variante de API subjacente, então este par deve ser tratado como uma demonstração prática, e não como um benchmark determinístico. A diferença visível ainda é útil: um prompt delega quase todas as escolhas, enquanto o outro define escolhas que podem ser inspecionadas.
Tentativa A: Um Prompt Vago de Foto Realista
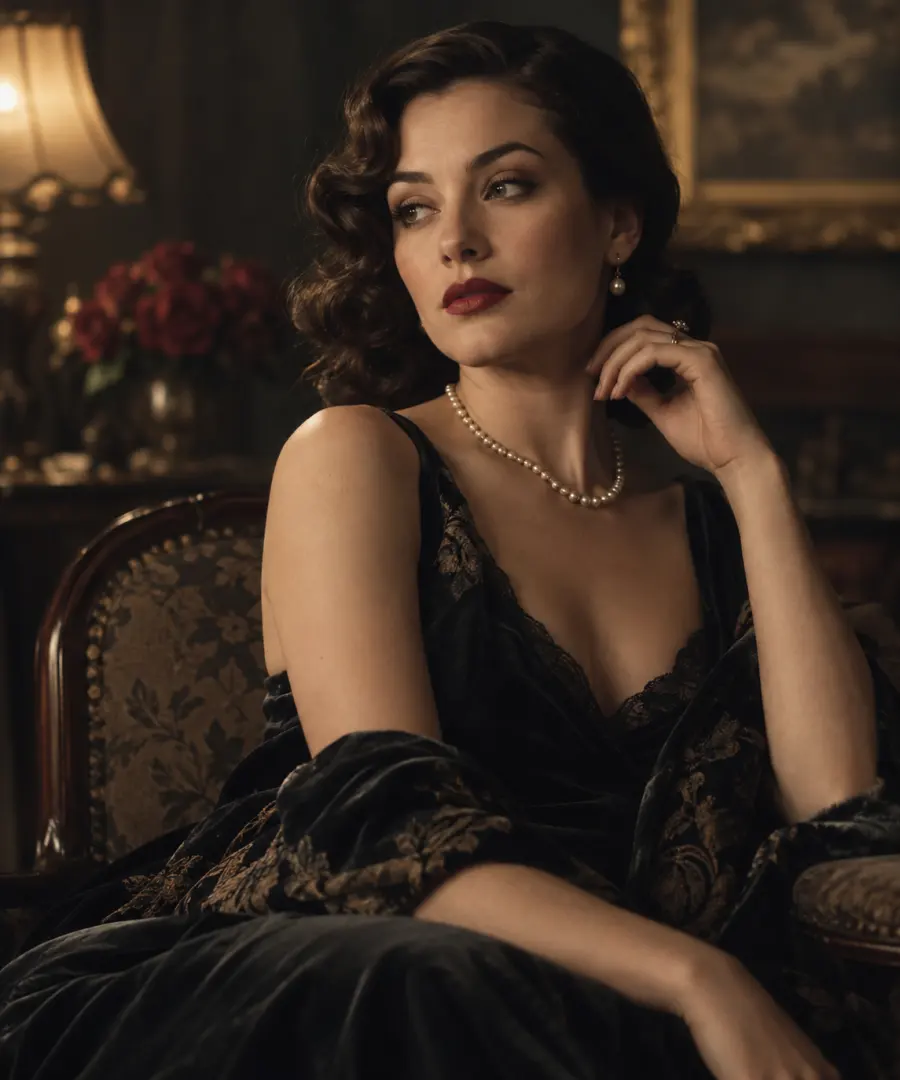
Crie um belo retrato cinematográfico de uma mulher em estilo vintage.
Este prompt identifica uma categoria ampla, mas deixa quase todas as decisões visíveis para o modelo. “Bonito”, “cinematográfico” e “vintage” não definem o enquadramento, a fonte de luz, o material, o tratamento da pele ou o fundo. A saída pode parecer polida, mas ainda assim genérica.
Tentativa B: Um Prompt com Requisitos Visíveis
Crie uma fotografia de retrato editorial vertical de uma mulher adulta com cachos castanhos na altura dos ombros.

Enquadre-a da parte superior do peito para cima, levemente virada para longe da câmera, olhando um pouco além da lente. Ela usa um vestido de veludo bordô profundo sob um véu de renda marfim.

A luz do sol quente do final da tarde passa pela renda e projeta um padrão de sombra intrincado, mas natural, em um lado do rosto, pescoço e vestido. Preserve a textura visível da pele, fios de cabelo individuais, a maciez do veludo e a estrutura fina da renda.

A fotografia deve se assemelhar a um retrato em filme 35mm cuidadosamente exposto: realces quentes, sombras neutras profundas, grão contido e um fundo de estúdio escuro e silencioso.

Sem pele com aparência plástica, suavização por filtro de beleza, retoque comercial brilhante, joias extras, texto, logotipo ou marca d'água.
O segundo prompt é mais longo porque o briefing contém mais decisões, não porque o comprimento em si melhora uma imagem. Cada frase adicionada dá a você algo visível para inspecionar.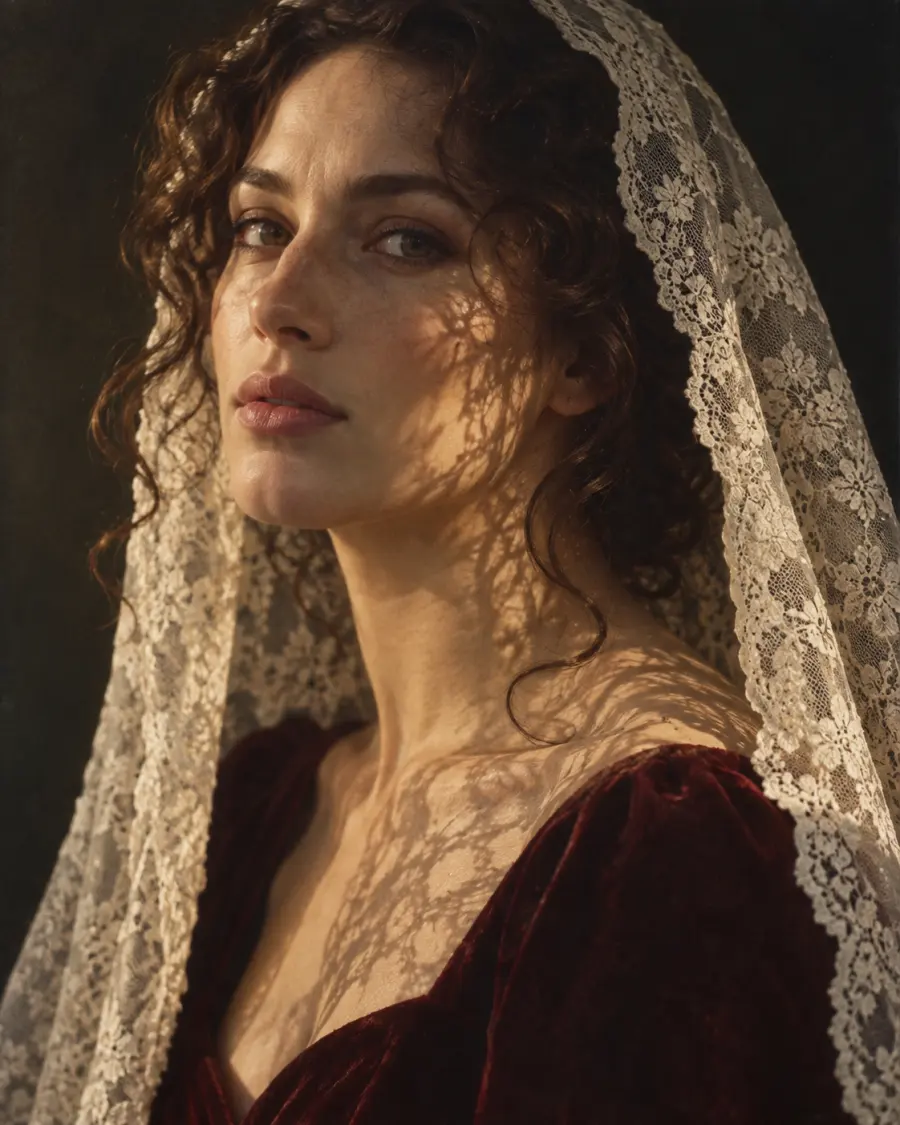
| Alteração no prompt |
O que inspecionar na saída |
| Nomeou um retrato editorial |
O resultado parece intencionalmente composto, em vez de uma foto de rosto genérica? |
| Definiu enquadramento e olhar |
O enquadramento da parte superior do peito está correto, e os olhos estão direcionados conforme solicitado? |
| Localizou a fonte de luz |
A sombra da renda segue uma direção crível? |
| Nomeou quatro texturas |
Você consegue distinguir pele, cabelo, veludo e renda? |
| Adicionou exclusões |
Há menos suavização, brilho ou decoração indesejada? |
O Que Aconteceu
A Tentativa A produziu um retrato vintage atraente, mas o modelo tomou a maioria das decisões criativas por conta própria. Ele escolheu uma composição sentada de três quartos, um vestido de renda preto, joias de pérola, um interior mobiliado e luz suave de lâmpada. Nenhuma dessas escolhas estava errada, mas elas não podiam ser previstas a partir do prompt. A imagem é lida como um retrato geral de glamour vintage, e não como o conceito editorial específico usado neste teste.
A Tentativa B seguiu o briefing solicitado muito mais de perto. O resultado usa um enquadramento de retrato fechado, cachos castanhos, um vestido de veludo bordô, um véu de renda marfim, um fundo escuro e luz direcional quente. A renda produz um padrão de sombra visível no rosto, pescoço e vestido, enquanto o veludo, a renda, o cabelo e a pele permanecem visualmente distintos. Também evita as joias e os detalhes de sala mobiliada introduzidos na Tentativa A.
O segundo resultado não é melhor apenas porque seu prompt é mais longo. Ele está mais alinhado porque o prompt define decisões visíveis. Uma limitação permanece: a sombra da renda é mais forte e dominante do que um fotógrafo escolheria, então essa instrução seria a próxima variável a suavizar.
“Fotorrealista” diz ao modelo a categoria. Instruções de enquadramento, luz, material e textura dizem a ele como esse realismo deve parecer.
Teste 2: Como Renderizar Texto Exato com o GPT Image 2.5
A geração de texto se torna mais difícil quando um pôster combina várias linhas, tamanhos de fonte diferentes e uma composição curva. Para este teste, o design é um pôster original serigrafado em azul e marfim com uma grande onda, letras arqueadas, textura de papel e três elementos de texto obrigatórios:
NORTHLINE
DESIGN AFTER DARK
SEPTEMBER 18 · 7 PM
Tentativa A: Cópia Exata sem Regras de Posicionamento
Crie um pôster serigrafado vintage em azul e branco com uma grande onda estilizada.

Inclua o texto:
NORTHLINE
DESIGN AFTER DARK
SEPTEMBER 18 · 7 PM
O texto está presente na solicitação, mas o modelo não foi informado com que frequência cada linha deve aparecer, qual linha é mais importante ou onde o texto deve ficar. Verifique erros de ortografia, palavras ausentes, texto repetido, slogans inventados e hierarquia fraca.
Tentativa B: Cite, Conte e Posicione Cada Linha
Crie um pôster de evento vintage serigrafado vertical em uma paleta de duas cores: azul cobalto profundo e marfim quente.

Composição:
Uma onda oceânica estilizada e ousada sobe diagonalmente pelo centro. A tipografia curva-se com a onda sem ficar distorcida ou difícil de ler. Use textura de papel visível, cobertura de tinta levemente imperfeita e desgaste contido nas bordas.

Renderize estes três elementos de texto exatamente uma vez cada:


1. “NORTHLINE” — nome da marca pequeno em maiúsculas no topo.


2. “DESIGN AFTER DARK” — a maior manchete, empilhada no centro e integrada à onda.


3. “SEPTEMBER 18 · 7 PM” — informação do evento menor na parte inferior.

A ortografia e a pontuação devem corresponder exatamente ao texto citado. Mantenha uma hierarquia clara entre marca, manchete e data. Não adicione, repita, abrevie, traduza ou substitua nenhuma palavra.

Nenhum outro texto, letras, logotipos, assinaturas ou marcas d'água.
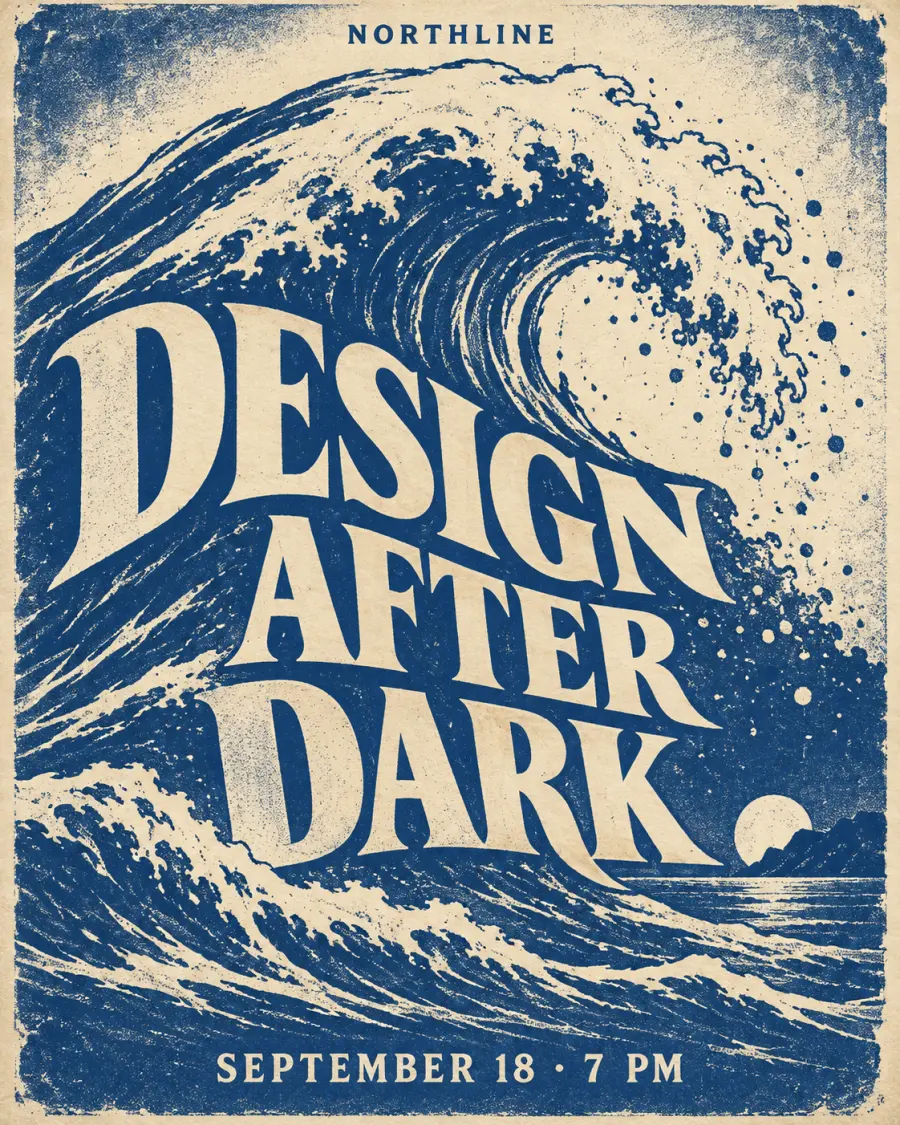
Não julgue este teste apenas por uma prévia reduzida. Registre o resultado linha por linha.
| Texto obrigatório |
Tentativa A |
Tentativa B |
NORTHLINE |
Aprovado: correto e exibido uma vez |
Aprovado: correto, exibido uma vez e colocado no topo |
DESIGN AFTER DARK |
Aprovado: correto e exibido uma vez |
Aprovado: correto, exibido uma vez e usado como a manchete central dominante |
SEPTEMBER 18 · 7 PM |
Aprovado: correto e exibido uma vez |
Aprovado: correto, exibido uma vez e colocado na parte inferior |
| Texto extra |
Nenhum observado |
Nenhum observado |
A OpenAI recomenda citar o texto obrigatório, especificar sua posição e tipografia, e pedir que não haja texto extra. Também recomenda comparar qualidade média ou alta quando o design inclui texto pequeno, informações densas ou várias fontes. Isso pode melhorar as chances, mas não é uma garantia de ortografia. Verifique cada ativo final.
Se uma linha estiver errada, edite apenas essa linha antes de regenerar o pôster inteiro. Uma correção focada dá ao modelo menos oportunidades de redesenhar partes que já eram aceitáveis.
O Que Aconteceu
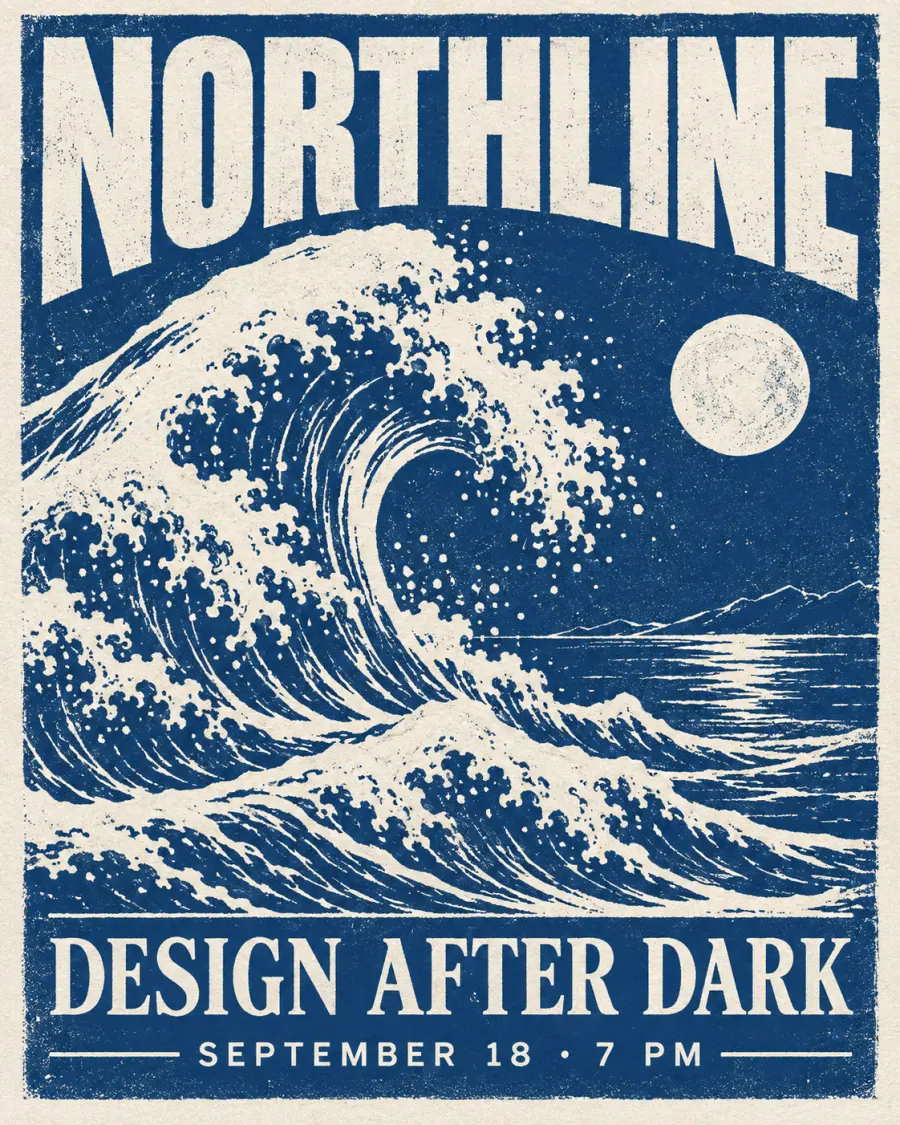
Ambas as tentativas renderizaram as três linhas corretamente, exatamente uma vez, sem texto extra. Isso importa porque este teste não fabricou uma falha de texto para o prompt mais curto. A Tentativa A já produziu um pôster utilizável com forte contraste e tipografia legível.
O prompt estruturado melhorou o controle, não a ortografia. A Tentativa B colocou NORTHLINE como uma pequena linha de marca no topo, fez de DESIGN AFTER DARK a manchete central dominante, integrou essa manchete à onda e manteve a data na parte inferior. A hierarquia está muito mais próxima do briefing escrito, embora a manchete curva seja um pouco menos fácil de escanear do que a tipografia mais reta da Tentativa A.
A lição prática não é que todo prompt de texto curto falha. Citar, contar e posicionar o texto torna os critérios de aceitação explícitos e reduz o número de decisões de layout deixadas ao acaso. A ortografia exata ainda precisa de uma verificação visual em cada saída.
Teste 3: Como Editar uma Foto sem Alterar Todo o Resto
Um bom prompt de edição descreve duas coisas: a alteração solicitada e o limite ao redor dela. Descrever apenas o novo traje dá ao modelo permissão — implicitamente — para reinterpretar o restante da fotografia.
Para este teste, primeiro crie uma imagem de origem original: duas mulheres adultas vestindo moda streetwear preta em uma ampla rua de cidade europeia, cercadas por edifícios históricos claros e luz natural fria. Use essa imagem gerada como entrada para ambas as tentativas de edição.
Tentativa A: A Edição Vaga
Mude os trajes delas para moda vintage bordô e creme.
A instrução é clara sobre a direção ampla do guarda-roupa, mas silenciosa sobre identidade, pose, cabelo, iluminação, fundo e posição da câmera. Qualquer um desses detalhes pode mudar.
Tentativa B: Separe Alterar, Preservar e Excluir
Alteração solicitada:
Substitua apenas as roupas usadas pelas duas mulheres. Vista a mulher à esquerda com uma jaqueta de veludo bordô profundo ajustada, uma blusa de seda creme e calças escuras sob medida. Vista a mulher à direita com um longo casaco de lã creme sobre uma blusa de tricô bordô e calças escuras. Ajuste cada peça naturalmente à posição e pose existentes do corpo.

Preservar:
Mantenha os rostos, identidades, tons de pele, traços faciais, penteados, expressões, proporções corporais, poses, posições das mãos e posições no enquadramento de ambas as mulheres inalterados. Preserve o ângulo original da câmera, a perspectiva da lente, o enquadramento, a rua, os edifícios, os veículos, os pedestres, a direção da luz do dia, as sombras e as dimensões da imagem.

Não adicionar:
Não adicione texto, logotipos, chapéus, joias, bolsas, pessoas extras, novos edifícios ou novos objetos de rua. Não embeleze nem retoque os rostos delas.

Saída:
Retorne uma fotografia editada fotorrealista com apenas a substituição de roupa solicitada.
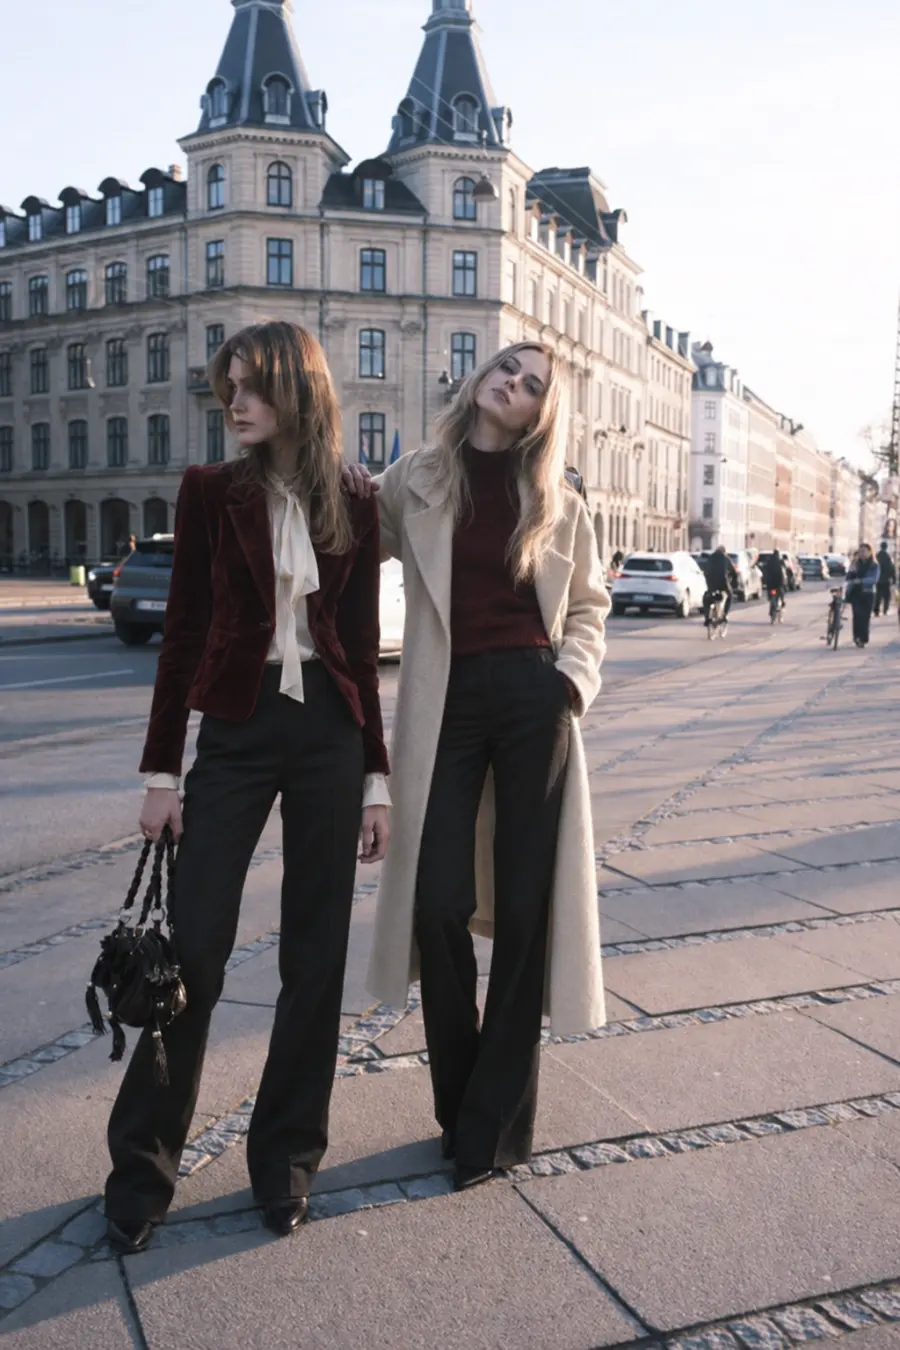
Avalie ambas as edições com a mesma lista de verificação:
| Elemento |
Edição vaga |
Edição estruturada |
| Rostos e identidade preservados |
Parcial |
Parcial, mas mais próximo da origem |
| Penteados preservados |
Parcial |
Majoritariamente preservado |
| Poses e posições das mãos preservadas |
Parcial |
Parcial; a pose principal se mantém, mas uma mão se move para dentro de um bolso do casaco |
| Roupas alteradas conforme solicitado |
Aprovado para o pedido amplo de cor e estilo |
Aprovado para as peças especificadas |
| Rua e edifícios preservados |
Parcial; vários pequenos detalhes são redesenhados |
Majoritariamente preservado, com pequenas alterações generativas |
| Iluminação e enquadramento preservados |
Parcial; a luz fica mais quente |
Majoritariamente preservado |
| Bolsa existente preservada |
Falha; ela muda de cor e design |
Falha; ela é redesenhada mesmo que apenas as roupas devessem mudar |
O Que Aconteceu
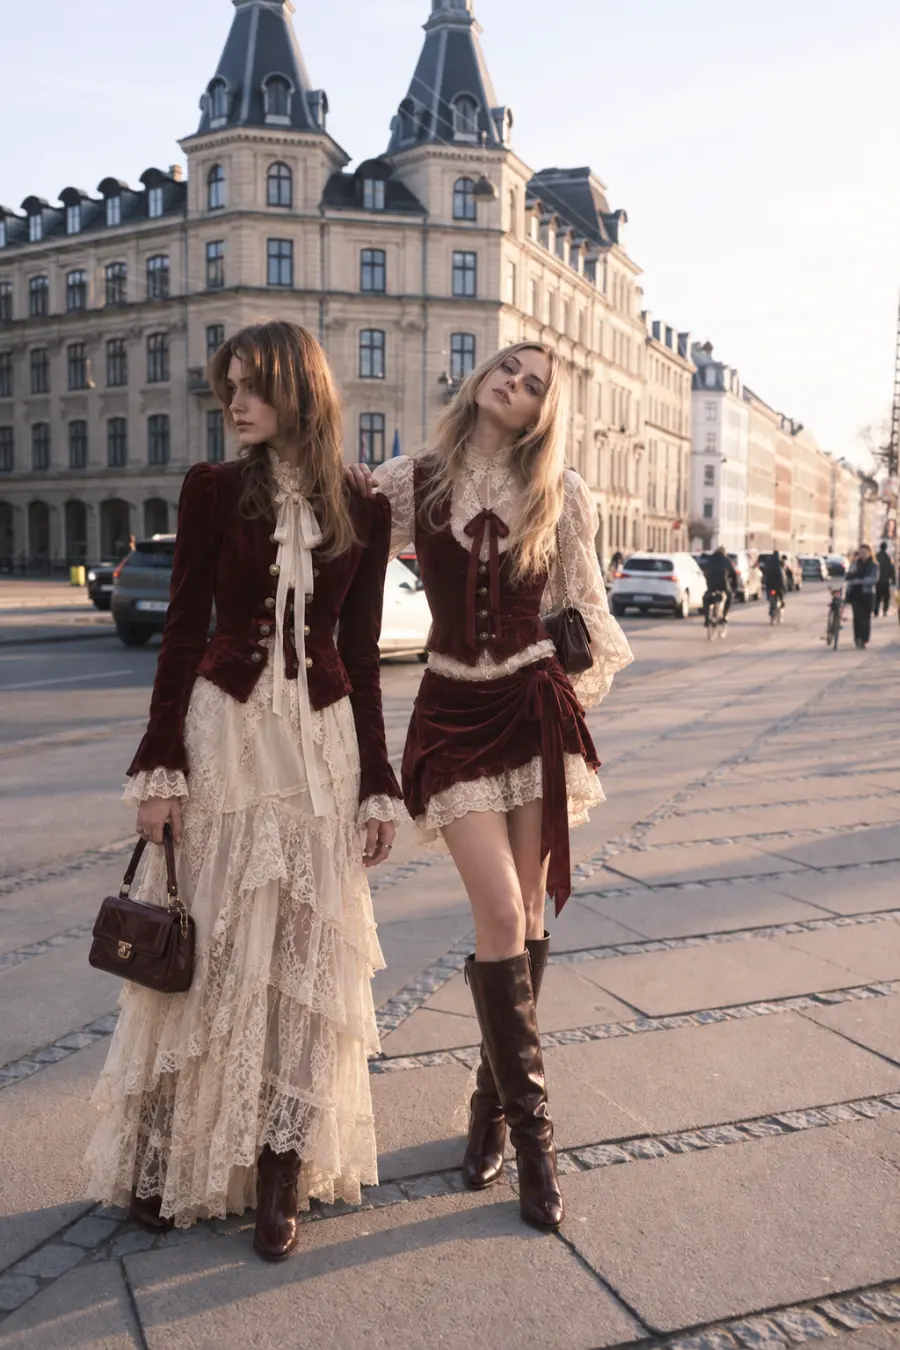
A Tentativa A satisfaz o pedido amplo, mas trata “moda vintage” como permissão para redesenhar a cena. As mulheres recebem trajes elaborados de renda e veludo, incluindo um vestido longo em camadas e um visual curto com espartilho. Suas posições gerais permanecem reconhecíveis, mas detalhes faciais, cabelo, mãos, poses da parte inferior do corpo, iluminação, tráfego, pedestres e a bolsa original todos mudam.
A Tentativa B está substancialmente mais próxima da edição solicitada. A mulher à esquerda recebe a jaqueta de veludo bordô, a blusa creme e as calças escuras; a mulher à direita recebe o casaco creme, a blusa de tricô bordô e as calças escuras. Suas posições, ângulos da cabeça, layout da rua, enquadramento e luz do dia permanecem muito mais próximos da origem.
Ainda não é uma edição que preserva pixels. A mão livre da mulher à direita se move para dentro do bolso do casaco, rostos e detalhes de fundo são regenerados, e a bolsa preta existente muda de forma, mesmo que o prompt solicite apenas uma substituição de roupa. A frase Não adicione bolsas também era ambígua demais porque a origem já continha uma. Uma correção mais clara seria: Preserve exatamente a bolsa preta existente; não a recolora, substitua, remova ou duplique.
O padrão útil é simples: Altere apenas X, seguido de uma lista concreta de preservação. A lista deve refletir o custo real de falha do ativo. Para um retrato, isso pode ser o rosto e a pose. Para uma imagem de e-commerce, pode ser a silhueta do produto, o rótulo, o texto impresso e a perspectiva da câmera.
Teste 4: Como Reduzir o Desvio em Múltiplas Edições do GPT Image 2.5
Uma edição bem-sucedida não prova que um fluxo de trabalho é estável. Detalhes podem sofrer desvio quando a saída passa por várias revisões. A OpenAI aconselha usar a saída aprovada anterior como próxima entrada, fazer uma alteração focada por rodada e repetir restrições críticas quando elas começam a se mover.
Continue a partir do resultado estruturado aprovado no Teste 3.
Rodada 1: Roupas
A Rodada 1 é a edição de guarda-roupa bordô e creme aceita do Teste 3.
Rodada 2: Adicionar Uma Bolsa
Use a imagem aprovada anterior como base.

Faça apenas esta nova alteração:
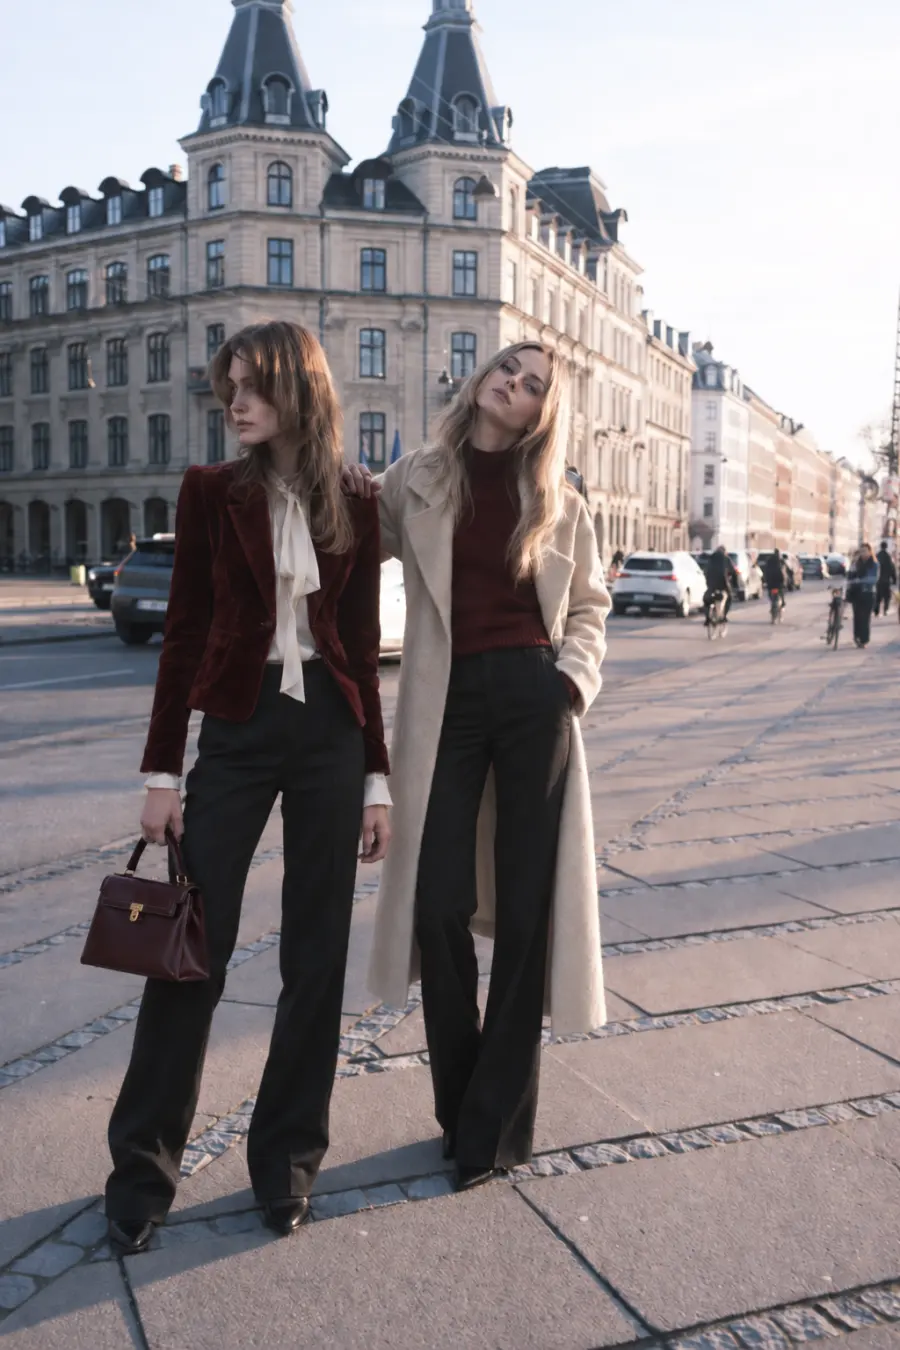
Adicione uma pequena bolsa de couro bordô estruturada à mão existente da mulher à esquerda. Combine sua escala, perspectiva, pegada, luz e sombra com a fotografia.

Preserve todos os detalhes aprovados anteriormente:
Mantenha ambos os rostos, identidades, penteados, expressões, proporções corporais, poses, posições das mãos — exceto pela pegada natural da bolsa —, roupas, cores, rua, edifícios, veículos, pedestres, ângulo da câmera, enquadramento e luz do dia inalterados.

Não adicione nenhum outro acessório, objeto, pessoa, texto, logotipo ou marca d'água.
Rodada 3: Mover a Cena para a Hora Dourada
Use a imagem aprovada anterior como base.

Faça apenas esta nova alteração:
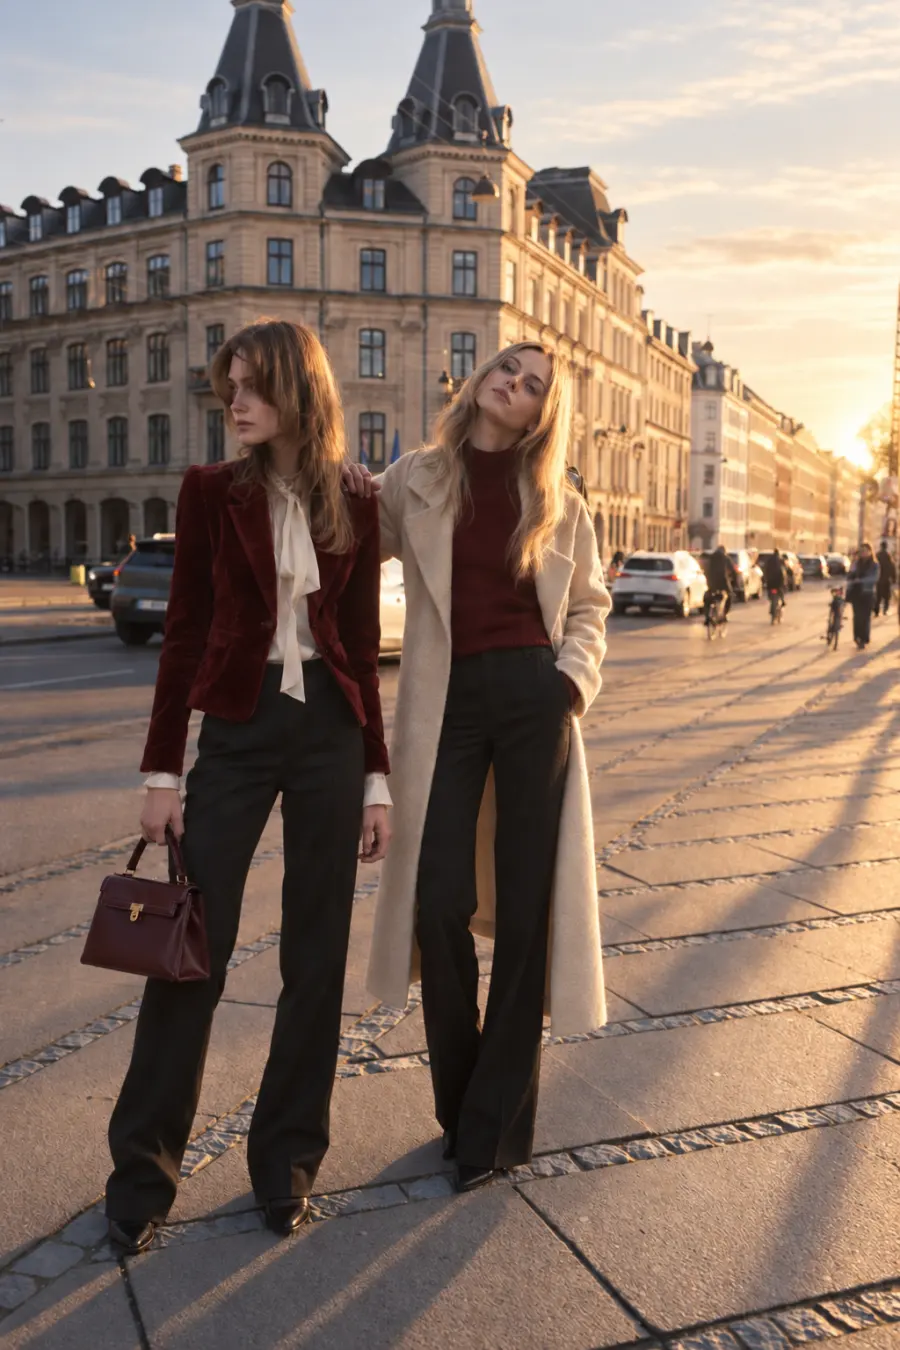
Mude a cena de luz fria de dia para luz solar quente de hora dourada no final da tarde. Deixe a luz vir da direita da câmera e criar sombras longas e críveis pelo pavimento. Mantenha o tratamento de cor natural, em vez de fortemente laranja.

Preserve todos os detalhes aprovados anteriormente:
Mantenha ambos os rostos, identidades, penteados, expressões, proporções corporais, poses, posições das mãos, roupas bordô e creme, a bolsa bordô, layout da rua, edifícios, veículos, pedestres, ângulo da câmera, perspectiva da lente, enquadramento e dimensões da imagem inalterados.

Não adicione nem remova pessoas, veículos, arquitetura, detalhes de roupa, acessórios, texto, logotipos ou marcas d'água.
 Agora compare as três rodadas, incluindo as áreas que não deveriam mudar.
| Elemento |
Rodada 1 |
Rodada 2 |
Rodada 3 |
| Rostos e identidade |
Linha de base |
Majoritariamente preservado |
Majoritariamente preservado |
| Penteados |
Linha de base |
Preservado |
Preservado |
| Roupas |
Edição de guarda-roupa aprovada |
Preservado |
Preservado |
| Pose e posição |
Linha de base |
Preservado, exceto pelo ajuste permitido na pegada |
Preservado |
| Bolsa |
Bolsa preta existente |
Alterada para uma bolsa bordô estruturada |
Preservado |
| Composição da rua |
Linha de base |
Majoritariamente preservado |
Majoritariamente preservado; iluminação e céu mudam conforme solicitado |
| Edições aprovadas anteriormente mantidas |
— |
Aprovado |
Aprovado |
O Que Aconteceu
A Rodada 2 fez uma alteração focada de acessório, mantendo as roupas aprovadas, a composição de duas pessoas, rostos, penteados, linha de edifícios e perspectiva da rua. Como a Rodada 1 já continha uma bolsa preta, o modelo a substituiu por uma bolsa bordô estruturada em vez de literalmente adicionar uma segunda. O resultado visual corresponde ao resultado pretendido de uma única bolsa, mas a instrução teria sido mais precisa como Substitua a bolsa preta existente.
A Rodada 3 moveu com sucesso a cena para a hora dourada. A luz quente entra pela direita da câmera, sombras longas cruzam o pavimento, e o tratamento permanece natural em vez de se tornar uniformemente laranja. A bolsa bordô, o guarda-roupa, as poses, o enquadramento e a arquitetura principal sobrevivem à terceira rodada.
Pequenos desvios permanecem visíveis em detalhes faciais regenerados, tráfego, pedestres, textura do pavimento e céu. Os assuntos principais e as edições aprovadas estão estáveis o suficiente para um fluxo de trabalho criativo, mas a sequência não demonstra preservação idêntica em pixels. É exatamente por isso que a saída anterior, uma alteração por rodada e regras de preservação repetidas são úteis: elas limitam o desvio sem fingir eliminá-lo.
Instruções de preservação repetidas reduzem a ambiguidade; elas não criam um bloqueio de pixels. Se um logotipo, rótulo, região do rosto ou fundo aprovado deve permanecer idêntico em pixels, faça a composição da edição aceita no ativo original em vez de depender de outra geração.
Você Deve Usar Flare ou Sunburst com Estes Prompts?
Os exemplos acima foram criados com o ChatGPT Images 2.5 na interface do ChatGPT, não com uma variante de API nomeada. Para desenvolvedores, a OpenAI expõe dois modelos de API do GPT Image 2.5. Ambos usam os mesmos princípios de prompting, então os prompts neste guia podem ser adaptados a qualquer um dos modelos.
| Fluxo de trabalho da API |
Comece com |
Por quê |
| Reescrita de prompt, prévias e variantes frequentes |
GPT Image 2.5 Flare |
É a escolha padrão orientada à velocidade para a maioria dos aplicativos de API. |
| Imagens finais sensíveis a detalhes |
GPT Image 2.5 Sunburst |
Prioriza qualidade de imagem e precisão, com tempos de geração mais longos. |
| Uma edição difícil de identidade, texto ou produto |
Flare primeiro, depois Sunburst se necessário |
Mantenha o prompt e as entradas fixos para que o modelo seja a única variável alterada. |
A OpenAI relata que o Flare pode reduzir a latência em até 50% em comparação com o GPT Image 2, mas isso não é um resultado fixo para todas as solicitações. Complexidade do prompt, imagens de referência, dimensões, configurações de qualidade e condições de tráfego afetam o tempo de resposta.
Para a distinção em nível de produto entre ChatGPT Images 2.5 e os dois modelos de API, consulte O Que É ChatGPT Images 2.5?. Para um benchmark separado de modelos, veja nossos testes reais do GPT Image 2.5 vs GPT Image 2.
O Que Vai no Prompt — e o Que Pertence aos Parâmetros da API?
Instruções de prompt descrevem a imagem. Parâmetros de solicitação controlam como o serviço a gera e a retorna. Misturar os dois pode tornar um teste difícil de reproduzir.
| Coloque no prompt |
Defina como um parâmetro da API |
| Assunto e ação |
Modelo |
| Composição e posicionamento |
Tamanho da imagem |
| Iluminação e materiais |
Nível de qualidade |
| Texto visível exato |
Modo de fundo |
| Edição solicitada |
Formato de saída |
| Regras de preservação |
Número de saídas |
| Elementos visuais indesejados |
Comportamento síncrono ou assíncrono |
Escrever “PNG transparente 4K” dentro do prompt não substitui definir tamanho, fundo e formato de saída na solicitação. Transparência é um exemplo útil: peça um assunto isolado no prompt, defina o fundo da API como transparente e retorne PNG ou WebP para que o canal alfa possa ser preservado.
O GPT Image 2.5 suporta valores de qualidade auto, low, medium, high, xhigh e max. Um rótulo mais alto não garante um resultado melhor para todos os prompts. Aprove a composição primeiro, depois teste uma alteração de qualidade por vez.
Como Testar Estes Prompts no GPT Proto
A rota mais simples é o Gerador de Imagens com IA da GPT Proto:
Faça login e abra o gerador de imagens.
Selecione GPT Image 2.5 Flare ou Sunburst.
Cole o prompt.
Faça upload da imagem original ao executar uma edição.
Mantenha o modelo, o tamanho e a qualidade fixos durante um teste A/B de prompt.
Gere a imagem e avalie-a com a lista de verificação relevante acima.
Para testes de API, a página atual do modelo GPT Proto documenta esta solicitação de texto para imagem para o Flare. Defina GPTPROTO_API_KEY em seu ambiente antes de executá-la.
curl --request POST "https://gptproto.com/api/v3/openai/gpt-image-2.5-flare/text-to-image" \
  --header "Authorization: Bearer $GPTPROTO_API_KEY" \
  --header "Content-Type: application/json" \
  --data '{
    "prompt": "Create a vertical editorial portrait photograph of an adult woman with shoulder-length chestnut curls. Frame her from the upper chest upward. Warm late-afternoon sunlight passes through an ivory lace veil and casts a natural shadow pattern across one side of her face. Preserve visible skin texture, individual hair strands, velvet texture, and fine lace detail. No text, logo, watermark, beauty-filter smoothing, or glossy commercial retouching.",
    "n": null,
    "quality": "medium",
    "size": "1024x1536",
    "enable_sync_mode": false,
    "response_format": "url"
  }'
Para testar o Sunburst, use sua página do modelo e altere o endpoint de gpt-image-2.5-flare para gpt-image-2.5-sunburst. Não compare modelos enquanto também reescreve o prompt ou altera o tamanho da imagem; você não saberá mais qual variável causou a diferença.
Quatro Modelos de Prompt do GPT Image 2.5 para Copiar e Colar
Os exemplos acima são específicos. Estes modelos foram criados para serem reutilizados. Substitua os campos entre colchetes em vez de copiar cada detalhe inalterado.
Modelo de Prompt de Foto Realista
Crie uma [orientação] [tipo de fotografia] de [assunto adulto e atributos visíveis].

Composição:
[Enquadramento, ponto de vista, corte, olhar, pose, posicionamento do assunto e espaço negativo.]

Iluminação e ambiente:
[Fonte e direção da luz], em [ambiente e hora do dia].

Detalhe visível:
Preserve [texturas de pele, cabelo, tecido, produto, superfície e ambiente].
Use [cor e tratamento fotográfico].

Evite:
Sem [estilo de retoque, objetos indesejados, texto, logotipos, marcas d'água ou artefatos visuais].
Modelo de Prompt de Pôster com Texto Exato
Crie um pôster [formato] para [público e uso].

Direção visual:
[Paleta, layout, assunto gráfico, estilo de tipografia, textura e hierarquia.]

Renderize estes elementos de texto exatamente uma vez cada:


1. “[MARCA]” — [posição e tratamento tipográfico].


2. “[MANCHETE]” — [posição e hierarquia].


3. “[TEXTO DE APOIO]” — [posição e hierarquia].

A ortografia, capitalização, números e pontuação devem corresponder exatamente ao texto citado.
Não adicione, repita, abrevie, traduza ou substitua nenhuma palavra.
Nenhum outro texto, letras, logotipos, assinaturas ou marcas d'água.
Modelo de Prompt de Edição de Imagem Controlada
Alteração solicitada:
Altere apenas [elemento alvo] para [novo requisito].

Preservar:
Mantenha [identidade, rosto, geometria do produto, pose, layout, rótulos, iluminação, sombras,
ângulo da câmera, fundo e dimensões] inalterados.

Não adicionar:
Não adicione [pessoas, objetos, texto, logotipos, acessórios ou cenário indesejados].

Saída:
Retorne [formato e uso pretendido] com apenas a alteração solicitada.
Modelo de Prompt de Edição em Vários Turnos
Use a imagem aprovada anterior como base.

Faça apenas esta nova alteração:
[Uma edição focada.]

Preserve todos os detalhes aprovados anteriormente:
[Liste a identidade, composição e edições anteriores que devem permanecer.]

Não adicione, remova ou redesenhe:
[Elementos protegidos e adições indesejadas.]
Erros Comuns de Prompt no GPT Image 2.5
| Erro |
Abordagem melhor |
| Acumular adjetivos vagos |
Descreva luz visível, material, ação e composição. |
| Tratar um prompt mais longo como automaticamente melhor |
Inclua requisitos que possam ser verificados no resultado. |
| Editar sem regras de preservação |
Separe a alteração dos detalhes protegidos. |
| Solicitar várias edições importantes de uma vez |
Faça uma alteração importante por rodada. |
| Esconder texto exato em um parágrafo |
Cite, conte e posicione cada linha obrigatória. |
Presumir que max vai reparar um briefing fraco |
Teste clareza do prompt e configurações de qualidade como variáveis separadas. |
| Reescrever o prompt enquanto muda de modelo |
Mantenha o prompt e as configurações da solicitação constantes primeiro. |
| Esperar preservação idêntica em pixels |
Use composição quando a estabilidade exata for necessária. |
Um prompt não é bem-sucedido porque soa sofisticado. Ele é bem-sucedido quando a saída passa em uma verificação de aceitação definida.
Conclusão Final
Comece nomeando a imagem de que você precisa. Descreva requisitos que possam ser vistos e verificados. Para uma edição, dê ao modelo os dois lados do limite: o que deve mudar e o que deve permanecer fixo.
Depois, altere uma variável por vez. Guarde a saída com falha, porque ela frequentemente revela a instrução ausente com mais clareza do que outra página de conselhos genéricos sobre prompts.
Teste estes prompts com o GPT Image 2.5, comece rápido com o GPT Image 2.5 Flare, ou teste o GPT Image 2.5 Sunburst quando detalhes finais e precisão de edição importarem mais do que o tempo de geração.