Introdução
Quando OpenAI lançou o GPT-Image-1 em março de 2025 como um recurso do ChatGPT, a resposta foi avassaladora. Apenas na primeira semana, mais de 130 milhões de usuários geraram mais de 700 milhões de imagens—tantas que a infraestrutura da OpenAI ficou sobrecarregada. Sam Altman publicou um tuíte famoso dizendo que as GPUs estavam "derretendo" devido à demanda sem precedentes. Em 23 de abril de 2025, a OpenAI disponibilizou o modelo por meio da API, democratizando o acesso para desenvolvedores e empresas em todo o mundo.
GPT-Image-1 representa uma mudança fundamental na tecnologia de geração de imagens. Diferentemente de modelos anteriores, como o DALL-E 3, que dependiam de uma arquitetura baseada em difusão, o GPT-Image-1 usa um design nativamente multimodal integrado à estrutura do GPT-4o. Essa escolha arquitetônica proporciona geração mais rápida, melhor adesão às instruções e capacidade de lidar com tarefas complexas de edição que antes exigiam a regeneração de imagens inteiras.
Para criadores de conteúdo, designers de produtos, equipes de marketing e desenvolvedores, o GPT-Image-1 tornou-se uma ferramenta essencial para a criação visual rápida. Este guia mostra o que torna o GPT-Image-1 especial, como usá-lo de forma eficaz, como integrá-lo ao seu fluxo de trabalho e como simplificar a implantação com plataformas avançadas como a GPT Proto AI API Platform. Seja para criar seu primeiro recurso de geração de imagens ou ampliar sistemas de produção, você encontrará estratégias práticas para ter sucesso.
Dicas: A OpenAI lançou oficialmente o GPT-Image-1.5, apenas alguns meses depois da estreia do GPT-Image-1 original, em abril de 2025. Este modelo mais recente representa um avanço significativo no competitivo cenário de geração de imagens por IA, oferecendo desempenho mais rápido, melhor seguimento de instruções e edição mais confiável do que seus antecessores.
O que exatamente é o GPT-Image-1?
O GPT-Image-1 é um transformer generativo nativamente multimodal, desenvolvido pela OpenAI, que entende texto e imagens como entradas nativas. Ele foi desenvolvido diretamente sobre a base do GPT-4o, o principal modelo multimodal da OpenAI, em vez de ser um sistema independente acoplado a um modelo de linguagem.
Essa distinção é importante. Os geradores tradicionais de imagens aceitam prompts de texto e geram imagens isoladamente. O GPT-Image-1 processa instruções de texto e imagens de referência simultaneamente dentro da mesma arquitetura de rede neural, permitindo uma compreensão mais profunda do contexto visual e resultados mais sofisticados.
A linhagem: do DALL-E ao GPT-Image-1
A jornada de geração de imagens da OpenAI evoluiu em etapas claras. O DALL-E (2021) foi pioneiro na capacidade de converter texto em imagem. O DALL-E 3 (2023) aprimorou esse recurso com melhor adesão aos prompts e mecanismos de segurança mais robustos. O GPT-Image-1 representa uma reformulação arquitetônica fundamental: em vez de tratar a geração de imagens como uma tarefa separada, ele integra a criação de imagens à estrutura multimodal mais ampla do GPT.

Essa integração significa que o GPT-Image-1 se beneficia do amplo conhecimento de mundo do GPT-4o, de uma melhor compreensão de instruções complexas e de capacidades mais fortes de raciocínio visual. O modelo entende contextos históricos, localizações geográficas, nuances culturais e conceitos do mundo real de maneiras que os modelos anteriores baseados em difusão não conseguiam igualar.
Arquitetura multimodal explicada
O GPT-Image-1 usa uma arquitetura autorregressiva, e não de difusão. Isso significa que ele gera imagens sequencialmente, prevendo tokens visuais um de cada vez, de modo semelhante à forma como os modelos de linguagem preveem palavras. Essa abordagem contrasta fortemente com os modelos de difusão, que refinam iterativamente imagens ruidosas.
O benefício prático é que os modelos autorregressivos geralmente geram imagens mais rapidamente e mantêm melhor consistência durante toda a composição. Os tokens visuais do modelo são processados por camadas de atenção que compreendem relações espaciais, harmonia de cores e integração textual desde o início da geração, e não como uma etapa posterior.
Como funciona o GPT-Image-1
Entender como o GPT-Image-1 gera imagens ajuda você a criar prompts melhores e antecipar o comportamento do modelo. O processo ocorre em etapas distintas.
A etapa de processamento da entrada
Quando você envia um prompt de texto, o GPT-Image-1 tokeniza sua descrição em linguagem natural. Isso não é uma simples extração de palavras-chave. O modelo analisa profundamente o significado semântico do prompt, identificando o assunto principal, a intenção composicional, as preferências estilísticas e as relações espaciais.
Se você fornecer uma imagem de referência, o modelo a processará por meio de embeddings de tokens visuais—uma camada especializada que converte informações visuais para o mesmo espaço de tokens do texto. Isso permite que o modelo entenda instruções como "aplique a iluminação desta referência" ou "mantenha o estilo, mas altere o assunto" com precisão impressionante.
A etapa de raciocínio visual
O modelo constrói uma representação interna do que a imagem solicitada deve conter. Ele determina:
-
Assuntos principais e secundários, além de suas relações espaciais
-
Condições de iluminação e efeitos atmosféricos (brilho da hora dourada, luz forte de estúdio, luar)
-
Estilo artístico e meio (fotorrealismo, aquarela, renderização 3D, pintura a óleo)
-
Paleta de cores e composição (regra dos terços, foco centralizado, linhas diagonais)
-
Elementos textuais e seu posicionamento, caso você tenha solicitado texto incorporado
Essa etapa utiliza extensivamente o conhecimento de mundo do GPT-4o. Se você solicitar "o interior de um speakeasy art déco dos anos 1920", o modelo compreenderá a estética histórica, o mobiliário adequado ao período e a iluminação típica daquela época—sem que você precise especificar todos os detalhes.
A etapa de geração da imagem
Em vez de refinar progressivamente o ruído, o GPT-Image-1 prevê diretamente os tokens da imagem. O modelo gera informações visuais em sequência, mantendo a consistência em toda a composição. As previsões dos tokens levam em conta as áreas geradas anteriormente, garantindo que os assuntos não mudem repentinamente de aparência durante a geração e que os layouts espaciais permaneçam coerentes.
A saída oferece três resoluções nativas: 1024×1024 (quadrada), 1024×1536 (retrato) e 1536×1024 (paisagem). Cada resolução gera uma imagem com informações visuais equivalentes—a maior densidade de pixels nos modos retrato e paisagem permite mais detalhes.
Principais recursos que definem o GPT-Image-1

Seguimento de instruções em escala
O recurso mais característico do GPT-Image-1 é sua capacidade de interpretar e executar instruções complexas e multifacetadas. Os modelos anteriores tinham dificuldade com instruções compostas, como "gere uma fotografia de uma mulher com vestido vermelho, em pé em um jardim ensolarado, segurando uma câmera vintage, com fundo em bokeh suave, fotografada com lente de 50 mm, iluminação de hora dourada e efeito de granulação de filme".
O GPT-Image-1 divide essa instrução em componentes e renderiza fielmente cada elemento. Mais impressionante ainda: quando as instruções entram em conflito, como ao solicitar simultaneamente detalhes nítidos e desfoque de movimento, o modelo interpreta sua intenção de forma inteligente, em vez de simplesmente calcular a média dos dois efeitos.
Desenvolvedores testaram esse recurso com centenas de prompts detalhados. O modelo mantém a consistência mesmo diante de instruções que especificam várias condições: quantidades exatas de objetos, intervalos precisos de cores, posicionamento espacial e requisitos de estilo simultaneamente.
Excelência na renderização de texto
Uma das tarefas historicamente mais difíceis para geradores de imagens é renderizar texto legível. Os primeiros modelos produziam rabiscos ilegíveis. O DALL-E 3 melhorou esse aspecto, mas continuou pouco confiável para textos densos.
O GPT-Image-1 se destaca nesse aspecto. Ele consegue gerar:
-
Sinalizações e rótulos legíveis com formação correta das letras
-
Capas de revistas com manchetes e títulos de artigos legíveis
-
Infográficos com texto claro e devidamente posicionado
-
Cartazes e anúncios com vários tamanhos de texto mantendo a hierarquia
-
Embalagens de produtos com texto funcional nos rótulos
O modelo entende as convenções tipográficas—sabe que os títulos devem ser maiores que o texto do corpo, que as cores do texto devem contrastar com os fundos e que a orientação do texto é importante. Para materiais de marketing, mockups de produtos e conteúdo educacional, esse recurso por si só já justifica o uso do GPT-Image-1.
Versatilidade de estilos e amplitude artística
O GPT-Image-1 gera imagens em um espectro impressionante de abordagens artísticas:
| Categoria de estilo |
Aplicações |
Uso típico |
| Fotorrealista |
Fotos de produtos, renderizações arquitetônicas, retratos |
Comércio eletrônico, imóveis, portfólios profissionais |
| Ilustração |
Aquarela, pinturas a óleo, desenhos de linha, esboços |
Publicação, editorial, belas-artes |
| Arte digital |
Renderizações 3D, arte conceitual, imagens de fantasia |
Jogos, entretenimento, protótipos de design |
| Design gráfico |
Design plano, arte em estilo vetorial, minimalismo, gráficos marcantes |
Design web, branding, redes sociais |
| Estilos fotográficos |
Film noir, vintage, HDR, documentário |
Projetos criativos, exploração artística |
| Anime e animação |
Design de personagens, imagens inspiradas no Studio Ghibli |
Tornou-se viral logo após o lançamento |
Além dos estilos estéticos, o modelo entende qualidades específicas de cada meio. "Um esboço a carvão" produz algo claramente diferente de "um desenho a lápis"—o modelo entende as características inerentes a cada meio. Essa especificidade torna o GPT-Image-1 extremamente valioso para profissionais criativos que compreendem como a escolha do material afeta os resultados visuais.
Integração do conhecimento de mundo
O GPT-Image-1 utiliza o treinamento do GPT-4o em bilhões de pares de texto e imagem para compreender contextos do mundo real. Isso permite:
-
Precisão histórica: gerar cenas adequadas a qualquer período, com detalhes autênticos
-
Autenticidade geográfica: criar paisagens com flora, arquitetura e iluminação apropriadas à região
-
Adequação cultural: gerar imagens culturalmente específicas sem estereótipos ofensivos
-
Precisão científica: criar diagramas cientificamente corretos, ilustrações anatômicas e visualizações técnicas
-
Conhecimento contemporâneo: gerar imagens incorporando tendências atuais da moda, arquitetura moderna e o contexto de acontecimentos atuais
Para casos de uso profissional—livros didáticos, materiais educacionais e conteúdo em estilo documental—esse conhecimento de mundo torna-se uma vantagem significativa sobre modelos treinados puramente em imagens, sem uma compreensão semântica profunda.
Edição e transformação multimodal de imagens
O GPT-Image-1 oferece quatro modos distintos de edição além da geração simples:
Edição de texto para imagem: descreva alterações em uma imagem existente usando linguagem natural. Em vez de regenerar a imagem inteira, o GPT-Image-1 aplica modificações direcionadas, preservando as áreas inalteradas.
Transformação de imagem para imagem: envie uma imagem e solicite uma transformação. O modelo pode alterar o estilo artístico, ajustar a composição ou reinventar o assunto, mantendo os elementos especificados por você.
Inpainting: especifique uma região, por meio de uma caixa delimitadora ou máscara, para modificar enquanto o modelo regenera apenas essa área, mantendo a coerência com o conteúdo ao redor.
Outpainting: expanda uma imagem para além de seus limites originais, ampliando a composição com conteúdo contextualmente apropriado.
Esses recursos de edição possibilitam fluxos de trabalho impossíveis com modelos de geração única. Um designer pode testar rapidamente várias versões de uma mesma imagem-base sem precisar começar do zero a cada vez.
Estrutura de preços do GPT-Image-1
Preços baseados em tokens
A OpenAI cobra pelo GPT-Image-1 usando seu sistema padrão baseado em tokens. Essa abordagem oferece transparência e escala de acordo com o uso real:
-
Tokens de entrada de texto: US$ 5 por 1 milhão de tokens (o texto do seu prompt)
-
Tokens de entrada de imagem: US$ 10 por 1 milhão de tokens (se você fornecer imagens de referência)
-
Tokens de saída de imagem: US$ 40 por 1 milhão de tokens (a imagem gerada)
Na prática, um prompt simples, com 50 a 100 tokens, contribui de forma insignificante para os custos. As imagens de saída dominam os preços, que variam conforme a resolução e as configurações de qualidade.
Detalhamento do custo por imagem
Embora os preços por token forneçam a estrutura técnica, entender os custos por imagem ajuda no planejamento do orçamento:
| Resolução |
Qualidade padrão |
Alta qualidade |
| 1024×1024 (quadrada) |
US$ 0,01 |
US$ 0,17 |
| 1024×1536 (retrato) |
US$ 0,02 |
US$ 0,26 |
| 1536×1024 (paisagem) |
US$ 0,02 |
US$ 0,26 |
A qualidade padrão atende à maioria dos casos de uso: conteúdo para redes sociais, apresentações, rascunhos e iterações. A alta qualidade justifica o preço adicional para entregas finais, impressões grandes e aplicações profissionais.
Cenários de custo no mundo real
Orçamento de um pequeno criador (10 a 20 imagens/mês)
-
Custo mensal estimado: US$ 0,50 a US$ 1,00
-
Ideal para: uso por hobby, experimentação e projetos pessoais
Fluxo de trabalho de um criador de conteúdo (100 a 200 imagens/mês)
- Mistura de qualidade padrão e alta: US$ 2 a US$ 5/mês
- Adequado para: ilustrações de blog, conteúdo para redes sociais e exploração criativa
Empresa de comércio eletrônico (5.000 imagens/mês)
-
Principalmente qualidade padrão, com saídas finais seletivas em alta qualidade: US$ 40 a US$ 60/mês
-
Casos de uso: variações de produtos, fotografia de estilo de vida e imagens para catálogos
Pipeline de produção empresarial (mais de 50.000 imagens/mês)
Como começar a usar a API do GPT-Image-1
Pré-requisitos e configuração
Para começar a usar o GPT-Image-1 programaticamente:
-
Crie uma conta na OpenAI em platform.openai.com
Verifique sua organização (obrigatório em algumas regiões)
Configure o faturamento com um método de pagamento válido
Gere uma chave de API no painel da sua conta
Armazene sua chave de API com segurança como uma variável de ambiente (nunca a inclua diretamente nos scripts)
Novas contas recebem US$ 5 em créditos gratuitos, suficientes para uma ampla experimentação—aproximadamente 500 gerações de imagens quadradas em qualidade padrão.
Padrão básico de implementação
A implementação mais simples requer apenas algumas linhas de código. Veja o padrão essencial usando Python:
import requests
import json
api_key = "your-api-key-here"
headers = {
"Authorization": f"Bearer {api_key}",
"Content-Type": "application/json"
}
payload = {
"model": "gpt-image-1",
"prompt": "A serene mountain landscape at sunrise, misty valleys, golden light, oil painting style",
"size": "1024x1024",
"quality": "standard",
"n": 1
}
response = requests.post(
"https://api.openai.com/v1/images/generations",
headers=headers,
json=payload
)
result = response.json()
image_url = result['data'][0]['url']
print(f"Generated image: {image_url}")
A API retorna URLs para as imagens geradas, válidas por 60 dias. Baixe e armazene as imagens permanentemente se planejar usá-las após esse período.
Engenharia de prompts para obter melhores resultados
Prompts eficazes seguem uma estrutura consistente que fornece contexto sem sobrecarregar o modelo:
Estrutura: [Assunto] + [Cenário/Contexto] + [Estilo/Meio] + [Iluminação/Humor] + [Detalhes técnicos]
Prompt fraco: "Um gato"
Prompt eficaz: "Um gato malhado laranja e peludo sentado atentamente sobre um mourão de madeira, cenário rural, luz da tarde nublada, fotografia profissional de vida selvagem, profundidade de campo rasa, cores naturais"
Práticas essenciais:
-
Seja específico sobre quantidades: "Três maçãs", não "algumas maçãs"
-
Descreva as relações espaciais: "No lado esquerdo", "ao fundo", "ao redor do assunto"
-
Especifique a iluminação explicitamente: em vez de uma "boa iluminação" vaga, descreva "luz quente da hora dourada" ou "luar azul e frio"
-
Mencione referências artísticas: "No estilo do Studio Ghibli" ou "como uma pintura renascentista" oferece uma orientação mais forte do que um termo genérico como "artístico"
-
Mencione termos técnicos de fotografia quando apropriado: "Fotografado com lente de 85 mm", "profundidade de campo cinematográfica", "gradação de cores RAW"
Dica profissional: prompts mais longos, de 200 a 500 tokens, normalmente produzem resultados mais detalhados do que descrições minimalistas. O modelo é excelente na interpretação de especificações detalhadas e raramente ignora instruções bem articuladas.
GPT-Image-1 vs. soluções concorrentes
GPT-Image-1 vs. DALL-E 3
Embora o DALL-E 3 continue funcional, o GPT-Image-1 o supera em praticamente todos os aspectos:
| Dimensão |
DALL-E 3 |
GPT-Image-1 |
Vencedor |
| Arquitetura |
Baseada em difusão |
Autorregressiva/Multimodal |
GPT-Image-1 |
| Renderização de texto |
Limitada e pouco confiável |
Excelente, pronta para produção |
GPT-Image-1 |
| Velocidade de geração |
Moderada (20 a 30 s normalmente) |
Mais rápida (10 a 20 s normalmente) |
GPT-Image-1 |
| Precisão da edição |
Fraca (requer regeneração) |
Excelente (edições direcionadas) |
GPT-Image-1 |
| Seguimento de instruções |
Bom |
Superior |
GPT-Image-1 |
| Integração do conhecimento de mundo |
Limitada |
Ampla (baseada no GPT-4o) |
GPT-Image-1 |
| Preço da API |
US$ 0,02 a US$ 0,20 por imagem |
US$ 0,01 a US$ 0,17 por imagem |
GPT-Image-1 |
Para projetos novos, o GPT-Image-1 é a escolha recomendada. O DALL-E 3 continua disponível para aplicações legadas ou requisitos estéticos específicos, mas o foco do desenvolvimento mudou totalmente para o GPT-Image-1.
GPT-Image-1 vs. Midjourney
O Midjourney se destaca pela estética artística e pela exploração orientada pela comunidade. Ele produz imagens com uma qualidade distinta, frequentemente etérea, que atrai artistas digitais e profissionais criativos. Sua interface baseada no Discord promove uma comunidade ativa de criadores.
O GPT-Image-1 prioriza aspectos diferentes: integração com API, confiabilidade em produção, adesão às instruções e implantação empresarial. Ele é determinístico, oferece resultados consistentes a partir de prompts idênticos, inclui mecanismos robustos de segurança e integra-se perfeitamente a aplicações.
Escolha o Midjourney se: você prioriza flexibilidade artística, exploração comunitária e variedade estética.
Escolha o GPT-Image-1 se: você precisa de integração programática, precisão no seguimento de instruções, confiabilidade em produção e renderização de texto.
GPT-Image-1 vs. Imagen 3 e Nano Banana Pro do Google
O Google lançou o Imagen 3, um modelo baseado em difusão que enfatiza resultados fotorrealistas e controle refinado da iluminação. Ele está disponível nas plataformas Gemini e Vertex AI do Google.
O Nano Banana Pro, a mais recente versão do Google, combina geração baseada em difusão com recursos de edição de pós-produção, oferecendo capacidades competitivas de iteração.
A resposta da OpenAI: a base multimodal do GPT-Image-1 oferece vantagens na compreensão semântica e na integração do conhecimento de mundo que os modelos puramente baseados em difusão têm dificuldade de igualar. Sua disponibilidade de API em várias plataformas (OpenAI, Azure e provedores de AI API terceirizados) supera a distribuição mais limitada do Imagen.
Dicas: para conhecer mais diferenças, leia GPT Image vs Nano Banana.
Limitações e considerações conhecidas do GPT-Image-1
Limitações técnicas atuais
O GPT-Image-1 apresenta melhor desempenho com assuntos únicos e composição clara. Cenas complexas, com muitos objetos ou vários assuntos interagindo, às vezes apresentam inconsistências. O modelo ainda enfrenta dificuldades com:
-
Vários rostos humanos: gerar cenas com várias pessoas pode produzir estruturas faciais inconsistentes
-
Posições complexas das mãos: as mãos continuam notoriamente difíceis, um desafio para todos os modelos de geração de imagens
-
Textos pequenos e detalhados: embora a renderização de texto seja excelente, textos extremamente pequenos em layouts densos podem exigir iterações
-
Logotipos de marcas extremamente específicos: o modelo evita reproduzir precisamente conteúdo protegido por direitos autorais
Vieses conhecidos de cor e estilo
A análise das saídas do GPT-Image-1 revela características sutis:
-
Um leve viés para cores quentes em muitas saídas, afetando algumas fotografias de paisagens e retratos
-
Recorte prematuro da composição em algumas configurações, geralmente resolvido no GPT-Image-1.5
-
Dificuldades ocasionais com estilos artísticos específicos que possuem poucos exemplos no treinamento
Essas limitações não são falhas, mas áreas que exigem ajustes no prompt ou refinamento iterativo. A maioria dos fluxos de produção envolve de 2 a 3 iterações; portanto, entender esses vieses ajuda você a criar prompts mais eficazes.
Integração avançada do GPT-Image-1 com o GPT Proto
Para desenvolvedores e empresas que desejam integrar recursos de IA de ponta, o GPT Proto oferece uma solução abrangente que vai além da geração de imagens. Essa poderosa plataforma fornece acesso aos modelos de IA mais recentes, incluindo suporte a variantes do ChatGPT 4.1, como gpt-4.1, gpt-4.1-nano e gpt-4.1-mini.
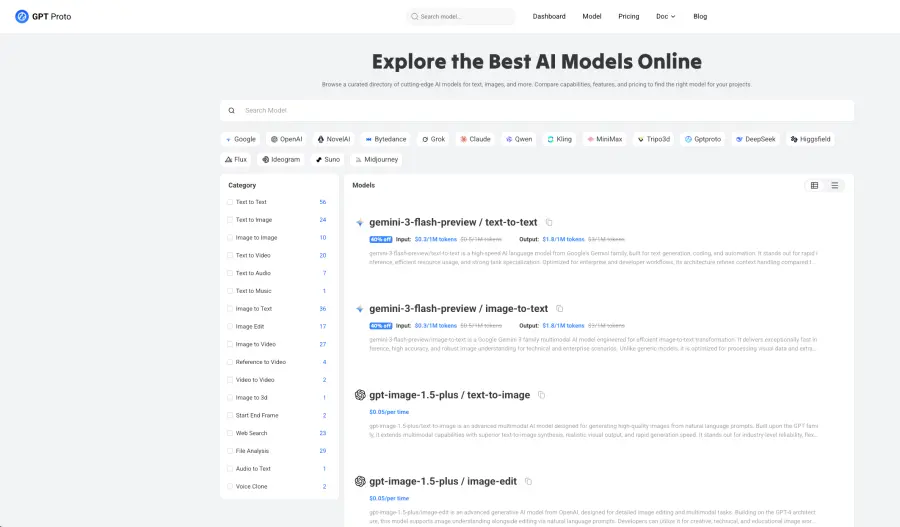
O GPT Proto funciona como uma plataforma unificada de API de IA que conecta você aos modelos de IA mais avançados do mundo, tudo em um só lugar. Em vez de gerenciar vários provedores de API, você pode acessar GPT, Claude, Gemini, Midjourney e outros modelos líderes por meio de um único serviço com pagamento conforme o uso.
Criada por desenvolvedores para desenvolvedores, a plataforma oferece APIs limpas e bem documentadas que tornam a integração simples, seja para criar aplicações ou testar protótipos. Com endpoints de API distribuídos globalmente e altamente otimizados, suas aplicações mantêm tempos de resposta rápidos para gerar texto, imagens, música ou vídeo.
A plataforma adiciona continuamente os modelos mais recentes, como Grok, Runway e Kling, garantindo que você permaneça na vanguarda sem trocar de plataforma. Como um agregador de modelos de IA, o GPT Proto recebe feedback de desenvolvedores e equipes independentes para orientar seu roadmap e construir uma comunidade que amplia os limites das possibilidades da IA.
Conclusão
O GPT-Image-1 representa uma mudança de paradigma na geração de imagens com IA, combinando uma arquitetura multimodal avançada com confiabilidade de nível empresarial para fornecer resultados fotorrealistas e artisticamente diversificados em escala. Desde sua renderização superior de texto e capacidade de seguir instruções até seus preços flexíveis e integração perfeita com APIs, o GPT-Image-1 permite que criadores de conteúdo, empresas e desenvolvedores simplifiquem os fluxos de criação visual mantendo a consistência em produção. Seja para gerar materiais de marketing, mockups de produtos, conteúdo educacional ou explorar possibilidades criativas, o design multimodal nativo do GPT-Image-1, a integração do conhecimento de mundo e os recursos de edição iterativa fazem dele a escolha definitiva para profissionais que buscam precisão, escalabilidade e implantação visual rápida. Para equipes que procuram uma plataforma unificada de IA que consolide o acesso ao GPT-Image-1 e a outros modelos líderes, o GPT Proto AI API oferece uma solução abrangente com endpoints de API otimizados, integração simplificada e implantação econômica—permitindo que desenvolvedores ampliem os fluxos de geração de imagens sem gerenciar vários provedores de serviços, tornando-a uma escolha de infraestrutura valiosa para empresas que desenvolvem aplicações de IA de próxima geração em 2026 e além.