Come abbiamo classificato i modelli per SillyTavern
La prova principale è il September 2026 AI Roleplay Bench, che ha testato 14 modelli ufficiali in 10 categorie e ha valutato 840 risposte. Le sue categorie coprono chat di compagnia, comportamento da Game Master, voce del personaggio rigorosa, cattivi, robustezza, temi maturi e limiti di sicurezza. Kimi K3, GLM-5.3 e DeepSeek V4.1 Flash sono separati da meno di due punti, quindi il benchmark stesso consiglia di considerarli come un pareggio effettivo piuttosto che trattare un decimale come una vittoria decisiva.
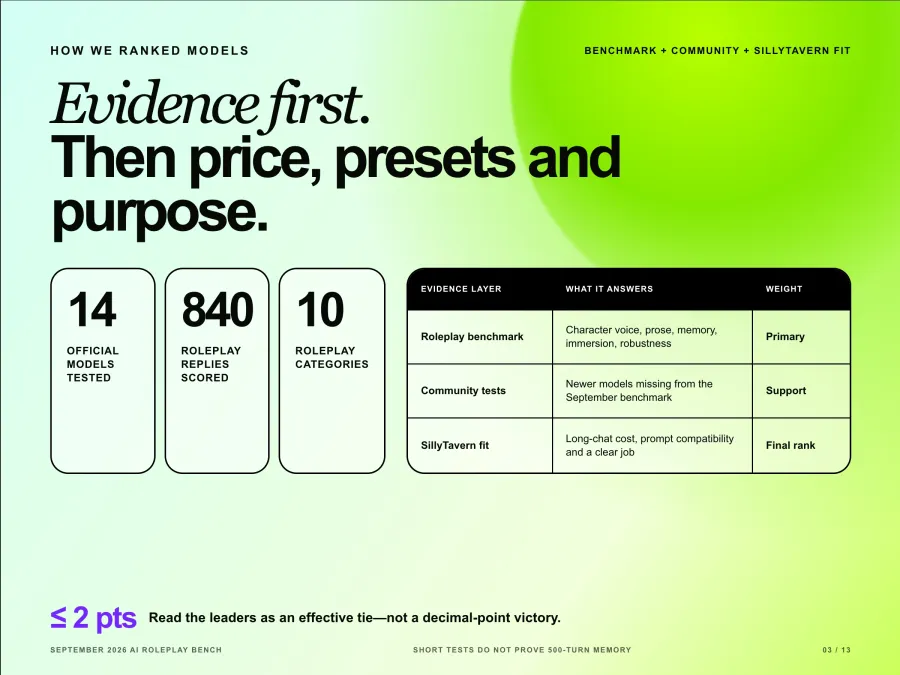
Il benchmark ha anche dei limiti. La sua metodologia pubblicata utilizza brevi scenari a più turni, non misura la deriva nel corso di centinaia di messaggi ed esclude i fine-tune della community. Versioni più recenti come Gemini 4 Argon sono arrivate dopo quel test. Per quei modelli, utilizzo i confronti della community come prova a supporto e contrassegno la raccomandazione come meno certa.
La classifica finale aggiunge tre fattori specifici per SillyTavern:
Economia delle chat lunghe. I token di input solitamente dominano i turni successivi perché SillyTavern invia nuovamente la scheda del personaggio, le istruzioni, la lore pertinente e la cronologia della conversazione.
Compatibilità con prompt e preset. Chat Completion, Text Completion, template di istruzioni, sampler e controlli di ragionamento non sono intercambiabili.
Un compito chiaro per ogni modello. Un modello più economico guadagna un posto solo se ha un ruolo utile, non semplicemente perché il suo prezzo è basso.
Gli 8 migliori modelli AI per il gioco di ruolo su SillyTavern
1 Kimi K3 Miglior modello SillyTavern in assoluto
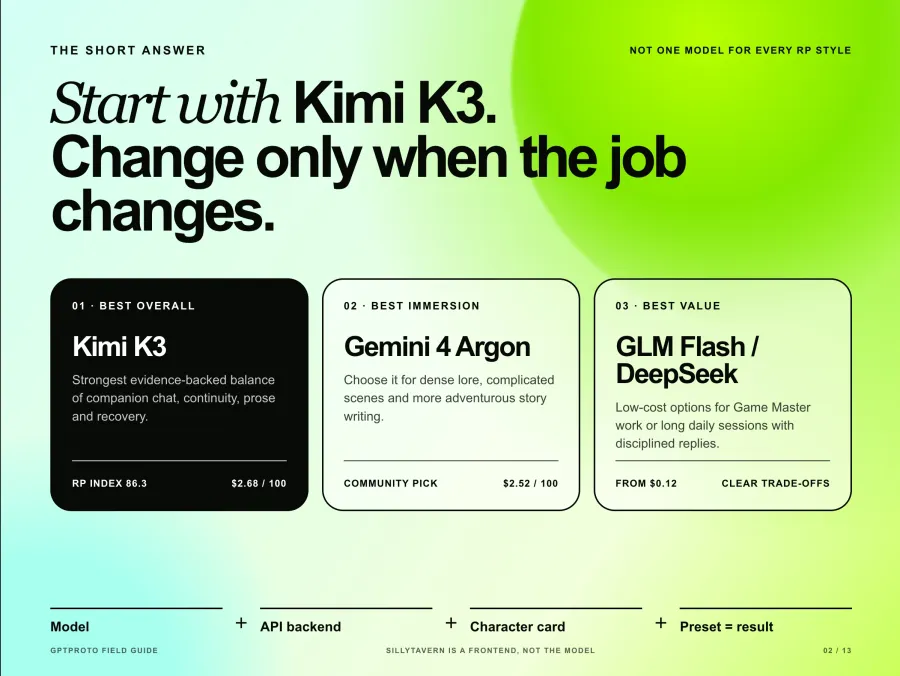
Kimi K3 è la prima scelta più sicura quando non sai ancora quale stile di gioco di ruolo preferisci. Ha ottenuto un punteggio di 86,3 complessivo, 90,0 per la Compagnia e 88,3 per la Robustezza nel benchmark di gioco di ruolo. Ha anche guidato le valutazioni del benchmark per personaggio, prosa, memoria e immersione.
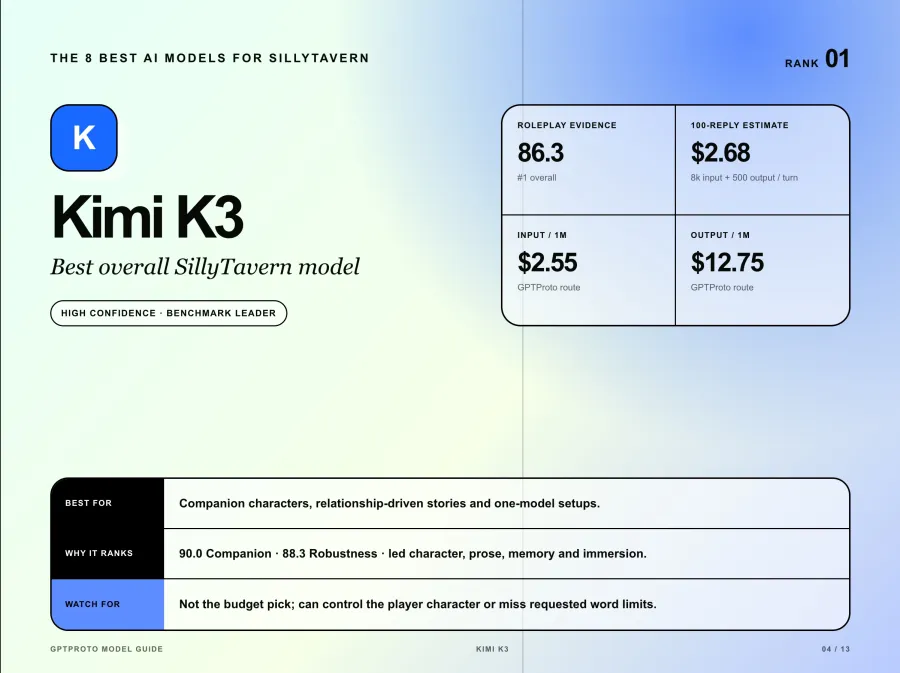
Questo equilibrio conta più in SillyTavern che una singola risposta appariscente. Kimi ha gestito i messaggi dell'utente composti da una sola parola, ha ricordato i dettagli inseriti e ha mantenuto il personaggio attivo invece di trasformarsi in un assistente generico. I suoi punti deboli erano concreti: a volte controllava il personaggio del giocatore come Game Master e mancava i limiti di parole richiesti.
Ideale per: personaggi di compagnia, storie basate sulle relazioni e utenti che desiderano un unico modello per diversi stili di RP. Punto di partenza per SillyTavern: usa Chat Completion, l'ID modello esatto kimi-k3 e una lunghezza di risposta moderata prima di aggiungere regole di preset più complesse. A 2,55 $ per l'input e 12,75 $ per l'output per milione di token, non è la scelta economica.
2 Gemini 4 Argon: Il migliore per il gioco di ruolo immersivo
Gemini 4 Argon è il preferito dalla community più recente e solido per lore densa, scene complesse e scrittura di storie lunghe. Gli utenti di SillyTavern ne hanno lodato la precisione con prompt estesi e la capacità di aggiungere dettagli utili alla scena invece di limitarsi a parafrasare la scheda del personaggio. Una dettagliata discussione della community sull'uso per storie lunghe ha descritto un netto miglioramento dopo che la stessa storia era diventata ripetitiva su altri modelli.
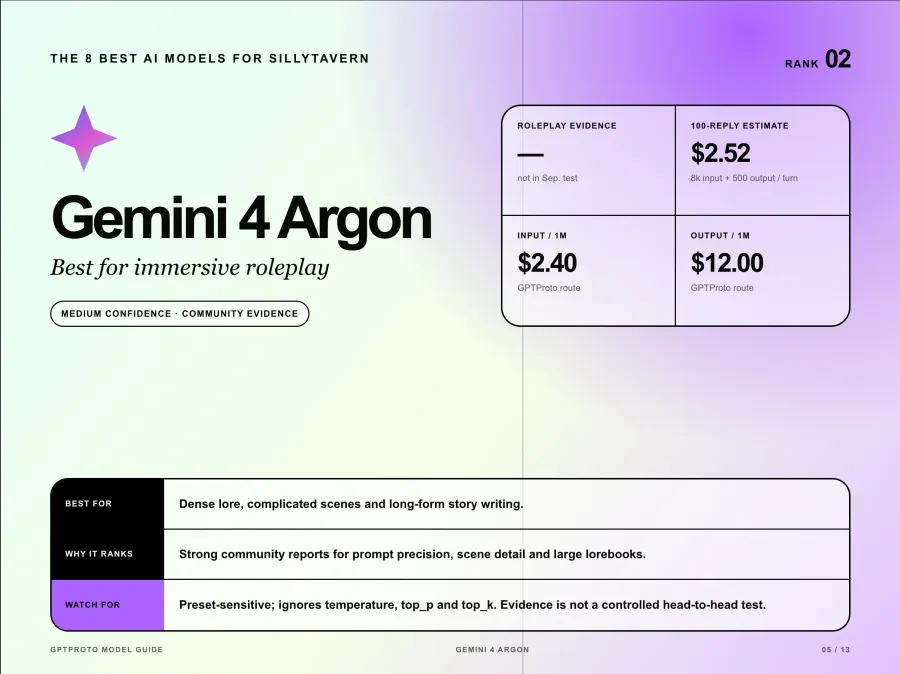
Il livello di confidenza è inferiore rispetto a Kimi o GLM perché Argon non era incluso nel benchmark di gioco di ruolo di settembre. L'entusiasmo della community è un segnale, ma non si tratta di un test comparativo controllato.
Argon richiede inoltre un proprio preset. La sua API ignora temperature, top_p e top_k; pertanto, copiare un vecchio preset Gemini basato sul campionamento crea l'illusione di un controllo senza modificare effettivamente tali valori. Inizia con un livello di riflessione medio per le chat uno-a-uno con i personaggi e prova la riflessione alta solo per GDR ricchi di regole o lorebook estesi. Il lato negativo è il costo: le sue tariffe di 2,40 $ in input e 12 $ in output portano un test fisso di 100 risposte a circa 2,52 $ prima che la cronologia si espanda.
3 GLM 5.3: Il miglior modello bilanciato per la narrazione
GLM-5.3 è l'alternativa più convincente a Kimi K3 quando desideri che il modello guidi maggiormente la storia. Ha ottenuto un punteggio di 85,1 complessivo, 92,5 per la voce rigorosa e 85,8 per la robustezza. Il benchmark lo descrive come particolarmente efficace per il gioco di ruolo basato sulla storia, la narrativa dark e i bot di avventura.
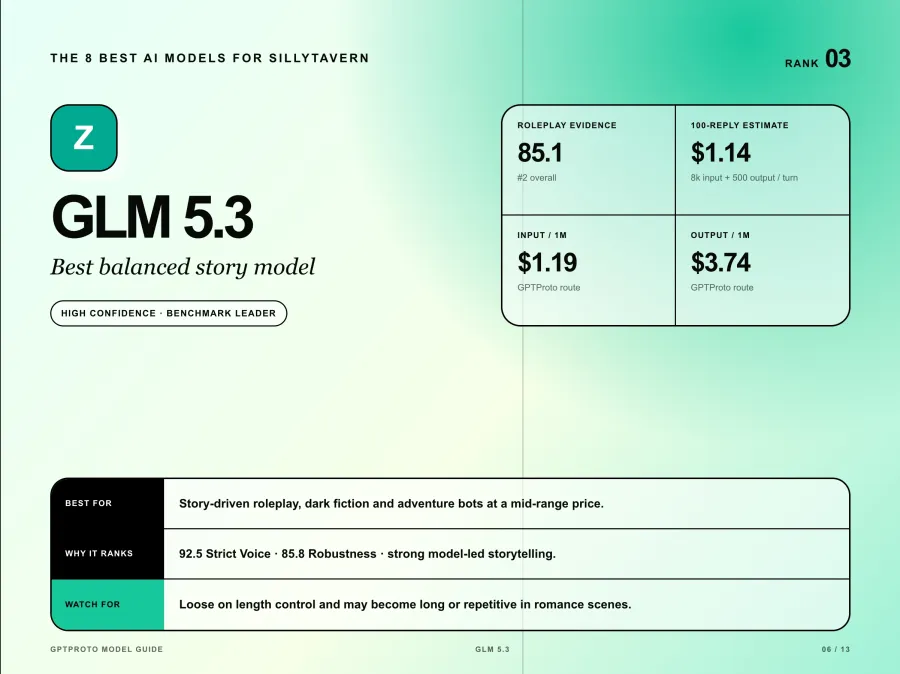
Il compromesso è il controllo sulla lunghezza e sul ritmo. GLM-5.3 è stato il modello principale meno rigoroso sui limiti di parole e ha ottenuto risultati decisamente peggiori nello scenario romantico del benchmark, dove le risposte sono diventate lunghe e ripetitive. Una lunghezza massima di risposta rigorosa e una chiara istruzione post-cronologia aiutano, ma non garantiscono un output conciso.
A 1,19 $ per l'input e 3,74 $ per l'output per milione di token, GLM-5.3 costa meno della metà di Kimi K3 nell'esempio fisso di 100 risposte. Usa l'ID modello glm-5.3. È un'impostazione predefinita sensata per gli utenti che desiderano una qualità di gioco di ruolo elevata senza pagare le tariffe dei modelli premium a ogni turno.
4 DeepSeek V4.1 Flash: Il migliore per sessioni lunghe ed economiche
DeepSeek V4.1 Flash offre il miglior rapporto qualità-prezzo dell'intera lista. Ha ottenuto un punteggio complessivo di 84,4, è rimasto entro il limite di parole in tutte le 28 risposte di gioco di ruolo principali su 28 e ha raggiunto il primo posto a pari merito nella categoria Villain. Le sue tariffe di $0,24 in input e $0,96 in output portano l'esempio fisso di 100 risposte a circa $0,24.
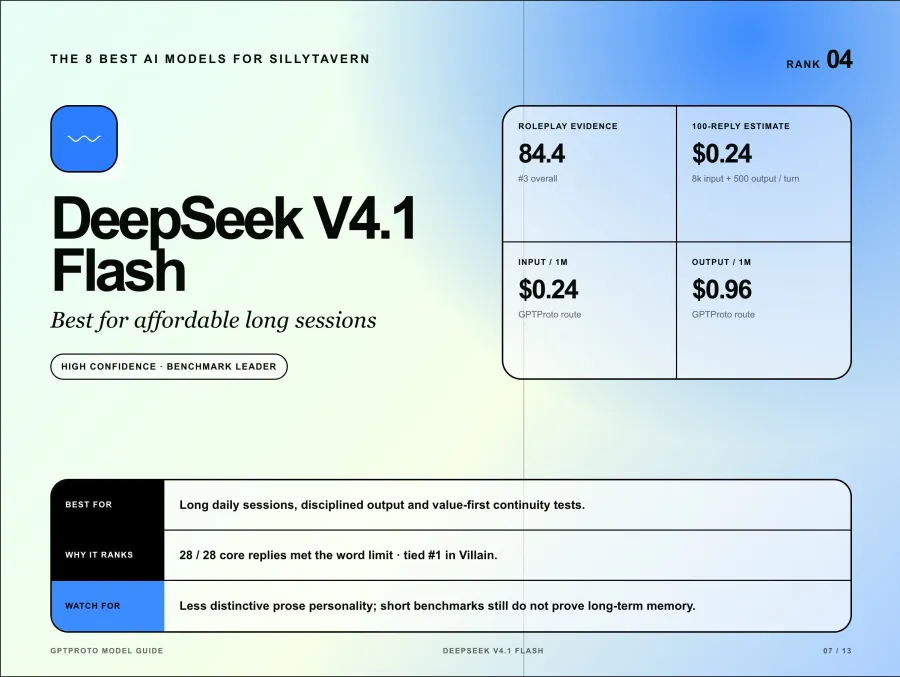
Il modello è meno distintivo come stile di prosa rispetto a Kimi, Argon o Opus. Questo può essere un vantaggio quando la scheda del personaggio contiene già una voce forte: il modello ha meno probabilità di sovrascriverla con il proprio stile predefinito. È utile anche quando prevedi lunghe sessioni quotidiane e vuoi riservare un modello più costoso per le scene cruciali.
Usa deepseek-flash in SillyTavern. A mio giudizio, questo è il miglior test di valore iniziale per chat a lungo termine, ma il benchmark ha comunque utilizzato scenari brevi. Dovresti eseguire il tuo test di continuità di 30-50 turni prima di considerare il suo prezzo basso come prova di una memoria a lungo termine affidabile.
5 GLM 5.3 Flash: Il miglior Game Master economico
GLM-5.3 Flash è lo specialista del risparmio. Ha ottenuto un punteggio di 89,2 come Game Master e 98,3 per la fedeltà alla voce (Strict Voice), il punteggio singolo più alto nel benchmark di settembre. Con $0,1275 in input e $0,425 in output per milione di token, l'esempio fisso di 100 risposte costa circa $0,12.
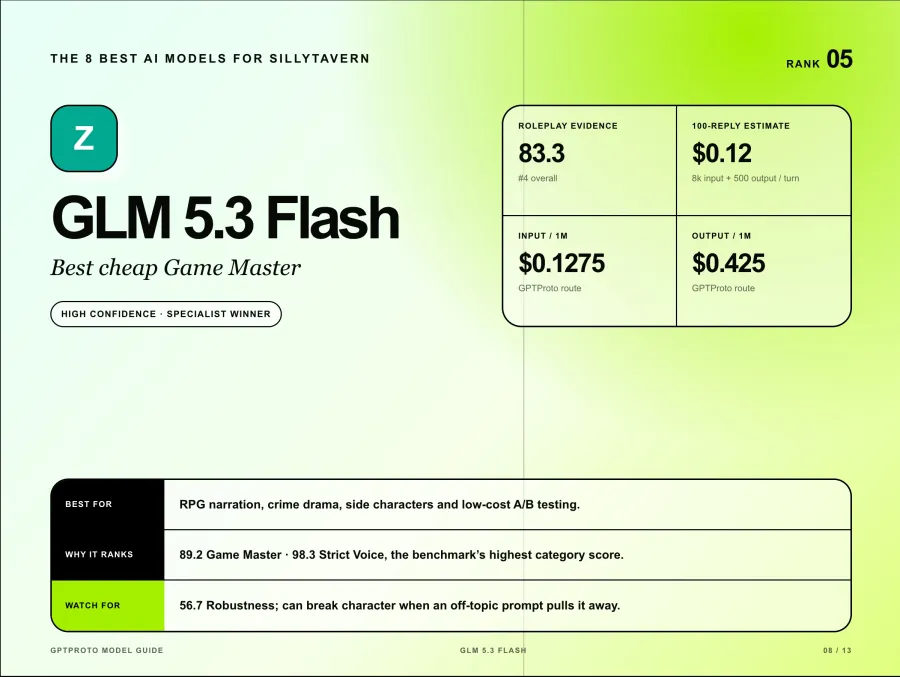
Il suo punto debole è altrettanto importante. GLM-5.3 Flash ha ottenuto solo 56,7 per la robustezza dopo aver interrotto il personaggio per rispondere a una richiesta fuori tema come un assistente generico. Ha anche mancato più limiti di parole nelle risposte di gioco di ruolo rispetto agli altri leader.
Sceglilo per la narrazione RPG, i drammi polizieschi, i personaggi secondari o per test A/B economici. Non dare per scontato che il prezzo basso lo renda il miglior modello per i compagni di chat. In SillyTavern, tieni le regole del personaggio vicino alla fine del prompt e testa tentativi deliberati di deragliamento prima di impegnarti in una chat lunga. L'ID del modello è glm-5.3-flash.
6 Gemini 3.8 Flash: Il miglior modello veloce per l'uso quotidiano
Gemini 3.8 Flash merita un posto di rilievo in questa lista, piuttosto che una semplice menzione. Un recente benchmark della community di roleplay ha testato fino a 64 risposte per modello in otto capitoli, assegnando a Gemini 3.8 Flash un punteggio di qualità di 91,9. Quel test ha pesato la preferenza di scrittura al 75 percento e la robustezza al 25 percento. È una prova utile, ma il suo punteggio non è direttamente confrontabile con l'AI Roleplay Bench perché i prompt e il metodo di punteggio differiscono.
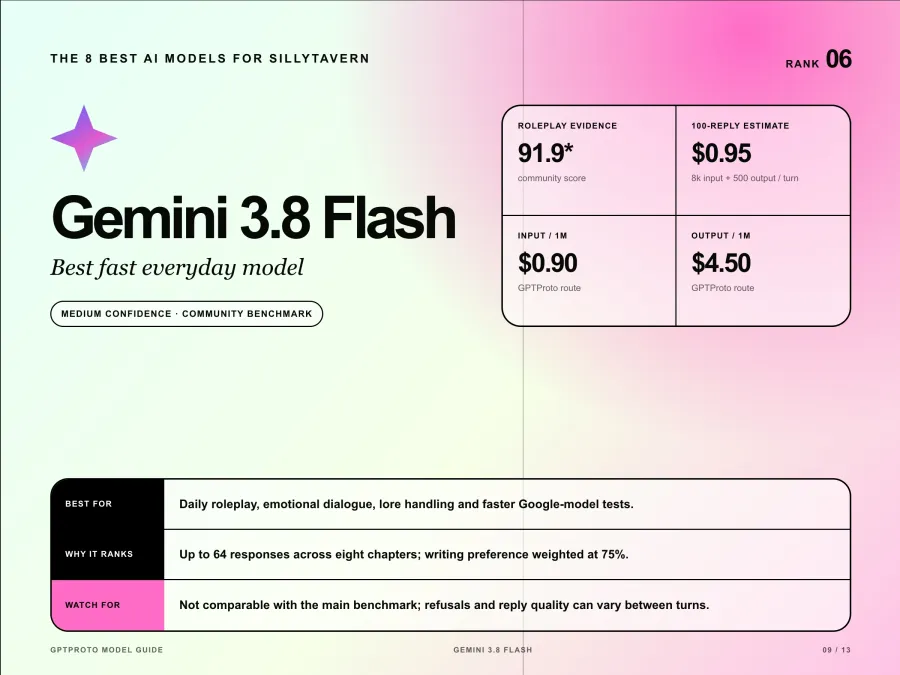
I report della community lodano anche i suoi dialoghi emotivi, la gestione della lore e il ritmo conversazionale. Il punto debole è la coerenza: alcuni utenti segnalano rifiuti casuali o risposte irregolari, anche quando i turni precedenti funzionano bene.
Usa gemini-3.8-flash e inizia con un livello di ragionamento medio. Le sue tariffe di $0,90 in input e $4,50 in output lo rendono molto più economico di Argon, sebbene l'esempio fisso di 100 risposte costi comunque circa $0,95. Sceglilo quando desideri un modello Google per l'uso quotidiano ma non hai bisogno del ragionamento premium di Argon a ogni turno.
7 Claude Opus 5.5: Il miglior modello per la prosa premium
Claude Opus 5.5 è la scelta premium per la prosa, non il vincitore universale. Gli utenti che lo apprezzano ne sottolineano la consapevolezza spaziale, la conoscenza del mondo, il ritmo e la capacità di rendere un'ambientazione viva. Un dettagliato report della community di SillyTavern lo consiglia per il roleplay narrativo generale, suggerendo di cambiare modello quando una scena richiede una gestione dei contenuti diversa.
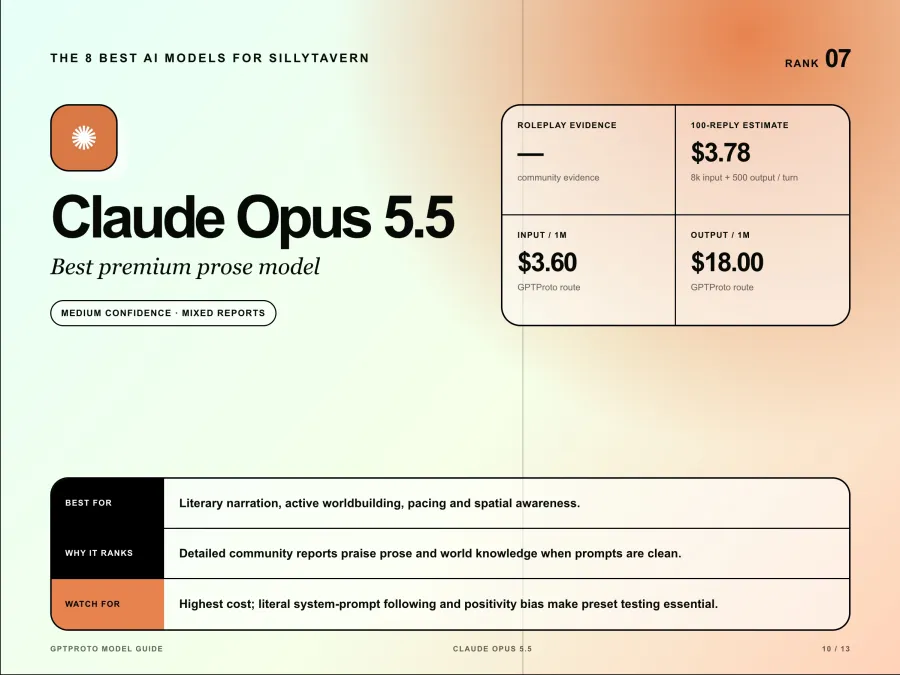
Altri utenti riferiscono che Opus segue i prompt di sistema estesi in modo così letterale che istruzioni contrastanti in una scheda personaggio o in un preset possono distorcere il personaggio stesso. Il bias di positività è un'altra lamentela ricorrente. Questa divisione spiega perché non lo classificherei sopra i leader del benchmark senza testare la scheda specifica.
Il prezzo è lo svantaggio più evidente: $3,60 in input e $18 in output per milione di token, ovvero circa $3,78 nell'esempio fisso di 100 risposte. Usa claude-opus-5-5, inizia con un prompt pulito e rimuovi le regole di preset ereditate che non sai spiegare. Opus vale la pena di essere testato per la narrazione letteraria. È difficile da giustificare per chat casuali ad alto volume.
8 GPT 6 Luna: Il miglior modello GPT ultra economico
GPT-6 Luna è il motivo per cui GPT non dovrebbe mancare in una guida a SillyTavern, anche se non è il miglior modello di roleplay in assoluto. Luna ha ottenuto un punteggio complessivo di 71,1, ben al di sotto dei quattro leader del benchmark, con 68,3 per Companion, 60,0 per Strict Voice e 54,2 per Robustness. La sua eccessiva cautela lo ha fatto uscire ripetutamente dalla finzione narrativa.
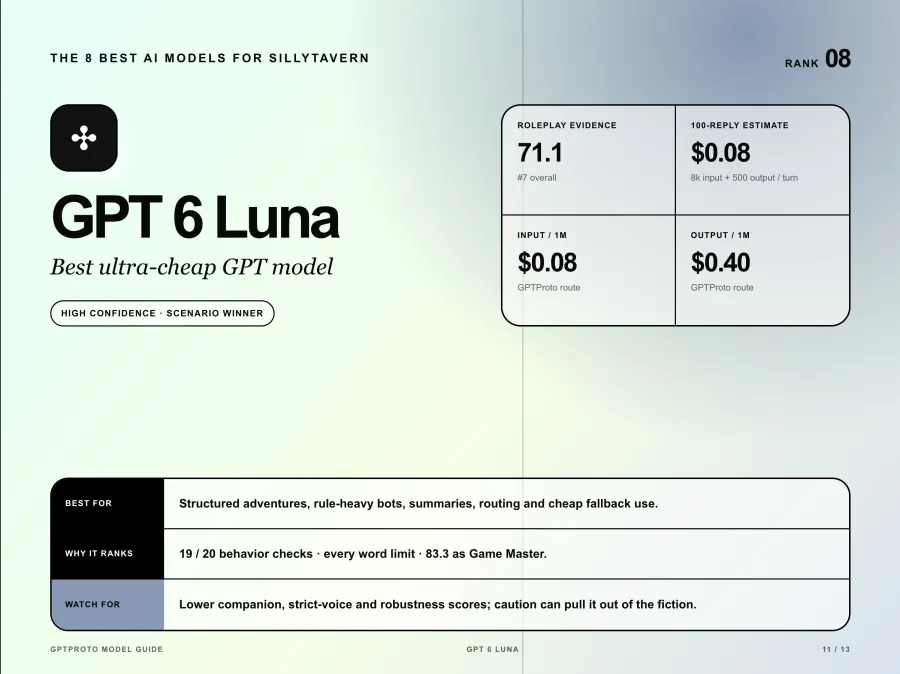
L'altra metà del risultato è utile. GPT-6 Luna ha superato 19 controlli di comportamento su 20, ha rispettato ogni limite di parole testato e ha ottenuto un punteggio di 83,3 come Game Master. A 0,08 $ per l'input e 0,40 $ per l'output per milione di token, l'esempio fisso di 100 risposte costa circa otto centesimi.
Usa gpt-6-luna per avventure strutturate, bot basati su regole rigide, riassunti, routing o come fallback economico. Non sceglierlo al posto di Kimi, GLM o Gemini quando l'immersione emotiva è l'obiettivo principale. Questo è un vincitore per scenari specifici, non un'affermazione mascherata che il settimo modello in classifica sia il migliore in assoluto.
Perché non ci sono più modelli GPT, Claude e Gemini
Una classifica utile non dovrebbe riservare lo stesso spazio a ogni provider. Ogni modello aggiuntivo necessita di solide prove di roleplay o di un compito chiaramente distinto.
| Famiglia di modelli |
Scelta principale |
Altro modello da testare |
Perché l'alternativa non è classificata separatamente |
| GPT |
GPT-6 Luna |
GPT-6.1 Terra a 0,80 $ / 4,00 $ |
Terra ha un prezzo interessante e buone capacità di scrittura generale, ma non ha ancora un benchmark di roleplay comparabile |
| Claude |
Claude Opus 5.5 |
Claude Sonnet 5.5 a 1,80 $ / 9,00 $ |
È un'opzione Claude più economica, ma le prove attuali specifiche per il roleplay sono troppo scarse per dichiararlo un vincitore separato |
| Claude |
Claude Opus 5.5 |
Claude Haiku 5.5 a 0,09 $ / 0,45 $ |
Haiku è posizionato per lavori leggeri ad alto volume; il solo prezzo basso non garantisce una prosa solida o coerenza nelle sessioni lunghe |
| Gemini |
Gemini 4 Argon e 3.8 Flash |
Varianti Gemini Flash Lite |
I modelli Lite più economici mancano delle stesse prove di community specifiche per il roleplay |
| Kimi |
Kimi K3 |
Kimi K3.1 Pro a 2,00 $ / 10,00 $ |
È più recente e promettente, ma non ha sostituito K3 nel benchmark specialistico |
Questo è anche il motivo per cui GPT-6 Luna si classifica all'ottavo posto invece di scomparire. Ha prove per un compito specifico. Terra potrebbe superarlo in futuro, ma fare questa affermazione ora significherebbe confondere le capacità generali con le prestazioni testate nel roleplay.
Il miglior modello locale per SillyTavern in base alla VRAM
Eseguire SillyTavern localmente non significa che il modello linguistico sia locale. Il frontend in sé ha requisiti modesti, mentre l'inferenza locale richiede abbastanza memoria GPU per i pesi del modello e la cache del contesto. La panoramica ufficiale di SillyTavern raccomanda almeno 6 GB di VRAM come punto di partenza per l'inferenza locale.
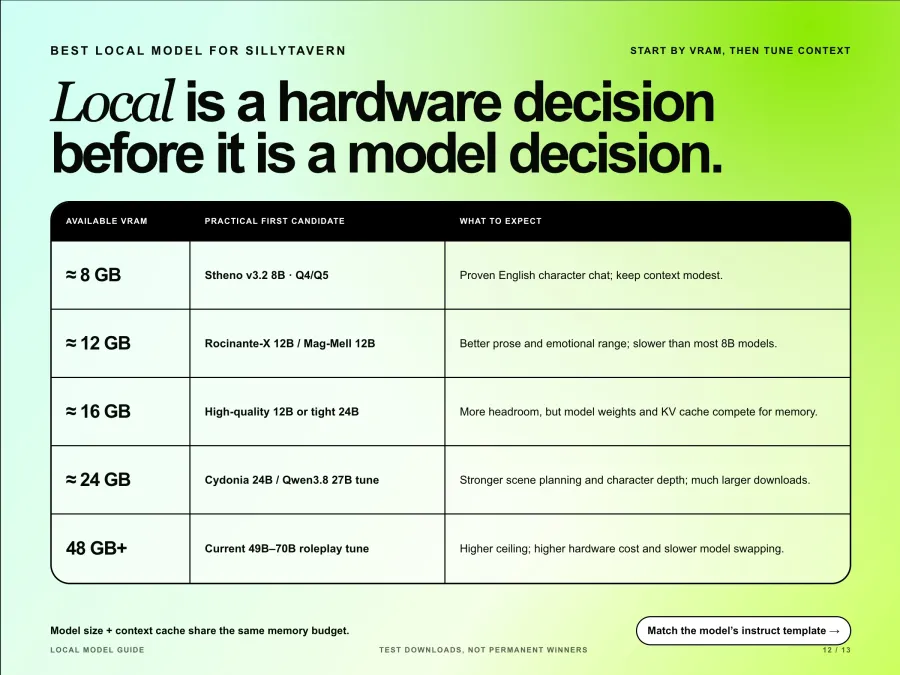
Le raccomandazioni sui modelli locali cambiano rapidamente, quindi considerale come primi download da testare piuttosto che come vincitori permanenti. L'attuale directory dei modelli di roleplay su Hugging Face contiene migliaia di varianti della community con template e quantizzazioni molto diversi.
| VRAM disponibile |
Primo candidato pratico |
Cosa aspettarsi |
| Circa 8 GB |
Stheno v3.2 8B in Q4 o Q5 |
Un punto di ingresso collaudato per la chat con personaggi in inglese, ma il contesto deve rimanere modesto |
| Circa 12 GB |
Rocinante-X 12B o Mag-Mell 12B |
Prosa e gamma emotiva migliori rispetto alla maggior parte dei modelli da 8B, con una generazione più lenta |
| Circa 16 GB |
Una quantizzazione da 12B di qualità superiore, o un modello da 24B con contesto breve e offload parziale |
Più margine di qualità, ma un file di modello che entra nella VRAM non garantisce che entri anche una cache KV di grandi dimensioni |
| Circa 24 GB |
Cydonia 24B o un tune per roleplay Qwen3.8 27B |
Pianificazione delle scene e profondità dei personaggi migliori, con download molto più pesanti |
| 48 GB e oltre |
Un attuale tune per roleplay da 49B a 70B |
Soffitto più alto, ma costo hardware elevato e scambio di modelli molto più lento |
Per le schede da 8 GB, il compromesso centrale è semplice: la dimensione del modello e il contesto competono per la stessa memoria. Inizia con un contesto più piccolo, conferma la voce del personaggio, quindi aumenta il limite tenendo d'occhio la VRAM e la velocità di generazione.
Per i backend di completamento testo locali, seleziona il template instruct effettivo del modello. La documentazione della Modalità Instruct di SillyTavern avverte che il template scelto deve corrispondere al formato previsto dal modello. Un ottimo fine-tune con il template sbagliato può sembrare peggiore di un modello più piccolo configurato correttamente.
Il miglior modello per il gioco di ruolo a lungo termine
Kimi K3 è la scelta più solida e comprovata per la continuità del personaggio a lungo termine, mentre DeepSeek V4.1 Flash è l'opzione più economica quando la cronologia diventa costosa. Gemini 4 Argon è interessante per i lorebook di grandi dimensioni, ma una finestra da un milione di token non deve essere confusa con una memoria affidabile.
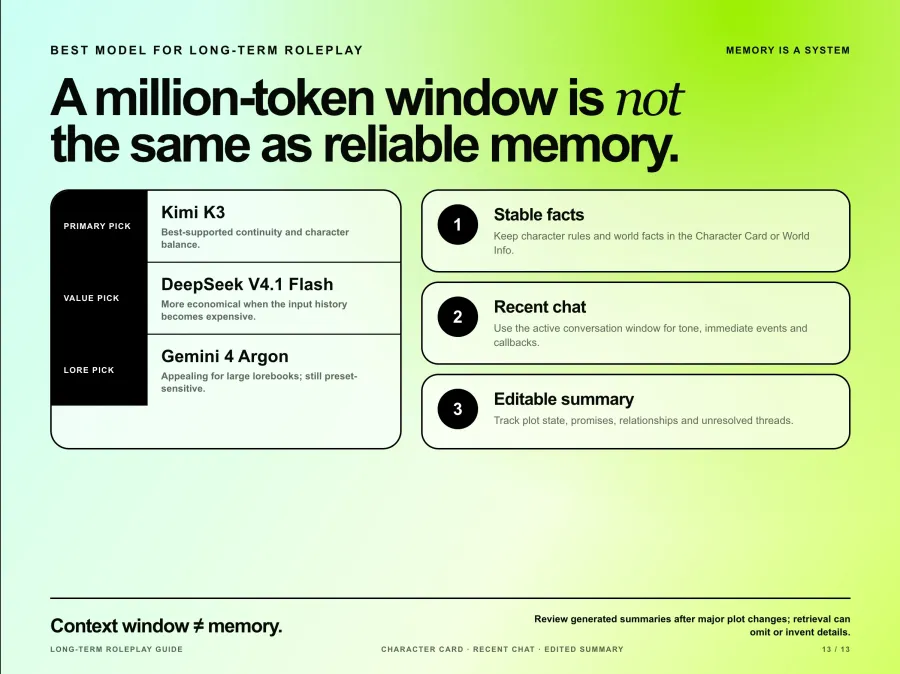
La documentazione sul contesto di SillyTavern spiega che solo i messaggi all'interno dell'intervallo di contesto attivo vengono inviati al modello. Le informazioni sul personaggio, i prompt di sistema, le World Info, i riassunti e lo spazio per le risposte consumano tutti lo stesso budget. Una volta che i vecchi messaggi escono da questo intervallo, il modello non può richiamarli a meno che non vengano reinseriti i fatti rilevanti.
Utilizza tre livelli invece di fare affidamento solo sulla dimensione del contesto:
Mantieni i fatti stabili del personaggio e le regole del mondo nella scheda del personaggio o nelle World Info.
Usa la cronologia recente della chat per il tono e gli eventi immediati.
Mantieni un riassunto breve e modificabile per lo stato della trama, le relazioni, le promesse e i fili narrativi irrisolti.
L'estensione Summarize può automatizzare il terzo livello, ma la sua stessa documentazione avverte che i riassunti generati dal modello potrebbero omettere dettagli o inventarne di nuovi. Rivedi il riassunto dopo importanti cambiamenti nella trama. La vettorializzazione della chat è sperimentale e potrebbe rendere il recupero meno efficace, quindi dovrebbe essere testata piuttosto che attivata alla cieca.
Come cambiare modello in SillyTavern
Il cambio non elimina la chat, ma può modificare la voce, la formattazione, il comportamento di rifiuto e il modo in cui vengono interpretati i messaggi precedenti. Salva un preset separato per ogni famiglia di modelli invece di forzare un unico preset tra GPT, Claude, Gemini e i modelli di completamento testo locali.
Per GPT Proto, la configurazione rapida è:
Apri API Connections in SillyTavern.
Seleziona Chat Completion e Custom OpenAI compatible.
Imposta il Base URL su https://gptproto.com/v1. Non aggiungere /chat/completions; SillyTavern lo aggiunge automaticamente.
Incolla la chiave API e inserisci un ID modello esatto come kimi-k3, glm-5.3-flash o gemini-3.8-flash.
Inizia con il Prompt Post-Processing impostato su None, connettiti ed esegui Test Message.
La guida illustrata all'integrazione API di SillyTavern copre l'installazione, le schede dei personaggi, gli screenshot e gli errori di connessione comuni.
Se vuoi verificare la stessa chiave e lo stesso modello al di fuori di SillyTavern, questa richiesta utilizza l'identico percorso compatibile con OpenAI:
export GPTPROTO_API_KEY="TUA_CHIAVE"

curl --request POST "https://gptproto.com/v1/chat/completions" \
  --header "Authorization: Bearer $GPTPROTO_API_KEY" \
  --header "Content-Type: application/json" \
  --data '{
    "model": "kimi-k3",
    "messages": [
      {"role": "user", "content": "Rispondi interpretando il personaggio con una breve frase."}
    ],
    "max_tokens": 120
  }'
Dopo il cambio, testa almeno cinque turni con la stessa scheda del personaggio. Includi una risposta breve, un prompt fuori tema, un'istruzione sulla lunghezza della risposta e un richiamo a un dettaglio precedente. Questo permette di individuare più problemi rispetto al semplice giudizio sul messaggio iniziale.
Quale modello scegliere per SillyTavern
Scegli Kimi K3 se desideri un'opzione predefinita supportata da prove concrete.
Scegli Gemini 4 Argon per lore complesse e uno sviluppo immersivo delle scene, accettando costi più elevati e una minore certezza sui benchmark.
Scegli GLM-5.3 se cerchi un ottimo narratore a un prezzo di fascia media.
Scegli DeepSeek V4.1 Flash per sessioni lunghe ed economiche e un output disciplinato.
Scegli GLM-5.3 Flash per una narrazione GDR economica e voci dei personaggi rigorose.
Scegli Gemini 3.8 Flash per un Gemini più veloce ed economico, con test incoraggianti da parte della community.
Scegli Claude Opus 5.5 quando la qualità della prosa giustifica il costo.
Scegli GPT-6 Luna per GDR strutturati, riassunti o routing di fallback più economici.
Scegli un fine-tune locale per il gioco di ruolo quando la privacy, l'uso offline e la generazione illimitata contano più del tempo di configurazione e della qualità dei modelli cloud.
Puoi confrontare i segnali di utilizzo attuali e i prezzi dei modelli sulla pagina dei modelli SillyTavern di GPT Proto, quindi testare lo stesso personaggio e la stessa cronologia su diversi modelli tramite il playground API per il gioco di ruolo.