Se oggi sei indeciso tra GPT 6.1 Terra e Sonnet 5.5, ecco la breve regola decisionale che utilizzo prima di eseguire un benchmark:
Scegli GPT-6.1 Terra se la tua pipeline esegue ispezioni di screenshot ad alto volume, automazione di moduli e fatture, debug di layout UI o attività di codifica limitate, dove una tariffa di $0,80/$4,00 per token e un'esecuzione delle attività 3 volte più veloce contano più della profondità di refactoring autonomo di picco, e i tuoi input a richiesta singola rimangono pari o inferiori a 272K token.
Rimani su Claude Sonnet 5.5 se il tuo agente esegue migrazioni di repository multi-file, debug approfondito del terminale dove una modifica mancata è più costosa del costo dei token, o prompt a passaggio singolo tra 300K e 900K token, dove il sovrapprezzo per il contesto lungo di OpenAI annulla il vantaggio di prezzo sull'input di Terra.
Puoi controllare le tariffe del catalogo in tempo reale o calcolare il tuo volume mensile di token tramite l'hub di confronto modelli di GPT Proto prima di scegliere una delle due strade. Tutto ciò che segue è un confronto basato su documentazione e benchmark verificato il 5 novembre 2026; i benchmark riportati dai fornitori sono etichettati separatamente dalle misurazioni indipendenti di Artificial Analysis e dai primi feedback degli sviluppatori.
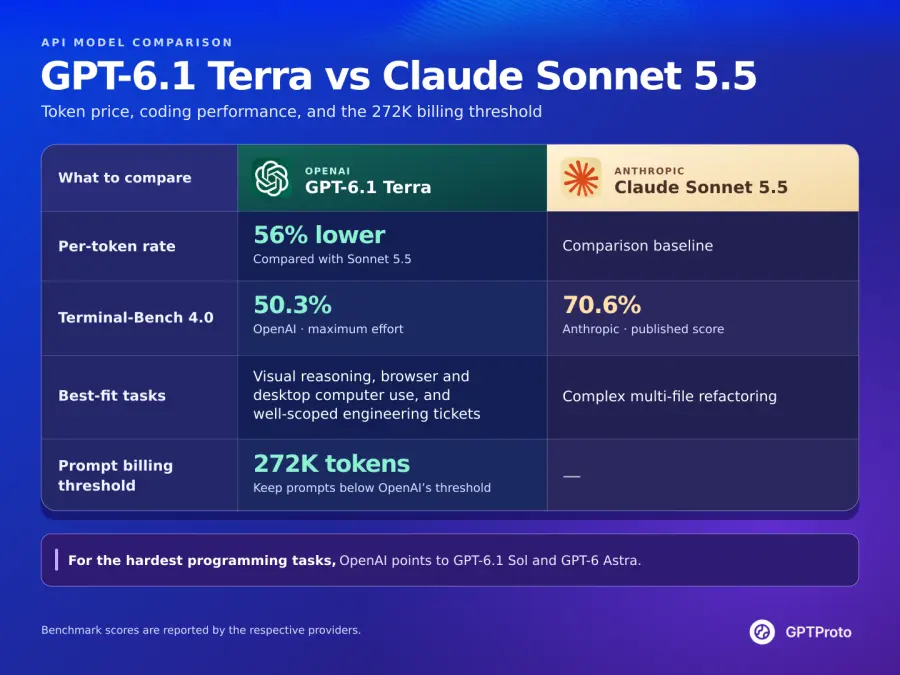
Confronto rapido tra GPT-6.1 Terra e Claude Sonnet 5.5
Gli sviluppatori che cercano confronti tra ChatGPT 6.1 Terra e Sonnet 5.5 o tra Anthropic Claude Sonnet 5.5 e GPT 6.1 Terra si imbattono spesso in schede tecniche contrastanti, poiché i due fornitori strutturano in modo diverso i controlli di ragionamento, gli endpoint degli strumenti e i supplementi per i contesti lunghi. La tabella seguente allinea entrambi i modelli con la documentazione ufficiale di OpenAI gpt-6.1-terra, la panoramica di Anthropic su Claude Sonnet 5.5 e le tariffe live del catalogo GPT Proto.
| Specifica |
GPT-6.1 Terra (gpt-6.1-terra) |
Claude Sonnet 5.5 (claude-sonnet-5-5) |
| Fornitore |
OpenAI |
Anthropic |
| Data di rilascio |
26 ottobre 2026 |
28 settembre 2026 |
| Standard ufficiale input / output (per 1M di token) |
$1.00 / $5.00 |
$2.00 / $10.00 |
| GPT Proto input / output (per 1M di token) |
$0.80 / $4.00 (−20% rispetto all'ufficiale) |
$1.80 / $9.00 (−10% rispetto all'ufficiale) |
| Lettura input memorizzato ufficiale (per 1M di token) |
$0.05 (5% dell'input base) |
$0.10 (ridotto da $0.20 il 7 ott 2026) |
| Scrittura cache ufficiale (per 1M di token) |
$1.25 (TTL 30m) / $2.50 (TTL 12h) |
$2.50 (TTL 5m) |
| Lettura / scrittura cache GPT Proto (per 1M di token) |
$0.04 / $1.00 |
$0.09 / $2.25 (verificare la pagina del modello live) |
| Finestra di contesto |
1.050.000 token |
1.000.000 token |
| Regola di prezzo per contesto lungo |
>272K input fatturati a richiesta completa a 2x input/cache e 1.5x output |
Tariffa fissa sull'intera finestra di contesto da 1M |
| Token di output massimi |
128.000 token |
128.000 token |
| Modalità input / output |
Testo, Immagine, Documento in → Testo out |
Testo, Immagine, Documento in → Testo out |
| Data di taglio della conoscenza |
1 giugno 2026 |
Inizio-metà 2026 (mantiene il tokenizer di Sonnet 5) |
| Controlli di ragionamento / impegno |
none, low, medium (predefinito), high, xhigh, max |
Pensiero adattivo attivo per impostazione predefinita; medium, high (predefinito API), max, between_tools |
| Endpoint richiesto per la chiamata agli strumenti |
/v1/responses richiesto dai documenti OpenAI |
/v1/messages (nativo) o compatibile con OpenAI /v1/chat/completions |
| Disponibilità client e IDE |
ChatGPT Work & Codex (non Chat normale), GitHub Copilot, Claude Code (tramite API) |
Claude.ai, Claude Code, GitHub Copilot, Cursor |
| Indice di intelligenza AA (v4.3.2) |
41 (medium) / 48 (max) |
56 (max, fallback predefinito) |
| Costo medio attività di valutazione AA |
$0.10 (`medium`) / $0.40 (max) |
$5.46 (max, fallback predefinito) |
| Terminal-Bench 4.0 (riportato dal fornitore) |
50,3% (max effort) |
70,6% |
Tre righe in quella tabella fanno quasi tutto il lavoro quando si pianifica il budget di un'applicazione. Primo, sulle richieste standard sotto i 272K token, GPT-6.1 Terra è più economico del 56% per token su GPT Proto sia per l'input che per l'output, quindi i completamenti lunghi non invertono la classifica dei costi. Secondo, Sonnet 5.5 mantiene un vantaggio di 20,3 punti percentuali su Terminal-Bench 4.0, che segue da vicino il comportamento dei due modelli sulle modifiche non guidate ai repository. Terzo, a differenza di GPT-6.1 Sol, GPT-6.1 Terra ripristina il supporto per reasoning.effort: "none", offrendo nuovamente agli sviluppatori OpenAI un vero percorso rapido senza ragionamento.
Analisi dei prezzi e dei costi: quale costa di più e quale è più conveniente?
Quando gli sviluppatori cercano "GPT 6.1 Terra vs Sonnet 5.5 quale costa di più" o "quale è più conveniente", solitamente cercano di conciliare due cifre diverse: la tariffa per milione di token presente sulla pagina dei prezzi e il costo effettivo in dollari di un'attività completata dall'agente. Questi due rapporti non sono la stessa cosa.
A livello di singolo token, Claude Sonnet 5.5 è il modello più costoso con un ampio margine. Il listino ufficiale di Anthropic è di 2,00 $ per milione di token in input e 10,00 $ per milione di token in output, il doppio rispetto al prezzo di listino di 1,00 $/5,00 $ di OpenAI per Terra. Poiché GPT Proto applica uno sconto del 20% su GPT-6.1 Terra (0,80 $ input / 4,00 $ output) e uno sconto del 10% su Claude Sonnet 5.5 (1,80 $ input / 9,00 $ output), Sonnet 5.5 costa 2,25 volte tanto per token sulla piattaforma. Entrambi i fornitori ora prezzano le letture di input memorizzate nella cache al 5% dell'input base (0,05 $ ufficiale per Terra contro 0,10 $ ufficiale per Sonnet 5.5 dopo che Anthropic ha dimezzato il prezzo di lettura della cache di Sonnet nell'ottobre 2026), ed entrambi addebitano 1,25 volte l'input base per le scritture standard nella cache (1,25 $ contro 2,50 $ ufficiale). Si noti che un prompt lungo a uso singolo scritto nella cache aggiunge in realtà un sovrapprezzo del 25% su entrambi i modelli se non si legge mai quel prefisso una seconda volta.
A livello di singola attività, il divario diventa molto più marcato. Nell'Intelligence Index v4.3.2 di Artificial Analysis (pubblicato il 26-27 ottobre 2026), la configurazione testata di Claude Sonnet 5.5 (impegno max con fallback predefinito) ha registrato un costo medio ponderato di 5,46 $ per attività di valutazione. Nella stessa suite di valutazione, [GPT-6.1 Terra con impegno `max`](https://artificialanalysis.ai/models/gpt-6-1-terra) ha registrato una media di 0,40 $ per attività, e GPT-6.1 Terra con impegno medium ha registrato una media di soli 0,10 $ per attività. Si tratta di una differenza di 13,6 volte con impegno max e di una differenza di 54,6 volte confrontando l'impostazione massima di Sonnet con l'impostazione predefinita medium di Terra.
Perché una differenza di 2 volte per token si trasforma in un divario di fatturazione da 13 a 54 volte? I modelli di ragionamento fatturano i token di pensiero come token di output. Quando Sonnet 5.5 viene eseguito con impegno alto o massimo su un benchmark aperto, genera lunghe catene di ragionamento a 10,00 $ per milione di token (9,00 $ su GPT Proto). L'annuncio di Terra nota anche che, con impegno massimo nell'Agents' Last Exam, Terra ha utilizzato meno di un terzo dei token rispetto a Claude Opus 5.5. Ancora più importante è la scoperta della frontiera di Pareto di Artificial Analysis: per GPT-6.1 Terra, le impostazioni di impegno low e medium sono Pareto-ottimali per intelligenza rispetto al costo. Portare Terra al livello max sposta il suo punteggio da 41 a 48, che pareggia GPT-6.1 Sol con impegno medium—eccetto che Sol medium costa 0,21 $ per attività mentre Terra `max` costa 0,40 $. In breve, se desideri la configurazione più conveniente su Terra, mantienila su low o medium; se un'attività è abbastanza difficile da richiedere un impegno max, dovresti già testare Sol o Sonnet 5.5.
Calcolo dei costi effettivi: due scenari di produzione reali
Per capire dove la tariffa più economica sui token sia effettivamente vantaggiosa — e dove invece si riveli controproducente — eseguiamo i calcoli precisi basandoci sulle tariffe di catalogo live di GPT Proto ($0,80/$4,00 per Terra; $1,80/$9,00 per Sonnet 5.5), ipotizzando richieste non memorizzate nella cache inferiori a 272K token.
Lo scenario A è un ciclo di agenti per QA visivo ed estrazione di moduli in 20 passaggi. Ogni passaggio invia uno screenshot e uno snippet DOM per un totale di 15.000 token di input e genera 1.500 token di output (inclusi medium token di ragionamento). In 20 passaggi, un singolo flusso di lavoro consuma 300.000 token di input (0,3M) e 30.000 token di output (0,03M):
GPT-6.1 Terra su GPT Proto: (0,3 * $0,80) + (0,03 * $4,00) = $0,24 + $0,12 = $0,36 per flusso di lavoro.
Claude Sonnet 5.5 su GPT Proto: (0,3 * $1,80) + (0,03 * $9,00) = $0,54 + $0,27 = $0,81 per flusso di lavoro.
Con 10.000 flussi di lavoro al mese, Terra costa $3.600 contro gli $8.100 di Sonnet: un risparmio mensile di $4.500. Anche se Terra fallisse la convalida nel 20% dei casi e dovesse ripetere quei 2.000 flussi di lavoro da zero (aggiungendo $720), il costo totale sarebbe di $4.320, con un risparmio comunque di $3.780 al mese rispetto a un'esecuzione di Sonnet senza tentativi aggiuntivi.
Lo scenario B è un refactoring del backend su più file in una pull request attiva. Supponiamo che ogni tentativo legga 80.000 token di input ed emetta 10.000 token di output. Un passaggio pulito su Sonnet 5.5 costa (0,08 * $1,80) + (0,01 * $9,00) = $0,234. Un passaggio su Terra costa (0,08 * $0,80) + (0,01 * $4,00) = $0,104. Si risparmiano 13 centesimi sulla chiamata API. Il problema è che se Terra non rileva una dipendenza di tipo tra moduli — il che è coerente con il suo divario del 50,3% contro il 70,6% nel Terminal-Bench — e costringe a tre tentativi più 12 minuti del tempo di un ingegnere senior a $90/ora ($18,00 di costo del lavoro), quel risparmio di 13 centesimi sui token è appena costato al tuo team $18,18. In una frase: Terra vince nettamente sui cicli ripetibili e verificabili meccanicamente, mentre Sonnet 5.5 giustifica la sua tariffa più alta ogni volta che una modifica fallita richiede tempo di revisione umana.
Contesto della finestra (1,05M vs 1M): Perché superare i 272K cambia il conto
Sulla carta, il confronto tra GPT 6.1 Terra e Sonnet 5.5 per quanto riguarda il contesto della finestra sembra un pareggio con un leggero vantaggio per OpenAI: Terra accetta 1.050.000 token in input ed emette fino a 128.000 token in output, mentre Claude Sonnet 5.5 accetta 1.000.000 di token in input ed emette fino a 128.000 token in output. La maggior parte delle tabelle comparative si ferma qui.
Se leggi la documentazione del modello gpt-6.1-terra di OpenAI, tuttavia, esiste una soglia di fatturazione a 272.000 token in input che cambia completamente l'economia del contesto lungo. Ogni volta che un prompt supera i 272K token in input su GPT-6.1 Terra, OpenAI fattura l'intera richiesta — non solo i token oltre i 272K — al doppio delle tariffe di input e cache e a 1,5 volte la tariffa di output.
Ecco cosa succede alla tariffa ufficiale per milione di token nel momento in cui il tuo prompt passa da 272.000 a 272.001 token:
| Fascia di contesto |
GPT-6.1 Terra (Tariffa ufficiale) |
Claude Sonnet 5.5 (Tariffa ufficiale) |
Rapporto prezzo di input |
| Prompt standard (≤272K token in input) |
$1,00 input / $5,00 output / $0,05 lettura cache |
$2,00 input / $10,00 output / $0,10 lettura cache |
Terra è più economico del 50% su input e output |
| Prompt a contesto lungo (>272K fino a 1M+ token in input) |
$2,00 input / $7,50 output / $0,10 lettura cache |
$2,00 input / $10,00 output / $0,10 lettura cache |
Le tariffe di input e lettura cache sono identiche ($2,00 / $0,10) |
A differenza del modello più piccolo Haiku 5.5 di Anthropic (che applica un sovrapprezzo di 5x sopra i 100K token), Claude Sonnet 5.5 mantiene prezzi fissi lungo l'intera finestra di contesto da 1.000.000 di token.
Facciamo i calcoli su un audit di repository da 400.000 token che produce 10.000 token in output alle tariffe di listino ufficiali:
GPT-6.1 Terra (attiva la regola >272K 2x/1,5x): (0,4 * $2,00) + (0,01 * $7,50) = $0,80 + $0,075 = $0,875.
Claude Sonnet 5.5 (tariffa fissa): (0,4 * $2,00) + (0,01 * $10,00) = $0,80 + $0,10 = $0,900.
Una volta che il tuo prompt supera i 272K token, lo sconto del 50% sull'input di Terra scompare completamente, lasciando una differenza totale di $0,025 su una chiamata da 400K token. Il mio consiglio è semplice: non inviare mai prompt monolitici >272K token a GPT-6.1 Terra aspettandoti un'economia a metà prezzo. Suddividi/recupera il contesto sotto i 272K token in modo che Terra rimanga nella sua fascia da $1,00 ($0,80 GPT Proto), oppure instrada i dump di repository da 300K–900K direttamente a Claude Sonnet 5.5, dove paghi la stessa tariffa di input ufficiale e ottieni una comprensione del codice a lungo raggio più solida. (Prima di eseguire prompt >272K in produzione tramite GPT Proto, verifica con il supporto della piattaforma come l'adeguamento del livello a 272K a monte si riflette sul saldo del tuo account.)
Benchmark e feedback della community: programmazione, frontend e lavoro agentico
I punteggi compositi principali nascondono dove ogni modello ha effettivamente successo. Sull'Artificial Analysis Intelligence Index v4.3.2, Claude Sonnet 5.5 (max, Default Fallback) ottiene 56, GPT-6.1 Sol (max) ottiene 52 e GPT-6.1 Terra ottiene 48 con impegno max e 41 con impegno medium. (Nell'istantanea dell'indice del 3 novembre 2026 mostrata sulla scheda di confronto di GPT Proto, Sonnet 5.5 registra 54,2 e Terra max registra 51: uno scarto più ridotto di 3,2 punti che favorisce comunque Sonnet.) Per prendere una decisione pratica di routing per codice, interfaccia utente frontend o cicli di agenti, dobbiamo scomporre tali aggregati per tipo di attività e confrontarli con ciò che gli sviluppatori segnalano sul campo.
1. Programmazione Backend e Terminale (GPT 6.1 Terra vs Sonnet 5.5 per il codice)
Per l'ingegneria del software pura da riga di comando, Anthropic mantiene ancora un netto vantaggio. Su Terminal-Bench 4.0, Anthropic riporta il 70,6% per Claude Sonnet 5.5 (in aumento rispetto al 10,3% di Sonnet 5), mentre OpenAI riporta il 50,3% per GPT-6.1 Terra a max effort (in aumento rispetto al 21,5% di GPT-5.6 Terra). Nel nuovo Coding Agent Index v2.0 di Artificial Analysis, Terra ottiene un punteggio di 48: 17 punti avanti rispetto al leggero GPT-6 Luna (31), ma 6 punti dietro GPT-6.1 Sol (54). Artificial Analysis nota anche che, specificamente per gli agenti di programmazione, le impostazioni di sforzo low e xhigh di Terra si collocano sulla frontiera dell'efficienza dei costi, mentre le altre impostazioni di sforzo rimangono indietro.
I primi test nel mondo reale indicano il confine esatto tra i due modelli:
Il changelog del 26 ottobre 2026 di GitHub Copilot ha riportato che, nei primi test interni, GPT-6.1 Terra ha risolto un numero sensibilmente maggiore di attività di terminale e di programmazione in C# rispetto a GPT-5.6 Terra, aggiungendo un'osservazione comportamentale cruciale: "Lavora in passaggi mirati e consolidati su attività ben definite." GitHub non ha pubblicato le percentuali grezze di successo in quella nota, quindi va considerata come un'osservazione qualitativa della piattaforma piuttosto che come un benchmark controllato.
Per quanto riguarda Claude, un primo test comparativo tra sviluppatori su r/ClaudeAI (eseguendo dieci attività di programmazione personali tre volte per configurazione a sforzo high in Claude Code e pi-agent) ha rilevato che Sonnet 5.5 ha completato costantemente le implementazioni in meno turni di conversazione e con meno token di output rispetto al suo predecessore, in gran parte perché Sonnet 5.5 raggruppa le chiamate di strumenti in parallelo in modo più aggressivo. Allo stesso modo, nella valutazione esterna CursorBench 4.0 di Cursor, Sonnet 5.5 a sforzo high ha ottenuto un punteggio del 47,8% a $1,67 per attività.
La conclusione per gli sviluppatori backend: se il ticket è ben definito (scrivere un metodo di servizio C#, aggiungere un unit test o correggere uno script CLI isolato), Terra a sforzo low o medium lo completerà rapidamente a meno della metà del prezzo per token. Se il ticket richiede di tracciare lo stato su dieci file dove un ciclo di ripetizione extra rovina il flusso di lavoro, la competenza del 70,6% di Sonnet 5.5 nel terminale giustifica la tariffa più alta. Dove è coinvolto il calcolo scientifico, OpenAI riporta anche che su Terminal-Bench-Science 0.1 (come la scrittura di codice per tracciare le divisioni cellulari in video time-lapse), Terra a sforzo max supera effettivamente GPT-6.1 Sol e si avvicina entro cinque punti a Claude Opus 5.5 a meno di un quinto del costo stimato.
2. GPT-6.1 Terra vs Sonnet 5.5 per la programmazione frontend
Cercare GPT 6.1 Terra vs Sonnet 5.5 per la programmazione frontend merita una risposta a sé stante, perché l'ingegneria frontend è composta da due lavori distinti uniti insieme: il lavoro di layout visivo/DOM e la logica di stato/architettura.
Quando OpenAI ha presentato il punteggio del 50,3% di GPT-6.1 Terra su Terminal-Bench 4.0, l'unico esempio concreto di programmazione evidenziato nell'annuncio è stato un bug frontend: "correggere una pagina web il cui layout si sposta durante il caricamento" (Cumulative Layout Shift, o CLS). Allo stesso tempo, OpenAI ha riferito che su MMMU-Pro — un benchmark per il ragionamento visivo su diagrammi, screenshot e layout densi — GPT-6.1 Terra supera GPT-5.6 Terra a tutti i livelli di sforzo e quasi eguaglia i modelli di frontiera GPT-6 Astra e GPT-6.1 Sol a una frazione del prezzo. Nel thread del giorno del lancio sul forum della OpenAI Developer Community, una delle prime reazioni degli sviluppatori ha riassunto Terra come "un ottimo rapporto qualità-prezzo, specialmente per quanto riguarda la comprensione visiva. Discreto anche nella programmazione."
Questa distinzione offre ai team frontend una chiara divisione del lavoro:
Usa GPT-6.1 Terra per il lavoro frontend visivo e a livello di UI: trasformare screenshot o wireframe di Figma nel markup iniziale Tailwind/HTML, confrontare gli screenshot renderizzati di Playwright con le specifiche di design per individuare nodi DOM sovrapposti o regressioni nei breakpoint mobile, e diagnosticare gli spostamenti di layout CSS. Poiché Terra elabora le immagini in modo nativo, è oltre 3 volte più veloce di GPT-6.1 Sol e Astra nei benchmark di azione visiva e costa $0,80/$4,00 su GPT Proto, la tua pipeline CI può permettersi di eseguire controlli di regressione visiva a ogni commit.
Usa Claude Sonnet 5.5 per l'architettura frontend ad alta intensità logica: refactoring di complessi alberi di stato delle server-action di React/Next.js, risoluzione di intricati vincoli generici di TypeScript o migrazione di un vecchio store Redux senza interrompere l'idratazione. Quando non c'è alcuno screenshot da ispezionare e la difficoltà risiede puramente nella coerenza dello stato tra più file, Sonnet 5.5 rimane la scelta più sicura.
3. Lavoro agentico, utilizzo del computer e accuratezza (per il lavoro agentico)
Se la tua definizione di GPT 6.1 Terra vs Sonnet 5.5 per il lavoro agentico è incentrata sull'automazione della GUI, sull'analisi dei documenti e sull'utilizzo del computer per il back-office, GPT-6.1 Terra è probabilmente il rilascio di maggior valore di OpenAI del 2026.
Nelle valutazioni fornite dal fornitore OpenAI su Agents' Last Exam v1 (che testa flussi di lavoro professionali a più passaggi come la conversione di disegni architettonici in un modello 3D o la registrazione di timecode scena per scena in un film d'animazione), GPT-6.1 Terra con uno sforzo medio ha ottenuto un punteggio superiore di 15 punti percentuali rispetto a GPT-5.6 Terra a circa un terzo del costo, eguagliando il modello di punta GPT-6 Astra a un decimo del prezzo per token. Con uno sforzo massimo, OpenAI riferisce che Terra è oltre 3 volte più efficiente in termini di token rispetto a Claude Opus 5.5 e a 1/4 del suo prezzo per token, producendo un costo per attività circa 9 volte inferiore e completando i flussi di lavoro oltre 3 volte più velocemente sia di GPT-6 Astra che di GPT-6.1 Sol.
Su OSWorld 2.1 (controllo delle applicazioni desktop), OpenAI riferisce che Terra con uno sforzo medio supera il miglior punteggio di GPT-5.6 Terra a una frazione del costo per attività. Per mantenere l'equilibrio, il punteggio OSWorld 2.1 (offline) pubblicato da Anthropic per Claude Sonnet 5.5 è un altissimo 83,9% (divulgato nella tabella di benchmark Haiku 5.5 di ottobre 2026 di Anthropic). Entrambi i modelli sono motori di utilizzo del computer di alto livello; la differenza è che gli agenti di screen-scraping inviano uno screenshot aggiornato a ogni clic, il che consuma rapidamente i token di input e rende la tariffa di input GPT Proto di $0,80/M di Terra molto più facile da sostenere su larga scala.
Altrettanto importante per gli agenti autonomi è sapere quando il modello non sa qualcosa. Nel benchmark AA-Omniscience indipendente di Artificial Analysis, il tasso di allucinazione di GPT-6.1 Terra (quanto spesso il modello tira a indovinare quando non possiede la conoscenza) è sceso di 50 punti percentuali — dall'88% di GPT-5.6 Terra al 38% — guadagnando contemporaneamente 2 punti in accuratezza complessiva. Tale misurazione indipendente supporta la valutazione interna dell'accuratezza di OpenAI (descritta ulteriormente nella Scheda di sistema di GPT-6.1 Terra), in cui i tassi di errore fattuale a basso sforzo su prompt difficili sono scesi dal 53,6% al 16,7% (e fino al 4,3% con uno sforzo massimo). Tassi di allucinazione più bassi significano meno chiamate di strumenti errate a valle.
Esperienza dello sviluppatore e insidie delle API (GPT 6.1 Terra vs Sonnet 5.5 per sviluppatori)
Passare da gpt-6.1-terra a claude-sonnet-5-5 in produzione raramente si risolve con una semplice sostituzione di stringa. Se stai valutando l'ergonomia di GPT 6.1 Terra vs Sonnet 5.5 per sviluppatori, quattro vincoli a livello di API determineranno il tuo lavoro di integrazione.
In primo luogo, GPT-6.1 Terra supporta reasoning.effort: "none", mentre GPT-6.1 Sol no. Quando OpenAI ha lanciato GPT-6.1 Sol il 29 settembre 2026, ha rimosso i livelli di ragionamento none e minimal, forzando ogni richiesta sul livello low o superiore e invalidando temperature e top_p su tutta la linea. Secondo la guida ufficiale alla migrazione e al prompting di OpenAI per gpt-6.1-terra, Terra supporta l'intero spettro: none, low, medium (predefinito), high, xhigh e max. Se imposti reasoning_effort: "none", Terra viene eseguito senza generare token di ragionamento nascosti e consente i parametri di campionamento standard. Tuttavia, nel momento in cui utilizzi low, medium, high, xhigh o max, devi rimuovere temperature, top_p, top_logprobs e logprobs dal payload della tua richiesta, altrimenti l'API rifiuterà la chiamata con un errore HTTP 400.
In secondo luogo, OpenAI richiede l'API Responses (/v1/responses) per le chiamate di strumenti su GPT-6.1 Terra. Sebbene i prompt di testo e immagini semplici funzionino su /v1/chat/completions, la documentazione del modello di OpenAI afferma esplicitamente che le chiamate di strumenti richiedono /v1/responses. Una volta utilizzata l'API Responses, Terra supporta tutti e nove gli strumenti nativi integrati di OpenAI — Ricerca web, Ricerca file, Generazione immagini, Interprete di codice, Shell ospitata, apply_patch, Competenze, Utilizzo computer, MCP e Ricerca strumenti — oltre a async: true sugli strumenti con funzioni personalizzate, in modo che il modello possa continuare a ragionare mentre uno strumento lento viene eseguito in background. Inoltre, Terra supporta l'invio di un elemento di input configuration_update a metà conversazione per aumentare o diminuire reasoning.effort in un passaggio complesso senza dover riscrivere il prefisso del prompt o invalidare la cache del prompt di 30 minuti (prompt_cache_options.ttl: "30m").
In terzo luogo, Claude Sonnet 5.5 ha le sue rigide trappole di errore 400. Secondo la guida alla migrazione di Anthropic per Sonnet 5.5, Sonnet 5.5 utilizza il pensiero adattivo per impostazione predefinita (con un impegno predefinito di high sull'API e medium in Claude Code, come indicato nei documenti di configurazione di Claude Code di Anthropic). Se la tua integrazione legacy di Claude invia thinking: {"type": "disabled"}, devi aggiornarla a between_tools per l'impostazione di pensiero più bassa. Ancora più importante, Sonnet 5.5 rifiuta le scelte forzate di strumenti (tool_choice: {"type": "any"} o uno strumento nominato forzato) con un errore 400 quando il pensiero adattivo è attivo; devi utilizzare auto e guidare la selezione dello strumento nel prompt. Devi anche analizzare i blocchi di contenuto della risposta per type invece di dare per scontato che content[0] sia testo, perché il primo blocco è spesso un blocco thinking.
Quarto, l'integrazione IDE e CLI è già predisposta per entrambi. Nota che negli abbonamenti consumer, le note di rilascio di OpenAI confermano che GPT-6.1 Terra è stato distribuito su ChatGPT Work e Codex (per i piani Plus, Pro, Business, Enterprise ed Edu), non sull'interfaccia standard di ChatGPT Chat, e non supporta la residenza dei dati di inferenza negli Emirati Arabi Uniti (sebbene la modalità Fast supporti la residenza dei dati nell'UE). Per gli sviluppatori che lavorano in terminali locali, entrambi i modelli possono essere collegati a Claude Code e OpenAI Codex tramite GPT Proto. Sulla pagina del modello GPT-6.1 Terra, facendo clic su Prova questo modello si apre un pannello di avvio rapido dove è possibile selezionare Claude Code o ChatGPT (Codex) sotto Lascia che l'IA completi l'integrazione, oppure fare clic su Copia Markdown per l'IA per consentire al tuo assistente di programmazione di configurare automaticamente le variabili d'ambiente.
Creazione di app: come instradare entrambi i modelli con una singola chiave API
Quando i team chiedono informazioni su GPT 6.1 Terra vs Sonnet 5.5 per la creazione di app, l'architettura migliore non consiste quasi mai nello scegliere un solo modello per il 100% del traffico. Poiché entrambi i modelli risiedono sotto un unico saldo prepagato su GPT Proto, è possibile instradare in base al passaggio anziché al fornitore: invia l'ispezione visiva ad alta frequenza, la classificazione degli screenshot e le correzioni dell'interfaccia utente delimitate a gpt-6.1-terra a $0,80/$4,00, ed esegui l'escalation della sintesi di codice su più file a claude-sonnet-5-5 a $1,80/$9,00.
1. Controllo cURL di prima chiamata (Chat Completions compatibili con OpenAI)
Entrambi i modelli possono essere richiamati per l'analisi testuale e visiva tramite l'endpoint unificato compatibile con OpenAI /v1/chat/completions di GPT Proto utilizzando un token Bearer standard. Passare dall'uno all'altro richiede di modificare solo la stringa "model" :
# Chiamata 1: GPT-6.1 Terra ($0,80 input / $4,00 output per 1M di token su GPT Proto)
curl --fail-with-body https://gptproto.com/v1/chat/completions \
  -H "Authorization: Bearer $GPTPROTO_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "gpt-6.1-terra",
    "messages": [
      {
        "role": "user",
        "content": "Ispeziona questa regola CSS e spiega in due frasi perché innesca uno spostamento del layout su mobile: .hero-banner { width: 100%; height: auto; }"
      }
    ]
  }'

# Chiamata 2: Claude Sonnet 5.5 ($1,80 input / $9,00 output per 1M di token su GPT Proto)
curl --fail-with-body https://gptproto.com/v1/chat/completions \
  -H "Authorization: Bearer $GPTPROTO_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "claude-sonnet-5-5",
    "messages": [
      {
        "role": "user",
        "content": "Scrivi un helper TypeScript che convalida le firme dei webhook utilizzando la Web Crypto API con confronto a tempo costante."
      }
    ]
  }'
2. Esempio di router a passaggi in Python per pipeline di frontend e app
Ecco un pattern pratico in Python che utilizza l'SDK standard openai puntato su https://gptproto.com/v1. In questo flusso di lavoro, il Passaggio 1 utilizza gpt-6.1-terra per effettuare il triage di una segnalazione di bug dell'interfaccia utente (dove il volume di token è elevato e la diagnosi visiva/DOM è economica), e il Passaggio 2 instrada dinamicamente la patch di codice effettiva a gpt-6.1-terra (per correzioni CSS isolate su singolo componente) o a claude-sonnet-5-5 (quando il triage segnala una modifica di stato tra più file o quando il prompt si avvicina al limite di 272K):
import os
import json
from openai import OpenAI

# Una chiave API e saldo condiviso tra i modelli OpenAI e Anthropic
client = OpenAI(
    api_key=os.environ["GPTPROTO_API_KEY"],
    base_url="https://gptproto.com/v1",
)

def triage_and_patch_ui_issue(dom_snapshot: str, screenshot_url: str, approx_tokens: int) -> dict:
    # Passaggio 1: Eseguire sempre il triage visivo/DOM su GPT-6.1 Terra ($0.80 / $4.00 per 1M)
    triage_response = client.chat.completions.create(
        model="gpt-6.1-terra",
        messages=[
            {
                "role": "system",
                "content": (
                    "Sei un agente di triage QA frontend. Ispeziona lo screenshot e il DOM. "
                    "Restituisci un JSON con le chiavi: 'root_cause', 'scope' ('isolated_css' o 'multi_file_state'), "
                    "e 'target_files' (array di stringhe)."
                ),
            },
            {
                "role": "user",
                "content": [
                    {"type": "text", "text": f"Istantanea DOM: {dom_snapshot}"},
                    {"type": "image_url", "image_url": {"url": screenshot_url}},
                ],
            },
        ],
        response_format={"type": "json_object"},
    )

    triage_data = json.loads(triage_response.choices[0].message.content)

    # Passaggio 2: Instradamento in base all'ambito dell'attività E al limite di fatturazione del contesto lungo di 272K
    # Se la correzione riguarda lo stato multi-file O supera i 272K token di input, passa a Sonnet 5.5
    if triage_data.get("scope") == "multi_file_state" or approx_tokens > 272_000:
        selected_model = "claude-sonnet-5-5"
    else:
        selected_model = "gpt-6.1-terra"

    patch_response = client.chat.completions.create(
        model=selected_model,
        messages=[
            {
                "role": "user",
                "content": (
                    f"Diagnosi di triage: {json.dumps(triage_data)} | "
                    f"Genera una patch minima e pronta per la produzione per il DOM/componente: {dom_snapshot}"
                ),
            }
        ],
    )

    return {
        "triage": triage_data,
        "routed_to": selected_model,
        "patch": patch_response.choices[0].message.content,
    }

if __name__ == "__main__":
    sample_dom = "<div class='card-grid'><img src='/hero.webp' /><h2>Checkout</h2></div>"
    result = triage_and_patch_ui_issue(
        dom_snapshot=sample_dom,
        screenshot_url="https://example.com/cls-regression-frame.png",
        approx_tokens=12_000,
    )
    print(f"Patch instradata a: {result['routed_to']}")
    print(result["patch"])
Nota pre-distribuzione (richiesto smoke test): Verifica le stringhe esatte del modello (gpt-6.1-terra e claude-sonnet-5-5) rispetto ai pannelli di utilizzo API in tempo reale sulle pagine dei modelli GPT Proto prima di distribuire cicli fatturabili. Se il tuo agente si basa sugli strumenti dell'API Responses nativa di OpenAI (apply_patch, shell ospitata o chiamate di funzione async: true) o sui parametri di pensiero adattivo nativi di Anthropic /v1/messages (output_config.effort), esegui un rapido smoke test rispetto ai rispettivi endpoint nativi di GPT Proto (/v1/responses e /v1/messages) per confermare il passaggio dei parametri sul tuo percorso.
Verdetto: quale dovresti usare?
Se desideri una tabella singola da incollare in un documento di revisione dell'architettura, abbina il tuo carico di lavoro principale alla modalità di errore e al limite di fatturazione che ti interessano di più:
| Carico di lavoro / Scenario |
Modello consigliato |
Impostazione consigliata |
Perché vince |
| QA di screenshot ad alto volume, lettura di fatture/moduli e utilizzo del computer tramite browser |
GPT-6.1 Terra |
low o medium effort |
Tariffa token GPT Proto inferiore del 56% ($0,80/$4,00), completamento delle attività oltre 3 volte più veloce rispetto a Sol/Astra e visione MMMU-Pro a livello di Astra. |
| Debug dell'interfaccia frontend (spostamenti di layout CLS, da Figma a CSS, regressioni visive) |
GPT-6.1 Terra |
medium effort |
Progettato per l'ispezione visiva e del DOM; testato esplicitamente sulle correzioni dello spostamento del layout delle pagine web. |
Classificazione a bassa latenza, routing o estrazione JSON dove è necessaria la temperature |
GPT-6.1 Terra |
reasoning.effort: "none" |
Ripristina il livello none senza ragionamento che GPT-6.1 Sol aveva eliminato, mantenendo al minimo la latenza e il numero di token di output. |
| Refactoring del backend su più file e modifiche complesse allo stato di TypeScript/React |
Claude Sonnet 5.5 |
medium o high effort |
70,6% contro 50,3% su Terminal-Bench 4.0; raggruppa le chiamate agli strumenti in meno passaggi, risparmiando tempo prezioso per la revisione degli sviluppatori. |
| Analisi di repository a contesto lungo con singola richiesta (da 300K a 900K token di input) |
Claude Sonnet 5.5 |
medium o high effort |
Terra attiva un sovrapprezzo di 2x sull'input / 1,5x sull'output oltre i 272K token (salendo a $2,00 di input ufficiale), annullando il suo vantaggio di prezzo. |
Codifica terminale nativa OpenAI più profonda quando il max di Terra non è sufficiente |
GPT-6.1 Sol |
medium effort |
Ottiene un punteggio di 54 contro i 48 di Terra sull'AA Coding Agent Index v2.0, e Sol medium ($0,21/attività) è effettivamente più economico per attività rispetto a Terra `max` ($0,40/attività). |
Per riassumere il verdetto senza giri di parole: avvia ogni passaggio ripetibile di visualizzazione, utilizzo del computer e codifica delimitata su GPT-6.1 Terra a low o medium effort per sfruttare la tariffa di $0,80/$4,00, e mantieni Claude Sonnet 5.5 per i passaggi di codifica su più file e i prompt con >272K token, dove la sua maggiore precisione al primo tentativo e il prezzo fisso per 1M di contesto si ripagano da soli. Per inserire i tuoi rapporti mensili di input e output, apri il calcolatore di confronto GPT Proto e testa entrambi i modelli fianco a fianco su un unico bilancio.