Alternative alle API di OpenAI in sintesi
| Alternativa |
Ideale per |
Approccio di accesso |
Principale considerazione per la migrazione |
| GPT Proto |
Famiglie di modelli multiple e accesso scontato |
Piattaforma di modelli unificata |
Verificare le funzionalità per il modello e l'endpoint scelti |
| Anthropic Claude |
Flussi di lavoro di programmazione e agenti |
API diretta del modello |
Le funzionalità native di Claude e la compatibilità SDK differiscono |
| Google Gemini |
Applicazioni multimodali |
API diretta del modello |
Le funzionalità avanzate potrebbero richiedere un'integrazione nativa Gemini |
| DeepSeek |
Carichi di lavoro di ragionamento orientati al budget |
API diretta del modello |
Includere la cache e i prezzi di picco rispetto a quelli fuori picco |
| Groq |
Applicazioni sensibili alla velocità |
Inferenza ospitata |
Valutare la combinazione di modello e funzionalità supportate |
| Mistral |
Applicazioni incentrate sui documenti |
Modelli più API per documenti |
OCR, stato della conversazione e inferenza sono aspetti distinti |
| OpenRouter |
Esplorazione dei modelli e routing dei provider |
Gateway multi-provider |
Definire i requisiti di routing e considerare le commissioni della piattaforma |
Come abbiamo confrontato queste alternative alle API di OpenAI
Pubblicato da GPT Proto, questo confronto utilizza la documentazione ufficiale, i prezzi pubblici e le funzionalità applicative documentate verificate il 29 ottobre 2026. Le raccomandazioni sono giudizi editoriali sull'idoneità al flusso di lavoro; non è stato eseguito alcun benchmark privato delle prestazioni tra provider. Distinguiamo le API dirette dei modelli dai gateway e dai servizi di inferenza perché sostituiscono parti diverse di una configurazione OpenAI.
Le 7 migliori alternative alle API di OpenAI
1. GPT Proto per l'accesso a modelli multipli e prezzi scontati
GPT Proto è adatto a un team SaaS il cui prodotto necessita di diversi modelli: uno per il supporto di routine, un altro per la programmazione complessa e forse modelli separati per la generazione di immagini o video. Il suo catalogo di modelli riunisce opzioni di testo, immagini, video e audio sotto un unico account, chiave API e saldo condiviso.
Ciò supporta una migrazione graduale. Mantieni le richieste GPT che funzionano già, sposta un'attività definita su Claude o DeepSeek e confronta i risultati prima di modificare il resto dell'applicazione. Un account condiviso riduce la fatturazione e la configurazione delle credenziali necessarie per tale valutazione.
Esiste anche un'opzione semplice per i team che desiderano mantenere GPT. La pagina API di GPT-6.1 Sol elenca 1,60 $ per l'input e 8 $ per l'output per milione di token, rispetto alle tariffe standard di OpenAI di 2 $ e 10 $. Si tratta di una riduzione del 20% su tali tariffe per token. Claude Sonnet 5.5 è quotato a 1,80 $ e 9 $, il 10% in meno rispetto alle tariffe standard corrispondenti di Anthropic.
Scegli GPT Proto quando la scelta del modello e l'accesso consolidato sono le priorità. Controlla la sezione Utilizzo API del modello selezionato per le interfacce e i campi supportati; una chiave condivisa non rende intercambiabile ogni modello o endpoint multimediale. Mantenere GPT tramite un altro provider preserva anche la dipendenza dalla famiglia di modelli GPT.
2. Anthropic Claude per la programmazione e i flussi di lavoro degli agenti
Claude merita di essere preso in considerazione quando l'applicazione trascorre la maggior parte del tempo a modificare codice, analizzare documenti o decidere quale strumento utilizzare successivamente. Inizia con Sonnet per la programmazione quotidiana e il lavoro degli agenti, valuta Opus per attività più impegnative e prendi in considerazione Haiku per la classificazione, l'estrazione o l'instradamento ripetitivi.
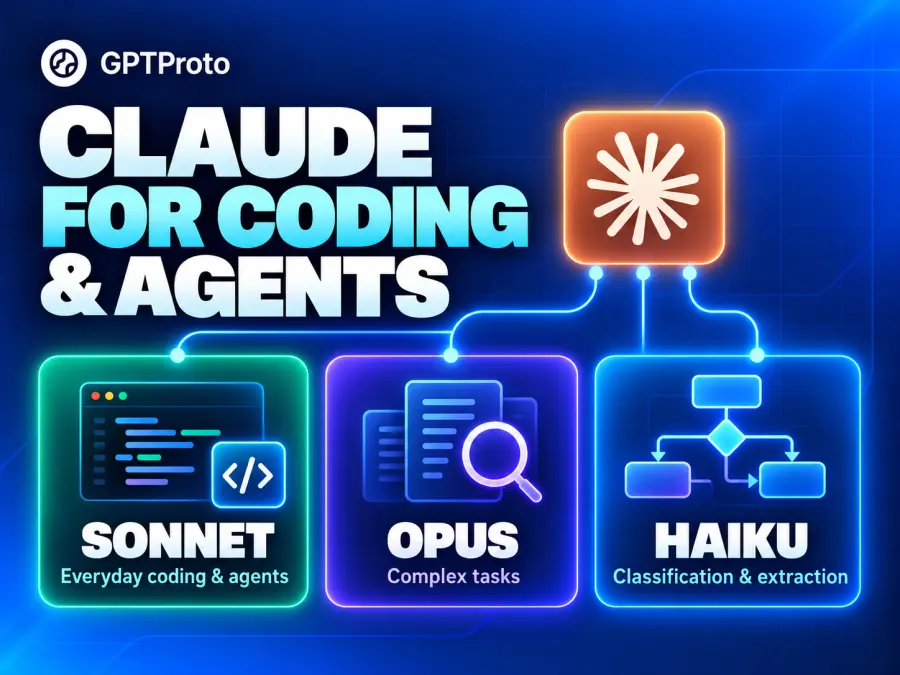
Ad esempio, un agente di supporto potrebbe utilizzare un modello leggero per classificare le richieste e riservare un modello più potente per indagare su un problema tecnico complesso. Il listino prezzi dei modelli di Anthropic rende visibili questi livelli: Sonnet 3.5 costa 2$ in input e 10$ in output per milione di token, mentre Haiku 3.5 parte da 0,10$ e 0,50$ per prompt fino a 100K token di input.
La migrazione richiede attenzione all'interfaccia. La documentazione sulla compatibilità dell'SDK OpenAI di Anthropic afferma che il livello di compatibilità ignora il campo strict dello schema degli strumenti. Le applicazioni che dipendono da una validazione rigorosa dovrebbero valutare il supporto per l'output strutturato dell'API nativa di Claude.
Utilizza la collezione di modelli Claude su GPT Proto per confrontare i percorsi disponibili. Claude è un'alternativa basata sulle funzionalità; scegliere Sonnet alla sua tariffa standard ufficiale non riduce automaticamente la fattura rispetto a GPT-4o.
3. Google Gemini per applicazioni multimodali
Gemini è un candidato utile per prodotti che combinano testo con screenshot, audio registrato, video o documenti. Un'app di apprendimento che esamina la registrazione di uno studente e uno strumento di supporto che interpreta le catture dello schermo necessitano di qualcosa di più della semplice generazione di testo.
Google documenta la compatibilità con l'SDK OpenAI, inclusa la modifica dell'URL di base, della chiave e del modello per le richieste supportate. Ciò può semplificare una valutazione iniziale. La sua guida all'integrazione spiega anche che le funzionalità avanzate di Gemini e gli strumenti lato server potrebbero richiedere una gestione aggiuntiva o un'integrazione nativa.
Seleziona il modello in base ai requisiti effettivi di input e output. Un modello Flash-Lite può essere un candidato conveniente per un'elaborazione più semplice, mentre una Live API separata gestisce l'interazione in tempo reale. L'accesso a un endpoint di testo Gemini non stabilisce il supporto per ogni prodotto Gemini.
Sfoglia i modelli Google su GPT Proto o esamina Gemini 1.5 Flash per i suoi input multimodali elencati. Google offre anche livelli gratuiti per modelli selezionati, con limiti e termini di utilizzo dei dati diversi rispetto all'accesso a pagamento, come mostrato nella sua documentazione sui prezzi.
4. DeepSeek per carichi di lavoro di ragionamento attenti al budget
Vale la pena valutare DeepSeek per l'analisi ripetuta di documenti, l'assistenza alla programmazione e le attività di ragionamento in cui i costi dei token si accumulano rapidamente. È particolarmente rilevante quando le richieste riutilizzano input sostanziali o possono essere eseguite al di fuori delle ore di punta.
La tabella dei prezzi ufficiale di DeepSeek elenca Flash a 0,30 $ per milione di token di input non memorizzati nella cache e 1,20 $ per milione di token di output durante i periodi di punta. Le tariffe non di punta sono 0,15 $ e 0,60 $. L'input memorizzato nella cache ha una tariffa separata e inferiore, quindi un flusso di lavoro basato su documenti ricorrenti può avere un'economia diversa rispetto a prompt brevi e non correlati.
La guida alle API di DeepSeek documenta l'accesso compatibile con OpenAI e Anthropic. Utilizza l'identificatore di modello esatto per il servizio scelto; la compatibilità con un formato di richiesta lascia comunque al comportamento del modello e alla gestione degli strumenti la necessità di una convalida.
La pagina delle API di DeepSeek Flash fornisce una rotta di accesso GPT Proto. Per una lista più ampia, confronta i migliori fornitori di LLM cinesi o esplora gli LLM cinesi per la programmazione.
Le sue tariffe basse ne giustificano una valutazione, ma non lo rendono più economico di ogni piccolo modello OpenAI.
5. Groq per applicazioni sensibili alla velocità
Groq è un'opzione per le applicazioni in cui gli utenti attendono direttamente l'output generato: assistenti interattivi, funzionalità a risposta breve e flussi di lavoro con diverse chiamate sequenziali al modello. Il suo valore dipende dal trovare un modello supportato che soddisfi i requisiti di qualità dell'attività.
Utilizza la documentazione sui modelli supportati di Groq per verificare disponibilità, limiti e specifiche di servizio pubblicate. Misura il tempo per la prima risposta utile e il tempo totale del flusso di lavoro nella tua applicazione; la cifra sulla velocità di generazione di un fornitore non include ogni ritardo di rete o dello strumento.
Groq fornisce un accesso compatibile con OpenAI, con campi non supportati documentati. Dispone anche di un'API per le risposte, ma la documentazione afferma che le applicazioni devono mantenere e rispedire autonomamente la cronologia della conversazione.
Scegli Groq quando la velocità di risposta è un requisito significativo del prodotto e il modello disponibile è adatto. Se l'app esistente dipende fortemente dalle conversazioni memorizzate, includi la gestione dello stato nella stima della migrazione. Sostituire il servizio di hosting e sostituire lo sviluppatore del modello sono decisioni separate.
6. Mistral per applicazioni incentrate sui documenti
Vale la pena prendere in considerazione Mistral per le applicazioni basate sull'acquisizione, l'estrazione e la risposta a domande su documenti. Uno strumento di elaborazione delle fatture, ad esempio, necessita di un'estrazione del testo affidabile prima di poter classificare un documento o spiegare una discrepanza.
Il suo catalogo API e i prezzi distinguono i modelli generici dai servizi OCR. Questo aiuta i team a stimare separatamente l'estrazione e la generazione, invece di trattare l'intero flusso di lavoro del documento come un'unica richiesta di chat.
La guida alla migrazione di Mistral copre le Chat Completions in stile OpenAI. La sua Responses API supporta la generazione di testo, input di file e immagini, chiamate di funzione e streaming. Al momento della revisione, è in anteprima pubblica ed è stateless: la tua applicazione fornisce la cronologia della conversazione.
Mistral è un candidato sensato quando l'elaborazione dei documenti è fondamentale per il prodotto. Valuta l'output di estrazione, la qualità delle risposte a valle e il costo di entrambe le fasi. Una migrazione della chat funzionante da sola non convalida un flusso di lavoro completo di elaborazione dei documenti.
7. OpenRouter per il routing dei provider e l'esplorazione dei modelli
OpenRouter è adatto ai team che desiderano confrontare i modelli e controllare quali provider sottostanti servono le loro richieste. Può anche essere utile quando un'applicazione necessita di una strategia esplicita di provider di backup.
Il routing introduce le proprie scelte. Decidi se le richieste possono spostarsi tra i provider, se ogni parametro richiesto deve essere supportato e quali requisiti di gestione dei dati si applicano. OpenRouter espone le preferenze del provider, le impostazioni di fallback e i controlli di supporto dei parametri; queste impostazioni meritano attenzione quando un'applicazione si basa su una funzionalità specifica.
Per una valutazione iniziale, mantieni fissi il provider e il modello in modo che le modifiche nei risultati siano più facili da analizzare. Quindi testa la configurazione di fallback prevista, inclusi i guasti e le differenze nella reportistica di utilizzo. Anche le commissioni di acquisto dei crediti e gli eventuali costi BYOK applicabili rientrano nella stima dei costi.
Scegli OpenRouter quando i controlli di routing sono un requisito primario. Il nostro confronto tra provider di API LLM spiega come differiscono gateway, piattaforme gestite e specialisti dell'inferenza.
Quali alternative all'API di OpenAI sono effettivamente più economiche
Esistono due decisioni di costo distinte. Puoi mantenere lo stesso modello tramite un provider di accesso diverso, oppure cambiare il modello che esegue il lavoro. La prima opzione offre un confronto diretto del prezzo per token. La seconda richiede una valutazione della qualità insieme al conto.
L'esempio seguente presuppone 10 milioni di token di input non memorizzati nella cache e 2 milioni di token di output fatturati al mese. Si tratta di uno scenario di utilizzo calcolato, non di un benchmark di pari qualità delle attività. L'output fatturato include i token di ragionamento laddove il provider li addebita come output. Commissioni per strumenti, tasse, scritture in cache e sconti per batch sono esclusi.
| Modello e percorso di accesso |
Input per 1M |
Output per 1M |
Costo stimato |
| GPT-6.1 Sol via OpenAI Standard |
$2.00 |
$10.00 |
$40.00 |
| GPT-6.1 Sol via GPT Proto |
$1.60 |
$8.00 |
$32.00 |
| GPT-6 Luna via OpenAI Standard |
$0.10 |
$0.50 |
$2.00 |
| Haiku 5.5 diretto, prompt fino a 100K |
$0.10 |
$0.50 |
$2.00 |
| DeepSeek Flash diretto, picco |
$0.30 |
$1.20 |
$5.40 |
| DeepSeek Flash diretto, fuori picco |
$0.15 |
$0.60 |
$2.70 |
| Gemini 3.1 Flash-Lite diretto, testo standard |
$0.25 |
$1.50 |
$5.50 |
Le tariffe provengono dalla pagina dei prezzi di OpenAI, dalla pagina di Sol di GPT Proto e dalle pagine dei prezzi di Anthropic, DeepSeek e Google collegate sopra.
L'esempio di Sol consente di risparmiare $8, ovvero il 20%, al volume di token indicato. Le righe dei modelli leggeri mostrano perché un'alternativa dovrebbe essere confrontata con il modello OpenAI di cui hai effettivamente bisogno. Un modello OpenAI piccolo può costare meno di un'alternativa più capace.
La soglia di 100K di Haiku si applica all'input di ogni richiesta, non al volume mensile. Le due righe di DeepSeek presuppongono che tutto l'utilizzo rientri nel periodo di prezzo indicato; il traffico misto produce una fattura combinata. Anche i tokenizer, lo sforzo di ragionamento e i tentativi di ripetizione possono modificare il numero di token consumati da un'attività. Per i carichi di lavoro degli agenti, confronta le API LLM convenienti in base all'idoneità all'attività, quindi monitora il costo per risultato accettato.
Quanto della tua integrazione OpenAI puoi mantenere
Inizia identificando le interfacce e i comportamenti utilizzati dall'applicazione. Una richiesta di saluto riuscita dice ben poco su un agente che utilizza strumenti.
| Dipendenza esistente |
Verifica prima della migrazione |
Possibile modifica dell'applicazione |
| Chat e streaming |
Campi di richiesta, formato evento, terminazione |
Configurazione client o parser di risposta |
| Chiamata di strumenti |
Argomenti, risultati degli strumenti, turno di follow-up |
Adattatore e convalida degli strumenti |
| Output strutturato |
Regole di schema applicate e casi di errore |
Modifiche allo schema e controlli lato applicazione |
| Conversazioni archiviate |
Archiviazione e recupero della cronologia |
Persistenza e riproduzione della cronologia |
| File o strumenti integrati |
Funzionalità equivalente e fatturazione |
Servizio di recupero o strumento separato |
Il resoconto di uno sviluppatore sulla portabilità dell'output strutturato descrive vincoli gestiti in modo diverso tra i vari provider. Consideralo come l'esperienza di un singolo professionista, quindi verifica il tuo schema esatto rispetto alla documentazione e alle risposte attuali.
Esegui richieste rappresentative attraverso l'integrazione candidata: traffico normale, input lunghi, uno strumento non riuscito e un output che viola il formato previsto. Registra i risultati accettati, l'utilizzo fatturato, il tempo di risposta e i tentativi. Per le applicazioni di programmazione, esegui anche la modifica generata attraverso i controlli del progetto stesso.
Mantieni un modo per riportare il traffico alla configurazione precedente durante la valutazione della sostituzione. Se stai ancora scegliendo una piattaforma complessiva per un nuovo prodotto, la più ampia guida alle API AI per sviluppatori copre tale decisione.
Alternative alle API Realtime Assistants e Moderation di OpenAI
Alternative alle API Realtime di OpenAI
Gemini Live API è un candidato per l'interazione vocale e visiva in tempo reale. Valuta la gestione delle interruzioni, i formati audio, il comportamento della sessione e il tempo di risposta vocale. Una pipeline che combina riconoscimento vocale, un LLM e sintesi vocale è un'altra architettura, ma le sue fasi separate aggiungono lavoro di integrazione e latenza. Il normale testo in streaming non è un sostituto equivalente per una sessione audio dal vivo.
Alternative alle API Assistants di OpenAI per agenti di produzione
Le API Assistants sono state dismesse il 26 agosto 2026, secondo la guida alla migrazione di OpenAI. I team che rimangono con OpenAI dovrebbero seguire il percorso di migrazione delle Risposte.
Per un design indipendente dal provider, combina un'API di modello scelta con un runtime di orchestrazione come LangGraph. I suoi componenti di stato e checkpointing possono supportare flussi di lavoro persistenti, ma il tuo team deve comunque implementare l'esecuzione degli strumenti, il recupero, l'archiviazione e il ripristino. Il cambio dell'endpoint del modello non migra automaticamente tali responsabilità né ricrea i vecchi thread.
Alternative alle API di moderazione di OpenAI per applicazioni di chat
Azure AI Content Safety offre analisi di testo e immagini per contenuti potenzialmente dannosi. Confronta categorie supportate, lingue, soglie, tempi di risposta e falsi positivi sugli esempi della tua applicazione.
La moderazione è una selezione separata dal modello conversazionale. Per chat creative o giochi di ruolo, il nostro confronto tra API di LLM non censurati affronta il comportamento del modello; un'applicazione deve comunque prendere le proprie decisioni su quali contenuti consentire e come applicarle.
Come provare le alternative alle API di OpenAI su GPT Proto
Inizia con un carico di lavoro che puoi valutare in modo coerente, come rispondere a domande di supporto o estrarre campi da un documento.
Scegli un modello. Apri il catalogo GPT Proto e confronta le opzioni pertinenti di Claude, Gemini o DeepSeek.
Apri le istruzioni di configurazione del modello. Utilizza "Prova questo modello" dove disponibile, o la sezione Utilizzo API. Copia le istruzioni specifiche del modello nel tuo assistente di programmazione o segui l'esempio visualizzato.
Configura l'integrazione. Crea una chiave API GPT Proto e utilizza l'ID modello, l'endpoint e il formato di richiesta mostrati in quella pagina. Mantieni le credenziali nella configurazione segreta dell'applicazione.
Valuta un piccolo set di richieste. Confronta risultati utili, utilizzo fatturato e tempo di risposta prima di espandere il traffico. Testa separatamente gli strumenti richiesti e gli output strutturati.