I migliori provider di API per app di compagnia AI a colpo d'occhio
| Provider |
Ideale per |
Funzionalità da valutare |
Principale compromesso |
| GPT Proto |
Combinare modelli di diversi laboratori con contenuti visivi |
Supporto per modelli di chat, immagini e video sotto un'unica chiave e bilanciamento |
La tua app deve ancora gestire lo stato del personaggio e la memoria persistente |
| OpenAI |
Integrazione diretta con i modelli vocali in tempo reale di OpenAI |
Testo, generazione di immagini, parlato e interazione audio in tempo reale |
L'accesso ad altre famiglie di modelli richiede integrazioni aggiuntive |
| Google Gemini API |
Prodotti che utilizzano l'ecosistema AI di Google |
Chat Gemini, interazione Live, generazione di immagini e modelli video |
L'input live e i media generati utilizzano funzionalità di modello diverse |
| Inworld |
Esperienze vocali in tempo reale configurabili |
STT, LLM selezionabili, TTS, oltre a inferenza di immagini e video |
La memoria tra sessioni richiede l'archiviazione e il ripristino da parte dell'applicazione |
| ElevenLabs |
Prodotti basati sulla voce che necessitano anche di contenuti visivi |
Agenti, voci configurabili e API per la generazione di immagini/video |
L'accesso alle API multimediali richiede un abbonamento |
| xAI |
Prodotti costruiti attorno a Grok |
Chat, API per la generazione di immagini/video Imagine e API vocali |
Ogni funzionalità ha i propri requisiti di richiesta e fatturazione |
Come abbiamo selezionato questi provider di API
Questa è una guida alla selezione basata sulla documentazione, verificata il 27 ottobre 2026. I consigli riflettono le funzionalità disponibili, i requisiti di integrazione e le strutture di fatturazione pubblicate. Non rappresentano una classifica misurata della qualità del dialogo o della velocità di risposta.
Ho dato priorità ai provider che uno sviluppatore potrebbe valutare per un prodotto di compagnia, considerando poi la scelta del modello, il supporto multimediale, il lavoro sull'applicazione e i costi. Un confronto utile deve spiegare se un servizio fornisce inferenza del modello, una pipeline di conversazione vocale o un'infrastruttura di prodotto aggiuntiva.
I progetti reali mostrano perché questa distinzione è importante. Il progetto open-source Utsuwa companion project configura separatamente i provider di LLM e di sintesi vocale (text-to-speech). La sua applicazione recupera la cronologia delle conversazioni, inserisce i ricordi pertinenti e adatta il contesto per adattarsi al modello selezionato. La selezione del provider è solo una parte di quel sistema.
Per ulteriori esempi, esplora le app di chat con personaggi e il loro utilizzo dei modelli di GPT Proto. Utilizza gli elenchi per indagare sui modelli applicativi e sulle scelte dei modelli. Non stabiliscono quale fornitore funzionerà meglio per la tua app.
6 provider di API da considerare per la tua app di compagnia
1. GPT Proto per combinare modelli di chat, immagini e video
GPT Proto è il punto di partenza più solido in questa breve lista se desideri confrontare diverse famiglie di modelli e aggiungere elementi visivi generati tramite lo stesso account. La sua API AI per il roleplay ti offre uno spazio per valutare i prompt dei personaggi e confrontare i modelli supportati prima di impegnarti con uno di essi.
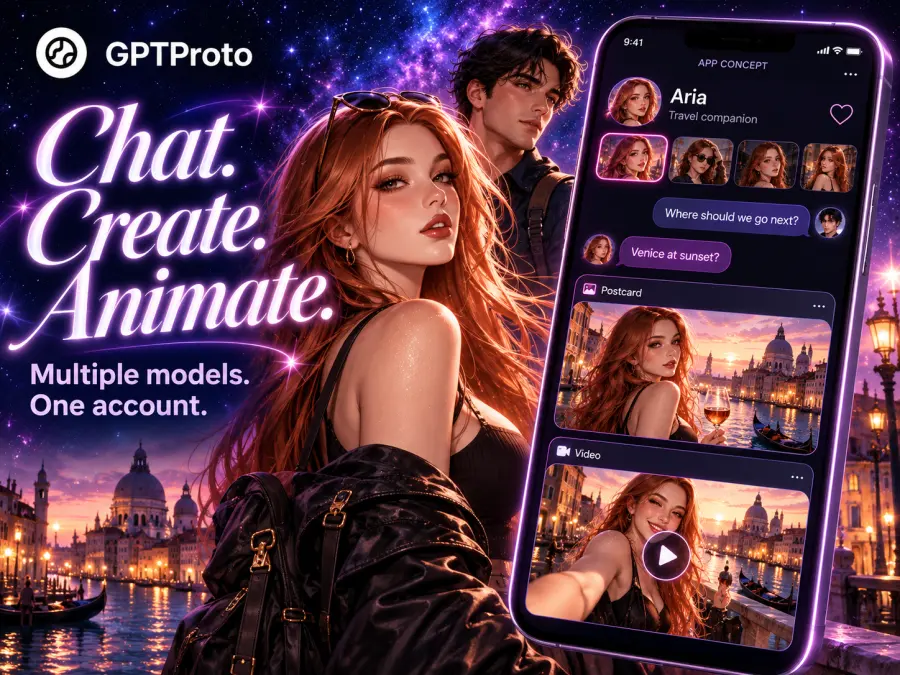
Immagina un compagno di viaggio immaginario: un modello di chat scrive la conversazione, un modello di immagini crea una cartolina dal personaggio e un modello video anima una scena. Questi compiti possono utilizzare modelli diversi. GPT Proto dispone di pagine dedicate per opzioni come generazione di immagini Nano Banana 2.1 e generazione video Kling 4.0, con esempi di richieste specifici per ogni modello.
L'accesso condiviso riduce il numero di account e saldi che il tuo team deve gestire. L'integrazione richiede comunque una gestione separata per ogni attività. Una richiesta di completamento chat e un lavoro video asincrono hanno cicli di vita differenti.
Per un riferimento concreto sui costi, GPT-6 Luna su GPT Proto indica 0,08 $ per milione di token in input e 0,40 $ per milione di token in output. Questo lo rende un candidato per esperimenti di chat economici; la qualità del personaggio richiede una valutazione a sé stante.
Scegli GPT Proto quando la flessibilità del modello e le funzionalità visive sono prioritarie. Integra memoria, autorizzazioni utente e stato del personaggio nella tua applicazione, e verifica separatamente qualsiasi funzionalità vocale in tempo reale richiesta.
2. OpenAI per l'accesso diretto ai modelli vocali in tempo reale
OpenAI è una scelta pratica quando i requisiti del tuo prodotto si concentrano sui suoi modelli e sull'interazione vocale in tempo reale. La Realtime API elabora l'audio direttamente, mantiene lo stato della conversazione e supporta gli strumenti. Il suo flusso documentato per browser utilizza un client secret effimero e WebRTC; le connessioni al server possono utilizzare WebSocket.
Ciò è utile per un compagno vocale che deve gestire interruzioni o richiamare uno strumento durante la conversazione. Puoi sviluppare basandoti sull'API originale e sui suoi SDK, con meno servizi intermedi da analizzare quando una funzionalità specifica del modello si comporta in modo imprevisto.
Il limite è la scelta dei modelli tra i vari fornitori. Se in futuro il tuo prodotto necessitasse dello stile di dialogo di un altro laboratorio o di un modello di immagini diverso, dovrai aggiungere tale integrazione autonomamente. Anche lo stato della conversazione archiviato richiede una progettazione esplicita per la cronologia dell'utente e il recupero della memoria.
Per i video, controlla attentamente la disponibilità attuale. L'avviso di deprecazione di OpenAI elenca la chiusura dell'API Videos e dell'API Sora 2 il 24 settembre 2026. Un vecchio tutorial accessibile non è prova sufficiente che il suo endpoint rimanga disponibile.
Scegli OpenAI quando l'accesso diretto alle sue funzionalità in tempo reale supera la necessità di cambiare famiglia di modelli.
3. Google Gemini API per app basate su Google AI
Vale la pena prendere in considerazione Google se utilizzi già il suo ecosistema di sviluppo e desideri valutare funzionalità di conversazione, input visivo, immagini generate e video all'interno di tale ambiente.
L'API Gemini Live supporta interazioni in streaming, con connessioni WebSocket lato frontend o backend. Google consiglia token effimeri per le connessioni client in produzione. Questo può essere adatto a un companion che risponde a input vocali e informazioni provenienti da una fotocamera o da uno schermo condiviso.
Il video generato è una selezione a parte. L'attuale guida video di Gemini indirizza gli sviluppatori verso Gemini Omni Flash e lo distingue dagli endpoint fuori produzione Veo 3.1 Preview. Per un personaggio che invia un breve messaggio animato, valuta un modello di generazione invece di dare per scontato che l'input video Live fornisca tale output.
Il lavoro pratico consiste nel selezionare e testare i modelli giusti per ogni funzionalità. Un prodotto potrebbe richiedere impostazioni, limiti di utilizzo e calcoli di fatturazione diversi per chat, voce e contenuti multimediali. Mantieni separati questi costi nelle tue previsioni.
Scegli Google quando il suo ecosistema si adatta alla tua app e ti senti a tuo agio nel selezionare modelli diversi per interazioni diverse.
4. Inworld per pipeline vocali in tempo reale configurabili
Inworld merita un'attenzione particolare quando la conversazione vocale è centrale per l'esperienza. La sua API Realtime combina speech-to-text, l'LLM scelto e text-to-speech, gestendo al contempo il rilevamento dei turni e le interruzioni tramite WebSocket o WebRTC.
Dispone inoltre di una copertura multimediale più ampia. Inworld Inference espone modelli di testo, immagini e video, quindi descrivere la piattaforma come un servizio solo vocale significherebbe ignorare parte della sua offerta.
Il limite importante è la memoria persistente. La sua documentazione sulla memoria a lungo termine spiega che le sessioni in tempo reale sono temporanee. Il tuo client deve salvare la memoria esternamente e ripristinarla per una sessione futura. Questa è una responsabilità concreta dell'applicazione da includere nelle stime di sviluppo.
Per la valutazione dei costi, monitora separatamente il riconoscimento vocale, il consumo di LLM e il parlato generato, quindi aggiungi l'utilizzo dei media. Un prezzo unitario TTS basso non stabilisce il prezzo di un'intera conversazione.
Scegli Inworld quando l'interazione vocale configurabile è un requisito fondamentale e desideri ridurre il lavoro di orchestrazione. Pianifica il database e il flusso di ripristino della memoria insieme all'integrazione vocale.
5. ElevenLabs per app basate sulla voce con funzionalità visive
ElevenLabs è un candidato ideale quando desideri che la configurazione vocale e i controlli di conversazione facciano parte della piattaforma che acquisti. ElevenAgents supporta la selezione del modello linguistico, la gestione dei turni, le interruzioni e il deployment tramite integrazioni web e mobile.
La sua offerta di immagini e video cambia il confronto. La guida all'API di immagini e video documenta endpoint di generazione asincroni separati, con risultati raccolti tramite webhook o polling. L'accesso richiede un piano Pro o superiore e le relative autorizzazioni API.
Tale requisito di abbonamento è importante per un piccolo prototipo. Confronta l'utilizzo previsto delle funzionalità con i servizi disponibili nel piano che intendi acquistare. Le generazioni multimediali consumano crediti in base al modello, alle impostazioni e agli input selezionati; un plafond vocale non dovrebbe essere considerato come un budget multimediale illimitato.
Esiste un'altra distinzione sui costi: la documentazione del modello agente contabilizza separatamente l'utilizzo di LLM di terze parti. Stima la configurazione della conversazione che effettivamente implementerai, invece di utilizzare il prezzo vocale di riferimento come totale.
Scegli ElevenLabs quando la configurazione vocale e gli strumenti per agenti giustificano i requisiti della piattaforma. Verifica l'accesso ai contenuti multimediali prima di progettare funzionalità di immagini o video dei personaggi basate su di esso.
6. xAI per app basate sui modelli Grok
xAI è rilevante quando desideri specificamente Grok come modello conversazionale e vuoi valutare le relative funzionalità multimediali e vocali.
La documentazione di Imagine copre la generazione e la modifica di immagini insieme alla generazione di video. Ciò offre agli sviluppatori un percorso per testare una conversazione tra personaggi e contenuti visivi generati all'interno dell'ecosistema dello stesso fornitore.
La voce dovrebbe essere valutata attraverso la sua documentazione dell'API vocale. Mantieni l'interazione vocale, la chat testuale e le clip generate come elementi di integrazione e budget separati, anche quando condividono lo stesso account.
Stai ancora costruendo il prodotto companion. Un'API di modello non fornisce automaticamente le risorse del personaggio, lo stato della relazione persistente o l'interfaccia presenti in un'app companion consumer. Verifica gli input, gli output e i controlli effettivi dell'API rispetto alle funzionalità presenti nelle tue specifiche.
Scegli xAI quando Grok stesso fa parte della decisione sul prodotto. Se la tua priorità è confrontare molte famiglie di modelli, includi nella valutazione anche un servizio multi-modello.
Quanto costa realmente un'app di compagnia AI
Un preventivo basato sui token diventa utile quando lo si collega a un carico di lavoro definito. Le conversazioni lunghe possono richiedere il reinvio delle istruzioni del personaggio, delle memorie recuperate e della cronologia recente a ogni richiesta. Misura l'input inviato dalla tua applicazione.
Ecco un carico di lavoro ipotetico basato solo su testo: 1.000 sessioni, 50 risposte per sessione, una media di 2.000 token di input per richiesta e 200 token di output fatturati per risposta. Ciò produce 100 milioni di token di input e 10 milioni di token di output.
| Stesso modello e carico di lavoro |
GPT Proto GPT-6 Luna |
OpenAI GPT-6 Luna |
| Prezzo di input per milione di token |
$0.08 |
$0.10 |
| Prezzo di output per milione di token |
$0.40 |
$0.50 |
| Costo per 100 milioni di token di input |
$8 |
$10 |
| Costo per 10 milioni di token di output |
$4 |
$5 |
| Stima totale dell'inferenza testuale |
$12 |
$15 |
Le tariffe provengono dalla pagina del modello di GPT Proto e dalla documentazione del modello OpenAI GPT-6 Luna. Questo calcolo utilizza tariffe standard per testo non memorizzato nella cache e non presuppone alcun output di ragionamento oltre alla quota di token dichiarata. Esclude i costi di scrittura nella cache, i tentativi, i media, l'elaborazione della memoria, l'archiviazione e le tasse. Si tratta di un'illustrazione dei costi di acquisto, non di un confronto misurato sulla qualità della compagnia.
Per un prodotto multimodale, aggiungi il seguente utilizzo alla previsione:
| Funzionalità |
Cosa misurare |
| Memoria persistente |
Chiamate di estrazione o riepilogo, embedding utilizzati, recupero e archiviazione |
| Immagini del personaggio |
Immagini richieste, risoluzione, input di riferimento e generazioni ripetute |
| Video brevi |
Durata generata, risoluzione, risorse di input, impostazioni audio e tentativi fatturati |
| Conversazione vocale |
Riconoscimento, utilizzo LLM, output vocale ed eventuali costi di piattaforma o connessione |
Anche la latenza rientra nella valutazione del prodotto. In un account di sviluppo per companion desktop, l'autore ha combinato l'inferenza cloud con la sintesi vocale locale e la memoria del database, segnalando poi i ritardi dovuti alle chiamate agli strumenti. È un'esperienza individuale, ma illustra perché un modello di testo veloce da solo non può determinare il tempo di attesa percepito dagli utenti.
Collega un modello di chat e pianifica il tuo flusso di lavoro multimediale
Inizia con una breve conversazione con il personaggio. Crea una chiave API GPT Proto, aggiungi credito e imposta la variabile d'ambiente GPTPROTO_API_KEY sul tuo server. La pagina del modello GPT-6 Luna fornisce l'esempio di utilizzo dell'API corrente.
curl --fail-with-body --silent --show-error \
  https://gptproto.com/v1/chat/completions \
  -H "Authorization: Bearer $GPTPROTO_API_KEY" \
  -H "Content-Type: application/json" \
  --data '{
    "model": "gpt-6-luna",
    "messages": [
      {
        "role": "system",
        "content": "You are Mira, a fictional travel companion. Be warm and concise."
      },
      {
        "role": "user",
        "content": "I have one free afternoon in Kyoto and prefer quiet places."
      }
    ]
  }'
Leggi la risposta da choices[0].message.content. Questa richiesta fornisce un'istruzione per il personaggio e un messaggio. Per continuare il dialogo, il tuo backend deve assemblare la conversazione e i ricordi rilevanti per ogni chiamata. Mantieni la chiave API permanente fuori dal codice del browser e dai bundle mobili.
Successivamente, seleziona un modello di immagine o video dalla sua pagina dedicata. Utilizza le istruzioni di utilizzo dell'API della pagina del modello quando chiedi al tuo assistente di programmazione di creare l'integrazione. Mantieni l'endpoint documentato, l'autenticazione, i parametri e il flusso di gestione dei risultati.
Un'attività multimediale asincrona richiede un ID lavoro salvato e un gestore di completamento. La tua interfaccia può mostrare un'immagine o un video in sospeso mentre la chat continua. Collegare ogni attività all'endpoint di completamento della chat non riprodurrà quelle funzionalità separate.
Quale provider API dovresti scegliere
| Il tuo primo traguardo di prodotto |
Lista di candidati |
Cosa convalidare prima di impegnarsi |
| MVP di compagno testuale |
GPT Proto o un'API a modello diretto |
Comportamento del personaggio, costo per conversazione, gestione della memoria |
| Chat più immagini e clip del personaggio |
GPT Proto, Google, Inworld, ElevenLabs o xAI |
Disponibilità esatta del modello, accesso ai media, riferimenti e flusso di completamento delle attività |
| Compagno vocale in tempo reale |
OpenAI, Inworld, ElevenLabs o Gemini Live |
Interruzioni, prima risposta udibile, coerenza vocale e costo totale della sessione |
| Prodotto costruito specificamente attorno a Grok |
xAI |
Funzionalità API richieste e lavoro applicativo oltre l'accesso al modello |
Per un team che sta ancora esplorando il proprio modello di dialogo e le funzionalità visive, inizierei con GPT Proto e una piccola valutazione ripetibile. Usa le stesse istruzioni per il personaggio e la cronologia della conversazione, quindi confronta i modelli supportati prima di costruire il resto del prodotto attorno a uno di essi.
La selezione del modello merita un passaggio separato. La nostra guida sui migliori modelli AI per il gioco di ruolo si concentra sui modelli di dialogo sottostanti. Usala per restringere i candidati, quindi testa i tuoi personaggi e i pattern di sessione.
Inizia con l'API AI di GPT Proto per il gioco di ruolo per confrontare una conversazione con un personaggio e aggiungi la generazione visiva una volta che l'esperienza di chat soddisfa i tuoi requisiti.