Kimi K3.1 Pro vs Opus 5.5 a confronto
| Elemento |
Kimi K3.1 Pro |
Claude Opus 5.5 |
| Prezzo ufficiale input / output per 1M di token |
$2 / $10 |
$4 / $20 |
| Prezzo GPT Proto input / output per 1M di token |
$2 / $10 |
$3.60 / $18 |
| Finestra di contesto |
Circa 1M di token |
1M di token |
| Input / output del modello |
Testo e immagini / testo |
Testo e immagini / testo |
| Livello di ragionamento predefinito API nativa |
Massimo |
Medio |
| La mia prova consigliata |
Attività delimitate con controlli chiari |
Sviluppo complesso e revisione finale |
I prezzi sono stati verificati il 29 ottobre 2026. Le specifiche ufficiali provengono dalla documentazione dell'API Kimi e dalla documentazione del modello Claude. Le tariffe di GPT Proto sono elencate nella pagina dell'API Kimi K3.1 Pro e nella pagina dell'API Claude Opus 5.5. Le operazioni di cache e altri costi applicabili richiedono una contabilizzazione separata.
Per un confronto rapido del catalogo, utilizza la pagina di confronto Kimi K3.1 Pro vs Claude Opus 5.5. Per il contesto su questa versione di Kimi, vedi cosa è cambiato in Kimi K3.1 Pro.
Cosa ci dicono i benchmark sulla programmazione e cosa tralasciano
Il confronto di lancio pubblicato da Moonshot riporta il 65,7% per Kimi K3.1 Pro e il 66,4% per Opus 5.5 su Terminal-Bench 4.0. Si tratta di cifre pubblicate dal fornitore, in attesa di una verifica indipendente di tale confronto specifico. Supportano l'idea di prendere sul serio Kimi per il lavoro basato su terminale; non stabiliscono prestazioni equivalenti nello sviluppo di applicazioni.
Il quadro indipendente più ampio è diverso. Il 29 ottobre, le pagine dei modelli dell'Artificial Analysis Intelligence Index v5.0 mostravano Kimi a 46 e Opus a 58, con quest'ultimo etichettato come Max con Fallback predefinito. Quei punti dell'indice non sono percentuali o tassi di successo nella programmazione. Mantieni la versione dell'indice e la configurazione associate al confronto.
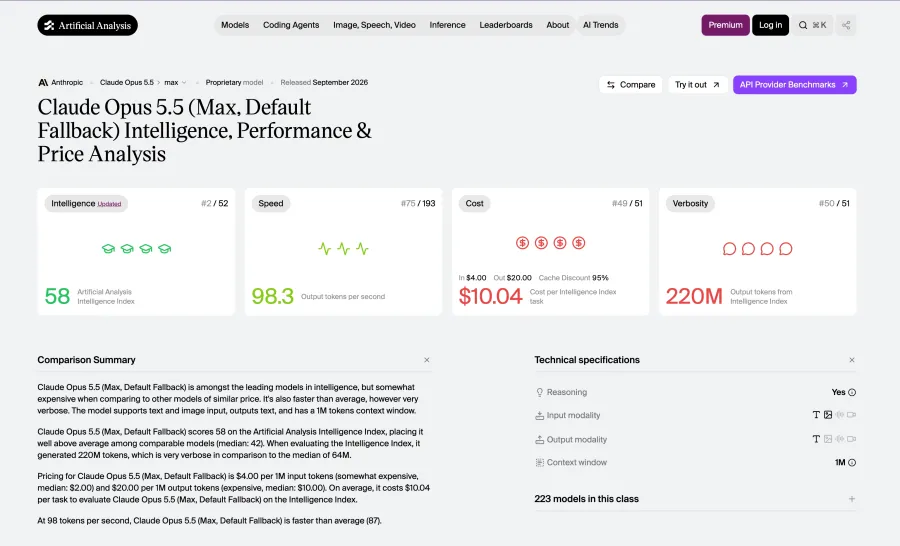
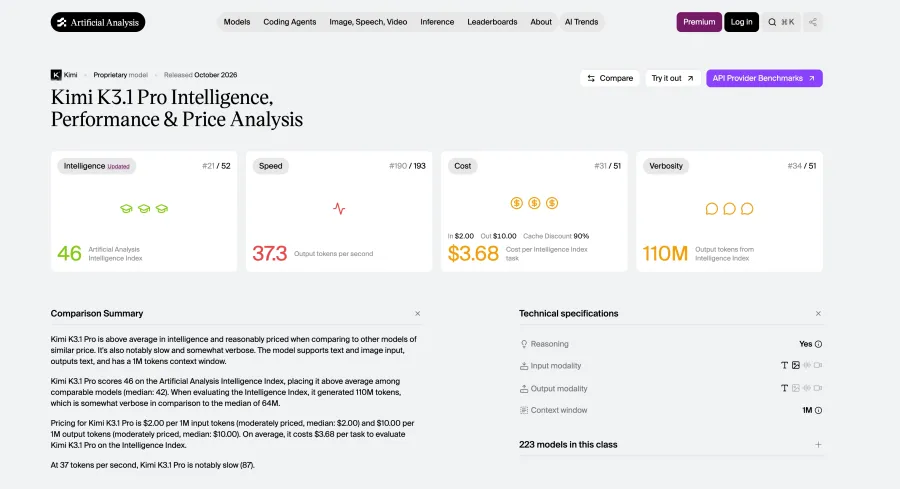
Tratterei Opus come la linea di base di qualità iniziale per lavori impegnativi, per poi testare se Kimi soddisfa gli stessi criteri di accettazione a un costo inferiore. Un benchmark di terminale non può dirti se un modulo di prenotazione mantiene il suo stato o se una dashboard rimane leggibile su mobile. I tuoi test applicativi devono rispondere a questo.
Sviluppo Frontend: Da uno screenshot a un'interfaccia funzionante
Per un'attività di conversione da screenshot a interfaccia, separa l'aspetto dal comportamento. Un layout fedele necessita comunque di una navigazione funzionante, stati dei moduli, accesso da tastiera e una versione mobile utilizzabile. Successivamente, richiedi una modifica. Aggiungere un filtro senza compromettere il layout esistente è un test diverso rispetto alla generazione di una pagina da zero.
Esiste un utile esempio per sviluppatori a riguardo. Nel confronto pubblicato da Melvynx, l'autore ha preferito il trattamento visivo di Opus per un selettore di fusi orari. Si tratta di un giudizio estetico su una singola build, piuttosto che di un tasso di successo misurato nello sviluppo frontend.
Per un sito di marketing o una dashboard rivolta ai clienti, la mia prima scelta sarebbe Opus quando il design richiede distinzione e perfezionamenti ripetuti. Kimi è un candidato sensato per un'interfaccia interna con un design system chiaro, specialmente quando è possibile ispezionare il risultato prima del rilascio. Il compromesso è il tempo speso a correggere ciò che il prompt iniziale lascia in sospeso.
Considera un'interfaccia di prenotazione come brief di valutazione. Fornisci a entrambi i modelli la stessa immagine di riferimento, la libreria di componenti esistente e i requisiti per la selezione della data, gli slot non disponibili, la convalida e la conferma. Chiedi a ciascuno di collegare l'interfaccia alla stessa API mock. Successivamente, introduci una richiesta fallita e verifica se l'utente può recuperare l'operazione senza perdere i dati del modulo.
Quest'ultimo passaggio rende il test un confronto tra applicazioni. Rivela se una pagina attraente è anche in grado di gestire l'azione successiva dell'utente.
App interattive e 3D: Qualità visiva, logica e prestazioni in runtime
Il caso di Kimi diventa più interessante nel lavoro visivo interattivo. L'esempio della lampada di lava di Melvynx includeva controlli per l'illuminazione e il colore. Ha valutato come migliore il risultato di Opus, che ha richiesto un maggiore sforzo, pur trovando convincenti i materiali e gli effetti di vetro di Kimi. I costi di esecuzione riportati sono stati di 2,30 $ per Kimi High e 4,16 $ per Max, contro i 4,35 $ per Opus Medium e 6,39 $ per Extra High.
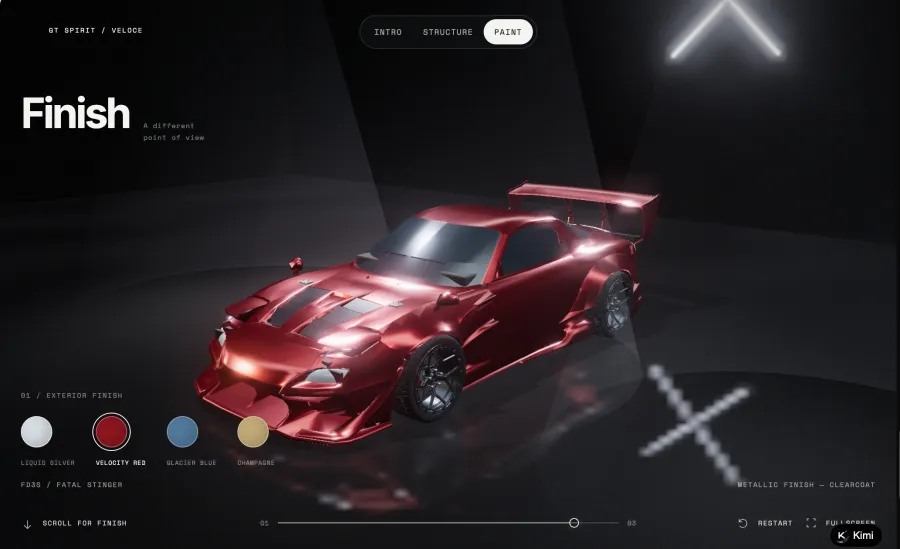
La stessa recensione descrive una simulazione di crash che ha funzionato meglio con Kimi High rispetto a Max. L'autore dichiara la presenza di un link di affiliazione a Kimi e l'uso di uno spazio di lavoro condiviso e non isolato. Questi esempi sono osservazioni utili, con i relativi limiti del caso.
La mia interpretazione è che valga la pena testare Kimi per configuratori di prodotto, demo educative e prototipi visivi. Scegliere automaticamente un'impostazione a sforzo maggiore significherebbe perdere una delle lezioni pratiche di quegli esempi. Inizia con un requisito esplicito e ispeziona l'artefatto.
Per un configuratore di mobili, definisci cosa deve cambiare quando qualcuno seleziona un materiale, cambia la vista della telecamera o ripristina il design. Verifica se il prezzo visualizzato corrisponde alla selezione. Ricarica la pagina. Prova i controlli su uno smartphone. Una sedia visivamente accattivante è solo una parte del risultato finale.
L'accuratezza tecnica richiede controlli specifici. I risultati BenchCAD di Moonshot riportano il 92,7% per Kimi e il 96,2% per Opus con strumenti, utilizzando una metrica di ricostruzione geometrica. Quel risultato pubblicato dal fornitore risponde a una domanda diversa rispetto a quella sull'attrattiva visiva di una scena. Un'animazione convincente necessita comunque di una convalida separata prima di essere utilizzata per insegnare la fisica o rappresentare un processo ingegneristico.
Per un prototipo, proverei prima Kimi. Per un'applicazione che richiede precisione, inizierei con Opus e richiederei controlli specifici per il dominio, indipendentemente dal modello che genera il codice.
Sviluppo Agente: Il modello è in grado di completare un'attività a più fasi?
Un agente che lavora in un repository deve comprendere il comportamento esistente, scegliere i file da modificare, eseguire strumenti, interpretare gli errori e decidere quando fermarsi. Gli errori possono accumularsi tra queste fasi.
Entrambi i fornitori pubblicano esempi di lavoro esteso. Moonshot descrive Kimi mentre diagnostica e corregge un simulatore prima di riaddestrare un controller di movimento. Il rapporto di lancio di Opus 5.5 di Anthropic descrive miglioramenti in un'applicazione web, inclusa un'attività di caricamento completata con successo in 39 prove su 40. Si tratta di esempi separati forniti dai vendor, piuttosto che di un test diretto condiviso.
Per un'applicazione di fatturazione esistente, un confronto utile sarebbe l'aggiunta di importazioni CSV. Richiedere la mappatura dei campi, la gestione delle righe non valide, il rilevamento dei duplicati, un'anteprima e test che coprano il comportamento esistente. Lascia che ogni modello lavori dallo stesso snapshot del repository e ispeziona entrambe le patch. Un riepilogo che dice “tutti i test superati” deve essere supportato da un log dei test.
Per quel tipo di modifica tra più file, Opus sarebbe il mio punto di partenza predefinito. Kimi è più facile da valutare su una parte limitata del lavoro, come l'implementazione della convalida rispetto a uno schema concordato. Espandi il suo ambito dopo che i test hanno stabilito che può gestire l'applicazione circostante.
Anche la configurazione è importante. La guida all'uso degli strumenti di Kimi richiede di mantenere il messaggio completo dell'assistente tra i vari turni. La documentazione di Opus di Claude descrive il pensiero specifico del modello e il comportamento degli strumenti. Verifica questi dettagli sul percorso scelto; la corrispondenza con un formato di richiesta di base non stabilisce un comportamento identico dell'agente.
Prezzi e costi: quanto costa effettivamente un risultato accettato?
Kimi K3.1 Pro ha le tariffe standard di input e output più basse. La domanda più difficile è di quanti tentativi, riprovazioni e cicli di revisione ha bisogno la tua attività.
Ecco un esempio di pianificazione utilizzando le tariffe elencate di GPT Proto. Supponiamo che ogni tentativo utilizzi 1 milione di token di input non memorizzati nella cache e 200.000 token di output fatturati. Questi sono volumi ipotetici, non risultati osservati dell'applicazione.
| Scenario di pianificazione |
Kimi K3.1 Pro |
Claude Opus 5.5 |
| Un tentativo ai volumi dichiarati |
$4.00 |
$7.20 |
| Due tentativi, ciascuno agli stessi volumi |
$8.00 |
$14.40 |
Secondo queste ipotesi, un risultato di Kimi che richiede due tentativi costa più in token di un risultato di Opus accettato dopo uno solo. I tentativi reali raramente ripetono esattamente gli stessi volumi di token, quindi utilizza i tuoi record di utilizzo per il calcolo effettivo.
La memorizzazione nella cache cambia nuovamente il confronto. Entrambi i fornitori elencano le letture ufficiali della cache a $0,20 per 1 milione di token nella loro documentazione Kimi e Claude. Una lunga sessione dell'agente con numerosi hit della cache avrà un rapporto di costo diverso rispetto a una richiesta nuova. Controlla anche le spese di scrittura nella cache, l'utilizzo dell'output e le tariffe effettive del tuo provider.
Per un team, monitorerei il costo per attività accettata insieme al tempo trascorso e ai minuti di revisione. Una bozza più economica può essere un buon valore quando controllarla è rapido. Diventa meno interessante quando uno sviluppatore deve ricostruire ciò che l'agente ha modificato prima di potersi fidare.
Come confrontare entrambi i modelli sulla tua app tramite GPT Proto
Utilizza una piccola modifica all'applicazione con risultati osservabili. Un modulo di prenotazione, un importatore CSV o un configuratore di prodotto ti forniscono prove più utili rispetto a una richiesta generica di “costruire qualcosa di impressionante”.
Apri la pagina del modello Kimi e la pagina del modello Opus. Usa "Prova questo modello" e "Avvio rapido" per ottenere la guida all'integrazione, quindi copia le istruzioni Markdown nel tuo assistente di programmazione. Mantieni la tua chiave API in una variabile d'ambiente locale o nella configurazione lato server.
Prima di valutare la qualità dello sviluppo, verifica che entrambi i percorsi dei modelli rispondano. Questo esempio di connessione segue il formato Chat Completions pubblicato sulle pagine dei modelli. Imposta GPTPROTO_API_KEY localmente prima di eseguirlo; le richieste consumano token a pagamento.
for model in kimi-k3.1-pro claude-opus-5-5; do
  curl --fail-with-body --silent --show-error --max-time 180 \
    https://gptproto.com/v1/chat/completions \
    -H "Authorization: Bearer $GPTPROTO_API_KEY" \
    -H "Content-Type: application/json" \
    --data "{
      \"model\": \"$model\",
      \"messages\": [{\"role\": \"user\",
        \"content\": \"Return only: API connection OK\"}]
    }"
done
Questo verifica la connettività, non la qualità del codice. Le API native hanno impostazioni di ragionamento predefinite diverse; configura e registra le impostazioni di impegno supportate prima di un confronto applicativo. Una risposta API necessita anche di un agente o di un'applicazione di supporto per modificare file, eseguire strumenti e ispezionare un browser.
Per la prova di sviluppo, avvia ogni modello da una copia pulita dello stesso progetto. Fornisci lo stesso compito, le stesse autorizzazioni, dipendenze e test di accettazione. Registra il percorso del modello, l'impegno, l'utilizzo fatturato, il tempo di completamento e le modifiche manuali richieste. Ripeti l'attività prima di rendere una piccola differenza il tuo standard di produzione.
Se l'endpoint restituisce un errore di autenticazione, controlla la chiave e l'intestazione di autorizzazione. Se un parametro opzionale viene rifiutato, confrontalo con la guida attuale della pagina del modello. Verifica che una risposta corretta contenga l'output del modello desiderato prima di espandere il lavoro.
Quale modello dovresti scegliere?
| Il tuo carico di lavoro |
La mia scelta iniziale |
Condizione per mantenerlo |
| Frontend rivolto al cliente con revisioni di design ripetute |
Opus 5.5 |
Un output accettato migliore giustifica il costo |
| Prototipo interattivo o esperimento visivo |
Kimi K3.1 Pro |
I controlli funzionano e l'artefatto è facile da ispezionare |
| Modifiche complesse in un'applicazione esistente |
Opus 5.5 |
I test del repository e la revisione supportano la scelta |
| Implementazione ripetuta basata su una specifica fissa |
Kimi K3.1 Pro |
I controlli automatizzati mantengono bassi i costi di correzione |
| Codice o simulazione sensibili alla precisione |
Opus come baseline iniziale |
È richiesta una validazione esterna per entrambi i modelli |
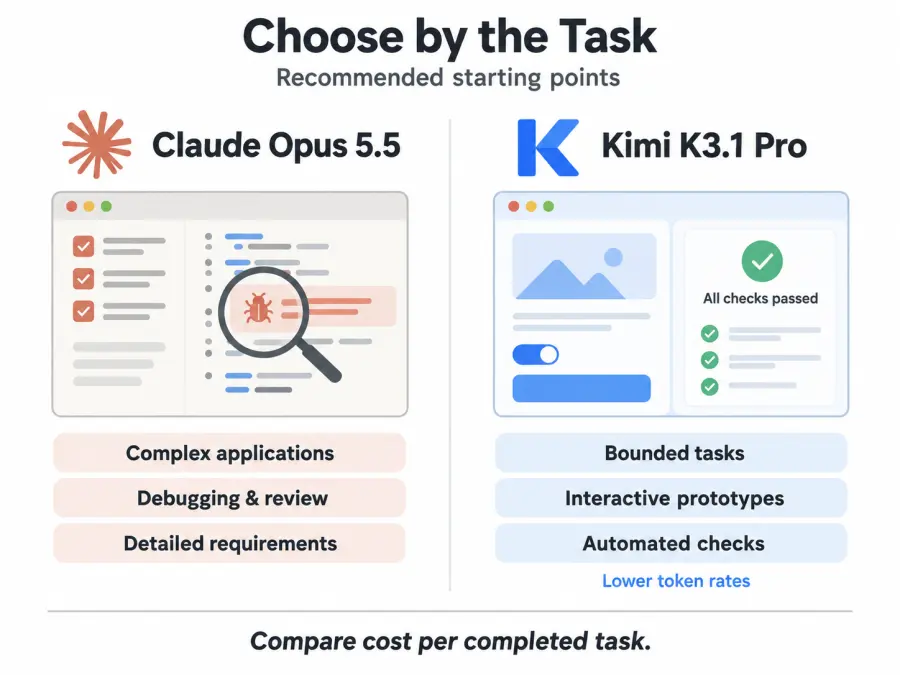
Sceglierei Opus 5.5 come impostazione predefinita iniziale per un team che affida un lavoro applicativo sostanziale a un agente. Le prove di valutazione più ampie supportano questa scelta, mentre sarà il repository effettivo a decidere se il premio di prezzo è giustificato.
Kimi K3.1 Pro è un candidato pratico per ridurre i costi di un lavoro ben definito. Inizia con attività che puoi ispezionare o testare, misura i risultati accettati e aumenta le sue responsabilità man mano che le prove migliorano. Questa è una ragione più valida per cambiare rispetto a un quasi pareggio su un singolo benchmark.
Porta un piccolo compito alle pagine API di Kimi K3.1 Pro e API di Claude Opus 5.5, utilizza le guide all'integrazione e confronta il risultato che la tua applicazione può accettare.