Hoe we modellen voor SillyTavern hebben gerangschikt
Het belangrijkste bewijs is de September 2026 AI Roleplay Bench, die 14 officiële modellen in 10 categorieën testte en 840 antwoorden beoordeelde. De categorieën omvatten companion-chat, Game Master-gedrag, strikte karakterstem, schurken, robuustheid, volwassen thema's en veiligheidsgrenzen. Kimi K3, GLM-5.3 en DeepSeek V4.1 Flash liggen minder dan twee punten uit elkaar, dus de benchmark zelf adviseert om ze als een effectieve gelijke stand te beschouwen in plaats van een decimaal als een doorslaggevende overwinning te zien.
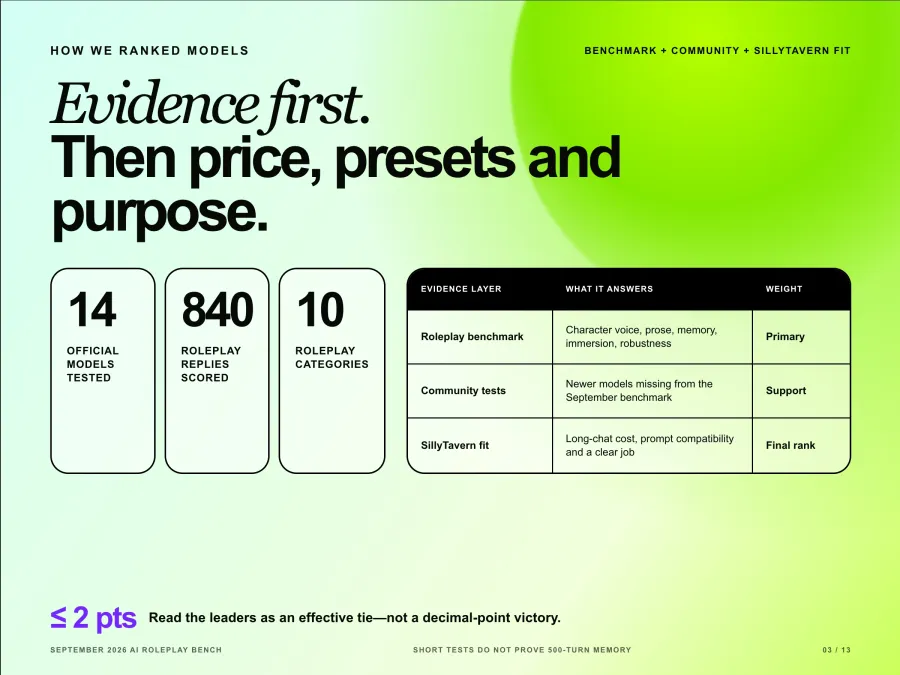
De benchmark heeft ook beperkingen. De gepubliceerde methodologie gebruikt korte scenario's met meerdere beurten, meet geen drift over honderden berichten en sluit door de community gemaakte fine-tunes uit. Nieuwere releases zoals Gemini 4 Argon kwamen ook pas na die test uit. Voor die modellen gebruik ik vergelijkingen uit de community als ondersteunend bewijs en markeer ik de aanbeveling als minder zeker.
De uiteindelijke ranglijst voegt drie SillyTavern-specifieke factoren toe:
Economie van lange chats. Input-tokens domineren meestal latere beurten omdat SillyTavern de karakterkaart, instructies, relevante lore en gespreksgeschiedenis opnieuw verstuurt.
Compatibiliteit met prompts en presets. Chat Completion, Text Completion, instruct-templates, samplers en redeneercontroles zijn niet uitwisselbaar.
Een duidelijke taak voor elk model. Een goedkoper model verdient alleen een plek als het een nuttige rol heeft, niet simpelweg omdat de prijs laag is.
De 8 beste AI-modellen voor SillyTavern Roleplay
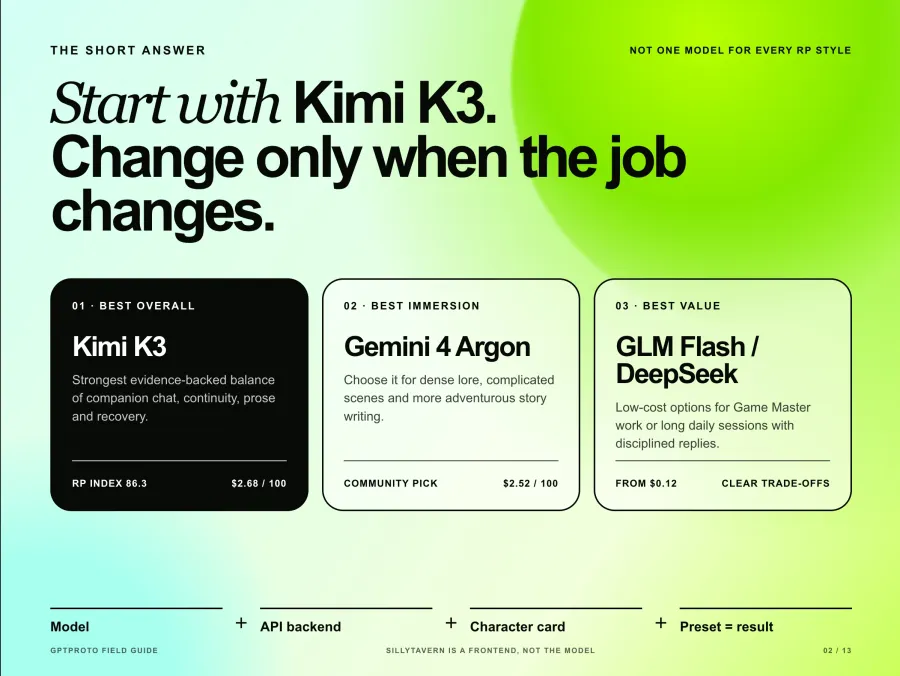
1 Kimi K3 Beste algehele SillyTavern-model
Kimi K3 is de veiligste eerste keuze wanneer je nog niet weet welke roleplay-stijl je verkiest. Het scoorde 86,3 in totaal, 90,0 voor Companion en 88,3 voor robuustheid in de roleplay-benchmark. Het leidde ook de beoordelingen van de benchmark voor karakter, proza, geheugen en immersie.
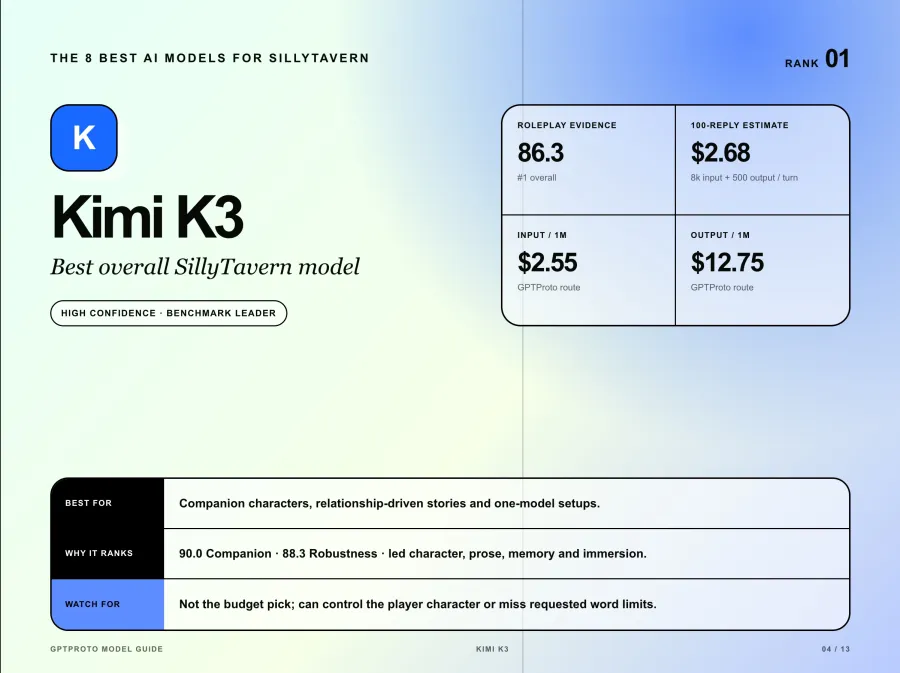
Die balans is in SillyTavern belangrijker dan een enkel flitsend antwoord. Kimi kon goed omgaan met berichten van één woord van de gebruiker, onthield geplaatste details en hield het karakter actief in plaats van te veranderen in een generieke assistent. De zwakke punten waren concreet: het bestuurde soms het karakter van de speler als Game Master en miste gevraagde woordlimieten.
Beste pasvorm: companion-karakters, relatiegerichte verhalen en gebruikers die één model willen voor verschillende RP-stijlen. SillyTavern startpunt: gebruik Chat Completion, de exacte kimi-k3 model-ID en een gematigde antwoordlengte voordat je complexere preset-regels toevoegt. Met $2,55 input en $12,75 output per miljoen tokens is het niet de budgetkeuze.
2 Gemini 4 Argon Beste voor meeslepende roleplay
Gemini 4 Argon is de sterkste recente favoriet van de community voor dichte lore, ingewikkelde scènes en het schrijven van verhalen in lange vorm. SillyTavern-gebruikers prijzen de precisie bij grote prompts en het vermogen om nuttige scènedetails toe te voegen in plaats van alleen de karakterkaart te parafraseren. Een gedetailleerde communitydiscussie over het gebruik voor lange verhalen beschreef een duidelijke verbetering nadat hetzelfde verhaal op andere modellen was gaan stagneren.
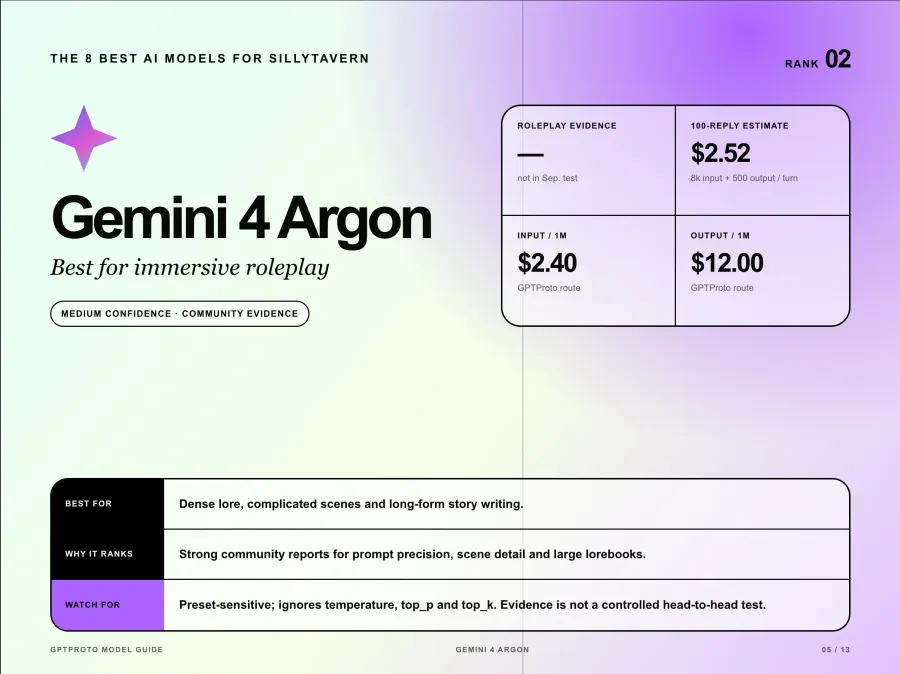
Het betrouwbaarheidsniveau is lager dan bij Kimi of GLM omdat Argon niet was opgenomen in de roleplay-benchmark van september. Het enthousiasme van de community is een aanwijzing, maar het is geen gecontroleerde vergelijkingstest.
Argon heeft ook zijn eigen preset nodig. De API negeert temperature, top_p en top_k, dus het kopiëren van een oudere Gemini-preset die zwaar leunt op samplers creëert de illusie van controle zonder die waarden daadwerkelijk te veranderen. Begin met medium thinking voor één-op-één karakterchats en test high thinking alleen voor RPG's met veel regels of grote lorebooks. Het nadeel zijn de kosten: de tarieven van $2,40 voor input en $12 voor output brengen een vaste test van 100 antwoorden op ongeveer $2,52 voordat de geschiedenis wordt uitgebreid.
3 GLM 5.3 Beste gebalanceerde verhaalmodel
GLM-5.3 is het meest overtuigende alternatief voor Kimi K3 wanneer je wilt dat het model meer van het verhaal draagt. Het scoorde 85,1 in totaal, 92,5 voor Strict Voice en 85,8 voor robuustheid. De benchmark beschrijft het als bijzonder effectief voor verhaalgedreven roleplay, duistere fictie en avonturenbots.
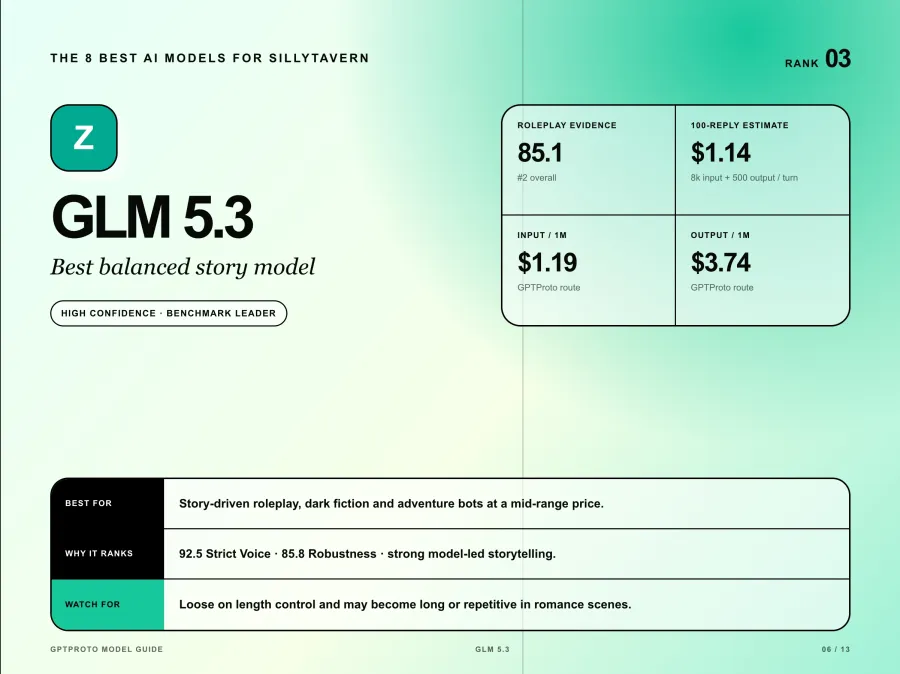
De afweging is de controle over lengte en tempo. GLM-5.3 was het minst strikt van de toonaangevende modellen wat betreft woordlimieten en presteerde veel slechter in het romantiekscenario van de benchmark, waar antwoorden lang en repetitief werden. Een strikte maximale antwoordlengte en een duidelijke instructie voor de post-geschiedenis helpen, maar ze garanderen geen beknopte output.
Met $1,19 voor input en $3,74 voor output per miljoen tokens kost GLM-5.3 minder dan de helft van Kimi K3 in het vaste voorbeeld van 100 antwoorden. Gebruik model-ID glm-5.3. Het is een verstandige standaardkeuze voor gebruikers die sterke roleplay-kwaliteit willen zonder bij elke beurt premium-tarieven te betalen.
4 DeepSeek V4.1 Flash Beste keuze voor betaalbare lange sessies
DeepSeek V4.1 Flash biedt de beste prijs-kwaliteitverhouding in deze lijst. Het model scoorde 84,4 in totaal, bleef binnen de woordlimiet bij alle 28 van de 28 kern-roleplay-antwoorden en eindigde op een gedeelde eerste plaats in de categorie 'Villain' (schurk). Met tarieven van $0,24 voor input en $0,96 voor output kost het vaste voorbeeld van 100 antwoorden ongeveer $0,24.
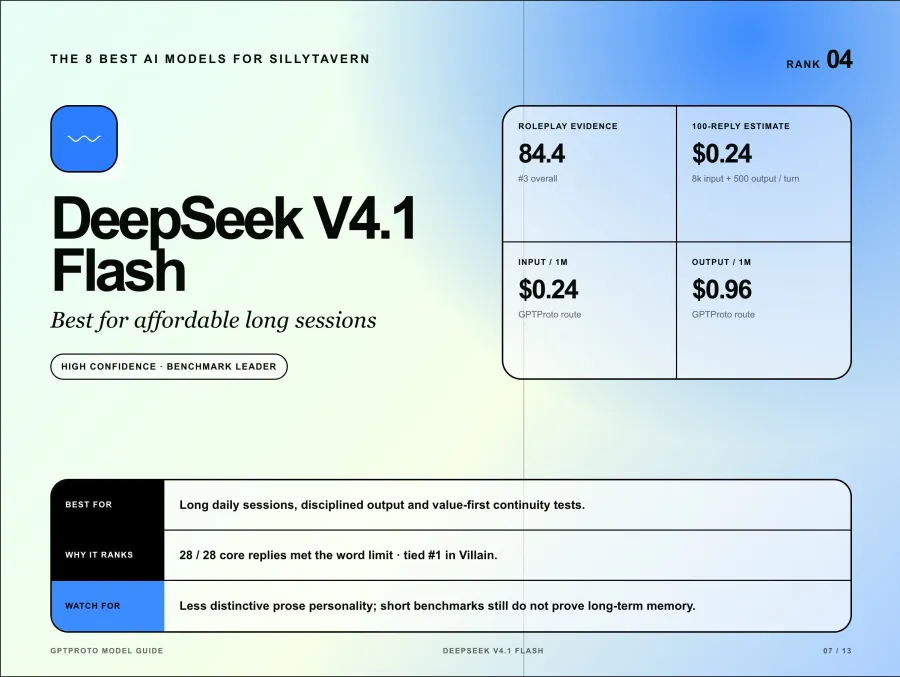
Het model is als proza-stylist minder uitgesproken dan Kimi, Argon of Opus. Dat kan een voordeel zijn wanneer de karakterkaart al een sterke eigen stem bevat: het model is minder geneigd deze te overschrijven met zijn eigen huisstijl. Het is ook nuttig wanneer je lange dagelijkse sessies verwacht en een duurder model wilt bewaren voor cruciale scènes.
Gebruik deepseek-flash in SillyTavern. Naar mijn oordeel is dit de beste eerste waardetest voor langlopende chats, maar de benchmark gebruikte nog steeds korte scenario's. Je zou je eigen continuïteitstest van 30 tot 50 beurten moeten uitvoeren voordat je de lage prijs als bewijs voor langetermijngeheugen beschouwt.
5 GLM 5.3 Flash Beste goedkope Game Master
GLM-5.3 Flash is de budgetspecialist. Het scoorde 89,2 als Game Master en 98,3 voor 'Strict Voice', de hoogste score in een enkele categorie in de september-benchmark. Met $0,1275 voor input en $0,425 voor output per miljoen tokens, kost het vaste voorbeeld van 100 antwoorden ongeveer $0,12.
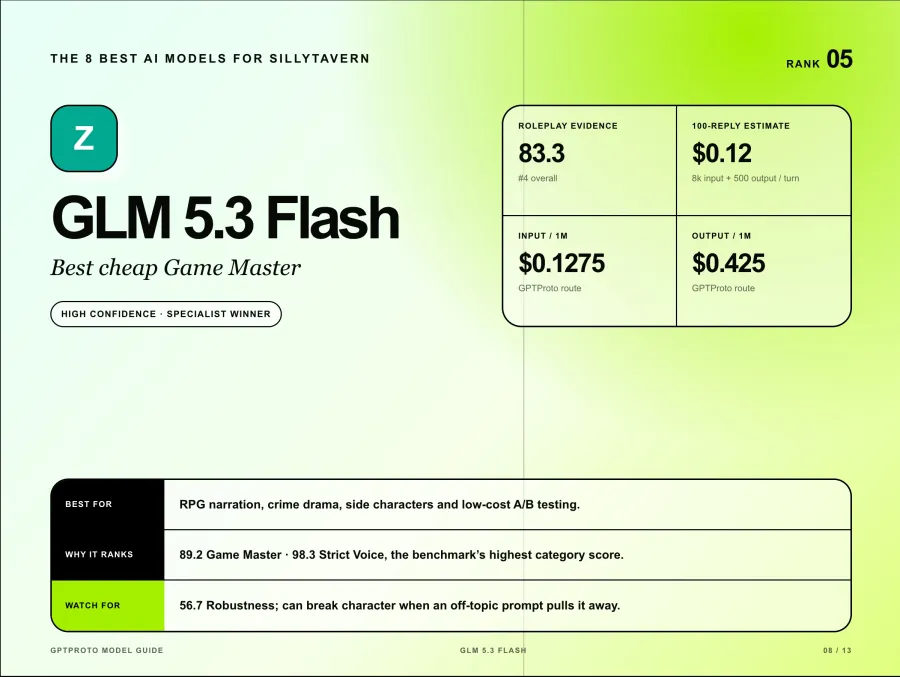
Het zwakke punt is net zo belangrijk. GLM-5.3 Flash scoorde slechts 56,7 voor robuustheid nadat het uit zijn rol viel om een off-topic verzoek te beantwoorden als een algemene assistent. Het overschreed ook vaker de woordlimieten voor kern-roleplay dan de andere koplopers.
Kies dit model voor RPG-vertellingen, misdaaddrama's, bijpersonages of goedkope A/B-tests. Ga er niet vanuit dat de lage prijs het tot het beste model voor metgezellen maakt. Houd in SillyTavern de karakterregels dicht bij het einde van de prompt en test opzettelijke ontsporingen voordat je er een lange chat aan toevertrouwt. De model-ID is glm-5.3-flash.
6 Gemini 3.8 Flash Beste snelle alledaagse model
Gemini 3.8 Flash verdient een volwaardige plek in deze lijst in plaats van slechts een vluchtige vermelding. Een recente community roleplay-benchmark testte tot 64 antwoorden per model over acht hoofdstukken en gaf Gemini 3.8 Flash een kwaliteitsscore van 91,9. Die test woog schrijfvoorkeur voor 75 procent en robuustheid voor 25 procent. Het is nuttig bewijs, maar de score is niet direct vergelijkbaar met AI Roleplay Bench omdat de prompts en de scoringsmethode verschillen.
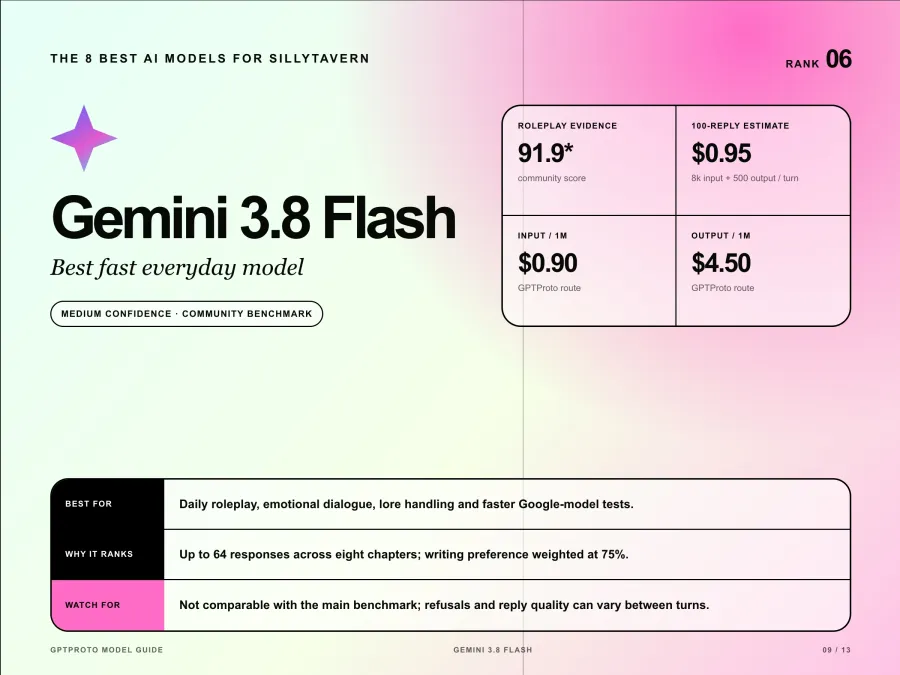
Community-rapporten prijzen ook de emotionele dialoog, het omgaan met lore en het gespreksritme. Het ruwe randje is de consistentie: sommige gebruikers melden willekeurige weigeringen of ongelijkmatige antwoorden, zelfs als omliggende beurten goed werken.
Gebruik gemini-3.8-flash en begin met medium thinking. De tarieven van $0,90 voor input en $4,50 voor output maken het veel goedkoper dan Argon, hoewel het vaste voorbeeld van 100 antwoorden nog steeds ongeveer $0,95 kost. Kies dit model wanneer je een Google-model voor dagelijks gebruik wilt, maar niet de premium redeneerkracht van Argon bij elke beurt nodig hebt.
7 Claude Opus 5.5 Beste premium proza-model
Claude Opus 5.5 is de keuze voor premium proza, niet de universele winnaar. Gebruikers die ervan houden wijzen op ruimtelijk inzicht, wereldkennis, tempo en het vermogen om een setting levendig te laten aanvoelen. Een gedetailleerd SillyTavern community-rapport raadt het aan voor algemene verhaal-roleplay, waarbij je naar andere modellen overschakelt wanneer een scène een andere inhoudelijke aanpak vereist.
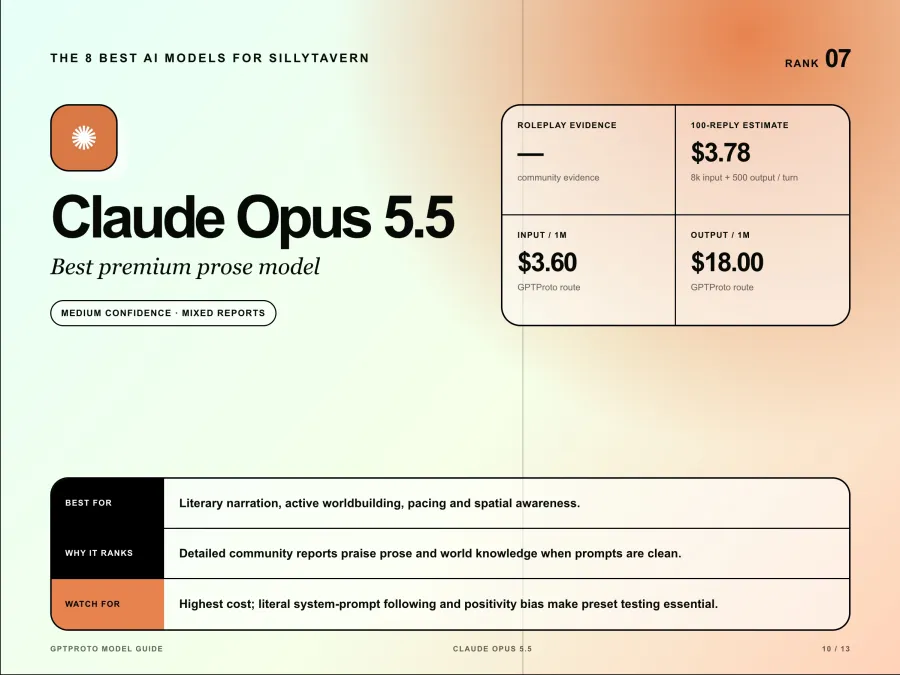
Andere gebruikers melden dat Opus grote systeemprompts zo letterlijk volgt dat tegenstrijdige instructies in een karakterkaart of preset het personage kunnen vervormen. Positiviteitsbias is een andere terugkerende klacht. Dat verschil verklaart waarom ik het niet boven de benchmarkleiders zou rangschikken zonder de exacte kaart te testen.
De prijs is het duidelijkste nadeel: $3,60 voor input en $18 voor output per miljoen tokens, of ongeveer $3,78 in het vaste voorbeeld van 100 antwoorden. Gebruik claude-opus-5-5, begin met een schone prompt en verwijder overgeërfde preset-regels die je niet kunt verklaren. Opus is het testen waard voor literaire narratie. Het is moeilijk te rechtvaardigen voor informele chats met een hoog volume.
8 GPT 6 Luna Beste Ultra Goedkope GPT-model
GPT-6 Luna is de reden waarom GPT niet mag ontbreken in een SillyTavern-gids, ook al is het niet het beste rollenspelmodel in het algemeen. Luna scoorde 71,1 in totaal, ruim onder de vier benchmarkleiders, met 68,3 voor Companion, 60,0 voor Strict Voice en 54,2 voor Robustness. De voorzichtigheid van het model haalde het herhaaldelijk uit de fictie.
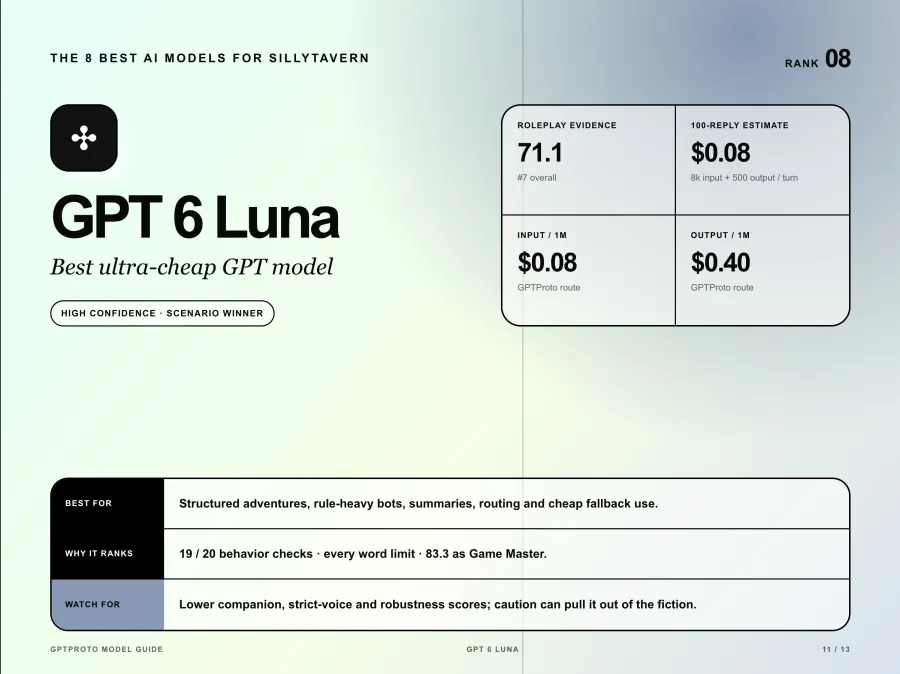
De andere helft van het resultaat is nuttig. GPT-6 Luna slaagde voor 19 van de 20 gedragscontroles, hield zich aan elke geteste woordlimiet en scoorde 83,3 als Game Master. Met $0,08 voor input en $0,40 voor output per miljoen tokens, kost het vaste voorbeeld van 100 antwoorden ongeveer acht cent.
Gebruik gpt-6-luna voor gestructureerde avonturen, regelzware bots, samenvattingen, routering of als goedkope fallback. Kies niet voor dit model boven Kimi, GLM of Gemini wanneer emotionele onderdompeling het hoofddoel is. Dit is een winnaar voor scenario's, geen verkapte bewering dat het model op de zevende plaats van de benchmark het beste is in het algemeen.
Waarom er niet meer GPT-, Claude- en Gemini-modellen zijn
Een nuttige ranglijst moet niet voor elke aanbieder evenveel ruimte reserveren. Elk extra model heeft ofwel sterk bewijs voor rollenspel nodig, ofwel een duidelijk andere taak.
| Modelfamilie |
Keuze voor de hoofdlijst |
Ander model dat het testen waard is |
Waarom het alternatief niet apart gerangschikt is |
| GPT |
GPT-6 Luna |
GPT-6.1 Terra voor $0,80 / $4,00 |
Terra heeft aantrekkelijke prijzen en algemene schrijfvaardigheid, maar nog geen vergelijkbare rollenspelbenchmark |
| Claude |
Claude Opus 5.5 |
Claude Sonnet 5.5 voor $1,80 / $9,00 |
Het is een goedkopere Claude-optie, maar het huidige bewijs specifiek voor RP is te dun voor een aparte winnaarsclaim |
| Claude |
Claude Opus 5.5 |
Claude Haiku 5.5 voor $0,09 / $0,45 |
Haiku is gepositioneerd voor lichtgewicht werk in grote volumes; een lage prijs alleen garandeert geen sterke proza of consistentie bij lange sessies |
| Gemini |
Gemini 4 Argon en 3.8 Flash |
Gemini Flash Lite-varianten |
De goedkopere Lite-modellen missen hetzelfde bewijs vanuit de RP-community |
| Kimi |
Kimi K3 |
Kimi K3.1 Pro voor $2,00 / $10,00 |
Het is nieuwer en veelbelovend, maar het heeft K3 nog niet vervangen in de specialistische benchmark |
Dit is ook de reden waarom GPT-6 Luna op de achtste plaats staat in plaats van te verdwijnen. Het heeft bewijs voor een specifieke taak. Terra zal het wellicht later voorbijstreven, maar die claim nu al maken zou algemene capaciteiten verwarren met geteste rollenspelprestaties.
Beste lokale model voor SillyTavern op basis van VRAM
Het lokaal draaien van SillyTavern betekent niet dat het taalmodel lokaal is. De frontend zelf heeft bescheiden vereisten, terwijl lokale inferentie voldoende GPU-geheugen nodig heeft voor de modelgewichten en de context-cache. Het officiële SillyTavern-overzicht beveelt ten minste 6 GB VRAM aan als startpunt voor lokale inferentie.
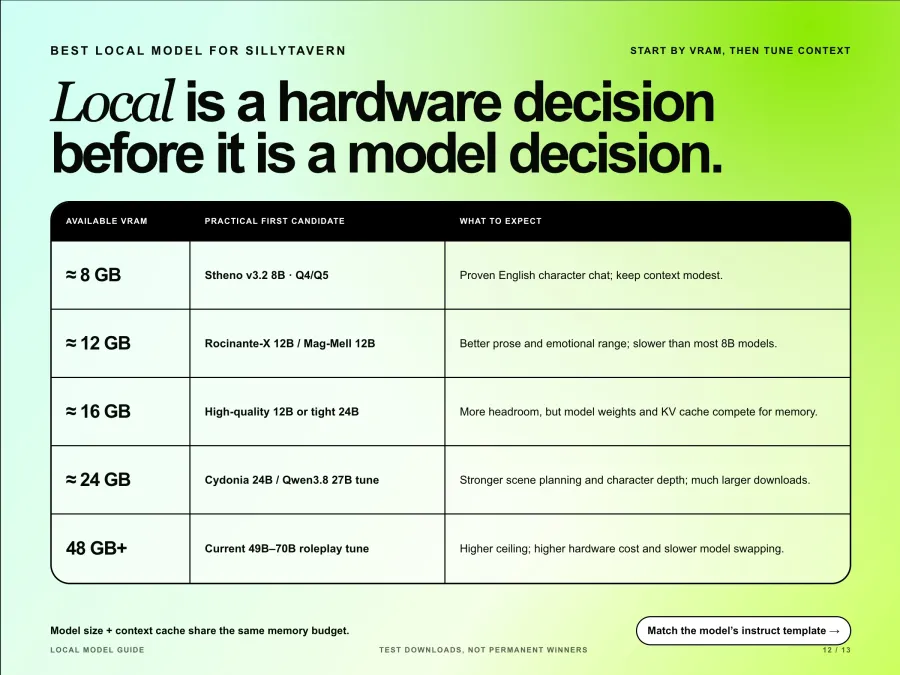
Aanbevelingen voor lokale modellen veranderen snel, dus beschouw deze als eerste downloads om te testen in plaats van als permanente winnaars. De huidige Hugging Face-directory voor roleplay-modellen bevat duizenden community-varianten met zeer verschillende templates en kwantisaties.
| Beschikbaar VRAM |
Praktische eerste kandidaat |
Wat kun je verwachten |
| Ongeveer 8 GB |
Stheno v3.2 8B in Q4 of Q5 |
Een bewezen startpunt voor Engelstalige karakterchats, maar de context moet bescheiden blijven |
| Ongeveer 12 GB |
Rocinante-X 12B of Mag-Mell 12B |
Betere proza en emotioneel bereik dan de meeste 8B-modellen, met tragere generatie |
| Ongeveer 16 GB |
Een 12B-kwantisatie van hogere kwaliteit, of een 24B-model met korte context en gedeeltelijke offload |
Meer kwaliteitsruimte, maar een modelbestand dat in het VRAM past, garandeert niet dat een grote KV-cache ook past |
| Ongeveer 24 GB |
Cydonia 24B of een Qwen3.8 27B roleplay-tune |
Betere scèneplanning en karakterdiepgang, met veel grotere downloads |
| 48 GB en meer |
Een actuele 49B tot 70B roleplay-tune |
Hoger plafond, maar hoge hardwarekosten en veel trager wisselen van modellen |
Voor kaarten met 8 GB is de centrale afweging simpel: modelgrootte en context strijden om hetzelfde geheugen. Begin met een kleinere context, bevestig de stem van het personage en verhoog daarna de limiet terwijl je het VRAM en de generatiesnelheid in de gaten houdt.
Selecteer voor lokale Text Completion-backends het daadwerkelijke instruct-template van het model. De Instruct Mode-documentatie van SillyTavern waarschuwt dat het gekozen template moet overeenkomen met het formaat dat het model verwacht. Een sterke fine-tune met het verkeerde template kan er slechter uitzien dan een kleiner model dat correct is geconfigureerd.
Beste model voor langdurige roleplay
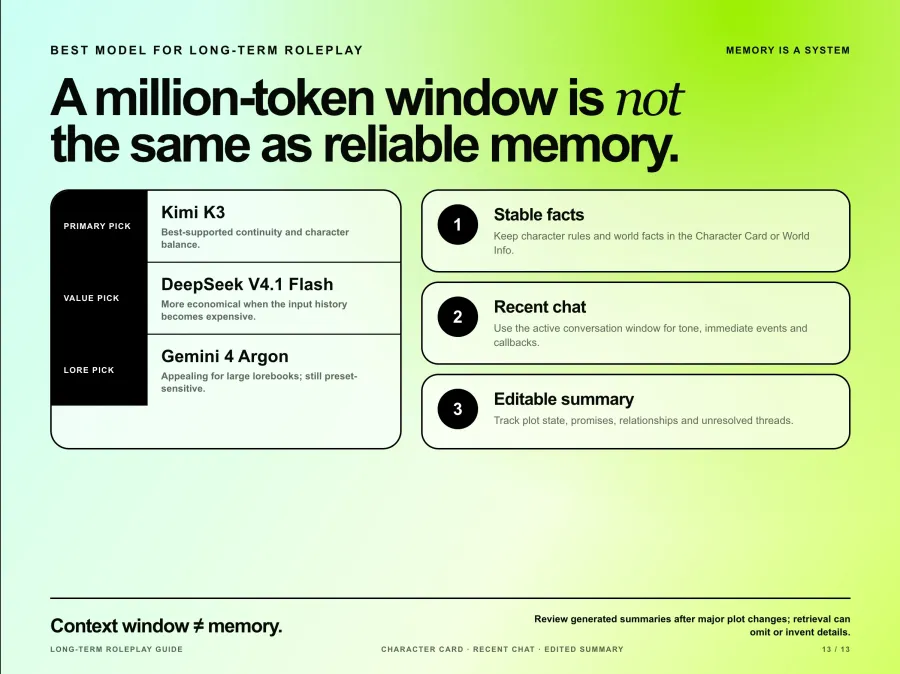
Kimi K3 is de sterkste, op bewijs gebaseerde keuze voor langdurige karaktercontinuïteit, terwijl DeepSeek V4.1 Flash de meer economische keuze is wanneer de geschiedenis duur wordt. Gemini 4 Argon is aantrekkelijk voor grote lorebooks, maar een venster van een miljoen tokens moet niet worden verward met betrouwbaar geheugen.
De contextdocumentatie van SillyTavern legt uit dat alleen berichten binnen het actieve contextbereik naar het model worden verzonden. Karakterinformatie, systeemprompts, World Info, samenvattingen en antwoordruimte verbruiken allemaal hetzelfde budget. Zodra oude berichten buiten dit bereik vallen, kan het model ze niet meer oproepen, tenzij je de relevante feiten opnieuw invoert.
Gebruik drie lagen in plaats van alleen te vertrouwen op de contextgrootte:
Houd stabiele karakterfeiten en wereldregels in de karakterkaart of World Info.
Gebruik de recente chatgeschiedenis voor toon en onmiddellijke gebeurtenissen.
Onderhoud een korte, bewerkbare samenvatting voor de plotstatus, relaties, beloften en onopgeloste verhaallijnen.
De Summarize-extensie kan de derde laag automatiseren, maar de documentatie waarschuwt dat door het model gegenereerde samenvattingen details kunnen weglaten of verzinnen. Controleer de samenvatting na grote plotwijzigingen. Chat Vectorization is experimenteel en kan het ophalen minder effectief maken, dus het moet worden getest in plaats van blindelings worden ingeschakeld.
Hoe wissel je van model in SillyTavern
Wisselen verwijdert de chat niet, maar het kan de stem, opmaak, weigeringsgedrag en de interpretatie van eerdere berichten veranderen. Sla een aparte preset op voor elke modelfamilie in plaats van één preset af te dwingen voor GPT, Claude, Gemini en lokale tekstaanvullingsmodellen.
Voor GPT Proto is de korte installatie als volgt:
Open API Connections in SillyTavern.
Selecteer Chat Completion en Custom OpenAI compatible.
Stel de Base URL in op https://gptproto.com/v1. Voeg geen /chat/completions toe; SillyTavern voegt dit zelf toe.
Plak de API-sleutel en voer een exacte model-ID in, zoals kimi-k3, glm-5.3-flash, of gemini-3.8-flash.
Begin met Prompt Post-Processing ingesteld op None, maak verbinding en voer Test Message uit.
De geïllustreerde SillyTavern API-integratiegids behandelt installatie, karakterkaarten, screenshots en veelvoorkomende verbindingsfouten.
Als je dezelfde sleutel en hetzelfde model buiten SillyTavern wilt verifiëren, gebruikt dit verzoek de identieke OpenAI-compatibele route:
export GPTPROTO_API_KEY="YOUR_KEY"

curl --request POST "https://gptproto.com/v1/chat/completions" \
  --header "Authorization: Bearer $GPTPROTO_API_KEY" \
  --header "Content-Type: application/json" \
  --data '{
    "model": "kimi-k3",
    "messages": [
      {"role": "user", "content": "Reply in character with one short sentence."}
    ],
    "max_tokens": 120
  }'
Test na het wisselen ten minste vijf beurten met dezelfde karakterkaart. Voeg één kort antwoord toe, één off-topic prompt, één instructie over de antwoordlengte en één verwijzing naar een eerder detail. Dat vangt meer problemen op dan alleen het beoordelen van het openingsbericht.
Welk SillyTavern-model moet je kiezen
Kies Kimi K3 als je een betrouwbare, op bewijs gebaseerde standaard wilt.
Kies Gemini 4 Argon voor complexe lore en meeslepende scèneontwikkeling, waarbij je hogere kosten en minder benchmark-zekerheid accepteert.
Kies GLM-5.3 als je een sterke verhalenverteller wilt tegen een middenklasse prijs.
Kies DeepSeek V4.1 Flash voor betaalbare lange sessies en gedisciplineerde output.
Kies GLM-5.3 Flash voor budgetvriendelijke RPG-vertellingen en strikte personagestemmen.
Kies Gemini 3.8 Flash voor een snellere, goedkopere Gemini met bemoedigende tests vanuit de community.
Kies Claude Opus 5.5 wanneer de kwaliteit van het proza belangrijk genoeg is om de kosten te rechtvaardigen.
Kies GPT-6 Luna voor de goedkoopste gestructureerde RP, samenvattingen of fallback-routing.
Kies een lokale roleplay fine-tune wanneer privacy, offline gebruik en onbeperkte generatie belangrijker zijn dan de insteltijd en de kwaliteit van cloud-modellen.
Je kunt actuele gebruiksgegevens en modelprijzen vergelijken op de GPT Proto SillyTavern-modelpagina, en vervolgens hetzelfde personage en dezelfde geschiedenis testen bij verschillende modellen via de roleplay API-speeltuin.