Als je vandaag moet kiezen tussen GPT 6.1 Terra en Sonnet 5.5, is dit de korte beslissingsregel die ik gebruik voordat ik een benchmark uitvoer:
Kies GPT-6.1 Terra als je pipeline bestaat uit het op grote schaal inspecteren van screenshots, automatisering van formulieren en facturen, het debuggen van UI-layouts, of begrensde codeertaken waarbij een tarief van $0,80/$4,00 per token en 3x snellere taakuitvoering belangrijker zijn dan de maximale diepgang van autonoom refactoren—en je invoer per verzoek 272K tokens of minder bedraagt.
Kies voor Claude Sonnet 5.5 als je agent migraties van repositories met meerdere bestanden uitvoert, diepgaande terminal-debugging doet waarbij een gemiste bewerking duurder is dan de tokenrekening, of prompts in één doorgang gebruikt tussen 300K en 900K tokens waarbij de toeslag voor lange context van OpenAI het prijsvoordeel van Terra tenietdoet.
Je kunt de actuele catalogustarieven bekijken of je eigen maandelijkse tokenvolume door de GPT Proto modelvergelijker halen voordat je een keuze maakt. Alles hieronder is een vergelijking gebaseerd op documentatie en benchmarks, geverifieerd op 5 november 2026; door leveranciers gerapporteerde benchmarks worden apart vermeld van onafhankelijke metingen door Artificial Analysis en vroege feedback van ontwikkelaars.
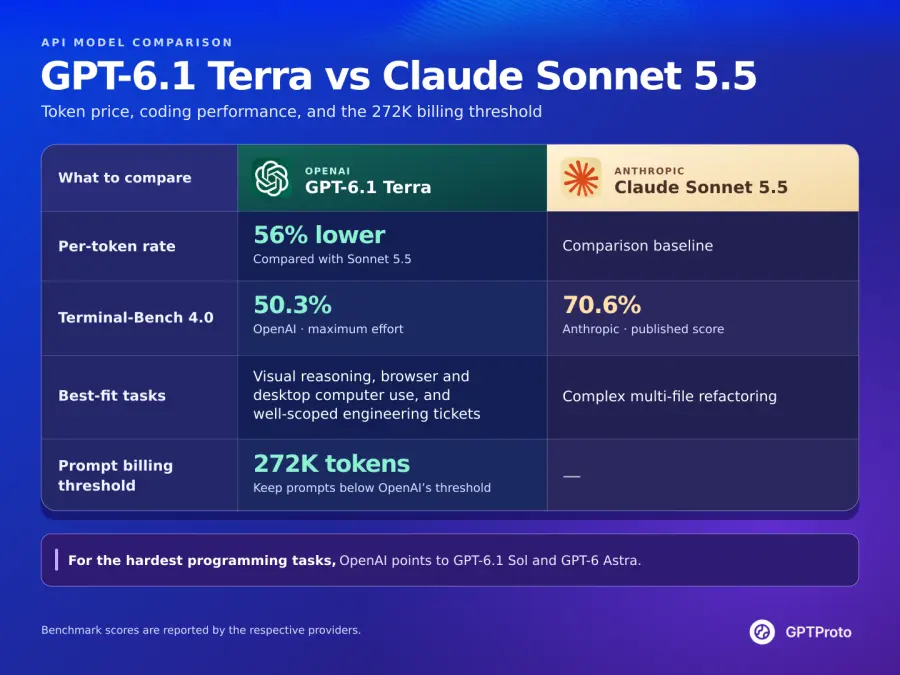
Vergelijking tussen GPT-6.1 Terra en Claude Sonnet 5.5 in één oogopslag
Ontwikkelaars die zoeken naar ChatGPT 6.1 Terra vs Sonnet 5.5 of Anthropic Claude Sonnet 5.5 vs GPT 6.1 Terra stuiten vaak op tegenstrijdige specificaties, omdat beide leveranciers hun redeneercontroles, tool-endpoints en toeslagen voor lange context verschillend structureren. De onderstaande tabel zet beide modellen af tegen de officiële gpt-6.1-terra-documentatie van OpenAI, het overzicht van Anthropic's Claude Sonnet 5.5 en de actuele catalogustarieven van GPT Proto.
| Specificaties |
GPT-6.1 Terra (gpt-6.1-terra) |
Claude Sonnet 5.5 (claude-sonnet-5-5) |
| Aanbieder |
OpenAI |
Anthropic |
| Releasedatum |
26 oktober 2026 |
28 september 2026 |
| Officiële standaard input / output (per 1M tokens) |
$1,00 / $5,00 |
$2,00 / $10,00 |
| GPT Proto input / output (per 1M tokens) |
$0,80 / $4,00 (−20% vs officieel) |
$1,80 / $9,00 (−10% vs officieel) |
| Officiële gecachte input read (per 1M tokens) |
$0,05 (5% van basis-input) |
$0,10 (verlaagd van $0,20 op 7 okt 2026) |
| Officiële cache write (per 1M tokens) |
$1,25 (30m TTL) / $2,50 (12u TTL) |
$2,50 (5m TTL) |
| GPT Proto cache read / write (per 1M tokens) |
$0,04 / $1,00 |
$0,09 / $2,25 (controleer live modelpagina) |
| Contextvenster |
1.050.000 tokens |
1.000.000 tokens |
| Prijsregel voor lange context |
>272K input berekent volledig verzoek tegen 2x input/cache en 1,5x output |
Vast tarief over het volledige 1M contextvenster |
| Maximale output-tokens |
128.000 tokens |
128.000 tokens |
| Input / output modaliteiten |
Tekst, Afbeelding, Document in → Tekst uit |
Tekst, Afbeelding, Document in → Tekst uit |
| Kennis-cutoff |
1 juni 2026 |
Begin-tot-midden 2026 (behoudt Sonnet 5 tokenizer) |
| Redenering / inspanningscontroles |
geen, laag, gemiddeld (standaard), hoog, xhoog, max |
Adaptief denken standaard aan; gemiddeld, hoog (API-standaard), max, tussen_tools |
| Vereist eindpunt voor tool-aanroepen |
/v1/responses vereist door OpenAI-documentatie |
/v1/messages (native) of OpenAI-compatibel /v1/chat/completions |
| Beschikbaarheid van client & IDE |
ChatGPT Work & Codex (niet de reguliere Chat), GitHub Copilot, Claude Code (via API) |
Claude.ai, Claude Code, GitHub Copilot, Cursor |
| AA Intelligence Index (v4.3.2) |
41 (medium) / 48 (max) |
56 (max, standaard fallback) |
| AA gemiddelde kosten voor evaluatietaak |
$0.10 (`medium`) / $0.40 (max) |
$5.46 (max, standaard fallback) |
| Terminal-Bench 4.0 (gerapporteerd door leverancier) |
50.3% (max inspanning) |
70.6% |
Drie rijen in die tabel doen bijna al het werk wanneer u een budget opstelt voor een applicatie. Ten eerste: bij standaardverzoeken van minder dan 272K tokens is GPT-6.1 Terra 56% goedkoper per token op GPT Proto voor zowel input als output, dus lange voltooiingen veranderen de kostenrangschikking niet. Ten tweede: Sonnet 5.5 heeft een voorsprong van 20,3 procentpunt op Terminal-Bench 4.0, wat nauw overeenkomt met hoe de twee modellen zich gedragen bij onbegeleide repository-bewerkingen. Ten derde: in tegenstelling tot GPT-6.1 Sol, herstelt GPT-6.1 Terra de ondersteuning voor reasoning.effort: "none", waardoor OpenAI-ontwikkelaars weer een echt snel pad zonder redenering hebben.
Prijs- en kostenoverzicht: Welke is duurder en welke is kostenefficiënter?
Wanneer ontwikkelaars zoeken naar "GPT 6.1 Terra vs Sonnet 5.5 welke is duurder" of "welke is kostenefficiënter," proberen ze meestal twee verschillende getallen met elkaar te verzoenen: het tarief per miljoen tokens op de prijspagina en de werkelijke kosten in dollars van een voltooide agent-taak. Die twee verhoudingen zijn niet hetzelfde.
Op het niveau van tokens per stuk is Claude Sonnet 5.5 met een ruime marge het duurdere model. De officiële prijzen van Anthropic zijn $2,00 per miljoen input-tokens en $10,00 per miljoen output-tokens—twee keer de catalogusprijs van OpenAI van $1,00/$5,00 voor Terra. Omdat GPT Proto een korting van 20% toepast op GPT-6.1 Terra ($0,80 input / $4,00 output) en een korting van 10% op Claude Sonnet 5.5 ($1,80 input / $9,00 output), kost Sonnet 5.5 op het platform 2,25 keer zoveel per token. Beide leveranciers rekenen nu voor gecachte input-reads 5% van de basis-input ($0,05 officieel voor Terra vs $0,10 officieel voor Sonnet 5.5 nadat Anthropic de prijs voor cache-reads van Sonnet in oktober 2026 heeft gehalveerd), en beide rekenen 1,25x de basis-input voor standaard cache-writes ($1,25 vs $2,50 officieel). Let op: een eenmalige lange prompt die naar de cache wordt geschreven, voegt in feite een toeslag van 25% toe op beide modellen als je dat voorvoegsel nooit een tweede keer leest.
Op het niveau van taken per stuk wordt het verschil veel groter. In de Intelligence Index v4.3.2 van Artificial Analysis (gepubliceerd op 26–27 oktober 2026), registreerde de geteste Claude Sonnet 5.5-configuratie (max inspanning met standaard fallback) gewogen gemiddelde kosten van $5,46 per evaluatietaak. In dezelfde evaluatiesuite kostte [GPT-6.1 Terra op `max` inspanning](https://artificialanalysis.ai/models/gpt-6-1-terra) gemiddeld $0,40 per taak, en GPT-6.1 Terra op medium inspanning gemiddeld slechts $0,10 per taak. Dat is een verschil van 13,6x bij max inspanning en een verschil van 54,6x wanneer de hoogste instelling van Sonnet wordt vergeleken met de standaard medium instelling van Terra.
Waarom verandert een verschil van 2x per token in een factuurverschil van 13x tot 54x? Redeneringsmodellen factureren denktokens als output-tokens. Wanneer Sonnet 5.5 op hoge of maximale inspanning draait bij een open benchmark, genereert het lange redeneerketens tegen $10,00 per miljoen tokens ($9,00 op GPT Proto). De aankondiging van Terra merkt ook op dat Terra bij maximale inspanning op het Agents' Last Exam minder dan een derde van het aantal tokens gebruikte dan Claude Opus 5.5. Nog belangrijker is de Pareto-frontier bevinding van Artificial Analysis: voor GPT-6.1 Terra zijn de low en medium inspanningsinstellingen Pareto-optimaal voor intelligentie versus kosten. Het opschroeven van Terra naar max verhoogt de score van 41 naar 48, wat gelijkstaat aan GPT-6.1 Sol op medium inspanning—behalve dat Sol medium $0,21 per taak kost, terwijl Terra `max` $0,40 kost. Kortom, als je de meest kostenefficiënte setup op Terra wilt, houd deze dan op low of medium; als een taak moeilijk genoeg is om max inspanning te vereisen, zou je al Sol of Sonnet 5.5 moeten testen.
Doorgerekende kosten: Twee echte productiescenario's
Om te zien waar het goedkopere tarief per token daadwerkelijk loont—en waar het averechts werkt—laten we de exacte berekening uitvoeren op basis van de actuele catalogustarieven van GPT Proto ($0,80/$4,00 voor Terra; $1,80/$9,00 voor Sonnet 5.5), uitgaande van niet-gecachte verzoeken onder de 272K tokens.
Scenario A is een agent-loop voor visuele QA en formulier-extractie van 20 stappen. Elke stap verstuurt een screenshot en een DOM-fragment van in totaal 15.000 input-tokens en genereert 1.500 output-tokens (inclusief medium redeneertokens). Over 20 stappen verbruikt één workflow 300.000 input-tokens (0,3M) en 30.000 output-tokens (0,03M):
GPT-6.1 Terra op GPT Proto: (0,3 * $0,80) + (0,03 * $4,00) = $0,24 + $0,12 = $0,36 per workflow.
Claude Sonnet 5.5 op GPT Proto: (0,3 * $1,80) + (0,03 * $9,00) = $0,54 + $0,27 = $0,81 per workflow.
Bij 10.000 workflows per maand kost Terra $3.600 tegenover de $8.100 van Sonnet—een maandelijkse besparing van $4.500. Zelfs als Terra bij 20% van de runs niet door de validatie komt en die 2.000 workflows opnieuw moet uitvoeren (wat $720 extra kost), is uw totale rekening $4.320, wat nog steeds een besparing van $3.780 per maand betekent ten opzichte van een Sonnet-run zonder retries.
Scenario B is een backend-refactor van meerdere bestanden in een actieve pull request. Stel dat elke poging 80.000 input-tokens leest en 10.000 output-tokens genereert. Eén schone pass op Sonnet 5.5 kost (0,08 * $1,80) + (0,01 * $9,00) = $0,234. Eén pass op Terra kost (0,08 * $0,80) + (0,01 * $4,00) = $0,104. U bespaart 13 cent op de API-aanroep. Het addertje onder het gras is dat als Terra een type-afhankelijkheid tussen modules mist—wat overeenkomt met het Terminal-Bench-gat van 50,3% versus 70,6%—en drie retries vereist plus 12 minuten van de tijd van een senior engineer à $90/uur ($18,00 aan arbeidskosten), die besparing van 13 cent aan tokens uw team zojuist $18,18 heeft gekost. In één zin: Terra wint overtuigend bij herhaalbare, machine-verifieerbare loops, terwijl Sonnet 5.5 zijn hogere tarief terugverdient zodra een mislukte bewerking tijd van menselijke beoordeling opslokt.
Contextvenster (1,05M vs 1M): Waarom het overschrijden van 272K de rekening verandert
Op papier ziet de vergelijking tussen het GPT 6.1 Terra vs Sonnet 5.5 contextvenster eruit als een nek-aan-nekrace met een klein voordeel voor OpenAI: Terra accepteert 1.050.000 input-tokens en genereert tot 128.000 output-tokens, terwijl Claude Sonnet 5.5 1.000.000 input-tokens accepteert en tot 128.000 output-tokens genereert. De meeste vergelijkingstabellen stoppen daar.
Als je echter de documentatie van het gpt-6.1-terra-model van OpenAI leest, is er een facturatiegrens bij 272.000 input-tokens die de economie van lange contexten volledig verandert. Wanneer een prompt op GPT-6.1 Terra de 272K input-tokens overschrijdt, factureert OpenAI het volledige verzoek — niet alleen de tokens boven de 272K — tegen 2x de input- en cachetarieven en 1,5x het outputtarief.
Dit is wat er gebeurt met het officiële tarief per miljoen tokens zodra je prompt de grens van 272.000 tokens naar 272.001 tokens overschrijdt:
| Contextcategorie |
GPT-6.1 Terra (Officieel tarief) |
Claude Sonnet 5.5 (Officieel tarief) |
Prijsverhouding input |
| Standaard prompt (≤272K input-tokens) |
$1,00 input / $5,00 output / $0,05 cache-read |
$2,00 input / $10,00 output / $0,10 cache-read |
Terra is 50% goedkoper op input en output |
| Long-context prompt (>272K tot 1M+ input-tokens) |
$2,00 input / $7,50 output / $0,10 cache-read |
$2,00 input / $10,00 output / $0,10 cache-read |
Input- en cache-read-tarieven zijn identiek ($2,00 / $0,10) |
In tegenstelling tot Anthropic's kleinere Haiku 5.5-model (dat een toeslag van 5x toepast boven de 100K tokens), hanteert Claude Sonnet 5.5 vaste prijzen over het gehele contextvenster van 1.000.000 tokens.
Laten we de berekening maken voor een repository-audit van 400.000 tokens die 10.000 output-tokens genereert tegen de officiële lijsttarieven:
GPT-6.1 Terra (activeert de >272K 2x/1,5x regel): (0,4 * $2,00) + (0,01 * $7,50) = $0,80 + $0,075 = $0,875.
Claude Sonnet 5.5 (vast tarief): (0,4 * $2,00) + (0,01 * $10,00) = $0,80 + $0,10 = $0,900.
Zodra je prompt de 272K tokens overschrijdt, verdwijnt Terra's inputkorting van 50% volledig, wat resulteert in een totaalverschil van $0,025 bij een aanroep van 400K tokens. Mijn advies is eenvoudig: stuur nooit monolithische prompts van >272K tokens naar GPT-6.1 Terra in de verwachting dat je de helft betaalt. Ofwel verdeel/haal je context op onder de 272K tokens zodat Terra in zijn $1,00 ($0,80 GPT Proto) categorie blijft, of routeer repository-dumps van 300K–900K direct naar Claude Sonnet 5.5, waar je hetzelfde officiële inputtarief betaalt en een sterker begrip van code over lange afstanden krijgt. (Controleer voordat je >272K prompts in productie draait via GPT Proto bij de platformondersteuning hoe de aanpassing van de 272K-laag stroomopwaarts wordt verwerkt in je accountsaldo.)
Benchmarks en feedback van de community: Programmeren, frontend en agent-gebaseerd werk
Geaggregeerde scores verhullen waar elk model daadwerkelijk uitblinkt. Op de Artificial Analysis Intelligence Index v4.3.2 scoort Claude Sonnet 5.5 (max, standaard fallback) 56, scoort GPT-6.1 Sol (max) 52, en scoort GPT-6.1 Terra 48 bij max inspanning en 41 bij medium inspanning. (Op de index-snapshot van 3 november 2026, weergegeven op de vergelijkingskaart van GPT Proto, noteert Sonnet 5.5 54,2 en noteert Terra max 51—een kleiner verschil van 3,2 punten dat nog steeds in het voordeel van Sonnet uitvalt.) Om een praktische routeringsbeslissing te nemen voor code, frontend UI of agent-loops, moeten we die totalen uitsplitsen per taaktype en ze vergelijken met wat ontwikkelaars in de praktijk rapporteren.
1. Backend- en terminal-programmering (GPT 6.1 Terra vs Sonnet 5.5 voor code)
Voor pure software-engineering vanaf de opdrachtregel (command line) heeft Anthropic nog steeds een duidelijk voordeel. Op Terminal-Bench 4.0 rapporteert Anthropic 70,6% voor Claude Sonnet 5.5 (tegenover 10,3% op Sonnet 5), terwijl OpenAI 50,3% rapporteert voor GPT-6.1 Terra op max inspanning (tegenover 21,5% op GPT-5.6 Terra). In de onlangs uitgebrachte Coding Agent Index v2.0 van Artificial Analysis scoort Terra 48—17 punten voor op de lichtgewicht GPT-6 Luna (31), maar 6 punten achter op GPT-6.1 Sol (54). Artificial Analysis merkt ook op dat voor specifieke programmeer-agents de low en xhigh inspanningsinstellingen van Terra zich op de grens van kostenefficiëntie bevinden, terwijl andere inspanningsinstellingen achterblijven.
Vroege praktijktests wijzen op de exacte grens tussen de twee modellen:
De changelog van de release van GitHub Copilot op 26 oktober 2026 rapporteerde dat GPT-6.1 Terra in vroege interne tests merkbaar meer terminal- en C#-programmeertaken oploste dan GPT-5.6 Terra, met een cruciale gedragsobservatie: "Het werkt in gefocuste, geconsolideerde stappen aan goed afgebakende taken." GitHub publiceerde in die notitie geen ruwe slagingspercentages, dus beschouw dit als een kwalitatieve bevinding van het platform in plaats van een gecontroleerde benchmark.
Aan de kant van Claude vond een vroege directe vergelijkingstest door ontwikkelaars op r/ClaudeAI (waarbij tien persoonlijke programmeertaken drie keer per configuratie werden uitgevoerd op high inspanning in Claude Code en pi-agent) dat Sonnet 5.5 implementaties consistent voltooide in minder gespreksbeurten en met minder output-tokens dan zijn voorganger, grotendeels omdat Sonnet 5.5 parallelle tool-aanroepen agressiever bundelt. Evenzo scoorde Sonnet 5.5 op Cursor's externe CursorBench 4.0-evaluatie bij high inspanning 47,8% tegen $1,67 per taak.
De conclusie voor backend-ontwikkelaars: als de ticket goed afgebakend is—het schrijven van een C#-servicemethode, het toevoegen van een unit-test of het repareren van een geïsoleerd CLI-script—zal Terra op low of medium inspanning dit snel voltooien tegen minder dan de helft van de tokenprijs. Als de ticket vereist dat de status over tien bestanden wordt getraceerd waarbij een extra herhalingslus de workflow verpest, rechtvaardigt de 70,6% terminalcompetentie van Sonnet 5.5 het hogere tarief. Waar wetenschappelijk rekenen betrokken is, rapporteert OpenAI ook dat op Terminal-Bench-Science 0.1 (zoals het schrijven van code om celdelingen in time-lapse-video te volgen), Terra op max inspanning GPT-6.1 Sol daadwerkelijk overtreft en binnen vijf punten van Claude Opus 5.5 komt tegen minder dan een vijfde van de geschatte kosten.
2. GPT-6.1 Terra versus Sonnet 5.5 voor Frontend-ontwikkeling
Zoeken naar GPT 6.1 Terra versus Sonnet 5.5 voor Frontend-ontwikkeling verdient een eigen antwoord, omdat frontend-engineering uit twee verschillende taken bestaat die aan elkaar zijn gelijmd: visueel/DOM-layoutwerk en state/architectuur-logica.
Toen OpenAI de score van 50,3% van GPT-6.1 Terra op Terminal-Bench 4.0 introduceerde, was het enige concrete programmeervoorbeeld dat in de aankondiging werd benadrukt een frontend-bug: "het repareren van een webpagina waarvan de lay-out verschuift tijdens het laden" (Cumulative Layout Shift, of CLS). Tegelijkertijd rapporteerde OpenAI dat GPT-6.1 Terra op MMMU-Pro—een benchmark voor visueel redeneren over diagrammen, screenshots en complexe lay-outs—beter presteert dan GPT-5.6 Terra op alle inspanningsniveaus en bijna gelijk is aan de grensverleggende GPT-6 Astra en GPT-6.1 Sol tegen een fractie van de prijs. In de discussiedraad op de dag van de lancering op het OpenAI Developer Community-forum, vatte een van de eerste reacties van ontwikkelaars Terra samen als "veel waar voor je geld, vooral als het gaat om visueel begrip. Ook behoorlijk goed in programmeren."
Die splitsing geeft frontend-teams een duidelijke taakverdeling:
Gebruik GPT-6.1 Terra voor visueel en UI-laag frontend-werk: het omzetten van Figma-screenshots of wireframes naar initiële Tailwind/HTML-markup, het vergelijken van gerenderde Playwright-screenshots met ontwerpspecificaties om overlappende DOM-nodes of regressies in mobiele breakpoints op te sporen, en het diagnosticeren van CSS-lay-outverschuivingen. Omdat Terra afbeeldingen native verwerkt, meer dan 3x sneller draait dan GPT-6.1 Sol en Astra op benchmarks voor visuele acties, en $0,80/$4,00 kost op GPT Proto, kan je CI-pipeline het zich veroorloven om bij elke commit visuele regressiechecks uit te voeren.
Gebruik Claude Sonnet 5.5 voor logica-intensieve frontend-architectuur: het refactoren van complexe React/Next.js server-action state-trees, het oplossen van ingewikkelde TypeScript generic constraints, of het migreren van een verouderde Redux-store zonder de hydratatie te verbreken. Wanneer er geen screenshot is om te inspecteren en de moeilijkheid puur ligt in de samenhang van de state over meerdere bestanden, blijft Sonnet 5.5 de veiligere keuze.
3. Agentisch werk, computergebruik en feitelijkheid (voor agentisch werk)
Als jouw definitie van GPT 6.1 Terra vs Sonnet 5.5 voor agentisch werk draait om GUI-automatisering, documentanalyse en computergebruik voor back-office taken, dan is GPT-6.1 Terra waarschijnlijk de meest waardevolle release van OpenAI in 2026.
In de door OpenAI gerapporteerde evaluaties op Agents' Last Exam v1 (waarin meerstaps professionele workflows worden getest, zoals het omzetten van architecturale tekeningen naar een 3D-model of het loggen van tijdcodes per shot in een animatiefilm), scoorde GPT-6.1 Terra bij gemiddelde inspanning 15 procentpunt hoger dan GPT-5.6 Terra tegen ongeveer een derde van de kosten, wat overeenkomt met het vlaggenschip GPT-6 Astra tegen een tiende van de tokenprijs. Bij maximale inspanning rapporteert OpenAI dat Terra meer dan 3x zo token-efficiënt is als Claude Opus 5.5 en 1/4e van de prijs per token kost, wat resulteert in ongeveer 9x lagere kosten per taak, terwijl workflows meer dan 3x sneller worden voltooid dan bij zowel GPT-6 Astra als GPT-6.1 Sol.
Op OSWorld 2.1 (besturing van desktopapplicaties) rapporteert OpenAI dat Terra bij gemiddelde inspanning de beste score van GPT-5.6 Terra verslaat tegen een fractie van de kosten per taak. Om dit in perspectief te plaatsen: de gepubliceerde OSWorld 2.1 (offline) score van Anthropic voor Claude Sonnet 5.5 is een zeer hoge 83,9% (bekendgemaakt in Anthropic's oktober 2026 Haiku 5.5 benchmarktabel). Beide modellen zijn toonaangevende engines voor computergebruik; het verschil is dat agents die schermen uitlezen bij elke klik een nieuwe screenshot versturen, wat snel input-tokens verbruikt en Terra's GPT Proto-inputtarief van $0,80/M op schaal veel beter volhoudbaar maakt.
Net zo belangrijk voor autonome agents is weten wanneer het model iets niet weet. In de onafhankelijke AA-Omniscience benchmark van Artificial Analysis daalde het hallucinatiepercentage van GPT-6.1 Terra (hoe vaak het model gokt wanneer het de kennis mist) met 50 procentpunt — van 88% bij GPT-5.6 Terra naar 38% — terwijl het tegelijkertijd 2 punten won in algehele nauwkeurigheid. Die onafhankelijke meting ondersteunt de interne feitelijkheidsevaluatie van OpenAI (verder gedetailleerd in de GPT-6.1 Terra System Card), waarbij het aantal feitelijke fouten bij moeilijke prompts met weinig inspanning daalde van 53,6% naar 16,7% (en tot 4,3% bij maximale inspanning). Lagere hallucinatiepercentages betekenen minder foutieve tool-aanroepen verderop in het proces.
Ontwikkelaarservaring en API-valkuilen (GPT 6.1 Terra vs Sonnet 5.5 voor ontwikkelaars)
Schakelen tussen gpt-6.1-terra en claude-sonnet-5-5 in productie is zelden een kwestie van een simpele tekstvervanging. Als je GPT 6.1 Terra vs Sonnet 5.5 voor ontwikkelaars ergonomie evalueert, zullen vier API-niveau beperkingen je integratiewerk bepalen.
Ten eerste ondersteunt GPT-6.1 Terra reasoning.effort: "none", terwijl GPT-6.1 Sol dat niet doet. Toen OpenAI op 29 september 2026 GPT-6.1 Sol lanceerde, verwijderde het de none en minimal redeneerniveaus, waardoor elk verzoek gedwongen werd naar low of hoger, wat temperature en top_p over de hele linie verstoorde. Volgens OpenAI's officiële gpt-6.1-terra prompting- en migratiegids, ondersteunt Terra het volledige spectrum: none, low, medium (standaard), high, xhigh en max. Als je reasoning_effort: "none" instelt, draait Terra zonder verborgen redeneertokens te genereren en staat het standaard sampling-parameters toe. Echter, zodra je low, medium, high, xhigh of max gebruikt, moet je temperature, top_p, top_logprobs en logprobs uit je request payload verwijderen, anders zal de API de aanroep afwijzen met een HTTP 400-fout.
Ten tweede vereist OpenAI de Responses API (/v1/responses) voor tool-aanroepen op GPT-6.1 Terra. Hoewel platte tekst- en afbeeldingsprompts werken op /v1/chat/completions, stelt OpenAI's modeldocumentatie expliciet dat tool-aanroepen /v1/responses vereisen. Eenmaal op de Responses API ondersteunt Terra alle negen van OpenAI's native ingebouwde tools—Web search, File search, Image generation, Code interpreter, Hosted shell, apply_patch, Skills, Computer use, MCP en Tool search—plus async: true op aangepaste functietools, zodat het model kan blijven redeneren terwijl een trage achtergrondtool wordt uitgevoerd. Bovendien ondersteunt Terra het verzenden van een configuration_update input-item halverwege een gesprek om reasoning.effort te verhogen of te verlagen tijdens een lastige beurt, zonder de prompt-prefix te herschrijven of je prompt-cache van 30 minuten ongeldig te maken (prompt_cache_options.ttl: "30m").
Ten derde heeft Claude Sonnet 5.5 zijn eigen strikte 400-foutvalkuilen. Volgens Anthropic's Sonnet 5.5 migratiegids gebruikt Sonnet 5.5 standaard adaptief denken (standaard ingesteld op high inspanning op de API en medium in Claude Code, zoals opgemerkt in Anthropic's Claude Code configuratiedocumentatie). Als je legacy Claude-integratie thinking: {"type": "disabled"} verstuurt, moet je dit bijwerken naar between_tools voor de laagste denkinstelling. Belangrijker nog is dat Sonnet 5.5 geforceerde toolkeuzes (tool_choice: {"type": "any"} of een geforceerde benoemde tool) afwijst met een 400-fout wanneer adaptief denken actief is; je moet auto gebruiken en de toolselectie in de prompt sturen. Je moet ook antwoordinhoudsblokken parseren op type in plaats van aan te nemen dat content[0] tekst is, omdat het eerste blok vaak een thinking blok is.
Ten vierde: IDE- en CLI-integratie is al voor beide modellen geregeld. Let op: in consumentenabonnementen bevestigen de release notes van OpenAI dat GPT-6.1 Terra is uitgerold naar ChatGPT Work en Codex (voor Plus-, Pro-, Business-, Enterprise- en Edu-abonnementen), niet naar de standaard ChatGPT Chat-interface, en dat het geen ondersteuning biedt voor UAE-inferentieresidentie (hoewel de Fast-modus wel EU-dataresidentie ondersteunt). Voor ontwikkelaars die in lokale terminals werken, kunnen beide modellen worden gekoppeld aan Claude Code en OpenAI Codex via GPT Proto. Op de GPT-6.1 Terra-modelpagina opent het klikken op Try this model een Quick Start-paneel waar je Claude Code of ChatGPT (Codex) kunt selecteren onder Let AI finish the integration, of klik op Copy Markdown for AI om je codeerassistent de omgevingsvariabelen automatisch te laten instellen.
Apps bouwen: Hoe u beide modellen routeert met één API-sleutel
Wanneer teams vragen stellen over GPT 6.1 Terra vs Sonnet 5.5 voor het bouwen van apps, is de beste architectuur bijna nooit het kiezen van één model voor 100% van het verkeer. Omdat beide modellen onder één prepaid-saldo op GPT Proto vallen, kunt u per stap routeren in plaats van per leverancier: stuur visuele inspecties met een hoge frequentie, screenshot-classificatie en begrensde UI-fixes naar gpt-6.1-terra tegen $0,80/$4,00, en escaleer de synthese van code over meerdere bestanden naar claude-sonnet-5-5 tegen $1,80/$9,00.
1. Eerste cURL-check (OpenAI-compatibele Chat Completions)
Beide modellen kunnen worden aangeroepen voor tekst- en visuele analyse via GPT Proto's uniforme OpenAI-compatibele /v1/chat/completions endpoint met behulp van een standaard Bearer token. Schakelen tussen beide vereist alleen het wijzigen van de "model" string:
# Call 1: GPT-6.1 Terra ($0,80 input / $4,00 output per 1M tokens op GPT Proto)
curl --fail-with-body https://gptproto.com/v1/chat/completions \
  -H "Authorization: Bearer $GPTPROTO_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "gpt-6.1-terra",
    "messages": [
      {
        "role": "user",
        "content": "Inspect this CSS rule and explain in two sentences why it triggers a layout shift on mobile: .hero-banner { width: 100%; height: auto; }"
      }
    ]
  }'

# Call 2: Claude Sonnet 5.5 ($1,80 input / $9,00 output per 1M tokens op GPT Proto)
curl --fail-with-body https://gptproto.com/v1/chat/completions \
  -H "Authorization: Bearer $GPTPROTO_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "claude-sonnet-5-5",
    "messages": [
      {
        "role": "user",
        "content": "Write a TypeScript helper that validates webhook signatures using Web Crypto API with constant-time comparison."
      }
    ]
  }'
2. Python Step-Router voorbeeld voor frontend & app-pipelines
Hier is een praktisch Python-patroon dat gebruikmaakt van de standaard openai SDK gericht op https://gptproto.com/v1. In deze workflow gebruikt Stap 1 gpt-6.1-terra om een UI-bugrapport te triëren (waar het tokenvolume hoog is en visuele/DOM-diagnose goedkoop is), en Stap 2 routeert de daadwerkelijke code-patch dynamisch naar ofwel gpt-6.1-terra (voor geïsoleerde CSS-fixes voor één component) of claude-sonnet-5-5 (wanneer de triage een wijziging in de status over meerdere bestanden markeert of wanneer de prompt de 272K-grens nadert):
import os
import json
from openai import OpenAI

# One API key and shared balance across both OpenAI and Anthropic models
client = OpenAI(
    api_key=os.environ["GPTPROTO_API_KEY"],
    base_url="https://gptproto.com/v1",
)

def triage_and_patch_ui_issue(dom_snapshot: str, screenshot_url: str, approx_tokens: int) -> dict:
    # Stap 1: Voer altijd visuele/DOM-triage uit op GPT-6.1 Terra ($0,80 / $4,00 per 1M)
    triage_response = client.chat.completions.create(
        model="gpt-6.1-terra",
        messages=[
            {
                "role": "system",
                "content": (
                    "Je bent een frontend QA-triage-agent. Inspecteer de screenshot en DOM. "
                    "Retourneer JSON met de keys: 'root_cause', 'scope' ('isolated_css' of 'multi_file_state'), "
                    "en 'target_files' (array van strings)."
                ),
            },
            {
                "role": "user",
                "content": [
                    {"type": "text", "text": f"DOM-snapshot: {dom_snapshot}"},
                    {"type": "image_url", "image_url": {"url": screenshot_url}},
                ],
            },
        ],
        response_format={"type": "json_object"},
    )

    triage_data = json.loads(triage_response.choices[0].message.content)

    # Stap 2: Routeren op basis van taakscope EN de 272K long-context factureringsgrens
    # Als de fix betrekking heeft op multi-file state OF de 272K input-tokens overschrijdt, escaleer dan naar Sonnet 5.5
    if triage_data.get("scope") == "multi_file_state" or approx_tokens > 272_000:
        selected_model = "claude-sonnet-5-5"
    else:
        selected_model = "gpt-6.1-terra"

    patch_response = client.chat.completions.create(
        model=selected_model,
        messages=[
            {
                "role": "user",
                "content": (
                    f"Triage-diagnose: {json.dumps(triage_data)} | "
                    f"Genereer een minimale, productieklare patch voor de DOM/component: {dom_snapshot}"
                ),
            }
        ],
    )

    return {
        "triage": triage_data,
        "routed_to": selected_model,
        "patch": patch_response.choices[0].message.content,
    }

if __name__ == "__main__":
    sample_dom = "<div class='card-grid'><img src='/hero.webp' /><h2>Checkout</h2></div>"
    result = triage_and_patch_ui_issue(
        dom_snapshot=sample_dom,
        screenshot_url="https://example.com/cls-regression-frame.png",
        approx_tokens=12_000,
    )
    print(f"Patch gerouteerd naar: {result['routed_to']}")
    print(result["patch"])
Pre-deployment opmerking (smoke test vereist): Controleer de exacte model-strings (gpt-6.1-terra en claude-sonnet-5-5) in de live API Usage-panelen op hun GPT Proto-modelpagina's voordat u factureerbare loops implementeert. Als uw agent vertrouwt op OpenAI's native Responses API-tools (apply_patch, Hosted shell, of async: true functie-aanroepen) of Anthropic's native /v1/messages adaptieve denkparameters (output_config.effort), voer dan een snelle smoke test uit tegen de respectievelijke native endpoints van GPT Proto (/v1/responses en /v1/messages) om de parameter-passthrough op uw route te bevestigen.
Eindoordeel: Welke moet je gebruiken?
Als je één tabel wilt om in een architectuur-reviewdocument te plakken, stem dan je primaire workload af op de foutmodus en de factureringsgrens die voor jou het belangrijkst zijn:
| Workload / Scenario |
Aanbevolen model |
Aanbevolen instelling |
Waarom het wint |
| High-volume screenshot QA, factuur-/formulierlezen & computergebruik via browser |
GPT-6.1 Terra |
low of medium effort |
56% lager GPT Proto-token-tarief ($0,80/$4,00), >3x snellere taakvoltooiing dan Sol/Astra, en Astra-niveau MMMU-Pro visie. |
| Frontend UI-debugging (CLS-layoutverschuivingen, Figma-naar-CSS, visuele regressies) |
GPT-6.1 Terra |
medium effort |
Gebouwd voor visuele + DOM-inspectie; expliciet gebenchmarkt op het oplossen van layout-verschuivingen op webpagina's. |
Classificatie met lage latentie, routering of JSON-extractie waarbij temperature nodig is |
GPT-6.1 Terra |
reasoning.effort: "none" |
Herstelt de niet-redenerende none-laag die GPT-6.1 Sol liet vallen, waardoor latentie en het aantal output-tokens minimaal blijven. |
| Backend-refactoring van meerdere bestanden & complexe TypeScript/React-statuswijzigingen |
Claude Sonnet 5.5 |
medium of high effort |
70,6% vs 50,3% op Terminal-Bench 4.0; bundelt tool-aanroepen in minder stappen, wat kostbare tijd voor ontwikkelaars bespaart. |
| Repository-analyse met lange context in één verzoek (300K tot 900K input-tokens) |
Claude Sonnet 5.5 |
medium of high effort |
Terra activeert een toeslag van 2x input / 1,5x output boven de 272K tokens (oplopend tot $2,00 officiële input), waardoor het prijsvoordeel verdwijnt. |
Diepgaand OpenAI-native terminal-coderen wanneer Terra max tekortschiet |
GPT-6.1 Sol |
medium effort |
Scoort 54 tegenover de 48 van Terra op de AA Coding Agent Index v2.0, en Sol medium ($0,21/taak) is per taak daadwerkelijk goedkoper dan Terra `max` ($0,40/taak). |
Om het eindoordeel samen te vatten zonder voorbehoud: start elke herhaalbare visuele, computergebruik- en begrensde codeerstap op GPT-6.1 Terra op low of medium effort om het tarief van $0,80/$4,00 te benutten, en houd Claude Sonnet 5.5 voor de codeerstappen met meerdere bestanden en prompts van >272K tokens, waar de hogere nauwkeurigheid bij de eerste poging en de vaste prijs voor 1M context zichzelf terugbetalen. Om je eigen maandelijkse input- en outputverhoudingen in te voeren, open je de GPT Proto vergelijkingscalculator en test je beide modellen naast elkaar op één balans.