OpenAI API-alternatieven in vogelvlucht
| Alternatief |
Beste match |
Toegangsbenadering |
Belangrijkste migratieoverweging |
| GPT Proto |
Meerdere modelfamilies en toegang met korting |
Verenigd modelplatform |
Bevestig de mogelijkheden voor het gekozen model en eindpunt |
| Anthropic Claude |
Code- en agent-workflows |
Directe model-API |
Native Claude-functies en SDK-compatibiliteit verschillen |
| Google Gemini |
Multimodale applicaties |
Directe model-API |
Geavanceerde functies vereisen mogelijk Gemini-native integratie |
| DeepSeek |
Budgetgerichte redeneertaken |
Directe model-API |
Houd rekening met cache en prijzen voor piek- versus daluren |
| Groq |
Snelheidsgevoelige applicaties |
Gehoste inferentie |
Evalueer de ondersteunde combinatie van model en functies |
| Mistral |
Documentgerichte applicaties |
Modellen plus document-API's |
OCR, gespreksstatus en inferentie zijn afzonderlijke zaken |
| OpenRouter |
Modelverkenning en provider-routing |
Multi-provider gateway |
Leg routingvereisten vast en houd rekening met platformkosten |
Hoe we deze OpenAI API-alternatieven hebben vergeleken
Gepubliceerd door GPT Proto; deze vergelijking maakt gebruik van officiële documentatie, openbare prijzen en gedocumenteerde applicatiefuncties zoals gecontroleerd op 29 oktober 2026. De aanbevelingen zijn redactionele oordelen over de geschiktheid voor workflows; er is geen privaat prestatieonderzoek tussen providers uitgevoerd. We maken onderscheid tussen directe model-API's en gateways/inferentiediensten omdat ze verschillende onderdelen van een OpenAI-opstelling vervangen.
De 7 beste OpenAI API-alternatieven
1. GPT Proto voor toegang tot meerdere modellen en korting op prijzen
GPT Proto is geschikt voor een SaaS-team waarvan het product verschillende modellen nodig heeft: één voor routinematige ondersteuning, een andere voor complexe code en wellicht afzonderlijke opties voor het genereren van afbeeldingen of video. De modelcatalogus brengt tekst-, beeld-, video- en audio-opties samen onder één account, API-sleutel en gedeeld saldo.
Dit ondersteunt een geleidelijke migratie. Behoud de GPT-verzoeken die al werken, verplaats een specifieke taak naar Claude of DeepSeek en vergelijk de resultaten voordat u de rest van de applicatie wijzigt. Een gedeeld account vermindert de complexiteit van facturering en het instellen van inloggegevens voor die evaluatie.
Er is ook een eenvoudige optie voor teams die GPT willen behouden. De GPT-6.1 Sol API-pagina vermeldt $1,60 voor input en $8 voor output per miljoen tokens, vergeleken met de standaardtarieven van OpenAI van $2 en $10. Dat is een korting van 20% op die tokentarieven. Claude Sonnet 5.5 staat genoteerd op $1,80 en $9, wat 10% onder de overeenkomstige standaardtarieven van Anthropic ligt.
Kies voor GPT Proto wanneer modelkeuze en geconsolideerde toegang de prioriteit hebben. Controleer de sectie API-gebruik van het geselecteerde model voor ondersteunde interfaces en velden; een gedeelde sleutel maakt niet elk model of media-eindpunt uitwisselbaar. Het behouden van GPT via een andere provider zorgt er ook voor dat u afhankelijk blijft van de GPT-modelfamilie.
2. Anthropic Claude voor coderen en agent-workflows
Claude hoort op de shortlist wanneer de applicatie het grootste deel van de tijd besteedt aan het bewerken van code, het analyseren van documenten of het beslissen welk hulpmiddel als volgende moet worden gebruikt. Begin met Sonnet voor dagelijks codeerwerk en agent-taken, evalueer Opus voor veeleisendere taken en overweeg Haiku voor repetitieve classificatie, extractie of routering.
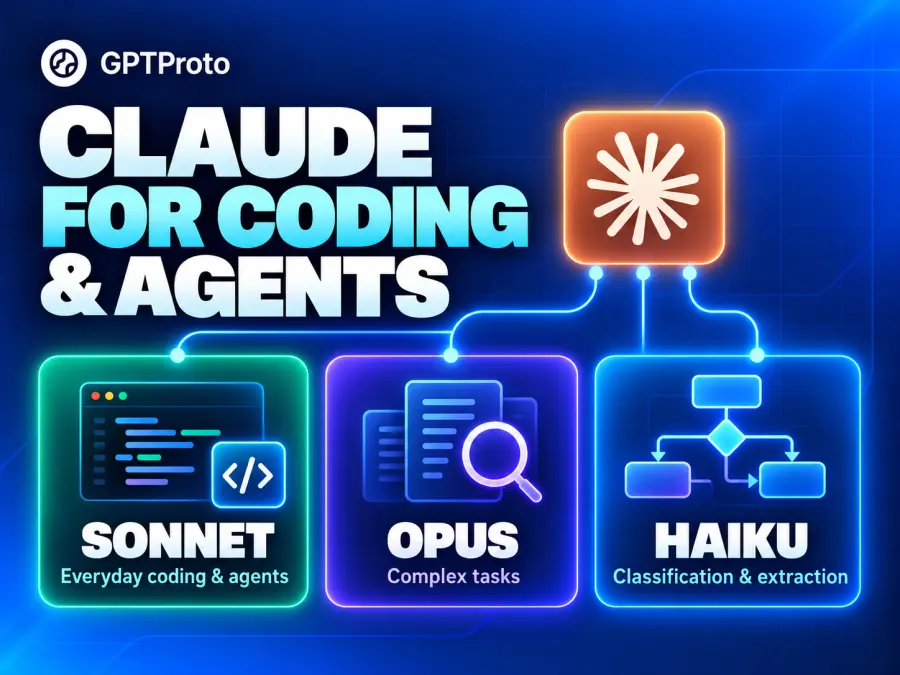
Een support-agent zou bijvoorbeeld een lichtgewicht model kunnen gebruiken om verzoeken te categoriseren en een krachtiger model kunnen reserveren voor het onderzoeken van een complex technisch probleem. De modelprijzen van Anthropic maken deze niveaus inzichtelijk: Sonnet 3.5 kost $2 voor input en $10 voor output per miljoen tokens, terwijl Haiku 3.5 begint bij $0,10 en $0,50 voor prompts tot 100K input-tokens.
Migratie vereist aandacht voor de interface. De documentatie over OpenAI SDK-compatibiliteit van Anthropic stelt dat de compatibiliteitslaag het strict veld van het tool-schema negeert. Applicaties die afhankelijk zijn van strikte validatie moeten de ondersteuning voor gestructureerde output van de native Claude API evalueren.
Gebruik de Claude-modelcollectie op GPT Proto om beschikbare routes te vergelijken. Claude is een op capaciteiten gericht alternatief; het kiezen van Sonnet tegen het officiële standaardtarief verlaagt de rekening niet automatisch ten opzichte van GPT-4o.
3. Google Gemini voor multimodale applicaties
Gemini is een nuttige kandidaat voor producten die tekst combineren met schermafbeeldingen, opgenomen audio, video of documenten. Een leer-app die de opname van een student beoordeelt en een support-tool die schermafbeeldingen interpreteert, hebben meer nodig dan alleen tekstgeneratie.
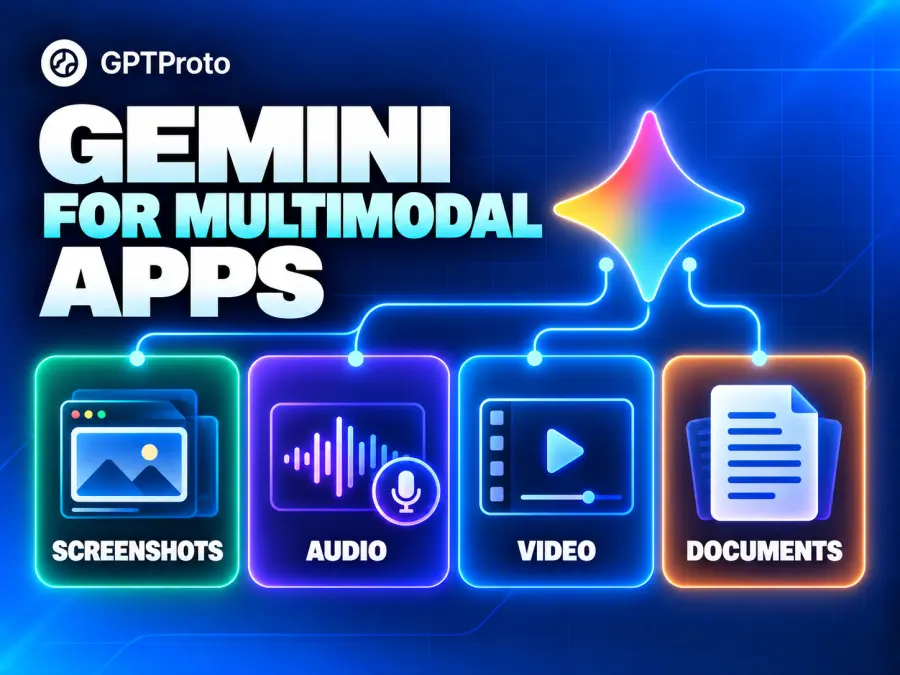
Google documenteert OpenAI SDK-compatibiliteit, inclusief het wijzigen van de basis-URL, de sleutel en het model voor ondersteunde verzoeken. Dat kan een eerste evaluatie vereenvoudigen. De integratiehandleiding legt ook uit dat geavanceerde Gemini-functies en server-side tools mogelijk extra afhandeling of native integratie vereisen.
Selecteer het model op basis van de werkelijke input- en outputvereisten. Een Flash-Lite-model kan een kostenefficiënte kandidaat zijn voor eenvoudigere verwerking, terwijl een aparte Live API real-time interactie afhandelt. Toegang tot een Gemini-teksteindpunt betekent niet dat elk Gemini-product wordt ondersteund.
Blader door Google-modellen op GPT Proto, of bekijk Gemini 1.5 Flash voor de vermelde multimodale inputs. Google biedt ook gratis niveaus voor geselecteerde modellen, met andere limieten en voorwaarden voor datagebruik dan bij betaalde toegang, zoals weergegeven in de prijsdocumentatie.
4. DeepSeek voor budgetgerichte redeneertaken
DeepSeek is het overwegen waard voor herhaalde documentanalyse, code-ondersteuning en redeneertaken waarbij tokenkosten snel oplopen. Het is met name relevant wanneer verzoeken substantiële input hergebruiken of buiten de piekuren kunnen worden uitgevoerd.
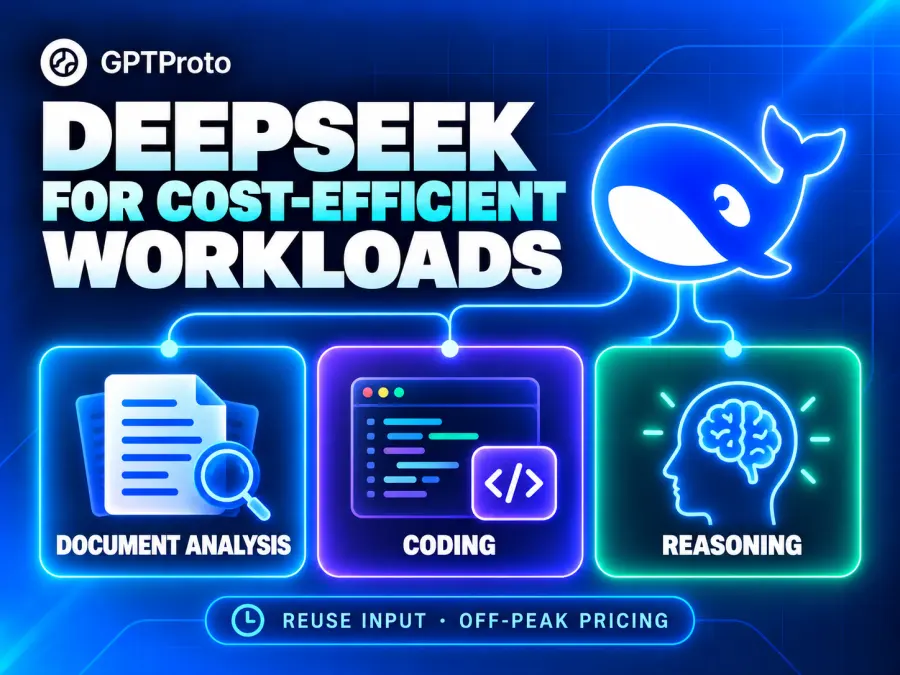
De officiële DeepSeek-prijstabel vermeldt Flash voor $0,30 per miljoen niet-gecachte input-tokens en $1,20 per miljoen output-tokens tijdens piekperiodes. Buiten de piekuren zijn de tarieven $0,15 en $0,60. Gecachte input heeft een apart, lager tarief, waardoor een terugkerende documentworkflow een andere economie kan hebben dan korte, niet-gerelateerde prompts.
De API-gids van DeepSeek documenteert toegang die compatibel is met OpenAI en Anthropic. Gebruik de exacte model-ID voor de gekozen service; compatibiliteit met een verzoekformaat betekent nog niet dat het modelgedrag en de afhandeling van tools niet gevalideerd hoeven te worden.
De DeepSeek Flash API-pagina biedt een GPT Proto-toegangsroute. Voor een bredere shortlist kunt u de top Chinese LLM-aanbieders vergelijken of Chinese LLM's voor coderen verkennen.
De lage tarieven rechtvaardigen een evaluatie, maar ze maken het niet goedkoper dan elk klein OpenAI-model.
5. Groq voor snelheidskritische applicaties
Groq is een optie voor applicaties waarbij gebruikers direct wachten op gegenereerde output: interactieve assistenten, functies met korte antwoorden en workflows met verschillende opeenvolgende modelaanroepen. De waarde ervan hangt af van het vinden van een ondersteund model dat voldoet aan de kwaliteitsvereisten van de taak.
Gebruik de documentatie over ondersteunde modellen van Groq om beschikbaarheid, limieten en gepubliceerde specificaties te controleren. Meet de tijd tot het eerste bruikbare antwoord en de totale workflowtijd in uw applicatie; het cijfer voor generatiesnelheid van een leverancier bevat niet elke netwerk- of toolvertraging.
Groq biedt OpenAI-compatibele toegang, met gedocumenteerde niet-ondersteunde velden. Het heeft ook een Responses API, maar de documentatie stelt dat applicaties zelf de gespreksgeschiedenis moeten bijhouden en opnieuw moeten verzenden.
Kies voor Groq wanneer reactiesnelheid een betekenisvolle productvereiste is en het beschikbare model past. Als de bestaande app sterk afhankelijk is van opgeslagen gesprekken, neem dan statusbeheer op in de migratieschatting. Het vervangen van de hostingservice en het vervangen van de modelontwikkelaar zijn afzonderlijke beslissingen.
6. Mistral voor documentgerichte applicaties
Mistral is het overwegen waard voor applicaties die zijn gebouwd rondom documentinname, extractie en vraag-antwoord-functionaliteit. Een tool voor factuurverwerking heeft bijvoorbeeld betrouwbare tekstextractie nodig voordat het een document kan classificeren of een discrepantie kan verklaren.
De API-catalogus en prijzen maken onderscheid tussen algemene modellen en OCR-services. Dit helpt teams om extractie en generatie afzonderlijk in te schatten in plaats van de gehele document-pipeline als één chatverzoek te behandelen.
De migratiehandleiding van Mistral behandelt Chat Completions in OpenAI-stijl. De Responses API ondersteunt tekstgeneratie, ondersteunde bestands- en afbeeldingsinvoer, functie-aanroepen en streaming. Op het moment van schrijven bevindt deze zich in de publieke preview en is deze stateless: uw applicatie levert de gespreksgeschiedenis.
Mistral is een verstandige kandidaat wanneer documentverwerking centraal staat in het product. Evalueer de extractie-output, de kwaliteit van de antwoorden verderop in het proces en de kosten van beide fasen. Een werkende chatmigratie alleen valideert nog geen volledige workflow voor documentverwerking.
7. OpenRouter voor provider-routing en modelverkenning
OpenRouter is geschikt voor teams die modellen willen vergelijken en willen bepalen welke onderliggende providers hun verzoeken afhandelen. Het kan ook helpen wanneer een applicatie een expliciete strategie voor back-up-providers nodig heeft.
Routing brengt eigen keuzes met zich mee. Bepaal of verzoeken tussen providers mogen wisselen, of elke gevraagde parameter moet worden ondersteund en welke vereisten voor gegevensverwerking van toepassing zijn. OpenRouter biedt instellingen voor provider-voorkeuren, fallback-instellingen en parameterondersteuning; die instellingen verdienen aandacht wanneer een applicatie afhankelijk is van een specifieke functie.
Houd voor een eerste evaluatie de provider en het model vast, zodat veranderingen in de resultaten gemakkelijker te onderzoeken zijn. Test vervolgens de beoogde fallback-configuratie, inclusief fouten en verschillen in gebruiksrapportage. Kosten voor het kopen van credits en eventuele BYOK-kosten horen ook in de kostenraming thuis.
Kies voor OpenRouter wanneer routeringscontroles een primaire vereiste zijn. Onze vergelijking van LLM API-providers legt uit hoe gateways, beheerde platforms en inferentie-specialisten van elkaar verschillen.
Welke OpenAI API-alternatieven zijn daadwerkelijk goedkoper
Er zijn twee afzonderlijke kostenbeslissingen. U kunt hetzelfde model behouden via een andere toegangsprovider, of het model veranderen dat het werk doet. De eerste optie biedt een relatief directe vergelijking van de tokenprijs. De tweede vereist een kwaliteitsbeoordeling naast de factuur.
Het onderstaande voorbeeld gaat uit van 10 miljoen niet-gecachte invoertokens en 2 miljoen gefactureerde uitvoertokens per maand. Dit is een berekend gebruiksscenario, geen benchmark van gelijke taakkwaliteit. Gefactureerde uitvoer omvat redeneertokens wanneer de provider deze als uitvoer in rekening brengt. Toolkosten, belastingen, cache-writes en batchkortingen zijn uitgesloten.
| Model en toegangsweg |
Invoer per 1M |
Uitvoer per 1M |
Voorbeeldkosten |
| GPT-6.1 Sol via OpenAI Standard |
$2.00 |
$10.00 |
$40.00 |
| GPT-6.1 Sol via GPT Proto |
$1.60 |
$8.00 |
$32.00 |
| GPT-6 Luna via OpenAI Standard |
$0.10 |
$0.50 |
$2.00 |
| Haiku 5.5 direct, prompts tot 100K |
$0.10 |
$0.50 |
$2.00 |
| DeepSeek Flash direct, piek |
$0.30 |
$1.20 |
$5.40 |
| DeepSeek Flash direct, daluren |
$0.15 |
$0.60 |
$2.70 |
| Gemini 3.1 Flash-Lite direct, standaard tekst |
$0.25 |
$1.50 |
$5.50 |
De tarieven zijn afkomstig van de OpenAI-prijspagina, GPT Proto's Sol-pagina, en de hierboven gelinkte prijspagina's van Anthropic, DeepSeek en Google.
Het Sol-voorbeeld bespaart $8, of 20%, bij het vermelde tokenvolume. De rijen met lichtgewicht modellen laten zien waarom een alternatief moet worden vergeleken met het OpenAI-model dat u daadwerkelijk nodig heeft. Een klein OpenAI-model kan minder kosten dan een capabeler alternatief.
De drempel van 100K van Haiku is van toepassing op de invoer van elk verzoek, niet op het maandelijkse volume. De twee rijen van DeepSeek gaan ervan uit dat al het gebruik binnen de vermelde prijsperiode valt; gemengd verkeer levert een gecombineerde factuur op. Tokenizers, redeneerinspanningen en nieuwe pogingen kunnen ook veranderen hoeveel tokens een taak verbruikt. Vergelijk voor agent-workloads betaalbare LLM-API's op basis van taakgeschiktheid en houd vervolgens de kosten per geaccepteerd resultaat bij.
Hoeveel van uw OpenAI-integratie kunt u behouden
Begin met het identificeren van de interfaces en gedragingen die de applicatie gebruikt. Een succesvol begroetingsverzoek zegt maar heel weinig over een agent die tools gebruikt.
| Bestaande afhankelijkheid |
Controleren vóór migratie |
Mogelijke applicatiewijziging |
| Chat en streaming |
Verzoekvelden, event-formaat, beëindiging |
Clientconfiguratie of antwoordparser |
| Tool-aanroepen |
Argumenten, toolresultaten, vervolgstap |
Tool-adapter en validatie |
| Gestructureerde output |
Gedwongen schemaregels en foutgevallen |
Schemawijzigingen en controles aan de applicatiezijde |
| Opgeslagen gesprekken |
Opslag en ophalen van geschiedenis |
Persistentie en geschiedenis-replay |
| Bestanden of ingebouwde tools |
Gelijkwaardige functie en facturering |
Aparte retrieval- of toolservice |
Het verslag van een ontwikkelaar over de overdraagbaarheid van gestructureerde output beschrijft hoe beperkingen per provider verschillend worden afgehandeld. Beschouw dit als de ervaring van één vakman en verifieer vervolgens uw exacte schema aan de hand van de huidige documentatie en antwoorden.
Voer representatieve verzoeken uit via de kandidaat-integratie: normaal verkeer, lange invoer, een mislukte tool en een output die uw verwachte formaat schendt. Registreer geaccepteerde resultaten, gefactureerd gebruik, responstijd en nieuwe pogingen. Voor codeertoepassingen voert u de gegenereerde wijziging ook uit via de eigen controles van het project.
Houd een manier achter de hand om het verkeer terug te sturen naar de vorige configuratie terwijl u de vervanging evalueert. Als u nog steeds een algemeen platform voor een nieuw product kiest, behandelt de bredere AI API-gids voor ontwikkelaars die beslissing.
Alternatieven voor OpenAI Realtime Assistants en Moderation API's
Alternatieven voor de OpenAI Realtime API
Gemini Live API is een kandidaat voor realtime spraak- en visuele interactie. Evalueer de afhandeling van onderbrekingen, audioformaten, sessiegedrag en responstijd van spraak. Een pijplijn die spraakherkenning, een LLM en spraaksynthese combineert, is een andere architectuur, maar de afzonderlijke fasen voegen integratiewerk en latentie toe. Gewone gestreamde tekst is geen gelijkwaardige vervanging voor een live audiosessie.
Alternatieven voor de OpenAI Assistants API voor productie-agents
De Assistants API werd op 26 augustus 2026 stopgezet, volgens de migratiegids van OpenAI. Teams die bij OpenAI blijven, moeten het migratiepad voor Responses volgen.
Voor een provider-onafhankelijk ontwerp combineert u een gekozen model-API met een orchestratie-runtime zoals LangGraph. De status- en checkpointing-componenten kunnen persistente workflows ondersteunen, maar uw team moet nog steeds tool-uitvoering, retrieval, opslag en herstel implementeren. Het wisselen van het model-eindpunt migreert die verantwoordelijkheden niet en maakt oude threads niet automatisch opnieuw aan.
Alternatieven voor de OpenAI Moderation API voor chatapplicaties
Azure AI Content Safety biedt tekst- en beeldanalyse voor potentieel schadelijke inhoud. Vergelijk ondersteunde categorieën, talen, drempelwaarden, responstijden en fout-positieven op basis van de voorbeelden van uw applicatie.
Moderatie is een aparte selectie van het conversationele model. Voor creatieve chat of rollenspellen behandelt onze vergelijking van ongecensureerde LLM-API's het modelgedrag; een applicatie moet nog steeds zelf beslissen welke inhoud wordt toegestaan en hoe dit wordt afgedwongen.
Hoe u OpenAI API-alternatieven kunt proberen op GPT Proto
Begin met één werklast die u consistent kunt beoordelen, zoals het beantwoorden van ondersteuningsvragen of het extraheren van velden uit een document.
Kies een model. Open de GPT Proto-catalogus en vergelijk de relevante Claude-, Gemini- of DeepSeek-opties.
Open de installatie-instructies van het model. Gebruik 'Try This Model' waar beschikbaar, of het gedeelte API-gebruik. Kopieer de modelspecifieke instructies naar uw codeerassistent of volg het getoonde voorbeeld.
Configureer de integratie. Maak een GPT Proto API-sleutel aan en gebruik het model-ID, het eindpunt en de aanvraagindeling die op die pagina worden getoond. Bewaar inloggegevens in de geheime configuratie van de applicatie.
Evalueer een kleine set aanvragen. Vergelijk nuttige resultaten, gefactureerd gebruik en responstijd voordat u het verkeer uitbreidt. Test vereiste tools en gestructureerde uitvoer afzonderlijk.