Kimi K3.1 Pro vs Opus 5.5 in vogelvlucht
| Item |
Kimi K3.1 Pro |
Claude Opus 5.5 |
| Officiële input / output prijs per 1M tokens |
$2 / $10 |
$4 / $20 |
| GPT Proto input / output prijs per 1M tokens |
$2 / $10 |
$3.60 / $18 |
| Contextvenster |
Ongeveer 1M tokens |
1M tokens |
| Model input / output |
Tekst en afbeeldingen / tekst |
Tekst en afbeeldingen / tekst |
| Standaard redeneerinspanning van de native API |
Max |
Medium |
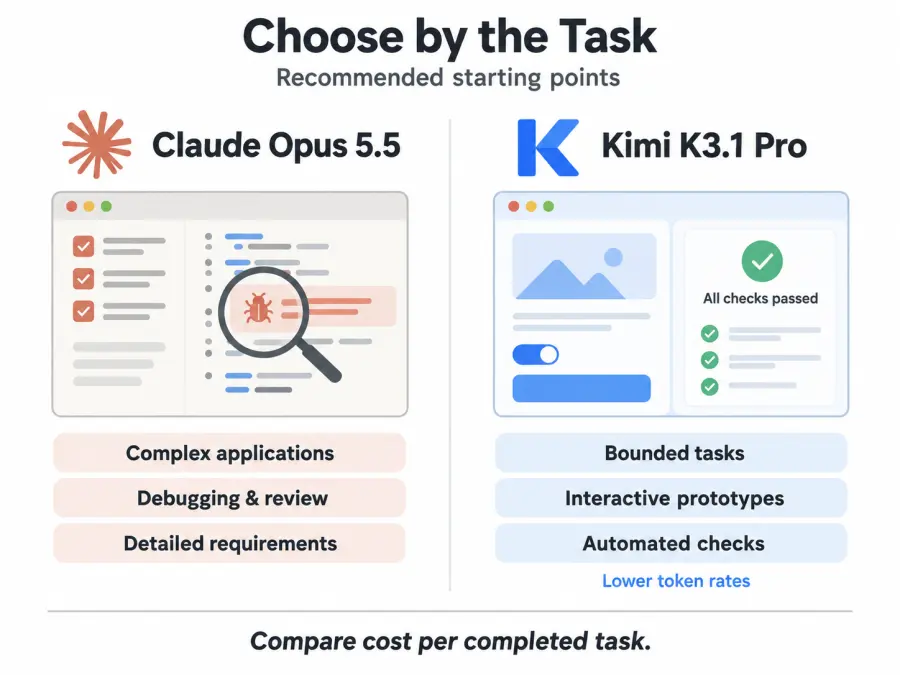
| Mijn aanbevolen eerste test |
Begrensde taken met duidelijke controles |
Complexe ontwikkeling en eindbeoordeling |
Prijzen zijn gecontroleerd op 29 oktober 2026. Officiële specificaties zijn afkomstig uit de Kimi API-documentatie en Claude modeldocumentatie. GPT Proto-tarieven staan vermeld op de Kimi K3.1 Pro API-pagina en Claude Opus 5.5 API-pagina. Cache-operaties en andere toepasbare kosten vereisen een aparte administratie.
Gebruik voor een snelle catalogusvergelijking de Kimi K3.1 Pro vs Claude Opus 5.5 vergelijkingspagina. Zie voor de achtergrond van deze Kimi-release wat er is veranderd in Kimi K3.1 Pro.
Wat de benchmarks ons vertellen over coderen en wat ze weglaten
Moonshot's gepubliceerde lanceringsvergelijking rapporteert 65,7% voor Kimi K3.1 Pro en 66,4% voor Opus 5.5 op Terminal-Bench 4.0. Dit zijn door de leverancier gepubliceerde cijfers, in afwachting van onafhankelijke verificatie van die specifieke vergelijking. Ze ondersteunen het serieus nemen van Kimi voor terminal-gebaseerd werk; ze stellen geen gelijke prestaties vast voor applicatieontwikkeling.
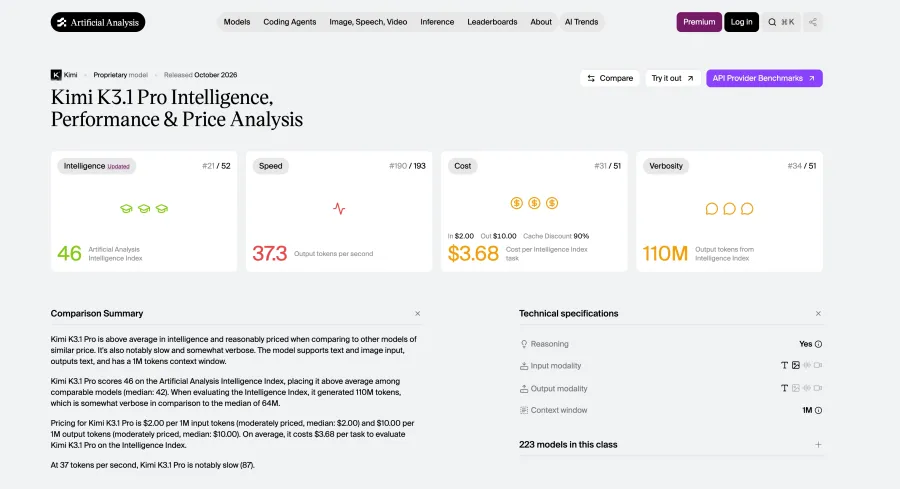
Het bredere onafhankelijke beeld is anders. Op 29 oktober toonden de modelpagina's van de Artificial Analysis Intelligence Index v5.0 Kimi op 46 en Opus op 58, waarbij de laatste werd gelabeld als Max met Default Fallback. Die indexpunten zijn geen percentages of een slagingspercentage voor coderen. Houd de indexversie en configuratie gekoppeld aan de vergelijking.
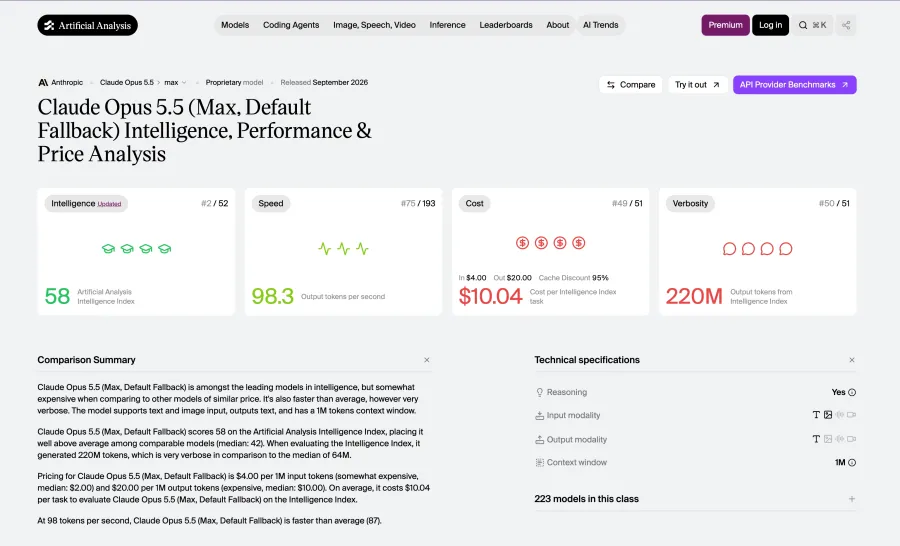
Ik zou Opus behandelen als de initiële kwaliteitsbasislijn voor veeleisend werk, en vervolgens testen of Kimi aan dezelfde acceptatiecriteria voldoet tegen lagere kosten. Een terminal-benchmark kan je niet vertellen of een boekingsformulier zijn status behoudt of dat een dashboard leesbaar blijft op mobiel. Jouw applicatietests moeten dat beantwoorden.
Frontend-ontwikkeling: Van een screenshot naar een werkende interface
Scheid bij een screenshot-naar-interface-taak het uiterlijk van het gedrag. Een getrouwe lay-out heeft nog steeds werkende navigatie, formulierstatussen, toetsenbordtoegang en een bruikbare mobiele versie nodig. Vraag daarna om een wijziging. Het toevoegen van een filter zonder de bestaande lay-out te verbreken is een andere test dan het genereren van een nieuwe pagina.
Er is hier een nuttig ontwikkelaarsvoorbeeld. In Melvynx's gepubliceerde vergelijking gaf hij de voorkeur aan de visuele behandeling van een tijdzone-checker door Opus. Dat is een esthetisch oordeel over één build, in plaats van een gemeten winstpercentage voor frontend.
Voor een marketingsite of een dashboard voor klanten zou mijn eerste keuze Opus zijn wanneer het ontwerp onderscheidend vermogen en herhaalde verfijning nodig heeft. Kimi is een verstandige kandidaat voor een interne interface met een duidelijk ontwerpsysteem, vooral wanneer je het resultaat kunt inspecteren vóór de release. De afweging is de tijd die wordt besteed aan het corrigeren van wat de initiële prompt openlaat.
Beschouw een boekingsinterface als een evaluatieopdracht. Geef beide modellen dezelfde referentieafbeelding, bestaande componentenbibliotheek en vereisten voor datumsselectie, niet-beschikbare slots, validatie en bevestiging. Vraag elk model om de interface te verbinden met dezelfde mock-API. Introduceer vervolgens een mislukt verzoek en controleer of de gebruiker kan herstellen zonder het formulier te verliezen.
Die laatste stap maakt dit een applicatievergelijking. Het legt bloot of een aantrekkelijke pagina ook de volgende actie van de klant afhandelt.
Interactieve apps en 3D: Visuele kwaliteit, logica en runtime-prestaties
Kimi's casus wordt interessanter bij interactief visueel werk. Melvynx's lava-lamp voorbeeld bevatte verlichtings- en kleurregelaars. Hij beoordeelde het resultaat van Opus, waar meer moeite in zat, als het beste, terwijl hij Kimi's materialen en glaseffecten overtuigend vond. Zijn gerapporteerde run-kosten waren $2,30 voor Kimi High en $4,16 voor Max, tegenover $4,35 voor Opus Medium en $6,39 voor Extra High.
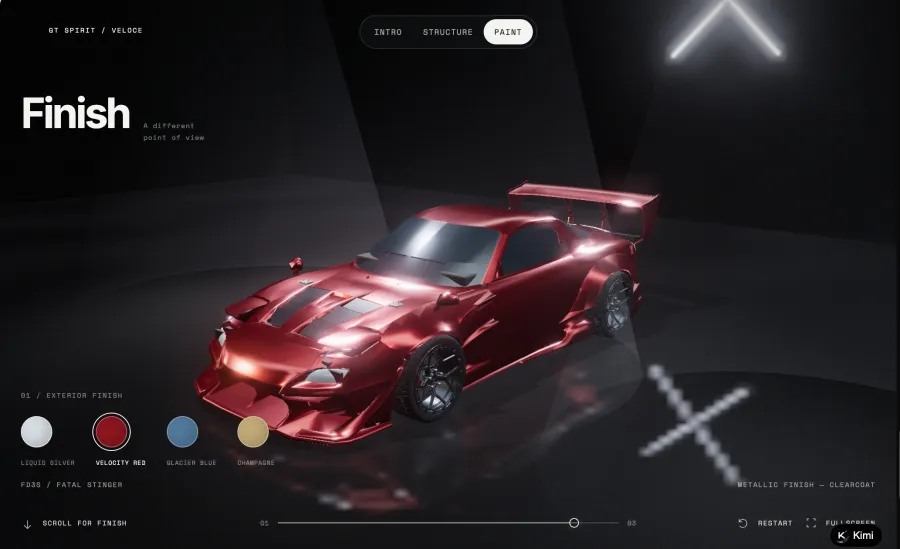
Dezelfde recensie beschrijft een crashsimulatie die beter werkte bij Kimi High dan bij Max. De auteur maakt melding van een Kimi-affiliatelink en een gedeelde, niet-geïsoleerde werkruimte. Deze voorbeelden zijn nuttige observaties, met die beperkingen in acht genomen.
Mijn interpretatie is dat Kimi het testen waard is voor productconfiguratoren, educatieve demo's en visuele prototypes. Automatisch kiezen voor een instelling met meer inspanning zou een van de praktische lessen van die voorbeelden missen. Begin met een expliciete vereiste en inspecteer het artefact.
Definieer voor een meubelconfigurator wat er moet veranderen wanneer iemand een materiaal selecteert, van camerabeeld wisselt of het ontwerp reset. Controleer of de weergegeven prijs overeenkomt met de selectie. Ververs de pagina. Probeer de bedieningselementen op een telefoon. Een visueel aantrekkelijke stoel is slechts een deel van het eindproduct.
Technische nauwkeurigheid heeft zijn eigen controles nodig. Moonshot's BenchCAD-resultaten rapporteren 92,7% voor Kimi en 96,2% voor Opus met tools, gebruikmakend van een meetwaarde voor geometriereconstructie. Dat door de leverancier gepubliceerde resultaat beantwoordt een andere vraag dan of een scène er aantrekkelijk uitziet. Een overtuigende animatie heeft nog steeds afzonderlijke validatie nodig voordat je deze gebruikt om natuurkunde te onderwijzen of een technisch proces weer te geven.
Voor een prototype zou ik eerst Kimi proberen. Voor een precisiegevoelige applicatie zou ik beginnen met Opus en domeinspecifieke controles vereisen, ongeacht welk model de code produceert.
Agent-ontwikkeling: Kan het model een taak met meerdere stappen voltooien?
Een agent die in een repository werkt, moet het bestaande gedrag begrijpen, bestanden kiezen om te wijzigen, tools uitvoeren, fouten interpreteren en beslissen wanneer hij moet stoppen. Fouten kunnen zich tussen die stappen opstapelen.
Beide leveranciers publiceren voorbeelden van uitgebreid werk. Moonshot beschrijft hoe Kimi een simulator diagnosticeert en corrigeert voordat een loop-controller opnieuw wordt getraind. Het Opus 5.5-lanceringsrapport van Anthropic beschrijft verbeteringen in een webapplicatie, waaronder een taak voor laadtijden die in 39 van de 40 pogingen succesvol werd voltooid. Dit zijn afzonderlijke voorbeelden van leveranciers, in plaats van een gedeelde directe vergelijkingstest.
Voor een bestaande facturatieapplicatie zou een nuttige vergelijking het toevoegen van CSV-imports zijn. Vereis veldtoewijzing, afhandeling van ongeldige rijen, detectie van duplicaten, een voorbeeldweergave en tests die het bestaande gedrag dekken. Laat elk model werken vanuit dezelfde repository-snapshot en inspecteer beide patches. Een samenvatting met de tekst “alle tests geslaagd” heeft een testlogboek nodig als onderbouwing.
Voor dat soort wijzigingen in meerdere bestanden zou Opus mijn standaard startpunt zijn. Kimi is gemakkelijker te evalueren op een begrensd onderdeel van de taak, zoals het implementeren van validatie tegen een overeengekomen schema. Breid de scope uit nadat de tests hebben aangetoond dat het de omliggende applicatie aankan.
Configuratie is ook van belang. Kimi's richtlijnen voor toolgebruik vereisen dat het volledige assistentbericht over verschillende beurten behouden blijft. De Opus-documentatie van Claude beschrijft modelspecifiek denk- en toolgedrag. Controleer die details voor de door u gekozen route; het matchen van een basisverzoekformaat betekent niet dat het gedrag van de agent identiek is.
Prijzen en kosten: Wat kost een geaccepteerd resultaat werkelijk?
Kimi K3.1 Pro heeft de lagere standaardtarieven voor input en output. De moeilijkere vraag is hoeveel aanroepen, nieuwe pogingen en beoordelingscycli uw taak nodig heeft.
Hier is een planningsvoorbeeld met de vermelde tarieven van GPT Proto. Ga ervan uit dat elke poging 1 miljoen niet-gecachte inputtokens en 200.000 gefactureerde outputtokens verbruikt. Dit zijn hypothetische volumes, geen geobserveerde applicatieresultaten.
| Planningsscenario |
Kimi K3.1 Pro |
Claude Opus 5.5 |
| Eén poging bij de vermelde volumes |
$4.00 |
$7.20 |
| Twee pogingen, elk bij dezelfde volumes |
$8.00 |
$14.40 |
Onder die aannames kost een Kimi-resultaat waarvoor twee pogingen nodig zijn meer aan tokens dan een Opus-resultaat dat na één poging wordt geaccepteerd. Echte nieuwe pogingen herhalen zelden exact dezelfde tokenvolumes, dus gebruik uw gebruiksgegevens voor de werkelijke berekening.
Caching verandert de vergelijking opnieuw. Beide leveranciers vermelden officiële cache-reads tegen $0,20 per 1 miljoen tokens in hun Kimi en Claude documentatie. Een lange agentsessie met uitgebreide cache-hits zal een andere kostenverhouding hebben dan een vers verzoek. Controleer ook de kosten voor cache-writes, outputgebruik en de werkelijke tarieven van uw provider.
Voor een team zou ik de kosten per geaccepteerde taak bijhouden, naast de verstreken tijd en de minuten van de beoordelaar. Een goedkoper concept kan een goede prijs-kwaliteitverhouding bieden als het snel te controleren is. Het wordt minder aantrekkelijk wanneer een ontwikkelaar moet reconstrueren wat de agent heeft gewijzigd voordat hij het kan vertrouwen.
Hoe je beide modellen zelf kunt vergelijken in je app via GPT Proto
Gebruik een kleine applicatiewijziging met waarneembare resultaten. Een boekingsformulier, CSV-importeur of productconfigurator levert nuttiger bewijs op dan een onbeperkt verzoek om “iets indrukwekkends te bouwen.”
Open de Kimi-modelpagina en de Opus-modelpagina. Gebruik 'Try this model' en 'Quick Start' om de integratiehandleiding te verkrijgen en kopieer vervolgens de Markdown-instructies naar je code-assistent. Bewaar je API-sleutel in een lokale omgevingsvariabele of server-side configuratie.
Controleer voordat je de ontwikkelkwaliteit evalueert of beide modelroutes reageren. Dit verbindingsvoorbeeld volgt het Chat Completions-formaat dat op de modelpagina's is gepubliceerd. Stel GPTPROTO_API_KEY lokaal in voordat je het uitvoert; de verzoeken verbruiken betaalde tokens.
for model in kimi-k3.1-pro claude-opus-5-5; do
  curl --fail-with-body --silent --show-error --max-time 180 \
    https://gptproto.com/v1/chat/completions \
    -H "Authorization: Bearer $GPTPROTO_API_KEY" \
    -H "Content-Type: application/json" \
    --data "{
      \"model\": \"$model\",
      \"messages\": [{\"role\": \"user\",
        \"content\": \"Return only: API connection OK\"}]
    }"
done
Dit controleert de connectiviteit, niet de codeerkwaliteit. De native API's hebben verschillende standaardinstellingen voor redeneren; configureer en noteer de ondersteunde inspanningsinstellingen vóór een applicatievergelijking. Een API-antwoord heeft ook een agent of applicatie eromheen nodig om bestanden te bewerken, tools uit te voeren en een browser te inspecteren.
Start voor de ontwikkelingsproef elk model vanuit een schone kopie van hetzelfde project. Lever dezelfde taak, machtigingen, afhankelijkheden en acceptatietests. Noteer de modelroute, inspanning, gefactureerd gebruik, voltooiingstijd en vereiste handmatige wijzigingen. Herhaal de taak voordat je een klein verschil doorvoert als je standaardinstelling voor productie.
Als het eindpunt een authenticatiefout retourneert, controleer dan de sleutel en de autorisatie-header. Als een optionele parameter wordt geweigerd, vergelijk deze dan met de huidige handleiding op de modelpagina. Controleer of een succesvol antwoord de beoogde modeloutput bevat voordat je de taak uitbreidt.
Welk model moet je kiezen?
| Jouw werklast |
Mijn startkeuze |
Voorwaarde om het te behouden |
| Klantgerichte frontend met herhaaldelijke ontwerpwijzigingen |
Opus 5.5 |
Betere geaccepteerde output rechtvaardigt de kosten |
| Interactief prototype of visueel experiment |
Kimi K3.1 Pro |
Besturingselementen werken en het artefact is eenvoudig te inspecteren |
| Complexe wijzigingen in een bestaande applicatie |
Opus 5.5 |
Repository-tests en review ondersteunen de keuze |
| Herhaalde implementatie op basis van een vaste specificatie |
Kimi K3.1 Pro |
Geautomatiseerde controles houden de correctiekosten laag |
| Precisiegevoelige code of simulatie |
Opus als initiële basislijn |
Externe validatie is vereist voor beide modellen |
Ik zou Opus 5.5 kiezen als de initiële standaard voor een team dat aanzienlijk applicatiewerk aan een agent overdraagt. Het bredere evaluatiebewijs ondersteunt om daar te beginnen, terwijl de daadwerkelijke repository bepaalt of de meerprijs gerechtvaardigd is.
Kimi K3.1 Pro is een praktische kandidaat om de kosten van goed gedefinieerd werk te verlagen. Begin met taken die je kunt inspecteren of testen, meet de geaccepteerde resultaten en geef het meer verantwoordelijkheid naarmate het bewijs verbetert. Dat is een sterkere reden om over te stappen dan een bijna-gelijkspel op één benchmark.
Probeer een kleine taak op de Kimi K3.1 Pro API en Claude Opus 5.5 API pagina's, gebruik de integratiehandleidingen en vergelijk het resultaat dat jouw applicatie kan accepteren.