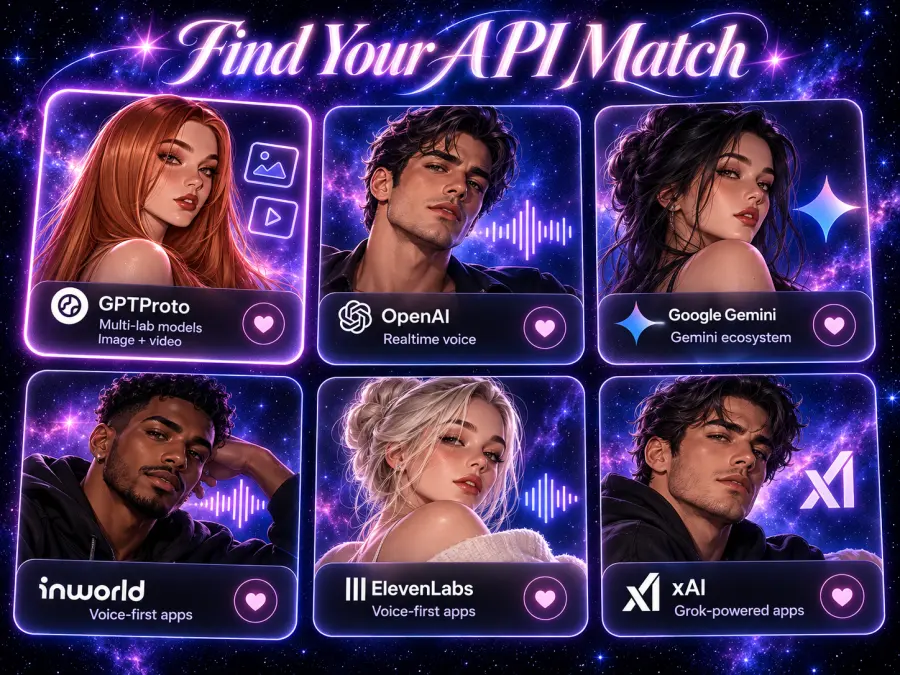
Beste API-aanbieders voor AI-companion-apps in één oogopslag
| Aanbieder |
Beste voor |
Te evalueren mogelijkheden |
Belangrijkste afweging |
| GPT Proto |
Modellen van verschillende laboratoria combineren met visuele content |
Ondersteunde chat-, beeld- en videomodellen onder één sleutel en balans |
Uw app beheert nog steeds de karakterstatus en het langetermijngeheugen |
| OpenAI |
Directe integratie met OpenAI realtime stemmodellen |
Tekst, genereren van afbeeldingen, spraak en realtime audio-interactie |
Toegang tot andere modellijnen vereist aanvullende integraties |
| Google Gemini API |
Producten die het AI-ecosysteem van Google gebruiken |
Gemini-chat, live-interactie, beeldgeneratie en videomodellen |
Live-invoer en gegenereerde media gebruiken verschillende modelmogelijkheden |
| Inworld |
Configureerbare realtime stemervaringen |
STT, selecteerbare LLM's, TTS, plus beeld- en video-inferentie |
Geheugen tussen sessies vereist opslag en herstel door de applicatie |
| ElevenLabs |
Spraakgestuurde producten die ook visuele content nodig hebben |
Agents, configureerbare stemmen en API's voor het genereren van beeld/video |
Toegang tot de Media API vereist een abonnement |
| xAI |
Producten gebouwd rondom Grok |
Chat, Imagine beeld/video-generatie en spraak-API's |
Elke functie heeft zijn eigen verzoek- en factureringsvereisten |
Hoe we deze API-aanbieders hebben geselecteerd
Dit is een op documentatie gebaseerde selectiegids, gecontroleerd op 27 oktober 2026. De aanbevelingen weerspiegelen de beschikbare mogelijkheden, integratievereisten en gepubliceerde factureringsstructuren. Ze vormen geen gemeten ranglijst van dialoogkwaliteit of responssnelheid.
Ik heb prioriteit gegeven aan aanbieders die een ontwikkelaar kan evalueren voor een companion-product, en vervolgens gekeken naar modelkeuze, media-ondersteuning, applicatiewerk en kosten. Een nuttige vergelijking moet uitleggen of een dienst model-inferentie, een spraakconversatie-pipeline of aanvullende productinfrastructuur biedt.
Echte projecten laten zien waarom dat onderscheid belangrijk is. Het open-source Utsuwa companion-project configureert LLM- en tekst-naar-spraak-aanbieders afzonderlijk. De applicatie haalt de gespreksgeschiedenis op, voegt relevante herinneringen toe en past de context aan het geselecteerde model aan. De keuze van de aanbieder is slechts één onderdeel van dat systeem.
Voor meer voorbeelden, verken GPT Proto's karakter-chat-apps en hun modelgebruik. Gebruik de lijsten om applicatiepatronen en modelkeuzes te onderzoeken. Ze bepalen niet welke leverancier het beste zal presteren voor uw eigen app.
6 API-aanbieders om te overwegen voor uw companion-app
1. GPT Proto voor het combineren van chat-, beeld- en videomodellen
GPT Proto is het sterkste startpunt op deze shortlist wanneer je verschillende modelfamilies wilt vergelijken en gegenereerde beelden via hetzelfde account wilt toevoegen. De AI API voor rollenspellen biedt je een plek om karakterprompts te evalueren en ondersteunde modellen te vergelijken voordat je je aan één model verbindt.
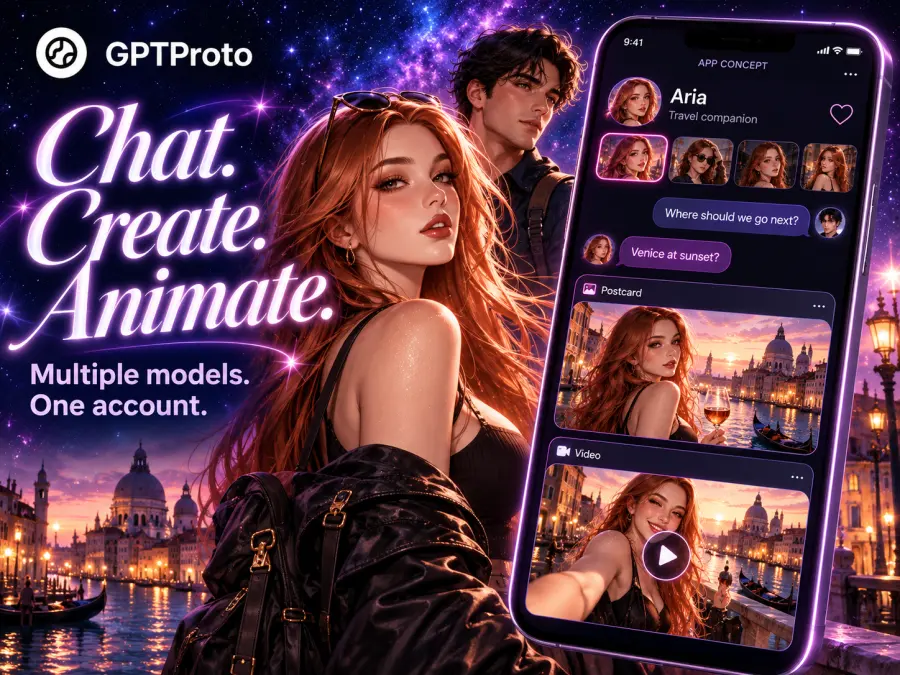
Denk aan een fictieve reisgenoot: een chatmodel schrijft het gesprek, een beeldmodel maakt een ansichtkaart van het personage en een videomodel animeert een scène. Die taken kunnen verschillende modellen gebruiken. GPT Proto heeft speciale pagina's voor opties zoals Nano Banana 2.1 beeldgeneratie en Kling 4.0 videogeneratie, met modelspecifieke verzoekvoorbeelden.
Gedeelde toegang vermindert het aantal accounts en saldi dat je team moet beheren. De integratie vereist nog steeds een afzonderlijke afhandeling voor elke taak. Een chat-completions-verzoek en een asynchrone videotaak hebben verschillende levenscycli.
Voor een concreet budgetreferentie: GPT-6 Luna op GPT Proto vermeldt $0,08 per miljoen input-tokens en $0,40 per miljoen output-tokens. Dat maakt het een kandidaat voor goedkope chat-experimenten; de kwaliteit van het personage vereist een eigen evaluatie.
Kies GPT Proto wanneer modelflexibiliteit en visuele functies prioriteiten zijn. Bouw geheugen, gebruikersrechten en karakterstatus in je applicatie en verifieer eventuele vereiste realtime spraakfuncties afzonderlijk.
2. OpenAI voor directe toegang tot realtime spraakmodellen
OpenAI is een praktische keuze wanneer de vereisten van je product gericht zijn op hun modellen en realtime spraakinteractie. De Realtime API verwerkt audio direct, behoudt de gespreksstatus en ondersteunt tools. De gedocumenteerde browser-flow maakt gebruik van een efemeer client-geheim en WebRTC; serververbindingen kunnen gebruikmaken van WebSocket.
Dat is nuttig voor een sprekende metgezel die onderbrekingen moet kunnen afhandelen of een tool moet kunnen aanroepen tijdens het gesprek. Je kunt ontwikkelen tegen de originele API en de bijbehorende SDK's, met minder tussenliggende services om te onderzoeken wanneer een modelspecifieke functie zich onverwacht gedraagt.
De beperking is de modelkeuze tussen leveranciers. Als je product later de dialoogstijl van een ander lab of een ander beeldmodel nodig heeft, zul je die integratie zelf moeten toevoegen. Opgeslagen gespreksstatus vereist ook een expliciet ontwerp voor gebruikersgeschiedenis en het ophalen van geheugen.
Controleer voor video zorgvuldig de huidige beschikbaarheid. De afschrijvingskennisgeving van OpenAI vermeldt de stopzetting van de Videos API en Sora 2 API op 24 september 2026. Een toegankelijke oudere tutorial is onvoldoende bewijs dat het eindpunt beschikbaar blijft.
Kies OpenAI wanneer directe toegang tot de realtime-mogelijkheden zwaarder weegt dan de noodzaak om tussen modelfamilies te schakelen.
3. Google Gemini API voor apps gebouwd rondom Google AI
Google is het overwegen waard als je hun ontwikkelaars-ecosysteem al gebruikt en gesprekken, visuele input, gegenereerde afbeeldingen en videofuncties binnen die omgeving wilt evalueren.
De Gemini Live API ondersteunt streaming-interacties met WebSocket-verbindingen aan de frontend of backend. Google raadt tijdelijke tokens aan voor productie-clientverbindingen. Dit kan geschikt zijn voor een companion die reageert op gesproken input en informatie van een camera of gedeeld scherm.
Gegenereerde video is een aparte selectie. De huidige Gemini-videogids wijst ontwikkelaars op Gemini Omni Flash en maakt onderscheid met de stopgezette Veo 3.1 Preview-endpoints. Voor een personage dat een kort geanimeerd bericht verstuurt, kun je beter een generatiemodel evalueren in plaats van aan te nemen dat Live video-input die output levert.
Het praktische werk bestaat uit het selecteren en testen van de juiste modellen voor elke functie. Een product kan verschillende instellingen, gebruikslimieten en facturatieberekeningen vereisen voor chat, spraak en media. Houd die kosten apart in je prognose.
Kies voor Google wanneer het ecosysteem bij je app past en je je comfortabel voelt bij het selecteren van verschillende modellen voor verschillende interacties.
4. Inworld voor configureerbare realtime spraakpijplijnen
Inworld verdient een nadere blik wanneer gesproken conversatie centraal staat in de ervaring. De Realtime API combineert spraak-naar-tekst, het door jou gekozen LLM en tekst-naar-spraak, terwijl het beurtwisselingen en onderbrekingen afhandelt via WebSocket of WebRTC.
Het heeft ook een bredere mediadekking. Inworld Inference stelt tekst-, beeld- en videomodellen beschikbaar, dus het platform omschrijven als een dienst voor alleen spraak zou een deel van het aanbod tekortdoen.
De belangrijke grens is persistent geheugen. De documentatie over langetermijngeheugen legt uit dat realtime sessies tijdelijk zijn. Je client moet het geheugen extern opslaan en herstellen voor een toekomstige sessie. Dit is een concrete verantwoordelijkheid van de applicatie om mee te nemen in ontwikkelingsschattingen.
Houd voor kostenevaluatie spraakherkenning, LLM-verbruik en gegenereerde spraak apart bij en voeg daar mediagebruik aan toe. Een lage prijs per TTS-eenheid bepaalt niet de prijs van een volledig gesprek.
Kies voor Inworld wanneer configureerbare spraakinteractie een kernvereiste is en je minder werk wilt hebben aan orkestratie. Plan de database en de flow voor geheugenherstel naast de spraakintegratie.
5. ElevenLabs voor spraakgestuurde apps met visuele functies
ElevenLabs is een kandidaat wanneer u wilt dat spraakconfiguratie en gespreksbesturing deel uitmaken van het platform dat u aanschaft. ElevenAgents ondersteunt de selectie van taalmodellen, gespreksbeurten, onderbrekingen en implementatie via web- en mobiele integraties.
Het aanbod voor beeld en video verandert de vergelijking. De Image & Video API-gids documenteert afzonderlijke asynchrone generatie-endpoints, waarbij resultaten worden verzameld via webhooks of polling. Toegang vereist een Pro-abonnement of hoger en de relevante API-rechten.
Die abonnementsvereiste is van belang voor een klein prototype. Vergelijk uw verwachte functiegebruik met de services die beschikbaar zijn onder het abonnement dat u van plan bent aan te schaffen. Mediageneraties verbruiken credits op basis van het geselecteerde model, de instellingen en de invoer; een spraaktegoed moet niet worden beschouwd als een onbeperkt mediabudget.
Er is nog een kostenverschil: de agentmodel-documentatie houdt apart rekening met het gebruik van LLM's van derden. Schat de gespreksconfiguratie die u daadwerkelijk gaat inzetten in plaats van de algemene spraakprijs als totaal te gebruiken.
Kies voor ElevenLabs wanneer spraakconfiguratie en agent-tools de platformvereisten rechtvaardigen. Controleer de mediatoegang voordat u karakter-afbeeldingen of videofuncties daaromheen ontwerpt.
6. xAI voor apps gebouwd rond Grok-modellen
xAI is relevant wanneer u specifiek Grok als gespreksmodel wilt gebruiken en gerelateerde media- en spraakmogelijkheden wilt evalueren.
De Imagine-documentatie behandelt het genereren en bewerken van afbeeldingen naast het genereren van video. Dit geeft ontwikkelaars een manier om een karaktergesprek en gegenereerde visuele inhoud binnen het ecosysteem van dezelfde leverancier te testen.
Spraak moet worden geëvalueerd via de eigen Voice API-documentatie. Houd spraakinteractie, tekstchat en gegenereerde clips als afzonderlijke integratie- en budgetposten, zelfs als ze hetzelfde account delen.
U bent nog steeds bezig met het bouwen van het companion-product. Een model-API levert niet automatisch de karakter-assets, de persistente relatiestatus of de interface die in een consumenten-companion-app worden gevonden. Controleer de werkelijke invoer, uitvoer en besturingselementen van de API aan de hand van de functies in uw specificatie.
Kies voor xAI wanneer Grok zelf onderdeel is van de productbeslissing. Als uw prioriteit ligt bij het vergelijken van vele modelfamilies, neem dan ook een multi-model service op in de evaluatie.
Wat kost een AI-companion-app nu eigenlijk?
Een token-offerte wordt pas nuttig wanneer je deze koppelt aan een gedefinieerde werklast. Lange gesprekken kunnen bij elk verzoek karakterinstructies, opgehaald geheugen en recente geschiedenis opnieuw verzenden. Meet de input die jouw applicatie verstuurt.
Hier is een hypothetische werklast met alleen tekst: 1.000 sessies, 50 antwoorden per sessie, gemiddeld 2.000 input-tokens per verzoek en 200 gefactureerde output-tokens per antwoord. Dat levert 100 miljoen input-tokens en 10 miljoen output-tokens op.
| Hetzelfde model en dezelfde werklast |
GPT Proto GPT-6 Luna |
OpenAI GPT-6 Luna |
| Inputprijs per miljoen tokens |
$0.08 |
$0.10 |
| Outputprijs per miljoen tokens |
$0.40 |
$0.50 |
| Kosten voor 100 miljoen input-tokens |
$8 |
$10 |
| Kosten voor 10 miljoen output-tokens |
$4 |
$5 |
| Totale schatting tekst-inferentie |
$12 |
$15 |
De tarieven zijn afkomstig van de modelpagina van GPT Proto en de documentatie van het OpenAI GPT-6 Luna-model. Deze berekening maakt gebruik van niet-gecachte standaardteksttarieven en gaat uit van geen enkele redeneer-output buiten de vermelde token-toelage. Het is exclusief kosten voor cache-schrijven, nieuwe pogingen, media, geheugenverwerking, opslag en belastingen. Het is een illustratie van inkoopkosten, geen gemeten vergelijking van de kwaliteit van de companion.
Voeg voor een multimodaal product het volgende gebruik toe aan de prognose:
| Functie |
Wat te meten |
| Persistent geheugen |
Extractie- of samenvattingsaanroepen, embeddings waar gebruikt, ophalen en opslag |
| Karakterafbeeldingen |
Aangevraagde afbeeldingen, resolutie, referentie-inputs en herhaalde generaties |
| Korte video's |
Gegenereerde duur, resolutie, input-assets, audio-instellingen en gefactureerde nieuwe pogingen |
| Gesproken conversatie |
Herkenning, LLM-gebruik, spraak-output en eventuele platform- of verbindingskosten |
Latentie hoort ook bij productevaluatie. In een ontwikkelaccount voor desktop-companions combineerde de auteur cloud-inferentie met lokale spraak en databasegeheugen, en rapporteerde vervolgens vertragingen door tool-aanroepen. Het is een individuele ervaring, maar het illustreert waarom een snel tekstmodel alleen niet de wachttijd kan bepalen die gebruikers ervaren.
Verbind een chatmodel en plan je mediaworkflow
Begin met een kort gesprek met je personage. Maak een GPT Proto API-sleutel aan, voeg tegoed toe en stel de GPTPROTO_API_KEY omgevingsvariabele in op je server. De GPT-6 Luna modelpagina biedt het huidige voorbeeld voor API-gebruik.
curl --fail-with-body --silent --show-error \
  https://gptproto.com/v1/chat/completions \
  -H "Authorization: Bearer $GPTPROTO_API_KEY" \
  -H "Content-Type: application/json" \
  --data '{
    "model": "gpt-6-luna",
    "messages": [
      {
        "role": "system",
        "content": "You are Mira, a fictional travel companion. Be warm and concise."
      },
      {
        "role": "user",
        "content": "I have one free afternoon in Kyoto and prefer quiet places."
      }
    ]
  }'
Lees het antwoord van choices[0].message.content. Dit verzoek levert een karakterinstructie en één bericht. Voor een voortdurende dialoog moet je backend de relevante conversatie en herinneringen voor elke aanroep samenstellen. Houd de permanente API-sleutel uit browsercode en mobiele bundels.
Selecteer vervolgens een beeld- of videomodel vanaf de bijbehorende pagina. Gebruik de API-gebruiksinstructies van de modelpagina wanneer je je codeerassistent vraagt om de integratie te bouwen. Behoud het gedocumenteerde eindpunt, de authenticatie, de parameters en de stroom voor resultaatverwerking.
Een asynchrone mediataak heeft een opgeslagen taak-ID en een voltooiingshandler nodig. Je interface kan een afbeelding of video in afwachting tonen terwijl de chat doorgaat. Het verbinden van elke taak met het chat-completions-eindpunt zal die afzonderlijke mogelijkheden niet reproduceren.
Welke API-provider moet je kiezen
| Je eerste productmijlpaal |
Shortlist |
Wat te valideren voordat je je vastlegt |
| Tekst-companion MVP |
GPT Proto of een directe model-API |
Karaktergedrag, kosten per gesprek, geheugenbeheer |
| Chat plus karakterafbeeldingen en clips |
GPT Proto, Google, Inworld, ElevenLabs of xAI |
Exacte beschikbaarheid van modellen, mediatoegang, referenties en stroom voor taakvoltooiing |
| Realtime gesproken companion |
OpenAI, Inworld, ElevenLabs of Gemini Live |
Onderbrekingen, eerste hoorbare reactie, stemconsistentie en totale sessiekosten |
| Product specifiek gebouwd rond Grok |
xAI |
Vereiste API-functies en het applicatiewerk buiten modeltoegang |
Voor een team dat nog steeds zijn dialoogmodel en visuele functies verkent, zou ik beginnen met GPT Proto en een kleine herhaalbare evaluatie. Gebruik dezelfde karakterinstructies en gespreksgeschiedenis, en vergelijk vervolgens ondersteunde modellen voordat je de rest van het product eromheen bouwt.
Modelselectie verdient een aparte ronde. Onze beste AI-modellen voor rollenspel gids richt zich op de onderliggende dialoogmodellen. Gebruik deze om de kandidaten te beperken en test vervolgens je eigen karakters en sessiepatronen.
Begin met GPT Proto's AI API voor rollenspel om een karaktergesprek te vergelijken, en voeg visuele generatie toe zodra de chatervaring aan je eisen voldoet.