OpenRouterの代替サービス一覧
| プラットフォーム |
製品タイプ |
公開されている料金モデル |
対応モダリティ |
セルフホスト |
最適な用途 |
主なトレードオフ |
| OpenRouter |
マネージドモデルゲートウェイ |
プロバイダー料金+クレジット購入手数料5.5% |
テキスト、画像、動画、音声、PDF |
いいえ |
幅広いプロバイダーの選択肢と詳細なルーティング制御 |
クレジット購入手数料、セルフホスト不可 |
| GPT Proto |
マネージド型オールインワンAI API |
従量課金、一部モデルは割引 |
テキスト、画像、動画、音声 |
いいえ |
1つのキーと残高で利用できる低価格なマルチモーダルアクセス |
公開されているモデルとプロバイダーのカタログはOpenRouterより小さい |
| Requesty |
マネージドAIゲートウェイ |
無料モデル、またはプロバイダー料金+5%の上乗せ |
モデルにより異なる |
いいえ |
マネージド型ルーティング、予算、EUデータレジデンシー |
有料モデルの利用に5%の上乗せ |
| Portkey |
ゲートウェイおよび可観測性プラットフォーム |
無料の開発者プラン、本番環境向けは月額49ドルから |
プロバイダーに依存 |
利用可能 |
ログ、トレース、ガードレール、チームガバナンス |
モデルアクセスの割引ではなく管理レイヤーを追加 |
| LiteLLM |
オープンソースSDKおよびプロキシ |
オープンソースソフトウェア、インフラとプロバイダー利用料は別途 |
プロバイダーに依存 |
はい |
インフラを管理したいチーム |
ゲートウェイを運用し、プロバイダーアカウントを管理する必要がある |
| Vercel AI Gateway |
マネージドAIゲートウェイ |
トークンへの上乗せなしでプロバイダーの定価を適用 |
テキスト、画像、動画、音声 |
いいえ |
VercelおよびAI SDKのプロジェクト |
中核エコシステム外では差別化が弱い |
| Bifrost |
オープンソースAIゲートウェイ |
オープンソースソフトウェア、インフラとプロバイダー利用料は別途 |
テキスト、画像、音声、ストリーミング |
はい |
セルフホスト型のルーティングとゲートウェイ制御 |
デプロイと継続的な運用が必要 |
| Eden AI |
マネージド型マルチサービスAI API |
プロバイダー料金+決済時のプラットフォーム手数料5.5% |
生成AI、OCR、音声、翻訳、ビジョン |
カスタムプランでのプライベートデプロイ |
より幅広いエンタープライズAIサービス |
プラットフォーム手数料と、より広く複雑な製品範囲 |
この表は、多くの代替サービス一覧が抱える問題を明らかにしています。これらの製品は相互に置き換え可能ではありません。GPT ProtoとOpenRouterはモデルへのマネージドアクセスを提供します。Portkeyは本番トラフィックに対する制御と可観測性を追加します。LiteLLMとBifrostは自分で運用するソフトウェアです。Eden AIは生成モデルの範囲を超え、OCRや翻訳などのサービスにも対応します。これらをカテゴリーを明示せずに比較すると、整然とした表は作れても、適切な判断にはつながりません.
なぜOpenRouterの代替サービスを探すのか?
OpenRouterには現在、70以上のプロバイダーによる400以上のモデルが掲載されています。また、開発者はプロバイダーの順序を設定し、許可するプロバイダーを制限し、パラメーターのサポートを必須にし、フォールバックを無効にできます。マルチモーダルに関するドキュメントでは、画像生成、非同期動画エンドポイント、音声生成、文字起こし、PDF、画像理解、動画理解を扱っています.
これらは事実です。したがって、誠実な代替サービス記事では、OpenRouterがマルチモーダル対応やプロバイダー制御を欠いているかのように装うべきではありません.
それでも、別のサービスを検討する正当な理由はあります.
1つ目は請求です。OpenRouterは上乗せなしで基盤となる推論料金をそのまま適用しますが、クレジット購入時に5.5%の手数料(最低0.80ドル)を請求します。別のプラットフォームでは、リクエストごとの上乗せ、月額ソフトウェア料金、モデル料金の割引、またはゲートウェイ手数料なしの料金体系を採用している場合があります。したがって、最も安い選択肢は、選択したモデルとプラットフォームの課金方式の両方によって決まります.
2つ目はデプロイです。マネージドゲートウェイはインフラ作業をなくしますが、チームによっては第三者サービスを経由してトラフィックを送信できません。LiteLLMとBifrostは、チームが独自のゲートウェイを運用できるようにすることで、この要件に対応します。コストはなくなるのではなく移動します。ソフトウェアはオープンソースでも、サーバー、アップグレード、監視、インシデント対応は依然としてチームの責任です.
3つ目は製品の重点です。あるチームにはプロバイダーレベルのルーティングが必要です。別のチームには監査ログとガードレールが必要です。小規模なスタジオでは、テキスト、画像、動画、音声の生成で1つの残高を共有できることを重視するかもしれません。コードを書かないクリエイターは、APIで自動化する前にブラウザーでアイデアを試したいかもしれません.
そこが本当の分岐点です。「AIモデルを持つプラットフォームはどれか?」ではありません。どのサービスも持っています。問題は、モデルの周囲に何があるかです.
これらの代替サービスの選定方法
プラットフォームを、実用面で重要な次の6つの観点から評価しました:
料金の仕組み:モデル割引、クレジット購入手数料、利用料への上乗せ、サブスクリプション、またはセルフホストのコスト.
テキストだけに対応するのか、画像、動画、音声タスクにも対応するのか.
1つのアカウント、APIキー、残高で、複数のプロバイダーまたはモダリティを利用できるか.
ルーティング、フォールバック、予算、ログ、ガバナンスをどの程度制御できるか.
プラットフォームがマネージド型かセルフホスト型か.
障害発生時に誰が運用上の負担を担うのか.
ベンダーが公開しているレイテンシーの主張によって、これらのプラットフォームを順位付けすることはしませんでした。こうした数値は、同じワークロード、リージョン、モデル、同時実行数、障害条件で測定されていることがほとんどありません。あるゲートウェイの追加遅延が数マイクロ秒だという主張も、数秒かかることがあるモデルリクエストのエンドツーエンドの所要時間については、ほとんど何も教えてくれません.
したがって、掲載順は合成ベンチマークのスコアではなく、編集上の判断によるものです。各製品は明確なユースケースごとに順位付けし、各推奨にはコストも含めています.
1. GPT Proto — 手頃な価格のオールインワンAI APIに最適
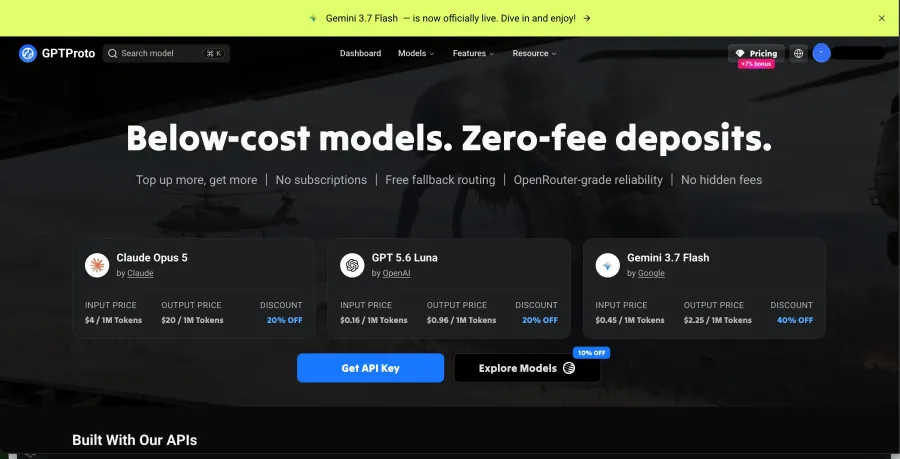
GPT Protoは、テキスト、画像、動画、音声モデルで1つのプリペイド残高と1つのAPIキーを使いたいユーザーにとって、この一覧で最適なOpenRouter代替サービスです。現在のAIモデルギャラリーには、LLM、画像生成モデル、動画生成モデル、マルチモーダルモデル、音声モデルなど、200以上のモデルが掲載されています.
主な違いは、アーキテクチャではなく経済性です。GPT Protoは、すべての掲載モデルに同じルールを適用するのではなく、選択されたモデルについて割引料金を公開しています。2026年8月17日時点の例では、GLM-5.2 APIは、入力100万トークンあたり1.26ドル、出力100万トークンあたり3.96ドルで掲載されており、参照元であるZ.aiの1.40ドルと4.40ドルから10%割引されています。その他のカタログ掲載モデルには異なる割引が適用されます。この表現が重要です。一部のモデルは安くなっていますが、「すべてのモデルが常に最安」というのは裏付けのない約束です.
GPT Protoでは、個別のAPIキーに金額上限、上限期間、モデルの許可リストを設定することもできます。フリーランサーは、1つのクライアントの利用を分離できます。小規模チームは、実験用アプリがアカウント残高をすべて消費するのを防げます。失敗したリクエストでは、請求された残高が直ちに返還されるため予算を保護できますが、返金とプロバイダーの自動フォールバックを混同してはいけません.
主力製品はAPIです。クリエイター向けのレイヤーは二次的ですが、便利な機能です。ブラウザーベースの画像ワークスペースで画像を生成したり、動画ワークスペースで動画のアイデアを試したり、Canvasで編集を続けたりしてから、そのプロセスをAPIワークフローに移行できます。問題が統合ではなく白紙の状態である場合、プロンプトと機能のギャラリーが出発点を提供します.
この橋渡しは、開発者ではないユーザー、マーケター、小規模スタジオに特に関係します。自動化のために誰かに費用を支払う前に、モデルの出力を検証できます。開発者は統合APIを利用でき、クリエイターは同じモデルエコシステムへの視覚的な入り口を得られます.
トレードオフは、カタログとルーティングの深さです。GPT Protoが公開しているモデルコレクションはOpenRouterより小さく、同程度のプロバイダー順序指定やフォールバック制御を公開ドキュメントで説明していません。共有マルチモーダルアクセス、割引掲載、シンプルなプロジェクト予算が、プロバイダーレベルの最大限の設定より重要ならGPT Protoを選びます。OpenRouter以上のルーティング制御だけを求めて選ぶことはありません.
最適な用途:個別のプロバイダーアカウントやサブスクリプションなしで、手頃な価格のマルチモーダルモデルアクセスを求める開発者、小規模チーム、スタジオ、ノーコード開発者.
2. Requesty — マネージド型ルーティングと予算ポリシーに最適
Requestyは、この一覧の多くの製品よりもOpenRouterのゲートウェイとしての役割に近いサービスです。従量課金プランでは、20以上のプロバイダーにまたがる600以上のモデルに加え、BYOK対応、ルーティングポリシー、自動フォールバック、ロードバランシング、プロンプトキャッシュ、支出上限、可観測性を提供しています.
料金は簡単に計算できます。Requestyは基本モデル料金に5%の上乗せを加えます。プロバイダーが一定量の利用に10ドルを請求する場合、Requestyの例では10.50ドルです。このプランにはサブスクリプション、シート料金、最低利用額はありません。無料枠では、クレジットカード不要で無料モデルを1日最大200リクエスト利用できます.
この仕組みは、LiteLLMやBifrostを運用せずに、マネージド型ルーティングと予算ルールを利用したいチームに適しています。公開されているすべてのプランでEUデータレジデンシーも含まれており、エンタープライズ顧客はSSO、RBAC、監査ログ、承認済みモデルポリシー、カスタムSLAを追加できます.
コストは上乗せ料金です。5%はプロトタイプでは小さく見えても、規模が大きくなると目立ちます。Requestyはエンジニアリング時間を節約できるかもしれませんが、それは推論を最も安く購入できる方法だという主張とは異なります.
最適な用途:明確なルーティングポリシー、予算上限、欧州データレジデンシーを備えたマネージドゲートウェイを求めるチーム.
3. Portkey — 本番環境の可観測性に最適
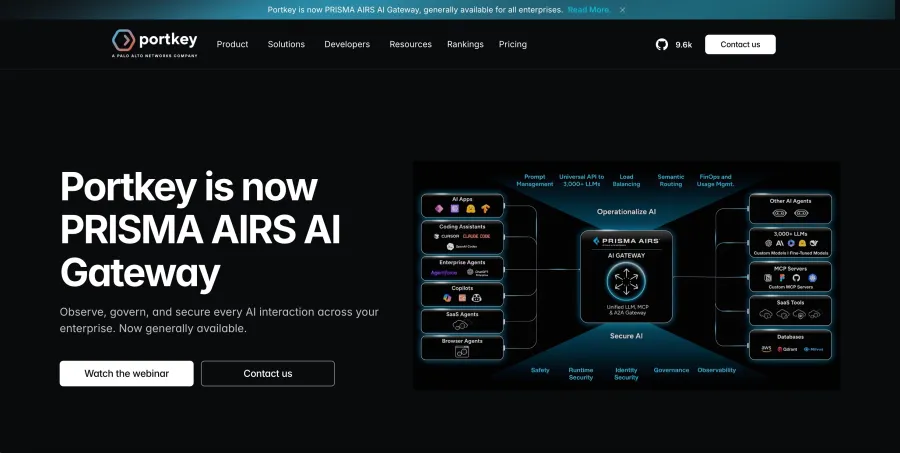
Portkeyは、より安価なモデルを探すことよりも、アプリケーションが実際のトラフィックを送信し始めた後に何が起きているかを理解することに重点を置いています。ゲートウェイにはフォールバック、ロードバランシング、再試行、キャッシュ、ユニバーサルAPIが含まれます。可観測性レイヤーは、ログ、トレース、フィードバック、メタデータ、フィルター、アラートを追加します。ガードレールとプロンプトのバージョン管理も同じコントロールプレーンにあります.
無料のDeveloperプランには、月10,000件の記録済みログが含まれ、ログ保持期間は3日、メトリクス保持期間は30日です。公開されているProductionプランは月額49ドルで、100,000件の記録済みログが含まれ、上限まで追加100,000件ごとに9ドルが課金されます。Productionのログ保持期間は30日に延長され、メトリクスは90日間利用できます.
この料金体系は、デバッグ時間と監査可能性に金銭的価値がある場合に意味を持ちます。サポートボットが静かにモデルを切り替えた場合、プロンプト変更によって障害が発生した場合、または1人の顧客が予想外のコスト急増を引き起こした場合、トレースとメタデータは理由の解明に役立ちます。安価な推論料金だけでは、その証拠を代替できません.
トレードオフは範囲です。Portkeyは運用レイヤーを追加するものであり、割引された共有残高型のモデルマーケットプレイスが主目的ではありません。2つのモデルを呼び出したいだけの小規模ユーザーは、まだ必要としていない制御機能に料金を支払うことになるかもしれません.
最適な用途:ログ、トレース、プロンプト管理、ガードレール、ロールベースの制御を必要とする本番AIチーム.
4. LiteLLM — オープンソースの代替サービスに最適
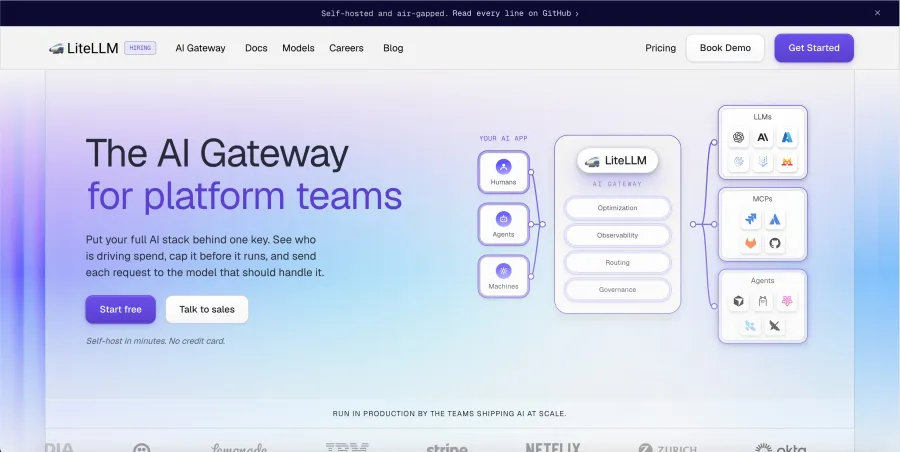
LiteLLMは、100以上のLLMプロバイダーに統一インターフェースを提供するオープンソースAIゲートウェイ兼Python SDKです。チームはSDKをアプリケーションに直接インポートすることも、プロキシを中央ゲートウェイとしてデプロイすることもできます。OpenAI形式のリクエストに加え、コスト追跡、仮想キー、ロードバランシング、ログ、ガードレールをサポートしています.
魅力は制御性です。プロバイダーキーをチームが管理するインフラ内に保持できます。内部サービスは、OpenAI、Anthropic、Bedrock、Vertex AIなど複数プロバイダー向けの個別統合を持つ代わりに、1つのゲートウェイを呼び出せます。ポリシーと予算も一元管理できます.
しかし、「オープンソース」は「無料のAI」と同義ではありません。モデルプロバイダーは推論料金を請求します。プロキシを実行する場所も必要です。シークレットの設定、バージョンの更新、ログの監視、セキュリティ問題へのパッチ適用、プロバイダーによるエンドポイント変更への対応を誰かが担わなければなりません。プラットフォームチームにとっては合理的なトレードオフでも、個人クリエイターにとっては割に合わない可能性があります.
LiteLLMはGPT Protoとも根本的に異なります。GPT Protoはユーザーにマネージド残高とモデルアクセスを提供します。LiteLLMは、ユーザーがすでに管理しているプロバイダーアカウントを接続するためのソフトウェアを提供します。両者は隣接する問題を解決しますが、同じ問題を解決するものではありません.
最適な用途:セルフマネージドゲートウェイを求め、すでに運用に必要なリソースを持つエンジニアリングチーム.
5. Vercel AI Gateway — VercelおよびAI SDKユーザーに最適
Vercel AI Gatewayは、1つのAPIキーの背後にルーティング、課金、可観測性を統合します。公開カタログはテキスト、画像、動画、音声モデルをカバーし、既存のOpenAI互換統合は通常、ベースURLと認証情報を変更するだけで移行できます。プロバイダー障害時の自動フォールバックも含まれます.
料金はこのサービスの強みです。Vercelは、顧客が自分のプロバイダーキーを持ち込む場合も含め、トークンへの上乗せはゼロだと説明しています。すべてのVercelチームは無料枠で月5ドル分のAI Gatewayクレジットを受け取れます。有料クレジットを購入すると従量課金に移行し、毎月繰り返される5ドル分の割り当ては受け取れなくなります。決済処理手数料が適用される場合はあります.
すでにAI SDKを使用しているNext.jsアプリケーションでは、統合の手間が減ります。モデル呼び出し、支出追跡、デプロイをアプリケーションスタックの他の部分の近くに配置できます。この利点は、そのエコシステム内では明確です.
一方、そのエコシステム外では判断は自動的ではありません。ゲートウェイはOpenAI互換クライアントでも動作しますが、別の場所にデプロイするチームにとって、Vercelとの周辺統合のメリットは小さくなります。上乗せゼロは魅力的ですが、それだけで既存の非Vercelスタックを移行する理由にはなりません.
最適な用途:Vercel、Next.js、またはAI SDKで構築し、トークンへの上乗せなしで統合課金とフォールバックを利用したいチーム.
6. Bifrost — より高い制御性を求めるセルフホスト型ゲートウェイに最適
Bifrostは、1つのOpenAI互換インターフェースを通じて23以上のプロバイダーに接続するApache 2.0ライセンスのオープンソースゲートウェイです。文書化されている機能には、自動フォールバック、プロバイダーとキー間のロードバランシング、セマンティックキャッシュ、MCP対応、テキスト、画像、音声、ストリーミングのマルチモーダル処理が含まれます.
LiteLLMと同様に、Bifrostはチームが独自のゲートウェイを運用したい場合に最も関係する選択肢です。企業環境内に配置し、既存のプロバイダーアカウントを使用し、別のマーケットプレイスから推論クレジットを購入せずにモデルアクセスを一元化できます.
Bifrostは積極的なパフォーマンス主張を公開しています。これらは、対象アプリケーションと同じトラフィックパターン、ハードウェア、設定、ログ設定で再現されるまでは、ベンダーベンチマークとして扱うべきです。ゲートウェイのオーバーヘッドはリクエスト時間の一部にすぎず、通常は上流のモデルが体感時間の大部分を占めます.
実際のトレードオフは運用責任です。インストールは短時間で済むかもしれませんが、最初のコマンドが成功した後に本番環境の保守が終わるわけではありません。キャパシティ計画、可用性、シークレット、可観測性、アップグレードはチームが担います.
最適な用途:ルーティング、キャッシュ、マルチモーダル対応を備えたオープンソースのセルフホスト型ゲートウェイを求めるチーム.
7. Eden AI — より幅広いエンタープライズAIサービスに最適
Eden AIは生成モデルのルーターを超える幅広いサービスです。カタログには、言語モデル、OCR、音声、翻訳、コンピュータービジョンなど、500以上のモデルとサービスが含まれます。ユーザーは複数のAPIキーを作成し、プロバイダーを比較し、1つのプラットフォームからコストとパフォーマンスを監視できます.
セルフサービスAI API Gatewayでは、クレジット購入時に5.5%のプラットフォーム手数料が適用されます。Eden AIは、カタログ内のモデル価格は推論への追加上乗せではなく、プロバイダー料金を反映していると説明しています。上位プランでは、カスタム料金、高いレート制限、プライベートデプロイ、コンプライアンス対応、専任サポート、SLAが追加されます.
この幅広さは、アプリケーションで請求書からテキストを抽出し、翻訳し、内容を分類して、その一部をLLMに送る必要がある場合に役立ちます。狭いモデルルーターでは最後の手順には対応できても、シーケンス全体には対応できない可能性があります.
幅広さは複雑さも加えます。仕事が単に「1つのキーで3つのチャットモデルを呼び出す」だけなら、エンタープライズ向けのマルチサービスプラットフォームはプロジェクトにとって過剰かもしれません。コスト比較には5.5%の手数料も含める必要があります.
最適な用途:生成AIとOCR、音声、翻訳、ビジョン、エンタープライズデプロイ要件を組み合わせる組織.
OpenRouterの方が優れている場面
元の製品が優れている場面を語らない代替サービス一覧は、広告になってしまいます。OpenRouterには依然として明確な利点があります.
1つ目は、公開カタログがGPT Protoの現在のカタログより大きいことです。OpenRouterは400以上のモデルと70以上のプロバイダー、GPT Protoは200以上のモデルです。数は変動しますが、同じモデルについて複数のプロバイダーを日常的に比較する開発者にとって、この差は十分に重要です.
2つ目は、OpenRouterがプロバイダーのルーティングを詳細に文書化していることです。リクエストには順序付きプロバイダーリストを含めたり、許可するプロバイダーを制限したり、すべてのパラメーターのサポートを必須にしたり、特定のエンドポイントを指定したり、フォールバックを無効にしたりできます。GPT Protoユーザーはモデルを選択してキー単位の予算を適用できますが、公開されているプロバイダー制御の範囲はそれほど広くありません.
3つ目は、OpenRouterにはアクティビティ、エクスポート、予算、データポリシー、ゼロデータ保持ルーティングに関する成熟した公開制御機能があることです。デフォルトではプロンプトと完了結果をログに記録しませんが、選択した上流プロバイダーのポリシーは依然として重要です.
私の判断は明快です。プロバイダーの幅広さと細かなルーティングが優先事項なら、OpenRouterを使い続けてください。より小さいながらも十分に幅広いカタログ、割引モデル、共有マルチモーダル課金、クリエイター向けツールが実際のワークフローに合うなら、GPT Protoを検討してください.
GPT ProtoはOpenRouterからの万能なアップグレードではありません。適した用途が異なるのです.
どのOpenRouter代替サービスを選ぶべきか?
| 必要なもの |
選択肢 |
| 1つの残高を共有する、手頃な価格のテキスト、画像、動画、音声モデル |
GPT Proto |
| マネージド型ルーティングポリシー、予算上限、より大きなカタログ |
Requesty |
| 本番ログ、トレース、プロンプト管理、ガードレール |
Portkey |
| 制御可能なPythonベースのオープンソースゲートウェイ |
LiteLLM |
| トークンへの上乗せなしのネイティブなVercelおよびAI SDK統合 |
Vercel AI Gateway |
| セルフホスト型のルーティングとキャッシュに重点を置くオープンソースゲートウェイ |
Bifrost |
| OCR、翻訳、音声、ビジョン、エンタープライズAIサービス |
Eden AI |
| 最大限の公開プロバイダー選択肢とプロバイダー順序制御 |
OpenRouter |
個人開発者や小規模スタジオの場合、最も長い機能一覧ではなく、料金モデルから検討を始めます。1つの残高でチャットボット、商品画像、音声出力、短い動画をまかなう必要があるなら、GPT Protoによって複数のアカウントをまとめられます。アプリケーションがすでに本番稼働しており、問題がモデルアクセスではなくデバッグなら、より適切な答えはPortkeyです。組織のポリシーでセルフホストが必要なら、マネージドサービスはもはや本当の候補ではありません。LiteLLMとBifrostを比較してください.
OpenRouterからGPT Protoへ切り替える方法
最も安全な移行方法は、一度に1つのモデルと1つの重要度の低いワークフローを扱うことです。金曜日の午後にすべてのモデルIDを変更して、それをロールアウト計画と呼んではいけません.
1. 同等のモデルを見つける
現在OpenRouter経由で使用しているモデルを、GPT Protoモデルギャラリーで検索します。対応する入力・出力モダリティについて、最新のモデルページを確認してください。上流モデルの能力と、AIプラットフォームが公開するルートは必ずしも同一ではありません.
たとえば、GPT ProtoのGLM-5.2ページには現在、テキスト、画像、ドキュメント入力とテキスト出力が記載されています。APIモデル文字列はglm-5.2です.
2. 別のAPIキーを作成する
一般的なアカウントキーを再利用せず、移行用のキーを作成します。金額上限、上限期間を設定し、プロジェクトに必要なモデルが少数の場合は許可するモデルを制限します。これにより、設定ミスによるコストを抑えられます.
3. エンドポイント、キー、モデルIDを変更する
GPT Protoの現在のGLM-5.2ドキュメントでは、次のリクエストを使用しています:
curl --request POST "https://gptproto.com/v1/chat/completions" \
  --header "Authorization: Bearer $GPTPROTO_API_KEY" \
  --header "Content-Type: application/json" \
  --data '{
    "model": "glm-5.2",
    "messages": [
      {
        "role": "user",
        "content": "このデプロイ計画における3つの主なリスクを要約してください。"
      }
    ]
  }'
これはドキュメントに基づく統合例であり、すべてのOpenRouterリクエスト本文を変更せずにコピーできるという主張ではありません。ツール呼び出し、構造化出力、プロバイダー固有のパラメーター、マルチモーダルコンテンツについては、選択したGPT Protoモデルのページで確認してください.
4. メディア生成を非同期ワークフローとして扱う
テキストチャットでは、元のリクエスト内で応答が返されることがよくあります。一方、画像や動画の生成では、タスクの作成、ステータスのポーリング、最終アセットURLの取得を行う場合があります。GPT Protoは非同期の画像・動画タスク、ポーリング、Webhookに対応していますが、正確なエンドポイントとペイロードはモデルによって異なります.
両方の製品が1つのキーを使用するからといって、テキストチャットの例で動画ワークフローを無理に処理しないでください.
5. トラフィックを増やす前に請求額を確認する
小規模な管理済みバッチを実行し、次を記録します:
モデルID
タスクタイプ
入力と出力のサイズ
返されたステータス
失敗したリクエスト数
バッチ前後の残高
失敗したリクエストに対する返金の挙動
出力形式がアプリケーションのパーサーと一致するか
この記事では、その値をベンチマークとして提示していません。このワークロードを実行していないためです。このチェックリストは、読者が自身のアプリケーションに依存する部分を検証できるようにするためのものです.
最終判断
手頃な価格で、テキスト、画像、動画、音声モデルにオールインワンでアクセスすることが優先なら、GPT Protoを選んでください.1つのキー、1つの残高、選択されたモデルの割引、キー単位の上限、クリエイター向けワークスペースにより、実験とAPI利用の間をつなぐ実用的なサービスです.
上乗せを避けることよりもマネージド型ルーティングと予算ポリシーが重要ならRequestyを選びます。アプリケーションにすでにトラフィックがあり、障害、コスト、プロンプトについてより良い証拠が必要ならPortkeyを選びます。ゲートウェイを管理下のインフラ内で実行する必要があるならLiteLLMまたはBifrostを選びます。Vercel中心のアプリケーションにはVercel AI Gatewayを、ワークフローがOCR、音声、翻訳、コンピュータービジョンまで広がる場合にはEden AIを選びます.
プロバイダーの幅広さとルーティング制御が課題に合っているなら、OpenRouterを使い続けてください。プラットフォームの切り替えが目的ではありません。取り除くべき制約を取り除くことが目的です.
1つのGPT Proto APIキーで200以上のAIモデルを試す.