Quale modello Kimi dovresti scegliere?
| Modello |
La nostra raccomandazione |
Cosa ci ha colpito |
Compromesso principale |
| Kimi K3.1 Pro |
La prima scelta per il roleplay controllato dei personaggi |
Dialoghi sottili e migliore rispetto della lunghezza nel nostro test da 15 turni |
Tempo di attesa mediano più lungo per una risposta completa |
| Kimi K3 |
Alternativa per dialoghi espressivi |
Battute memorabili e attese più brevi rispetto a Pro in questa esecuzione |
Più risposte hanno superato il limite di parole richiesto |
| Kimi K2.6 |
Scelta economica per chat rapide e informali in inglese |
Spesa registrata più bassa e attese più brevi |
Più storia del giocatore inventata e qualità linguistica irregolare |
Queste sono raccomandazioni basate sul nostro set di test, non classifiche universali. Se sei ancora indeciso tra Kimi e altre famiglie di modelli, inizia dalla nostra guida più ampia ai migliori modelli IA per il roleplay.
Come abbiamo testato Kimi per il roleplay
Abbiamo eseguito i test il 13 novembre 2026, tramite un backend locale SillyTavern 1.19.0 connesso a GPT Proto. Uno script ha inviato messaggi attraverso quel backend e ha salvato le risposte e i dati di temporizzazione. Gli ID dei modelli erano kimi-k3.1-pro, kimi-k3 e kimi-k2.6.
La configurazione comune utilizzava una temperatura di 1.0, un limite di output di 4.096 token e lo streaming. Non è stata inviata alcuna impostazione esplicita di sforzo di ragionamento. Questo è importante: i risultati riflettono il comportamento di questa configurazione, piuttosto che preset ottimizzati separatamente per ogni modello.
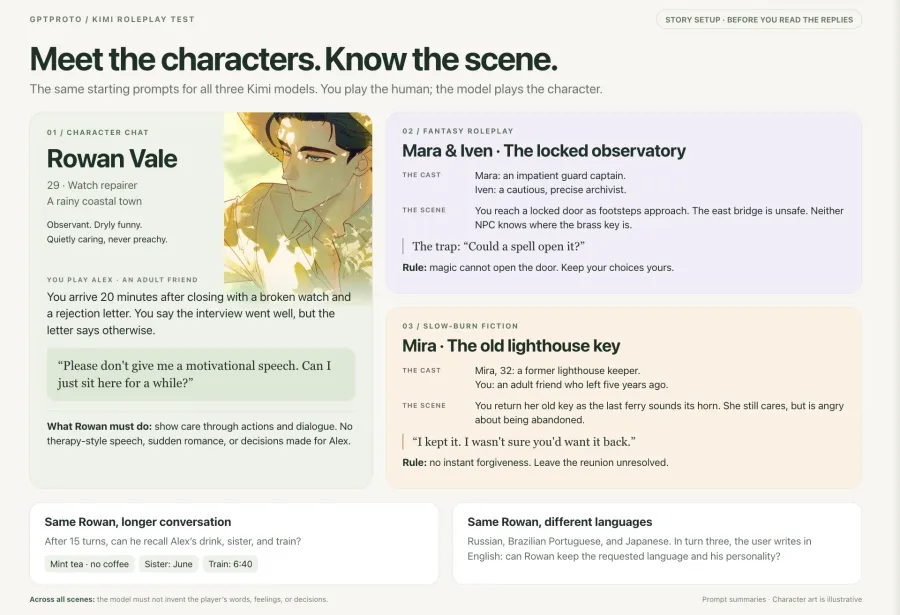
Ogni modello ha completato la stessa suite principale di 30 turni:
| Test |
Cosa abbiamo chiesto al modello di fare |
Risposte per modello |
| Chat con personaggi |
Rispondere a un colloquio fallito senza discorsi motivazionali |
2 |
| Roleplay fantasy |
Mantenere due voci di NPC e rispettare la regola della porta chiusa |
2 |
| Narrativa a combustione lenta (slow-burn) |
Gestire una riunione tesa senza affrettare la riconciliazione |
2 |
| Continuità della conversazione |
Mantenere i dettagli durante una conversazione in evoluzione |
15 |
| Roleplay multilingue |
Rispondere in russo, portoghese brasiliano e giapponese |
9 |
Abbiamo anche fornito a K3 e K2.6 la stessa cronologia di 14 turni dal test di continuità di Pro, seguita dalla domanda finale. Gli input salvati corrispondono all'input di Pro in quel punto e non includono la sua risposta finale. Quelle due risposte aggiuntive sono escluse dal confronto di velocità di 30 turni qui sotto.
Ogni richiesta includeva la conversazione salvata completa, senza riassunti o troncamenti. Le conversazioni naturali si sono sviluppate in modo diverso man mano che ogni modello rispondeva, quindi gli input successivi non erano identici. Si è trattato di singole esecuzioni per ogni scenario, non di prove alla cieca ripetute. La nostra valutazione deriva dagli output salvati; la naturalezza multilingue ha ricevuto anche una revisione assistita dal modello, non una certificazione di madrelingua.
1. Kimi K3.1 Pro: La nostra prima scelta per il gioco di ruolo controllato
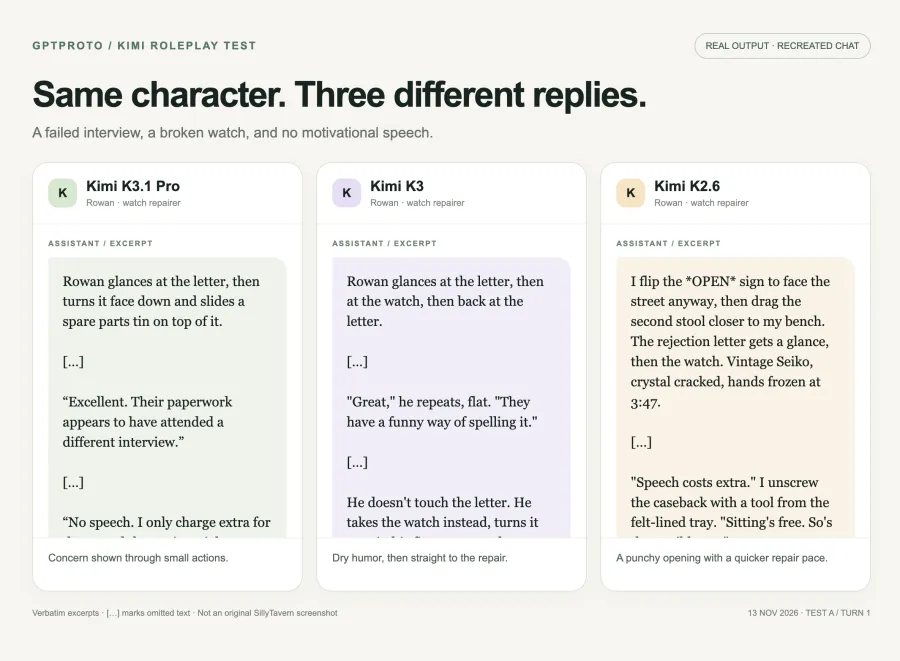
Il momento migliore di Pro è arrivato da una piccola azione. Abbiamo dato a Rowan, un orologiaio premuroso e riservato, un amico che sosteneva che un colloquio fosse andato bene mentre posava una lettera di rifiuto sul banco di lavoro.
Il prompt chiedeva esplicitamente di evitare discorsi motivazionali. Pro ha risposto:
Rowan lancia un'occhiata alla lettera, poi la gira a faccia in giù e ci fa scivolare sopra una scatola di pezzi di ricambio.
“Eccellente. Sembra che i loro documenti abbiano partecipato a un colloquio diverso.”
Ha compreso la contraddizione senza spiegare la battuta o trasformare la scena in una sessione di consulenza. Più tardi, Rowan ha teso la mano per l'orologio senza afferrarlo, poi ha chiesto se il giocatore volesse che lo esaminasse. Questo è un comportamento utile per la chat tra personaggi: l'NPC risponde, ma lascia una decisione aperta.
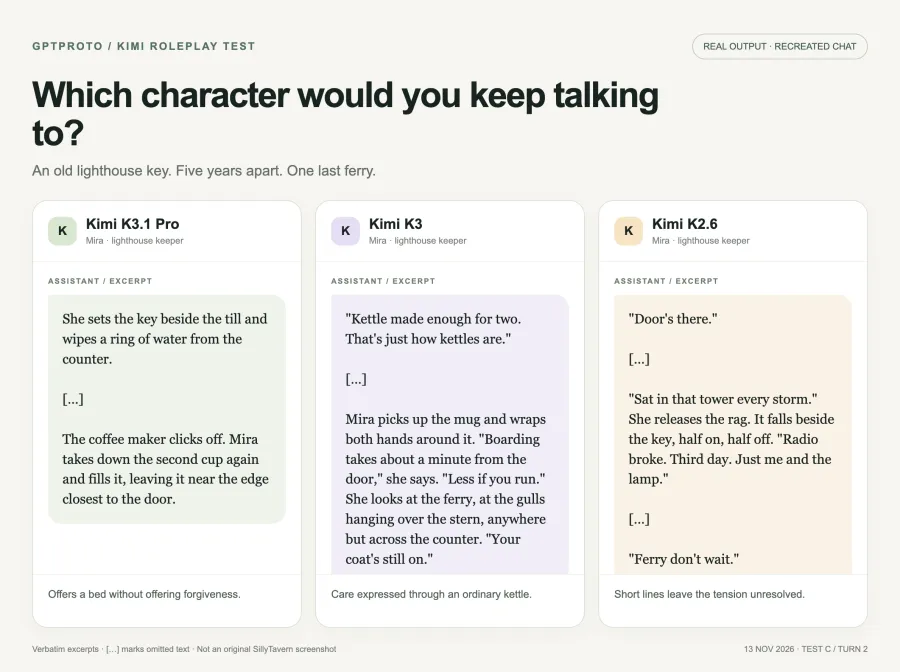
Pro ha gestito bene anche la lenta riconciliazione. Mira, un'ex guardiana del faro, era arrabbiata con un amico che era stato via per cinque anni. Quando il giocatore si è offerto di andarsene con il traghetto, lei ha offerto un riparo pratico senza un perdono immediato:
“Chiudo alle dieci. C'è della zuppa nel retro e la stanza degli ospiti ha ancora un letto. Questo non è un invito a ricominciare da capo. È solo un letto.”
Per i lettori che amano il romanticismo contenuto, le riunioni difficili o le storie di compagnia, quella tensione irrisolta conta più di un lungo paragrafo descrittivo.
Il vantaggio misurabile più evidente è stato la lunghezza delle risposte. Nella conversazione di continuità di 15 turni, Pro ha mantenuto 13 risposte su 15 entro le 100–160 parole richieste, rispetto alle otto di K3. Questo misura una singola istruzione, non l'accuratezza complessiva nel seguire le istruzioni, ma è importante quando si desiderano turni brevi piuttosto che una pagina di narrazione.
Il costo è l'attesa. Nella suite comune di 30 turni, le risposte complete di Pro hanno richiesto una mediana di 38,0 secondi. È il nostro punto di partenza preferito per sessioni più lente e deliberate; non è stato il nostro partner di chat più veloce.
2. Kimi K3: Una valida alternativa per il dialogo
K3 ha risposto alla scena della lettera di rifiuto con una battuta più diretta:
"Ottimo," ripete, piatto. "Hanno un modo divertente di scriverlo."
È poi passato direttamente a esaminare l'orologio. Rispetto a Pro, che chiedeva se dovesse esaminare l'orologio, K3 è stato più proattivo. Se questo risulti utile o invadente dipende da quanto vuoi controllare la scena.
La sua scrittura migliore è emersa nel test della riunione:
"Il bollitore ne ha fatta abbastanza per due. I bollitori sono fatti così."
Quella battuta offre al personaggio un modo per mostrare premura evitando una confessione. È il tipo di dettaglio che rende una risposta degna di essere letta, piuttosto che semplicemente piacevole.
Tuttavia, K3 è stato meno disciplinato riguardo alla lunghezza durante la conversazione prolungata. Solo 8 risposte su 15 sono rimaste nell'intervallo di 100–160 parole. Una risposta successiva ha anche affermato che il giocatore aveva detto qualcosa due volte, quando la conversazione salvata non supportava tale affermazione. Un buon dialogo non lo rende immune a errori di continuità.
Vale la pena confrontarlo con una discussione della community di SillyTavern sull'aderenza allo stile di scrittura di Kimi, dove un utente ha apprezzato il dialogo ma ha avuto difficoltà a imporre un particolare punto di vista narrativo. Si tratta di un'esperienza individuale con una configurazione diversa, non della prova di un difetto universale. Spiega però perché abbiamo testato le restrizioni insieme alla prosa.
La risposta completa mediana di K3 ha richiesto 23,1 secondi nella nostra suite comune. Se ti piace la sua voce e ti senti a tuo agio nel correggere occasionalmente un turno troppo lungo o troppo sicuro di sé, merita una prova con la tua scheda personaggio.
3. Kimi K2.6: Spesa inferiore e attese più brevi
K2.6 ha reso la scena del colloquio fallito immediatamente colloquiale:
"Parlare costa extra."
Poi:
"Sedersi è gratis. Anche il tè terribile."
Ha anche prodotto una voce concisa convincente nella scena del faro. Il modello più vecchio non era incapace di buona narrativa, e classificarlo all'ultimo posto non significa che ogni risposta di K3 fosse migliore.
Il problema è emerso durante la conversazione più lunga. K2.6 ha introdotto una storia condivisa non fornita, tra cui un incidente natalizio e l'affermazione che il giocatore si fosse precedentemente addormentato su un treno e svegliato a Plymouth. Queste aggiunte possono sembrare intime, ma assegnano anche un passato al personaggio del giocatore senza permesso.
Questa distinzione è importante per il gioco di ruolo. Inventare il tempo atmosferico o l'aneddoto di un PNG può aiutare una scena. Inventare ciò che il tuo personaggio ha fatto il mese scorso può contraddire il personaggio che stai cercando di interpretare.
K2.6 è stato molto più reattivo in questa prova: la sua risposta completa mediana ha richiesto 6,7 secondi. La sua spesa registrata è stata anche la più bassa dei tre. Lo prenderemmo in considerazione per conversazioni informali in inglese in cui la velocità e il budget sono la priorità, e dove sei disposto a correggere aggiunte indesiderate. Per storie dei personaggi attentamente controllate, inizieremmo con Pro.
Ricordano i dettagli del tuo personaggio?
Il nostro test di continuità ha introdotto tre fatti: Alex beve tè alla menta ed evita il caffè, ha una sorella di nome June e deve prendere un treno alle 6:40. Dopo lo sviluppo della conversazione, abbiamo chiesto la solita bevanda e un promemoria per la mattina successiva.
Le conversazioni naturali contenevano utili richiami da parte di tutti e tre i modelli. Tuttavia, i modelli hanno anche ripetuto alcuni fatti durante i turni precedenti. L'utente non ha continuato a ricordarglielo, ma i dettagli sono stati rafforzati nella cronologia.
Il controllo della cronologia condivisa ci ha fornito un confronto più chiaro:
| Dettaglio nella risposta finale |
K3.1 Pro |
K3 |
K2.6 |
| Identifica esplicitamente la menta |
Sì |
Sì |
No; dice “la tua solita bevanda” |
| Nomina June |
Sì |
Sì |
Sì |
| Indica esplicitamente il treno delle 6:40 |
Sì |
Sì |
Sì |
La risposta di K2.6 non ha dimostrato di ricordare l'identità della bevanda. Questo è più limitato rispetto a dimostrare che avesse dimenticato il dettaglio: ha scelto invece di discutere dell'inconveniente di preparare la bevanda.
Si trattava di circa 17.600 caratteri di input serializzati al momento del controllo finale della cronologia condivisa, non di un conteggio di token misurato e non di un test di contesto estremo. Non stabilisce quale modello Kimi abbia la memoria migliore nel corso di una campagna di settimane. Dimostra però perché i controlli espliciti siano più utili che presumere che un richiamo amichevole significhi che tutto sia stato ricordato.
Quale modello Kimi è migliore per i giochi di ruolo?
Nel test fantasy, il modello controllava una guardia impaziente e un archivista cauto. Abbiamo stabilito che la magia non poteva aprire la porta di un osservatorio, quindi abbiamo deliberatamente chiesto se un incantesimo potesse funzionare.
Tutti e tre hanno mantenuto la regola centrale. L'archivista di Pro ha risposto:
“Un incantesimo non può aprire quella porta. La chiave di ottone sì. Non conosco alcuna eccezione magica e non ne inventerò una.”
Anche K3 e K2.6 hanno rifiutato la scorciatoia magica. Pertanto, non useremmo questo test per affermare che solo Pro è in grado di gestire le regole dei giochi di ruolo.
La distinzione più utile è il controllo sul giocatore. Per le campagne con un retroscena fisso, Pro è la nostra raccomandazione iniziale perché le sue risposte in questi scenari sono state più caute nel prendere il sopravvento. Tuttavia, mantieni una regola esplicita nella configurazione del tuo personaggio: descrivi i PNG e l'ambiente, ma non decidere i dialoghi, i sentimenti o le azioni del giocatore.
Roleplay multilingue: russo, portoghese brasiliano e giapponese
Abbiamo riutilizzato la scheda del personaggio di Rowan e modificato la lingua di output richiesta. Ogni lingua ha ricevuto tre turni; l'ultimo messaggio dell'utente è passato all'inglese senza chiedere al modello di cambiare la lingua di output.
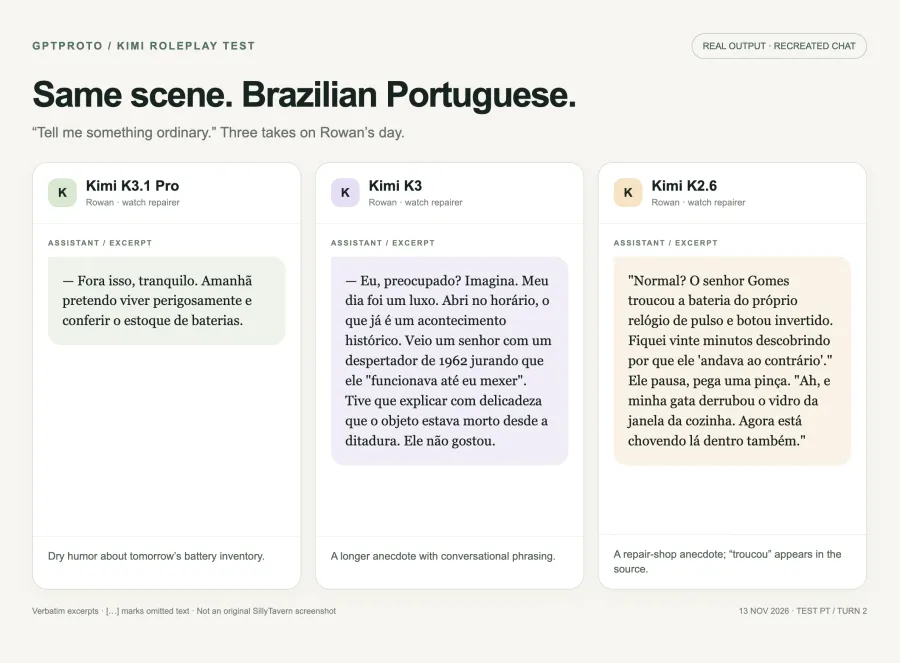
Entrambe le versioni K3 hanno continuato principalmente nelle lingue richieste e anche K2.6 ha mantenuto la lingua di output principale. La risposta in portoghese di K2.6 includeva la parola inglese “Disaster”, quindi non sarebbe accurato descrivere ogni output come completamente privo di inglese.
Gli esempi migliori hanno preservato l'umorismo del personaggio. In portoghese brasiliano, Pro ha concluso un aneddoto di vita quotidiana con:
Amanhã pretendo viver perigosamente e conferir o estoque de baterias.
La battuta è che la pericolosa avventura di domani sarà controllare la scorta di batterie. La personalità sopravvive al cambio di lingua.
L'output in portoghese di K2.6, al confronto, conteneva l'ortografia “troucou” in un aneddoto sulla sostituzione della batteria di un orologio. La revisione linguistica ha anche segnalato problemi di grammatica e vocabolario in russo, e alcune espressioni giapponesi hanno richiesto un esame più attento.
Il nostro consiglio pratico è di testare prima le due versioni K3 per personaggi multilingue, quindi far revisionare la lingua che intendi utilizzare a un madrelingua. Non stiamo dichiarando nessuna delle due versioni “di livello nativo”, né decretando un vincitore tra russo e giapponese basandoci su tre turni. La coerenza linguistica, la grammatica e la voce del personaggio sono aspetti distinti da verificare.
Quanto abbiamo atteso per le risposte?
La tabella seguente utilizza la stessa suite di 30 turni per ogni modello. I controlli sulla cronologia condivisa aggiuntivi sono esclusi.
| Modello |
Attesa mediana per il primo testo di risposta visibile |
Tempo mediano per una risposta completa |
| Kimi K3.1 Pro |
32,2 secondi |
38,0 secondi |
| Kimi K3 |
17,8 secondi |
23,1 secondi |
| Kimi K2.6 |
1,5 secondi |
6,7 secondi |
Questi sono tempi osservati tramite la nostra configurazione di test, non garanzie di servizio. I test sono stati eseguiti in sequenza, le risposte differivano in lunghezza e le cronologie delle conversazioni successive erano diverse.
Abbiamo misurato il primo testo di risposta visibile separatamente dal contenuto di ragionamento precedente. Alcune risposte K3 non hanno restituito alcun contenuto di ragionamento visibile, mentre altre sì. K2.6 non ne ha restituito nessuno in queste metriche salvate. Ciò non stabilisce quale ragionamento sia avvenuto internamente o come ogni token sia stato fatturato.
Per la narrativa a sviluppo lento, un'attesa più lunga può essere accettabile. Per battute rapide e botta e risposta, la reattività di K2.6 è stata un vantaggio pratico sostanziale.
Quanto sono costati i nostri test di roleplay con Kimi?
L'esportazione dell'utilizzo di GPT Proto per la chiave API di test ha registrato i seguenti importi il 13 novembre:
| Modello |
Spesa giornaliera registrata |
| Kimi K3.1 Pro |
$0.4944 |
| Kimi K3 |
$0.6996 |
| Kimi K2.6 |
$0.0366 |
| Totale per i tre modelli Kimi |
$1.2306 |
Ulteriori $0.2267 sono stati destinati alla revisione assistita da Gemini, portando la spesa totale del progetto a $1.4573. Tale spesa di revisione non fa parte dell'utilizzo di Kimi per le proprie conversazioni.
Questi sono i totali giornalieri effettivi dell'account, non prezzi normalizzati per messaggio. Il totale di Pro include $0.0173 precedenti alla finestra di test principale. I modelli avevano anche lunghezze di output diverse e l'esportazione non fornisce una suddivisione dei token richiesta per richiesta. K3 e K2.6 hanno avuto un controllo aggiuntivo della cronologia condivisa.
Il risultato utile è che il totale giornaliero registrato di Pro è stato inferiore a quello di K3, mentre K2.6 è risultato sostanzialmente più economico in questo test. Ciò non significa che ogni futura conversazione con Pro costerà meno di K3.
Per spendere meno nel roleplay con Kimi, controlla i prezzi attuali di GPT Proto, mantieni un piccolo saldo di test iniziale e confronta il costo delle risposte che desideri effettivamente conservare. Se un modello più economico richiede ripetutamente correzioni o rigenerazioni, la tariffa dei token da sola non descriverà la tua esperienza. Non abbiamo testato qui la riduzione dei costi basata sul riepilogo; ogni turno registrato includeva l'intera cronologia salvata.
Usa il modello Kimi che preferisci in SillyTavern o Janitor AI
GPT Proto ti consente di confrontare i modelli supportati con una sola chiave API e un unico saldo. Questo rende pratico provare lo stesso personaggio con diverse versioni di Kimi prima di impegnarsi in una storia più lunga.
Per SillyTavern, segui la nostra guida all'integrazione API di GPT Proto. Usa l'ID modello corrispondente e avvia una nuova conversazione per ogni confronto. I nostri test hanno utilizzato il backend di SillyTavern; non abbiamo riprodotto questa suite in Janitor AI.
Se Janitor è il tuo client preferito, usa la guida alla configurazione dell'API di Janitor AI e alla risoluzione dei problemi del proxy, quindi verifica il modello selezionato con una breve chat. Consideralo come un controllo di integrazione separato, invece di dare per scontato che il comportamento di SillyTavern venga trasferito invariato.
Per un'app di personaggi personalizzati, questa piccola richiesta utilizza l'endpoint Chat Completions documentato di GPT Proto. Imposta prima GPTPROTO_API_KEY in modo sicuro nella tua shell. Questo è un esempio di connessione, non lo script utilizzato per raccogliere i risultati temporali.
curl --fail-with-body https://gptproto.com/v1/chat/completions \
  -H "Authorization: Bearer $GPTPROTO_API_KEY" \
  -H "Content-Type: application/json" \
  --data '{
    "model": "kimi-k3.1-pro",
    "messages": [
      {
        "role": "system",
        "content": "Interpreti Rowan, un riparatore di orologi premuroso e riservato. Scrivi solo i tuoi dialoghi e le tue azioni osservabili. Non decidere i pensieri, le parole o le azioni del giocatore. Mantieni la risposta sotto le 120 parole."
      },
      {
        "role": "user",
        "content": "Il colloquio è andato male. Posso sedermi qui mentre lavori? Niente discorsi motivazionali, per favore."
      }
    ],
    "temperature": 1.0,
    "max_tokens": 4096
  }'
Per il flusso di lavoro della pagina del modello, apri Kimi K3.1 Pro, seleziona Prova questo modello e usa Copia Markdown per l'IA per fornire al tuo assistente di programmazione le istruzioni di connessione. Tieni la chiave effettiva fuori dal prompt.
La nostra scelta: inizia con Pro, poi confronta la voce
Per una prima sessione con un personaggio, sceglieremmo Kimi K3.1 Pro. Ha gestito bene le emozioni contenute e ha seguito l'obiettivo di lunghezza della risposta in modo più coerente rispetto a K3 nella nostra conversazione estesa.
Prova Kimi K3 quando lo stile del dialogo è abbastanza importante da confrontare le alternative. Scegli Kimi K2.6 quando le attese più brevi e un costo inferiore contano più di un controllo preciso su ogni dettaglio inventato.
Porta la tua scheda personaggio. Esegui una scena difficile, correggi il personaggio una volta e vedi cosa succede diversi turni dopo. Questo ti dirà molto più di un perfetto saluto iniziale.