Panoramica di Qwen 4 Max: dal blind test "Qoduck" all'anteprima di 14 giorni
Se desideri una panoramica pratica di Qwen 4 Max, inizia dai quattro giorni precedenti alla divulgazione del suo nome. Tra il 7 e il 10 novembre 2026, un modello anonimo in codice Qoduck è apparso all'interno di Qoder, un IDE di programmazione agentico. Gli sviluppatori che hanno testato Qoduck hanno notato un comportamento insolito: invece di restituire un rapido snippet di codice in un unico passaggio e attendere il feedback umano, il modello ha impiegato dai dieci ai quindici minuti per avviare controlli di shell, scrivere risorse SVG personalizzate da zero ed eseguire unit test sui propri diff prima di fornire una risposta finale.
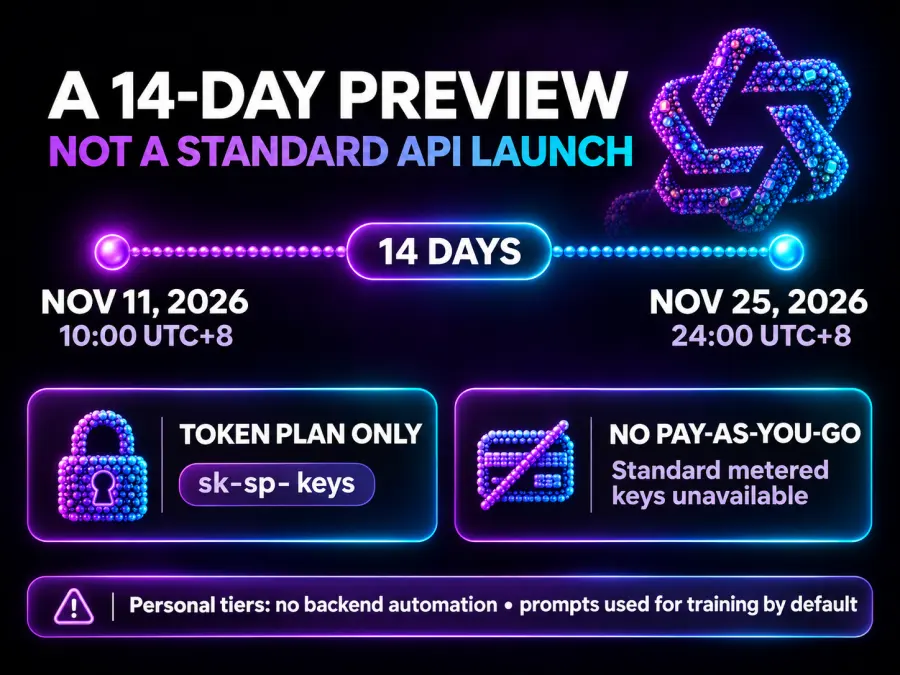
L'11 novembre 2026 alle 10:00 UTC+8, Alibaba ha confermato che Qoduck era il nuovo modello Qwen, Qwen 4 Max, e lo ha reso disponibile in Alibaba Cloud Model Studio con la stringa di modello qwen4-max-preview (indicata come qwen4.0-max-preview in alcune configurazioni client). Piuttosto che organizzare un lancio commerciale completo con prezzi di listino per token, Alibaba ha strutturato il rilascio — spesso descritto nella documentazione per sviluppatori come l'introduzione di Qwen 4 Max tramite un'anteprima di 14 giorni — per sottoporre a stress test i flussi di lavoro agentici all'interno di strumenti di sviluppo come Claude Code, Cursor, Cline e Qoder.
| Specifiche |
Stato confermato (qwen4-max-preview) |
Fonte / Nota tecnica |
| ID modello ufficiale |
qwen4-max-preview |
Documentazione Alibaba Cloud Model Studio / Bailian |
| Periodo di anteprima |
11 nov 2026 (10:00) – 25 nov 2026 (24:00 UTC+8) |
Anteprima limitata di 14 giorni rigorosi |
| Finestra di contesto |
1.000.000 di token (input massimo: 967.000 token) |
Verificato su documentazione CN e internazionale |
| Token di output massimi |
393.216 totali (131.072 output finale + 262.144 ragionamento) |
max_tokens limita il pensiero + output combinati |
| Modalità di input / output |
Input: Testo, Immagine, Video · Output: Testo |
Nessun input audio nativo nel percorso di anteprima |
| Controllo del ragionamento |
reasoning_effort: low, medium, xhigh |
Ragionamento attivo per impostazione predefinita; il valore predefinito è xhigh |
| Protocolli API supportati |
OpenAI Chat Completions, Responses API, Anthropic Messages |
Richiede un endpoint dedicato sk-sp- Token Plan |
| Dimensione parametri e pesi |
Non divulgati (anteprima commerciale chiusa) |
Le cifre 2.4T / 95B online appartengono a Qwen3.8-Max |
| Tabella dei benchmark ufficiale |
Non pubblicata al lancio dell'anteprima |
Il punteggio GameFeel di 49.9 in circolazione appartiene a Qwen-4-Flash-Early |
Comprendere qwen 4 max spiegato come un passo generazionale dipende da come utilizza la potenza di calcolo durante l'inferenza. Laddove le versioni precedenti trattavano la chiamata agli strumenti come un aiuto opzionale, il principale aggiornamento di qwen 4 max integra un ciclo di auto-verifica nella traccia di ragionamento predefinita. Quando gli viene chiesto di creare un'applicazione web o di correggere un'utility da riga di comando, il modello concatena abitualmente dozzine di invocazioni di strumenti: ispezionando alberi di directory, eseguendo pytest o browser headless locali, rilevando le proprie regressioni di sintassi o layout e riscrivendo le righe errate prima ancora che l'utente veda l'output.
Architettura, dimensioni del modello e verifica della realtà dei benchmark
Due informazioni errate dominano attualmente i risultati di ricerca per qwen 4 max size e qwen 4 max benchmark. Fare chiarezza è il modo più rapido per capire cosa abbia effettivamente rilasciato Alibaba e cosa rimanga invece non divulgato.
In primo luogo, Alibaba non ha divulgato il numero totale o attivo di parametri per alibaba qwen 4 max. Diversi blog di terze parti lo elencano come un modello Mixture-of-Experts (MoE) da 2,4 trilioni di parametri con 95 miliardi di parametri attivi per token. Quei numeri esatti appartengono al precedente modello di punta, Qwen3.8-Max, rilasciato nel settembre 2026. Sebbene Qwen 4 Max utilizzi quasi certamente un backbone MoE sparso per gestire una finestra di contesto da 1 milione di token in modo economico, qualsiasi cifra specifica sui trilioni di parametri letta nel novembre 2026 è un dato non verificato ereditato dalla generazione 3.8.
Ciò che sappiamo sul lato architetturale proviene dal rilascio tecnico di Alibaba dell'agosto 2026 di Qwen3.8-Flash-Next, che il team di Qwen ha esplicitamente designato come banco di prova per validare gli aggiornamenti architetturali fondamentali per la serie Qwen 4. Quel rapporto preliminare ha documentato quattro cambiamenti strutturali che spiegano come qwen4-max-preview gestisce carichi di lavoro da un milione di token:
Attenzione ibrida GDN + QSA: La combinazione di strati di attenzione lineare Gated DeltaNet (GDN) con Qwen Sparse Attention (QSA) riduce la latenza di prefill del time-to-first-token (TTFT) su un contesto di 1.000.000 di token fino a 7,6 volte rispetto all'attenzione completa standard.
Connessioni residue gated a 4 flussi: L'espansione della larghezza del flusso residuo con gate appresi migliora il flusso del gradiente e il routing delle caratteristiche tra gli strati durante il ragionamento profondo a più passaggi.
Strati di embedding N-gram: L'iniezione di contesto locale multi-token direttamente nella fase di embedding scarica il pattern matching lessicale dai blocchi di attenzione iniziali.
Addestramento con ottimizzatore Muon: Il passaggio dell'ottimizzazione del pre-addestramento su larga scala a Muon ha migliorato l'efficienza del campionamento su corpora di codice e logica formale.
In secondo luogo, se cerchi i risultati di qwen 4 max benchmark, probabilmente ti imbatterai in affermazioni secondo cui Qwen 4 Max ha ottenuto un punteggio di 49,9 su GameFeel Bench v1.4, superando Claude Opus 5.5 a 47,2. Ho controllato la classifica e i log di commit sottostanti: quel punteggio di 49,9 è stato registrato da un primo checkpoint di test leggero chiamato Qwen-4-Flash-Early (nome in codice interno hawk), non da qwen4-max-preview. Al 13 novembre 2026, Alibaba non ha pubblicato una tabella ufficiale delle classifiche MMLU-Pro, SWE-bench Verified o AIME per Qwen 4 Max.
Ciò che puoi verificare in questo momento è la meccanica della qwen 4 max context window e il suo budget di output—ed è qui che gli sviluppatori che migrano incontrano un ostacolo. Sebbene la finestra di contesto contenga 1.000.000 di token (con un limite documentato di 967.000 token per il prompt), l'output massimo è elencato come 393.216 token sul portale internazionale e suddiviso sul portale nazionale in 262.144 token di ragionamento più 131.072 token per la risposta finale.
Ecco il punto: il parametro API max_tokens in qwen4-max-preview regola la sum di reasoning_content e content. Poiché il modello utilizza come impostazione predefinita reasoning_effort: "xhigh" (la più alta delle tre impostazioni disponibili: low, medium e xhigh), un prompt di programmazione complesso può facilmente consumare da 15.000 a 40.000 token all'interno del blocco di ragionamento nascosto. Se il codice client esistente passa max_tokens: 4096 o 8192, il modello esaurirà l'intera disponibilità a metà del ragionamento e restituirà una stringa content vuota. Per evitare il troncamento silenzioso, aumenta max_tokens oltre 65.536 o imposta esplicitamente reasoning_effort su medium per le attività di routine.
Recensione pratica di Qwen 4 Max: cosa dimostrano realmente i test della community e dei media
Poiché Alibaba ha saltato il tradizionale comunicato stampa sui benchmark, i dati più affidabili sulla recensione di qwen 4 max provengono dai team di ingegneria che hanno integrato qwen4-max-preview in ambienti di agenti live durante le prime 48 ore di anteprima. I loro log mostrano un modello chiaro: ogni salto nella qualità dell'output è accompagnato da una notevole latenza e da un costo in token più elevato.
L'11 novembre, la società di consulenza IA giapponese WEEL ha pubblicato una valutazione in tre parti testando il modello in anteprima su sintesi frontend, ricerca multi-fonte e debug a livello di repository all'interno di Claude Code:
Pagina di destinazione SVG personalizzata da 908 righe (vs Qwen 3.8 Max): Ricevendo un prompt identico per creare una landing page responsive per una clinica di fisioterapia a tema forestale, Qwen3.8-Max ha terminato in circa 9,5 minuti, ma ha estratto foto stock esterne casuali che hanno rotto la griglia o non sono state caricate. qwen4-max-preview ha impiegato circa 17 minuti, quasi il doppio. Invece di collegare URL esterni fragili, ha invocato decine di volte il suo Interprete di Codice in background per disegnare programmaticamente illustrazioni SVG personalizzate di chiome di alberi, architettura della clinica e icone del personale, consegnando un file HTML da 908 righe senza risorse danneggiate.
Debug CLI autonomo in Claude Code (36/36 test superati): WEEL ha puntato Claude Code (alimentato da qwen4-max-preview tramite l'endpoint compatibile con Anthropic) su una CLI locale per la contabilità domestica in Python (kakeibo) e gli ha chiesto di aggiungere i flag di filtraggio --export-csv e --month con unit test. L'esecuzione ha richiesto 11 minuti e 48 secondi. Dopo aver scritto l'implementazione iniziale, il modello ha eseguito pytest, ha rilevato 2 test falliti — incluso un caso limite in cui una stringa di valuta negativa come -100日元 veniva interpretata erroneamente da argparse di Python come un flag da riga di comando — e ha corretto il parser autonomamente. Senza che gli venisse chiesto, ha anche anteposto un'intestazione BOM utf-8-sig in modo che i caratteri giapponesi non venissero alterati in Microsoft Excel e ha eseguito l'escape dei caratteri iniziali =, +, - e @ per bloccare l'iniezione di formule CSV. Tutti i 36 test sono stati superati, consumando solo lo 0,4% della quota mensile del piano Lite.
Ricerca politica auto-verificata: Incaricato di compilare una tabella di confronto dei sussidi per le PMI giapponesi del 2026, il modello ha impiegato 2 minuti per eseguire oltre una dozzina di query web sui portali ministeriali e altri 5 minuti per eseguire grep e script di validazione Python per verificare che nessuna colonna della tabella Markdown fosse spostata prima di presentare il risultato in 8 minuti.
Due giorni dopo, il 13 novembre, la pubblicazione tecnologica cinese Silicon Star (GuiXingRen) ha sottoposto qwen4-max-preview a una prova di ingegneria visiva e 3D. Quando gli è stato chiesto di generare la classica animazione SVG del "pellicano in bicicletta", il modello ha articolato la pedalata e le ombre parallasse degli alberi, aggiungendo spontaneamente uno slider di velocità 0,5x–1,75x e un selettore di temi giorno/crepuscolo/notte. In un test Three.js più difficile — la creazione di un gioco 3D giocabile con aeroplanini di carta chiamato Paper Skies in cui l'aereo vola attraverso la finestra di una camera da letto in un giardino — i recensori hanno notato che la sua fisica e la gestione degli ostacoli erano all'altezza del modello creativo Claude Fable 5.1 di Anthropic, sebbene fosse ancora leggermente indietro rispetto al più recente Claude Fable 5.2 nella rifinitura degli shader. Quando gli è stato chiesto di riprogettare la homepage responsive di Silicon Star, il modello ha avviato un browser locale, ha notato che le miniature degli articoli esterni restituivano errori 403 di hotlink, le ha sostituite automaticamente con segnaposto sfumati SVG stilizzati e ha completato un secondo round di revisioni del layout editoriale in 5 minuti.
Il feedback degli sviluppatori su X (precedentemente Twitter) e sui forum giapponesi aggiunge sfumature importanti a ogni highlight di qwen 4 max feature. Lo sviluppatore @round_boys ha dimostrato il rendering di una scena 3D completa da parte del modello utilizzando Java e Three.js in un unico passaggio, ma ha fatto notare che l'esecuzione ha consumato circa 69.000 token. Altri primi utilizzatori che hanno misurato il throughput grezzo hanno riportato velocità di streaming intorno ai 33 token al secondo con l'impostazione predefinita xhigh, osservando che le traiettorie di utilizzo degli strumenti basate sull'apprendimento per rinforzo (RL) a volte riflettono eccessivamente su semplici letture di file: un promemoria del fatto che il suffisso -preview è letterale.
Prezzi di Qwen 4 Max, regole del piano token e blocchi alla produzione
Se cerchi prezzi di qwen 4 max aspettandoti una tabella standard del tipo "$X per milione di token in input", non ne troverai una. Alibaba non offre una fatturazione a consumo (pay-as-you-go) per qwen4-max-preview. L'unico modo per inviare richieste è tramite un abbonamento attivo al Piano Token di Alibaba Cloud Model Studio (precedentemente chiamato Coding Plan), che fattura in "Crediti" mensili astratti anziché in dollari puri per token.
Sul portale internazionale QwenCloud, il Piano Token è suddiviso in livelli personali e per team:
Piano Lite (3 per il primo mese per i nuovi utenti): Include 20.000 crediti al mese, regolati da un rigido limite mobile di 1.200 crediti per finestra di 5 ore e 9.000 crediti a settimana.
Piano Pro (15 per il primo mese): Include 100.000 crediti al mese, con un limite di 6.000 crediti per finestra di 5 ore e 45.000 crediti a settimana. (Sul portale domestico cinese di Alibaba, i piani Lite e Pro sono elencati rispettivamente a 39 RMB e 199 RMB al mese, con promozioni a metà prezzo per il primo mese a 19,5 RMB e 99,5 RMB.)
Sconto anteprima di 14 giorni (11 nov – 25 nov 2026): Durante la finestra di anteprima di due settimane, le chiamate diurne (08:00–22:00 UTC+8) consumano solo il 20% del peso standard dei crediti, mentre le chiamate notturne fuori orario (22:00–08:00 UTC+8) ricevono un ulteriore sconto dell'80% su tale valore, riducendo il consumo effettivo di crediti a solo il 4% delle tariffe normali.
Per un singolo sviluppatore che lavora in un IDE di notte per 3 dollari, questo calcolo promozionale è difficile da battere. Per un team di ingegneri che costruisce un prodotto o gestisce agenti CI/CD automatizzati, tuttavia, il Piano Token introduce tre seri blocchi alla produzione:
Divieto di automazione backend e integrazione API: I termini del Piano Token di Alibaba limitano esplicitamente le chiavi personali Lite e Pro (sk-sp-) all'uso interattivo e attivato dall'utente all'interno dei plugin IDE supportati. L'utilizzo di una chiave di abbonamento per alimentare uno script backend automatizzato, una funzionalità SaaS rivolta ai clienti o una pipeline di dati batch viola i termini di servizio e comporta la sospensione dell'account.
Addestramento obbligatorio sui dati nei livelli personali: Secondo le regole del Piano Token, gli abbonamenti personali Lite e Pro includono per impostazione predefinita tutti i prompt, il contesto del repository e i completamenti del modello nel programma di miglioramento dell'addestramento dei modelli di Alibaba, e non esiste un'opzione per disattivarlo. Solo il piano aziendale Team (40 dollari per utente/mese) fornisce una garanzia di zero conservazione dei dati / nessun addestramento.
Limiti di velocità mobili di 5 ore e chiusura del 25 novembre: Anche se il tuo flusso di lavoro è puramente interno, un limite mobile di 1.200 crediti ogni 5 ore non può assorbire picchi di più sviluppatori, e l'endpoint qwen4-max-preview è programmato per chiudere il 25 novembre 2026 alle 24:00 UTC+8.
Confronto diretto: Qwen 4 Max vs Qwen 3.8 Max, Kimi K3.1 Pro, GLM-5.3 e Claude Opus 5.5
Poiché oggi non è possibile integrare qwen4-max-preview in un backend di produzione, la domanda pratica dietro ogni richiesta di confronto è quale modello di punta con pagamento a consumo copra lo stesso carico di lavoro agentico da 1M di contesto senza vincoli di abbonamento o esposizione dei dati per l'addestramento.
| Modello |
Fatturazione e disponibilità |
Finestra di contesto |
Output massimo |
Modalità di input supportate |
Tariffa a consumo GPT Proto (Input / Output per 1M) |
Qwen4-Max-Preview (qwen4-max-preview) |
Solo anteprima di 14 giorni (termina il 25 nov); Abbonamento Token Plan ($6–$30/mese) |
1.000.000 |
393.216 (incl. 262K CoT) |
Testo, Immagine, Video |
Non ospitato (nessuna API upstream a consumo) |
Qwen3.8 Max 0902 (qwen3.8-max-0902) |
Produzione a consumo |
1.000.000 |
65.536+ |
Testo, Immagine, Video, Audio, Documento |
4,20 (30% sotto il listino ufficiale) |
Kimi K3.1 Pro (kimi-k3.1-pro) |
Produzione a consumo |
1.048.576 (1,05M) |
131.072 |
Testo, Immagine, Documento |
10,00 ($0,20 input memorizzato nella cache) |
GLM-5.3 (glm-5.3) |
Produzione a consumo |
1.050.000 (1,05M) |
128.000 |
Testo, Immagine, Documento |
3,74 (15% sotto il listino ufficiale) |
Claude Opus 5.5 (claude-opus-5-5) |
Produzione a consumo |
1.000.000 |
128.000 |
Testo, Immagine, Documento |
18,00 (10% sotto il listino ufficiale) |
Qwen 4 Max vs Qwen 3.8 Max
Quando si valuta qwen 4 max vs qwen 3.8 max, il compromesso è tra il tempo di verifica autonoma e la stabilità di produzione con un supporto di modalità più ampio. Come dimostrato dal test della landing page di WEEL (17 minuti contro 9,5 minuti), Qwen 4 Max è disposto a impiegare il doppio del tempo reale per eseguire controlli Python in background e sintetizzare SVG personalizzati. Tuttavia, qwen4-max-preview abbandona l'analisi nativa di audio e documenti nel suo percorso di anteprima e non può essere chiamato su base per-token.
Se la tua pipeline si basa già sulla formattazione dei prompt, sulla tokenizzazione multilingue o sulla visione multimodale di Alibaba, qwen3.8-max-0902 è il modello di punta pronto per la produzione da scegliere oggi. Offre la stessa finestra di contesto da 1.000.000 di token accettando input di testo, immagini, video, audio e documenti. Su GPT Proto, qwen3.8-max-0902 viene eseguito a 4,20 per 1M di token di output—il 30% in meno rispetto al prezzo di listino ufficiale di Alibaba—e puoi confrontarlo con i modelli open-weight più piccoli nell'hub dei modelli Qwen.
Qwen 4 Max vs Kimi K3.1 Pro
Il confronto tra qwen 4 max vs kimi k3.1 pro è stato testato testa a testa nei benchmark Blender MCP e WebGL del 13 novembre di Silicon Star, e la differenza tra i due modelli è notevolmente chiara: Qwen 4 Max pensa come un ingegnere meccanico strutturale, mentre Kimi K3.1 Pro pensa come un designer industriale.
Nel prompt di Blender ("Molo di manutenzione per meganave orbitale di Giove") e nel test WebGL del cancello degli abissi ("Cancello delle diecimila maree"), qwen4-max-preview ha costruito nervature portanti interne più dense, bracci di attracco complessi e uno slider dell'interfaccia utente per il livello della marea funzionante che ricalcolava dinamicamente i dati su altezza e pressione dell'acqua. Eppure i revisori hanno costantemente assegnato a kimi-k3.1-pro punteggi più alti per composizione visiva, illuminazione dello shader dell'acqua e armonia dei colori. Se stai creando frontend rivolti all'utente, esperienze web 3D interattive o agenti di documenti a contesto lungo che necessitano di una finestra di contesto da 1.048.576 token (1,05M) e 131.072 token di output massimo oggi, Kimi K3.1 Pro è disponibile su GPT Proto a 10,00 per 1M di output (con l'input memorizzato nella cache che scende a 0,20$ per 1M).
Qwen 4 Max vs GLM-5.3
Gli sviluppatori che cercano qwen 4 max vs glm5.3 solitamente puntano a un'elevata efficienza di codifica e utilizzo degli strumenti a un prezzo aggressivo. Sebbene la promozione Lite del primo mese a 3$ di Qwen 4 Max sembri economica sulla carta, il limite di credito a rotazione di 5 ore e il divieto di script automatizzati lo rendono inutilizzabile per flotte di agenti in background.
Il modello glm-5.3 di Z.ai risolve esattamente questo problema su un'API a consumo. Supera leggermente Qwen 4 Max nella capacità di contesto totale, offrendo una finestra di contesto da 1,05M abbinata a un limite di output di 128K e accetta input di testo, immagini e documenti. A 3,74 per 1M di token di output su GPT Proto (15% in meno rispetto alla tariffa ufficiale di Z.ai), GLM-5.3 è il cavallo di battaglia pay-as-you-go più conveniente per bot di revisione PR automatizzati, routing di strumenti ad alta concorrenza e generazione di codice multi-file.
Qwen 4 Max vs Claude Opus 5.5
Alibaba ha integrato la compatibilità nativa con l'API Anthropic Messages in qwen4-max-preview specificamente per attirare gli sviluppatori che valutano qwen 4 max vs claude opus 5.5 all'interno di Claude Code. Come ha dimostrato il test Python CLI di WEEL, Qwen 4 Max è già in grado di eseguire un ciclo di riparazione pytest di 12 minuti e rilevare sottili bug di argparse e iniezione CSV.
Dove claude-opus-5-5 mantiene un vantaggio decisivo è l'efficienza della traiettoria, la reattività dello streaming e l'affidabilità dell'SLA di produzione. I tester della community hanno notato che la messa a punto RL in fase iniziale di Qwen 4 Max può portarlo a eseguire cicli di controlli shell ridondanti a ~33 token/s con ragionamento xhigh. Quando si esegue il refactoring di repository di produzione mission-critical in cui i turni di strumenti sprecati o l'addestramento dei dati a livello personale sono inaccettabili, Claude Opus 5.5 offre una finestra di contesto da 1M e un output massimo di 128K con una solida aderenza alle istruzioni. Tramite GPT Proto, puoi chiamare claude-opus-5-5 a 18,00 per 1M di output—10% in meno rispetto ai prezzi ufficiali di Anthropic.
Come chiamare le alternative di produzione tramite API unificata
Se desideri eseguire i quattro modelli di punta sopra citati senza gestire SDK di fornitori separati, finestre di credito per abbonamenti o endpoint regionali sk-sp-, GPT Proto li espone tutti dietro un'unica rotta compatibile con OpenAI (https://gptproto.com/v1/chat/completions).
Un dettaglio di autenticazione da notare prima di copiare lo snippet: come documentato nella nostra guida all'autenticazione e nella pagina di avvio rapido, passa sempre la tua chiave nell'intestazione Authorization con il prefisso Bearer (Authorization: Bearer $GPTPROTO_API_KEY). Di seguito è riportato un esempio basato sulla documentazione che mostra come chiamare qwen3.8-max-0902 e passare direttamente a glm-5.3, kimi-k3.1-pro o claude-opus-5-5 modificando una singola stringa:
curl --request POST "https://gptproto.com/v1/chat/completions" \
  --header "Authorization: Bearer $GPTPROTO_API_KEY" \
  --header "Content-Type: application/json" \
  --data '{
    "model": "qwen3.8-max-0902",
    "messages": [
      {
        "role": "user",
        "content": "Analizza questo parser CLI Python per rilevare collisioni di flag con numeri negativi e rischi di iniezione di formule CSV."
      }
    ]
  }'
import os
from openai import OpenAI

client = OpenAI(
    base_url="https://gptproto.com/v1",
    api_key=os.environ["GPTPROTO_API_KEY"],
)

# Scambia liberamente l'ID del modello tra i modelli di punta con contesto da 1M:

# "qwen3.8-max-0902" ($1.40/$4.20) | "glm-5.3" ($1.19/$3.74)

# "kimi-k3.1-pro" ($2.00/$10.00)   | "claude-opus-5-5" ($3.60/$18.00)
response = client.chat.completions.create(
    model="qwen3.8-max-0902",
    messages=[
        {
            "role": "user",
            "content": "Analizza questo parser CLI Python per rilevare collisioni di flag con numeri negativi e rischi di iniezione di formule CSV.",
        }
    ],
)

print(response.choices[0].message.content)